無審查 AI 圖片 · OpenMOSS
無審查 MOSS-Image-SFT:8 步草稿、乾淨漸層與動漫標籤
MOSS-Image-SFT 是 OpenMOSS 團隊於 2026 年 10 月 16 日發布的 5B 開放權重模型 MOSS-Image 的開箱即用版本。發布後第一個月,社群就把它變成更好上手的工具:用於快速草稿的 8 步蒸餾版、消除垂直色帶的 LoRA、給舊顯示卡用的 FP16 權重,以及越來越流行用簡單標籤撰寫動漫提示詞的寫法。本指南整理了這些技巧,並附上可以直接貼上使用的提示詞範本。
- 免費開始
- 無過濾
- 瀏覽器即可執行
無審查替代圖片生成器
文字轉圖片描述你想要的圖片,要出現的文字請加上引號。加入參考照片可進行編輯,留空則以文字生成圖片。
從 Base 到 SFT:專為產圖打造的檢查點
OpenMOSS 發布了同一個 5B 單流模型的兩個檢查點。Base 沒有經過後訓練,定位是訓練 LoRA 的乾淨起點。MOSS-Image-SFT 則是以精選資料微調 Base 而成,一上手就能產出好圖,並理解三種提示詞:一般句子、動漫風格標籤清單,以及帶座標的 JSON 版面。發布的白板範例顯示 SFT 版的文字分組更整齊、版面更俐落,不過 OpenMOSS 並未公布兩者差距的數據。如果只是想產圖,就載入這個檢查點;想訓練自己的風格,就從 Base 開始。發布一個月後,Hugging Face 上的 SFT 頁面累積 913 個讚、過去一個月約 19,500 次下載,以及 68 個以它打造的 Space。
8 步取代 50 步:DMD 蒸餾與 Spectrum
原始建議設定是搭配引導的 50 步取樣,細緻但很慢。MOSS-Image-SFT 社群很快就解決了這點。lodestones 發布了蒸餾版 MOSS-Image-SFT-8-steps-dmd,只要 8 步就能畫出一張圖,還附有 ComfyUI 用的 LoRA 轉接器。此外,ComfyUI-Spectrum-MOSS 節點會略過相似步驟之間的運算,讓取樣更快。OpenMOSS 表示自家的 DMD 版本仍在開發中。目前還沒有人公布公平的速度或品質評測,請用自己的顯示卡實測;不過多數人最後採用的分工很簡單:
| 用途 | 選擇 | 原因 |
|---|---|---|
| 找構圖、大量發想 | 8 步 DMD | 一次完整算圖的時間就能出很多張草稿 |
| 文字很多的海報 | 建議的 50 步 | 文字與細節保留得更好 |
| 最終商品照或封面 | 50 步,可搭配 Spectrum | 維持品質同時縮短等待時間 |
修正色帶、FP16 顯示卡與 SLG 設定
初期出現了兩個抱怨。部分 MOSS-Image-SFT 使用者發現平滑的天空與漸層上有淡淡的垂直條紋,也就是色帶。MATLOWAI 推出 MOSS-Image-SFT-DeBand 回應,這是一個小型 LoRA 加上 ComfyUI 預設,可以撫平這些條紋。第二個問題是硬體:發布的權重是 BF16,許多舊 GPU 並不支援。KBlueLeaf 發布了 MOSS-Image-FP16-fixed,這是調整過、能在 FP16 下順利執行的權重。最後一項調整是 skip-layer guidance(SLG)。模型卡將負向分支設為略過第 22 層,社群測試發現第 24 或 26 層也同樣可行。
- 天空或牆面出現條紋:載入 DeBand LoRA 並套用其預設。
- 舊顯示卡出現全黑或破圖:改用 FP16-fixed 權重。
- 想要更像照片的質感:試著關閉 SLG,但要注意手部與細節。
- 短提示詞看起來平淡:依模型卡建議,將 CFG 從 3 往 6 調高。
撰寫 MOSS-Image-SFT 提示詞的三種方式
多數圖片模型只讀得懂句子。MOSS-Image-SFT 能讀三種格式,接受最長 4K token 的提示詞,可用英文(建議)或中文。一般句子最適合照片與含文字的海報:把要出現的文字用引號括起來,需要換行時在引號內使用 \n。以逗號分隔的標籤清單,對動漫愛好者來說很直覺。JSON 則用於嚴格的版面,標題、商品或徽章各自擁有一個框。JSON 格式中,框採用以畫布中心為原點的 yxyx 順序,所以在 1024×1024 的圖上,每個軸的範圍是 -512 到 512。GitHub 儲存庫中的 Prompt Enhancer 技能可以幫你把粗略的像素草圖轉成這種中心座標。
{
  "summary": { "caption": "Clean perfume ad, black stone, soft rim light" },
  "items": [
    { "label": "product", "caption": "glass perfume bottle", "bbox": [-200, -160, 360, 160] },
    { "label": "title", "caption": "thin gold serif", "bbox": [-460, -300, -320, 300], "text": "NOIR 07" }
  ],
  "bbox_format": "yxyx"
}
可複製改編的提示詞範本
這些 MOSS-Image-SFT 範本遵循建議做法:描述場景、用引號標出文字、說明文字位置。解析度約 1 到 2 百萬像素,長寬比只要是 16 的倍數皆可;固定種子,每次只改一個細節。冰箱便條的範例很適合暖身:冰箱門上貼著一張便利貼,用中文手寫提醒某人去買牛奶和雞蛋。
- 旅遊海報: "Minimalist travel poster, bold title text \"EXPLORE KYOTO\" at top, red torii gate at sunset, small subtitle \"Autumn 2026\" at bottom, flat illustration, high contrast"
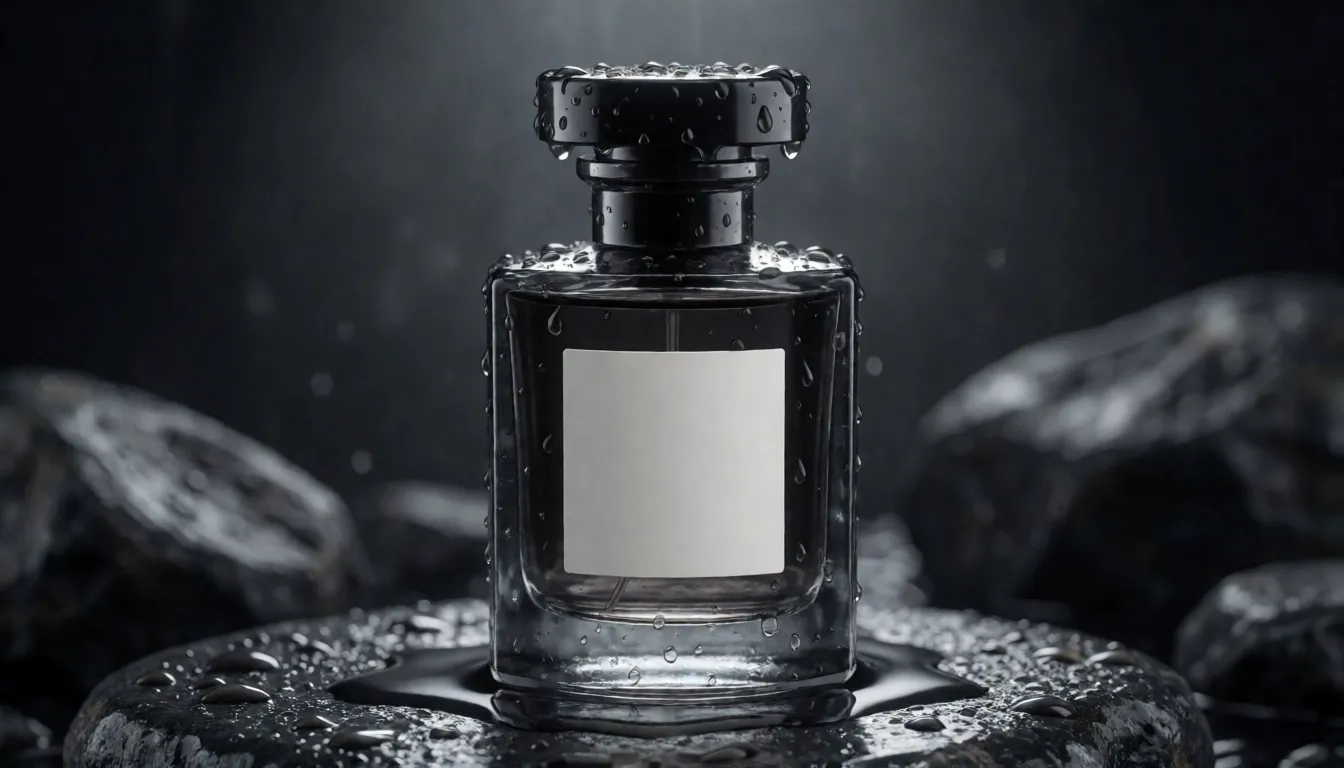
- 商品照: "Product photo of a glass perfume bottle on wet black stone, label text \"NOIR 07\", soft rim light, studio"
- 手寫便條: "A wide view of a refrigerator beside a kitchen counter, a sticky note on the door handwritten: \"Buy milk and eggs!\""
- 直式封面: "Vertical web novel cover, adult couple in the rain under one umbrella, title \"Midnight Contract\" in silver letters, cinematic"
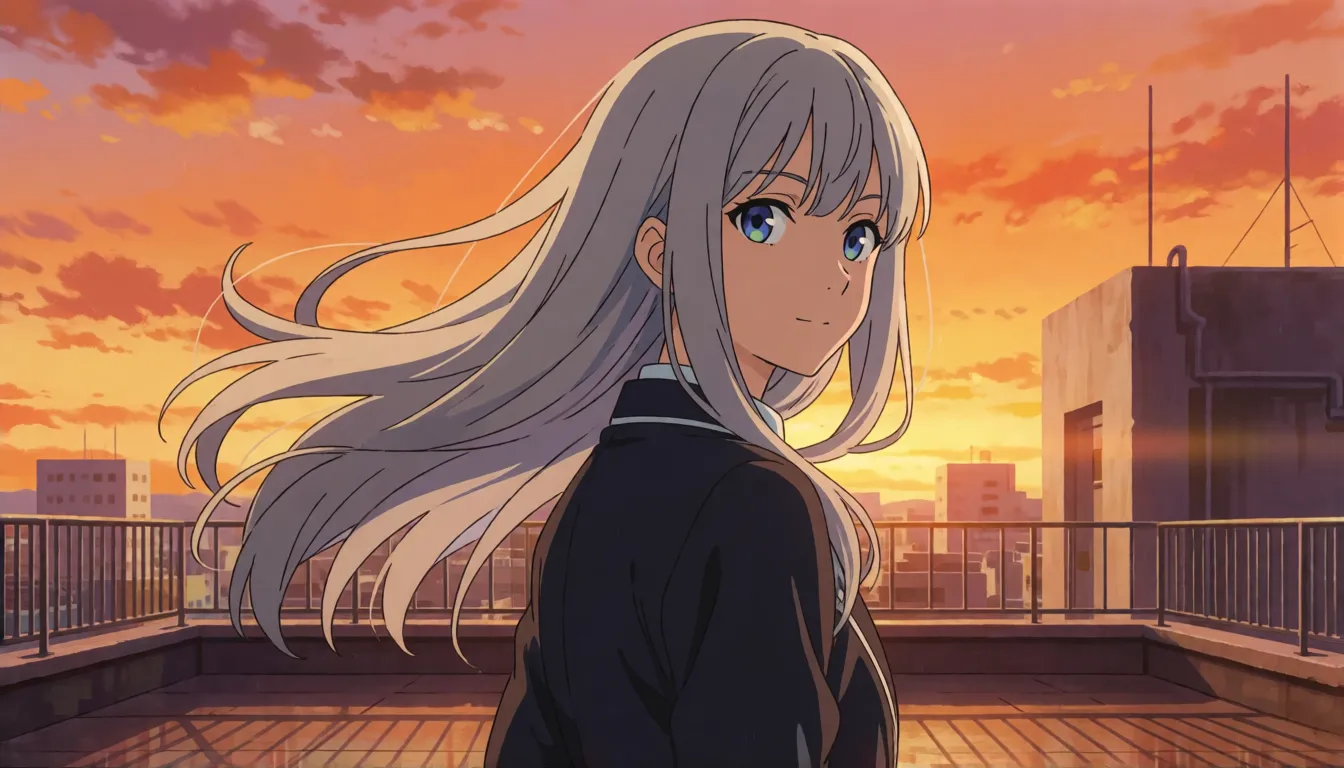
- 動漫標籤: "best quality, highres, newest, 1girl, adult, silver hair, school rooftop, sunset, wind, looking back"
用 Danbooru 風格標籤畫動漫插畫
動漫創作者會在 MOSS-Image-SFT 上發現驚喜:可以捨棄冗長句子,像在 booru 網站一樣寫簡短標籤。使用者指南甚至建議了順序:先寫品質標籤,接著是分數、meta 與年份標籤,然後是角色、作品、繪師,最後才是姿勢、服裝與背景等一般標籤。照這個順序寫,重要的部分就會排在前面。社群初期回報指出,繪師名稱標籤的效果比專門的動漫模型弱,所以風格很重要時請用文字描述,並在標籤後加一句完整的句子描述光線或氛圍。
- 品質 → 分數 → Meta → 年份 → 角色 → 作品 → 繪師 → 一般
- 開頭先寫:best quality, highres, newest
- 姿勢與場景放最後:looking back, rooftop, sunset, wind
文字是重點的海報與設計
清晰可讀的文字,是許多人嘗試 MOSS-Image-SFT 的原因。技術報告指出,它在長文字評測 LLTB 上的平均文字覆蓋率為 96.3%,是開放權重模型中最高的;範例中也滿是白板、招牌,以及中英文手寫便條。因此 MOSS-Image-SFT 很適合雙語活動海報、標有價格的店面橫幅、帶對話框的漫畫分格、資訊圖表,以及短劇和網路小說的直式封面。由於任何長寬比都可以,同一組提示詞就能重複用於方形貼文、寬版橫幅和直式手機限動。
訓練自己的角色或風格 LoRA
開放權重代表你可以教模型認識自己的角色或畫風。10 月 18 日發布的 KohakuMossTrainer 只需 6GB VRAM 就能訓練 LoRA 和 LyCORIS 轉接器,DiffSynth-Studio 則同時支援完整微調與 LoRA。一般建議在 Base 上訓練,再把成果載入 MOSS-Image-SFT 使用。生態系還小但成長迅速:Hugging Face 上的 SFT 模型樹列出 55 個轉接器、23 個微調和 2 個合併模型。標註文字請和你打算撰寫提示詞的方式一致:動漫角色用標籤,照片風格用句子。
線上、API、量化檔案與伺服器
試用 MOSS-Image-SFT 不需要本機環境。Hugging Face Space 可以直接在瀏覽器執行,MOSI API 平台也從 10 月 20 日起提供託管存取(目前價格請查看其網站)。自行架設服務的團隊,SGLang 和 vLLM-Omni 從第一天就支援此模型,兩者都公開了部署教學。VRAM 較少的使用者可以在模型樹中瀏覽 48 個量化版本,包括 GGUF 檔案;所需的載入器請查看各模型卡。在 Mac 上,Draw Things 和 DiffusionBee 是大家常用來本機生成的應用程式。
MOSS-Image-SFT 與 FLUX、Qwen-Image 比較
目前沒有正式的直接對比分數,因此這是實用層面的比較。MOSS-Image-SFT 體積小,約 5B 參數,在消費級顯示卡上更容易執行與訓練。它的強項是中英文長文字與 JSON 版面控制。FLUX 和 Qwen-Image 規模更大,社群 LoRA 與微調資源豐富得多,還有獨立的編輯模型,所以當你需要別人已經訓練好的特定風格時,它們仍佔上風。
| MOSS-Image-SFT | FLUX 系列 | Qwen-Image | |
|---|---|---|---|
| 規模 | 約 5B | 較大 | 較大 |
| 座標版面提示詞 | 支援,JSON 框 | 不支援 | 不支援 |
| 雙語長文字 | 主要強項 | 以英文為主 | 強 |
| 社群 LoRA | 起步中、持續成長 | 非常多 | 多 |
無審查 MOSS-Image-SFT 與成人藝術
OpenMOSS 並未發布無審查版本。MOSS-Image-SFT 的權重是開放的,在本機執行時不會有任何過濾,但建議的負向提示詞本身就包含 nsfw 這個詞,顯示預設設定偏向安全的圖片。社群中有成人主題的 LoRA,但品質與來源參差不齊,請仔細查核。熱門的成人方向包括泳裝寫真、海報女郎風格海報,以及明確為成年角色的奇幻封面。如果想省去設定,Spicy AI 在瀏覽器中就提供類似的無審查圖片生成。
泳裝寫真
成年模特兒在陽光海灘與泳池的拍攝,上方配上雜誌標題。
海報女郎
成年角色的復古海報女郎,標語文字精準到位。
奇幻封面
成年英雄與女巫,用於書籍或遊戲封面,標題清晰可讀。
- 用 8 步版本探索,再把滿意的作品用完整步數算圖。
- 所有要印出的文字都加上引號,並說明位置。
- 註明畫面中所有人都是成年人(18 歲以上),且絕不在未經同意下描繪真實人物。
在瀏覽器中建立成人主題圖片,不需要 GPU 也不用下載。
開啟圖片生成器 →發布一個月,社群都在做什麼
數字說明了一切:發布後不久 SFT 頁面約有 130 個讚,一個月後 SFT 頁面突破 900 個讚,模型樹中有 48 個量化檔案與數十個轉接器,GitHub 上也有約 2.6k 顆星。大家分享的 MOSS-Image-SFT 圖片大多分成幾類:復古旅遊海報、雙語雜誌封面、手寫便條與白板迷因、以標籤提示詞生成的動漫角色,以及給網店用的氛圍感商品照。
- 標題大又清楚的復古海報
- 雙語封面與活動傳單
- 手寫便條、收據與白板梗圖
- 以 booru 風格標籤生成的動漫角色
- 帶有品牌風格標籤的商品照
自架 MOSS-Image-SFT vs 在 Spicy AI 線上生成
| 本機部署(發布權重) | Spicy AI 線上 | |
|---|---|---|
| 內容過濾 | 本機執行時無 | 無內容過濾 |
| 開放權重 | 是 | 不需要 — 在瀏覽器執行 |
| 模型 | SFT 檢查點加社群外掛 | 類似的無審查圖片模型,線上託管 |
| 入門成本 | 自己的 GPU | 提供免費方案 |
常見問題
MOSS-Image-SFT 和 Base 有什麼不同?
SFT 是以精選資料微調 Base 而成,開箱就能產出更好的圖,並讀得懂句子、標籤和 JSON。Base 沒有後訓練,比較適合用來訓練 LoRA。OpenMOSS 並未公布數據比較。
一定要用 50 步嗎?
50 步是開發團隊的建議值。lodestones 的社群 8 步 DMD 版本能大幅縮短;開發團隊自己的 DMD 版本仍在開發中。
如何修正垂直條紋或色帶?
試試社群的 MOSS-Image-SFT-DeBand LoRA 搭配其 ComfyUI 預設,或調整 skip-layer guidance 設定。
我的 GPU 不支援 BF16,還能執行嗎?
可以。KBlueLeaf 的社群 MOSS-Image-FP16-fixed 權重就是為只支援 FP16 的顯示卡製作的。
它能寫中文字嗎?
可以。它能渲染中英文長文字,技術報告中 LLTB 評測的平均覆蓋率為 96.3%。需要精確換行時,在引號內加入 \n。
可以用動漫標籤嗎?
可以。建議順序是品質、分數、Meta、年份、角色、作品、繪師,最後是一般標籤。
Spicy AI 與 OpenMOSS 有合作關係嗎?
沒有。Spicy AI 是獨立平台,與 OpenMOSS 並無合作關係,也未獲其背書。模型名稱為其各自所有者的商標。