無審查 AI 圖片 · OpenMOSS
無審查 MOSS-Image:把文字精準放在你想要位置的開放權重模型
MOSS-Image 是 OpenMOSS 團隊推出、約 50 億參數的文字生成圖片模型,於 2026 年 10 月 16 日以開放權重釋出。它的拿手絕活是真正看得懂的文字:中英文標題、手寫便條和標籤都能直接畫進畫面裡,而 JSON 版面模式還能把每個標題、商品或 Logo 固定在精確座標上。由於權重在你自己的 GPU 上執行、沒有線上過濾器,可下載的檢查點就是本地創作者熱議的無審查 MOSS-Image。
- 免費開始
- 無過濾
- 瀏覽器即可使用
MOSS-Image 無審查替代圖片生成器
文字轉圖片描述你想要的圖片,要出現的文字請放進引號。加入參考照片即可編輯,留空則以文字生成圖片。
試試提示詞
範例提示詞為英文,使用英文能得到最穩定的結果。
為什麼設計師和賣家都在關注它
可以把 MOSS-Image 看成一款終於把文字當作畫面一部分的開放圖片生成器。把標題、價格或手寫便條用引號寫進提示詞,它就會以清楚可讀的英文或中文出現在圖中,而且就在版面指定的位置。光是這一點,就讓好玩的玩具變成網店、工作室和社群小編真的能拿來工作的工具。權重可免費下載、在自己的 GPU 上跑,沒有按張計費,提示詞和成品之間也沒有線上過濾。
在畫面中寫出清晰可讀的中英文字
多數開源圖片模型的文字仍然容易亂成一團,中文字更是重災區。MOSS-Image 經過訓練能寫出兩種語言,官方範例也大量展示這項能力:冰箱上用中文手寫的購物清單(牛奶、雞蛋、麵包)、寫滿筆記的白板、店家招牌和海報標題。訣竅很簡單:把你要的文字原封不動放進引號,並說明它的位置和樣式,例如 "a bold red headline reading \"SUMMER SALE\" across the top"。短句比長段落更乾淨;在官方對比中,SFT 檢查點的文字分組與對齊也比 Base 更整齊。
- 每個要印出的字都用引號括起來,並使用你想要的語言。
- 描述文字所在的表面:便利貼、霓虹招牌、黑板、雜誌封面。
- 指定字體風格:手寫、粗體無襯線、毛筆書法。
- 每段文字保持簡短;長文案拆成多個帶標籤的項目。
最擅長的場景:海報、電商橫幅與資訊圖表
既然文字與排版是它的強項,就特別適合「只有漂亮圖片還不夠」的工作。網路賣家用它製作角落帶價格標章的商品橫幅草稿,社群小編用它打造中英雙語標題的封面,短劇和網路漫畫創作者用它快速畫出已經放好台詞的海報與分格。老師和行銷人員拿來做白板講解與資訊圖表,餐廳用來做菜單和招牌,品牌團隊則用來批量產出只換標題的同款版面。
| 場景 | 你要求的內容 | 為什麼有效 |
|---|---|---|
| 電商橫幅 | 商品置中、標題在上、角落放標章 | JSON 方框讓每個元素都待在規劃好的位置 |
| 雙語社群封面 | 中文標題加英文副標 | 兩種文字都能清楚呈現 |
| 短劇或漫畫海報 | 角色、標語與對話框 | 長提示詞能同時容納大量細節 |
| 白板講解 | 手寫步驟與簡單插圖 | 手寫風格看起來很自然 |
| 菜單或招牌 | 一行行的菜名與價格 | 短文字行保持清晰銳利 |
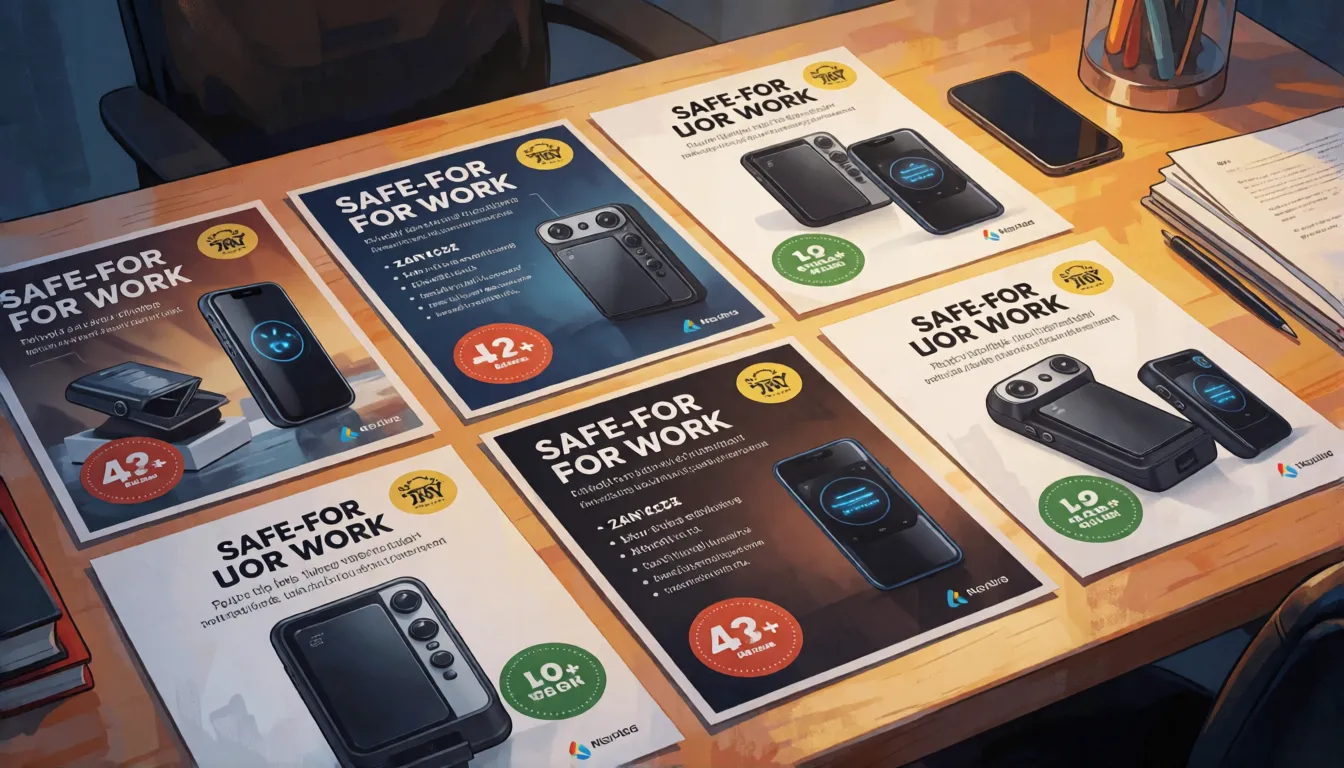
拿來做生意:主圖海報、菜單與廣告測試
最受益的是需要快速產出大量帶字圖片的小團隊。網店一個下午就能打好一週的促銷橫幅草稿,每張都把商品放中間、折扣放進貼紙、標題中英雙語。廣告代理商用同一份 JSON 版面,只換標語就能產出幾十版廣告,讓 A/B 測試變得便宜。咖啡廳和餐廳拿來排菜單和黑板特餐,印刷店接客製海報,條漫與短劇工作室先出標題已就位的封面草圖,再交給設計師精修。
| 誰在用 | 做什麼 | 為什麼划算 |
|---|---|---|
| 網店賣家 | 每週促銷橫幅與價格標籤 | 版面固定,只換文字 |
| 廣告代理商 | A/B 測試用的多版標語 | 同一份 JSON,幾秒換新文案 |
| 餐廳或咖啡廳 | 菜單、黑板特餐、櫥窗海報 | 短句文字清晰銳利 |
| 漫畫或短劇工作室 | 帶標題與宣傳語的封面草圖 | 省下多輪排版 |
| 接案設計師 | 定稿前給客戶看的樣稿 | 更快交出初稿 |
社群怎麼評價、大家都拿它玩什麼
在創作者分享圖片與模型的 Civitai 上,早期留言大多是正面的。有使用者說它是寫實圖片方面知識量最豐富的開放模型之一,並稱讚它動漫和寫真風格都能駕馭。也有人指出缺點:手和四肢偶爾會畫錯,畫師名稱的風格標籤幾乎沒效果,預設設定也偏慢;有人說原本一張要 100 多秒,直到社群做出 turbo LoRA 才縮短到大約十分之一,代價是皮膚稍微偏柔。發布十天後,GitHub 倉庫約有 1.9k 顆星,Base 模型頁面有 556 個讚。大家都在發什麼?虛構的復古旅遊海報、中英雙語雜誌封面、手寫冰箱便條和白板、自帶字幕的迷因圖、標好名字的動漫角色設定圖,以及成年模特兒的亮眼海灘寫真。
- 大字清楚的復古旅遊與電影風海報
- 中英雙語雜誌封面與社群封面
- 拿來做迷因的手寫便條、收據和白板梗圖
- 旁邊印著名字與數值的動漫角色設定圖
- 帶雜誌字樣的成年模特兒泳裝與復古性感寫真
可直接複製的 MOSS-Image 提示詞範例
這個模型能讀懂三種提示詞風格,各自適合不同目標。自然句子最適合照片和海報,標籤清單是動漫與社群 LoRA 使用者熟悉的寫法,JSON 則用於嚴格的版面。從以下範本開始,固定種子,每次只改一個細節:
- 自然語言:"A cozy kitchen at morning, a handwritten note on the fridge reading \"milk, eggs, bread\", warm sunlight, photorealistic."
- 海報:"Retro travel poster of a seaside town, large title \"VISIT CAPRI\" at the top in cream serif letters, grainy print texture."
- 標籤:"adult woman, beach, sunset, bikini, film grain, 35mm, golden hour"(僅限成年角色)。
- 資訊圖表:"Clean whiteboard with three numbered steps titled \"How to brew coffee\", simple marker drawings, flat lighting."
- 雙語封面:"Magazine cover, Chinese headline in bold brush strokes, English subtitle \"Night Market Guide\" below, neon street at night."
JSON 版面提示詞:用座標固定標題與商品
JSON 模式正是這個模型與眾不同之處。你不必祈禱標題剛好落在上方,而是先在 summary 描述整個場景,再列出各個項目,每項包含標籤、說明、邊界框和可選的文字。方框採用 yxyx 順序(上、左、下、右),以畫布中心為原點的像素座標表示;在 1024×1024 的圖片上,每個軸的範圍是 -512 到 512,數字必須與你生成的尺寸一致。OpenMOSS 仍把版面功能標為實驗性,所以要有微調一兩個方框的心理準備。入門骨架如下:
{
  "summary": { "caption": "Bright summer shop banner, white studio background" },
  "items": [
    { "label": "title", "caption": "bold red headline", "bbox": [-460, -400, -300, 400], "text": "SUMMER SALE" },
    { "label": "product", "caption": "glass bottle of iced lemon tea", "bbox": [-220, -200, 380, 200] },
    { "label": "badge", "caption": "yellow round sticker", "bbox": [260, 260, 460, 460], "text": "-50%" }
  ],
  "bbox_format": "yxyx",
  "bbox_coord_space": "abs_centralized"
}
欄位名稱依照官方 GitHub 儲存庫中的版面指南;官方的 Prompt Enhancer 技能也能把一句話擴寫成詳細描述或版面。
MOSS-Image 是無審查的嗎?NSFW LoRA 與成人藝術
在本地執行時,開放權重沒有任何線上過濾器:不會檢查你的提示詞或成品圖片,畫什麼由你決定。OpenMOSS 沒有釋出 NSFW 檢查點,也沒有說明訓練資料如何過濾,因此露骨細節取決於社群外掛。根據 AlphaSignal 的二手報導,一個使用觸發詞 moss_xvstyle 的 "Moss-image-nsfw-uncensored-lora" 在幾天內就出現,且可搭配 Base 與 SFT 使用;但它尚未在 Hugging Face 或 Civitai 頁面上獲得證實,請謹慎看待。熱門的成人方向包括明確為成年角色的泳裝與內衣寫真、復古海報女郎(pin-up)以及奇幻封面插畫。如果你想省去 GPU 設定,Spicy AI 也在瀏覽器中提供類似的無審查圖片生成。
比基尼與泳裝寫真
陽光海灘與泳池邊的成年模特兒拍攝,上方配上雜誌標題。
海報女郎與私房照海報
復古成人 pin-up 與內衣寫真,標語文字直接排好。
奇幻封面插畫
為書籍或遊戲封面打造成年英雄與女巫,標題清晰可讀。
- 把要出現的文字放進引號,並說明擺放位置。
- 角色外觀用標籤描述,光線與氛圍用完整句子描述。
- 固定種子,每次只改一個細節。
- 註明畫面中所有人都是成年人(18 歲以上),且絕不在未經同意下描繪真實人物。
不經過濾生成成人圖片,不需要 GPU,也不用下載。
開啟圖片生成器 →
SFT 與 Base:該選哪個檢查點
兩個檢查點共用相同的 5B 架構,但針對的使用者不同。SFT 以精選資料做過監督式微調,官方並排對比圖顯示它的文字分組更整齊、頁面版面更乾淨,只想直接生出好圖就載入它。Base 跳過了這道後訓練,更接近原始模型,因此是訓練 LoRA 與完整微調更好的起點。
| SFT | Base | |
|---|---|---|
| 最適合 | 直接生成圖片 | 微調與 LoRA 訓練 |
| 文字與版面 | 官方範例中分組更整齊 | 較鬆散、更原始的輸出 |
| 訓練 | 兩款訓練器皆支援 | 建議的起點 |
開始執行:Hugging Face、ComfyUI、diffusers 與 API
有四個簡單入口。最快的試用方式是 OpenMOSS-Team 的免費 Hugging Face Space。本地使用的話,目前的 ComfyUI nightly 版本已原生支援,搭配 Comfy-Org 重新打包的檔案和內建載入器即可;官方儲存庫的外掛在載入 diffusers 資料夾時依然好用。寫程式的人可以在 diffusers 0.38 以上,透過自訂的 pipeline_moss_image 與 trust_remote_code 載入權重,環境需 Python 3.10+、PyTorch 2.9+ 與 NVIDIA GPU。不想自己架設的團隊,可以透過 MOSI API 平台呼叫。
- 預設取樣:50 步、CFG 3、shift 5、流匹配 Euler。
- 寬高必須是 16 的倍數;官方範例使用 1024x1024 與 1456x1456。
- 引導每一步要跑兩次,所以會比蒸餾模型慢。
- 社群的 8 步 DMD 蒸餾版以些微畫質換取快得多的草稿速度。
VRAM、速度與量化版本
OpenMOSS 沒有公布最低 VRAM 需求,而是在 Gradio 示範中提供三種記憶體模式:GPU resident 把所有東西放在顯示卡上以求速度,Component 讓元件在 CPU 與 GPU 之間搬移,Sequential 則是最慢但最省記憶體的備案。如果遇到記憶體不足錯誤,可以切換到 Sequential、降低解析度或改用量化檔。Hugging Face 上列有 13 個由社群製作的 Base 模型量化衍生版本;由於畫質與支援程度因檔案而異,請查看各模型卡上的格式(例如 GGUF 或 FP8)以及需要的載入器。
用 KohakuMossTrainer 訓練你自己的風格
微調正是開放權重的價值所在。發布兩天後推出的 KohakuMossTrainer 支援兩個檢查點的完整微調以及 LyCORIS 或 LoRA 轉接器,README 表示轉接器最低只需 6GB VRAM 就能訓練。DiffSynth-Studio 同樣支援完整微調與 LoRA。短短十天內,Hugging Face 上已有 41 個轉接器和 36 個以 Base 模型為基礎的微調模型,從畫風到修正類都有,例如能撫平色彩斷層的社群 DeBand LoRA。建議在 Base 上訓練,標註文字保持和你平常寫提示詞相同的風格,並加入你希望 LoRA 學會的文字。
與 FLUX.2、Qwen-Image、Z-Image 比較
目前還沒有官方基準測試把這些模型放在一起比較,所以請把以下內容當作實用比較,而非評分表。明顯的差異在於規模、版面控制與編輯能力:
| MOSS-Image | FLUX.2 dev | Qwen-Image | Z-Image | |
|---|---|---|---|---|
| 規模 | 約 5B | 32B | 20B | 6B |
| 座標式版面提示詞 | 有,JSON 方框 | 無 | 無 | 無 |
| 照片編輯 / 參考圖 | 無 | 有 | 另有編輯模型 | 另有編輯模型 |
| 目前生態系 | 新興、快速成長 | 龐大 | 龐大 | 龐大 |
規模數據來自各模型公開的發布說明;這款模型目前尚未公布量化的基準測試結果。
自架 MOSS-Image 與在 Spicy AI 線上生成比較
| 本地部署(官方權重) | Spicy AI 線上版 | |
|---|---|---|
| 內容過濾 | 本地執行時無 | 無內容過濾 |
| 開放權重 | 有 | 不需要 — 直接在瀏覽器執行 |
| 模型 | Base 或 SFT 檢查點 | 類似的無審查圖片模型,線上託管 |
| 入門成本 | 自備 GPU | 提供免費方案 |
常見問題
大家最常用它做什麼?
最多的是帶有清晰標題的海報、網店橫幅和社群封面,其次是字幕直接畫進圖裡的迷因、白板解說圖,以及成人模特兒的魅力寫真。
它能編輯照片或使用參考圖嗎?
目前還不行。它只是文字生成圖片模型,編輯與參考圖功能不在這次發布範圍內。
它支援中文字嗎?
支援。它能呈現中文與英文,把確切的文字放進引號能得到最穩定的字形。
需要多少 VRAM?
官方沒有給出數字。示範提供省記憶體的 Sequential 模式,社群也有量化檔,LoRA 轉接器約 6GB 即可訓練。
要怎麼在 ComfyUI 中使用?
更新到已原生支援的最新 nightly 版本,再用內建載入器載入 Comfy-Org 重新打包的檔案即可。
Spicy AI 與 OpenMOSS 有合作關係嗎?
沒有。Spicy AI 是獨立平台,與 OpenMOSS 無任何隸屬或背書關係。模型名稱為其各自所有者的商標。