Imagen IA sin censura · SupraLabs
Supra2-IMG sin censura: un modelo de imagen de bolsillo que funciona casi en cualquier parte
Preguntar a la IA ▾
¿De verdad puede dibujar un modelo de apenas unos 100 millones de parámetros? Supra2-IMG dice que sí. Publicado por SupraLabs en Hugging Face en el otoño de 2026, este diminuto modelo de texto a imagen convierte una frase corta en inglés en una imagen de 256×256, y es lo bastante pequeño para funcionar en un portátil normal, un Mac, dentro de una pestaña del navegador o incluso en un móvil. Los pesos abiertos se ejecutan en local sin ningún filtro en línea, y por eso la gente busca Supra2-IMG sin censura.
- Empieza gratis
- Sin filtros
- Funciona en el navegador
Generador de imágenes alternativo sin censura
Texto a imagenDescribe la imagen que quieres. Añade una foto de referencia para editarla o déjalo vacío para texto a imagen.
100 millones de parámetros que aun así pintan una imagen
La mayoría de los generadores de imágenes conocidos pesan miles de millones de parámetros y necesitan una tarjeta gráfica seria. Este va en sentido contrario. El núcleo de dibujo es un transformer de difusión de solo 104,1 millones de parámetros, aproximadamente una octava parte de la UNet de 860 millones de parámetros de Stable Diffusion 1.5, y el archivo de pesos ocupa apenas unos 417MB. Lee tu prompt con el compacto codificador de texto Flan-T5-base de Google y decodifica las imágenes con el conocido VAE de Stability AI. Más sorprendente aún es lo barato que fue crearlo: SupraLabs lo entrenó desde cero con 5,6 millones de imágenes sintéticas del conjunto de datos FLUX-Reason-6M durante diez épocas, usando una sola GPU H100 durante unas nueve horas, preparación de datos incluida. El equipo indica un FID de 27,9 y una puntuación CLIP de 29,4 sin nombrar el conjunto de prueba, así que tómalos como datos autodeclarados. La idea no es superar en detalle a los modelos grandes, sino demostrar que una imagen reconocible y agradable puede salir de algo que cabe en casi cualquier dispositivo.
Dónde brilla un modelo de imagen diminuto
Ser pequeño y rápido cambia para qué sirve un modelo de imagen. En lugar de un póster perfecto, obtienes un bloc de bocetos que funciona sin conexión, arranca al instante y nunca pide una cuenta. La gente lo usa para miniaturas de concepto rápidas antes de un render más grande, iconos sencillos y arte provisional para apps y juegos, tableros de ambientación para historias y demostraciones en clase que enseñan cómo funciona la difusión sin alquilar una GPU en la nube. Como cada imagen cuesta tan poco, también va bien para jugar por lotes: genera una docena de variaciones de la misma idea y quédate con la que te guste.
| Escenario | Qué creas | Por qué encaja un modelo diminuto |
|---|---|---|
| Bocetos sin conexión | Miniaturas de concepto en el tren o el avión | No hace falta internet ni una GPU potente |
| Apps y juegos indie | Iconos, losetas y arte provisional | El tamaño pequeño encaja con recursos pequeños |
| Historias y tableros de ambientación | Escenas y atmósferas para escribir | Muchas variaciones rápidas entre las que elegir |
| Enseñanza y aprendizaje | Un modelo de difusión funcional para estudiar | Lo bastante pequeño para leerlo, ejecutarlo y reentrenarlo |
| Duelos de modelos | Pruebas lado a lado de modelos diminutos | Lo bastante rápido para comparar decenas de prompts |
Plantillas de prompts que funcionan a 256 píxeles
Los textos de entrenamiento siguen un orden sencillo: primero la composición, luego el sujeto y después el estilo y la imaginación. Copia ese orden, mantén los prompts cortos y en inglés, y no superes el límite de 128 tokens del codificador de texto. Un único sujeto claro por frase funciona mejor que escenas abarrotadas con muchas personas. Prueba estas plantillas y cambia una palabra cada vez con una semilla fija:
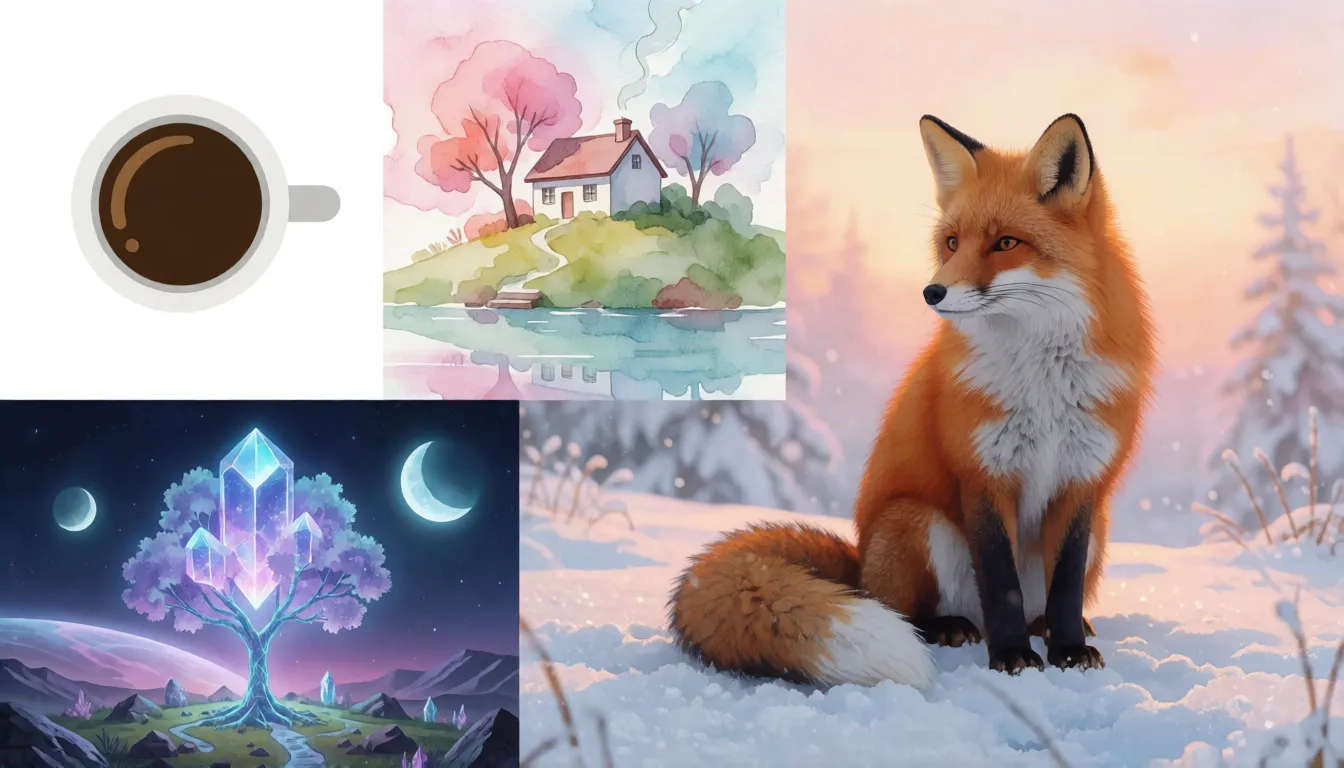
- Composición y sujeto: "a close-up of a red fox sitting in fresh snow, centered, soft morning light"
- Ambiente y escenario (el ejemplo de los autores): "a sea jellyfish floating in the pitch-black ocean depths"
- Estilo artístico: "a tiny cottage on a hill, watercolor painting, pastel colors"
- Iconos y recursos: "a flat minimal icon of a coffee cup, white background"
- Imaginación: "a glowing crystal tree on an alien planet, two moons in the sky, fantasy art"
- Retrato: "portrait of an adult woman with curly hair, studio lighting, neutral background"
Evita textos largos dentro de la imagen e interacciones complejas entre varias personas; el modelo es demasiado pequeño para resolverlos bien.
Cómo ejecutar Supra2-IMG en tres pasos
La instalación es sorprendentemente sencilla. Descarga los pesos model_final_ema.pt y el script inference.py del repositorio de SupraLabs en Hugging Face, instala PyTorch y ejecuta un solo comando. El script elige tu hardware automáticamente: primero una GPU NVIDIA en bf16, después Apple Silicon mediante MPS y, como último recurso, la CPU. Si solo quieres ver resultados, el Space de demostración de SupraLabs y el Space Supra-IMG Studio te permiten probarlo en línea desde el navegador sin instalar nada.
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/model_final_ema.pt
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
  --seed 0 --cfg 3.0 --steps 50 --n 1 --out out.png
Los valores por defecto de los autores son CFG 3.0, 50 pasos y semilla 0; --n genera varias imágenes en una sola ejecución.
Ejecutarlo en una CPU, un Mac o una tarjeta gráfica antigua
Aquí es donde el tamaño reducido compensa de verdad. El conjunto completo de modelo de dibujo, codificador de texto y VAE es diminuto para los estándares actuales, así que portátiles corrientes, Mac con chips de la serie M y tarjetas gaming antiguas son objetivos realistas. SupraLabs no ha publicado cifras de velocidad ni de memoria, y el propio script avisa de que en CPU irá lento, así que cuenta con segundos o minutos por imagen según tu equipo. Algunos ajustes te ayudan a cambiar calidad por velocidad:
- Mantén el CFG en torno a 3.0; vale la pena probar valores entre 2 y 5 para que siga el prompt con más o menos fuerza.
- En CPU, prueba de 20 a 30 pasos en lugar de 50 para borradores más rápidos y luego repite tu semilla favorita con todos los pasos.
- Usa --n para generar varias imágenes por lote y elegir la mejor en lugar de pulir una sola.
- Mantén la semilla fija mientras editas el prompt para ver qué cambia cada palabra.
En el navegador y en el móvil: ONNX, WebGPU y safetensors
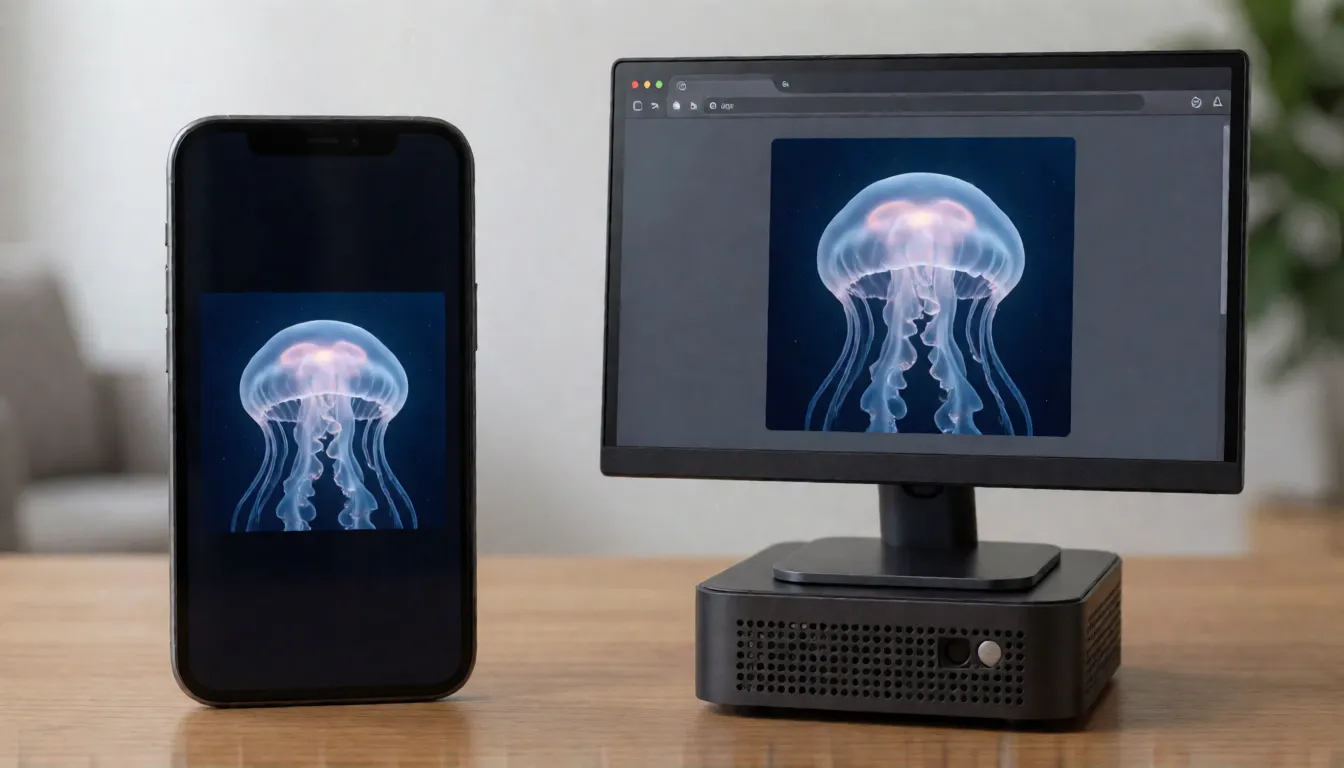
Pocas semanas después del lanzamiento, la comunidad empezó a llevar el modelo a nuevos lugares. Bartholomheow/Supra2-IMG-ONNX y sm079/supra2-img-web lo empaquetan para WebGPU, de modo que puede dibujar dentro de una pestaña del navegador sin nada de Python. mikhsol/Supra2-IMG-mobile-onnx ofrece una versión int8 pensada para móviles. Si prefieres el formato safetensors, más seguro que el archivo .pt original, malcolmrey/Supra2-IMG y mondk/Supra2-Safetensors ofrecen pesos convertidos. Son proyectos comunitarios incipientes con pocas descargas por ahora, así que espera asperezas y revisa las notas de cada repositorio.
Sliders LoRA, ajustes finos y entrenar el tuyo desde cero
Un modelo tan pequeño es un patio de recreo para los aficionados a trastear. ntc-ai/supra-particle-sliders añade sliders de concepto que puedes subir o bajar para cambiar un aspecto, y NZUONG/supra2-img-face-grpo es un ajuste fino experimental que usa aprendizaje por refuerzo para mejorar los retratos. FlameF0X/Tiny-T2I-Arena pone varios modelos diminutos de texto a imagen lado a lado para que votes los resultados. Lo que más atrae a quienes aprenden es la propia receta de entrenamiento: una H100 alquilada durante unas nueve horas basta para entrenar un transformer de difusión desde cero, lo que convierte un proyecto de laboratorio en un experimento de fin de semana. SupraLabs reconoce HobbyLM-Image de rootxhacker como la inspiración de ese espíritu de hazlo tú mismo.
- Sliders: ajusta un único concepto sin reescribir el prompt.
- Ajustes finos: especializa el modelo en caras, iconos o un estilo artístico.
- Desde cero: sigue el mismo conjunto de datos y el presupuesto de una sola GPU para entrenar el tuyo.
Los modelos de texto a imagen más pequeños comparados: Stable Diffusion y SANA
Este modelo no intenta ganar en calidad de imagen; su gran baza es estar entre los modelos de imagen más pequeños y baratos que puedes ejecutar y reentrenar. Así se sitúa frente a nombres conocidos:
| Supra2-IMG | Stable Diffusion 1.5 | SANA | HobbyLM-Image | |
|---|---|---|---|---|
| Tamaño del modelo de dibujo | 104M | Unos 860M (UNet) | De 0,6B a 1,6B | Modelo aficionado pequeño |
| Resolución | 256×256 | 512×512 | Hasta 4096×4096 | Baja resolución |
| Ecosistema comunitario | Nuevo y pequeño | Enorme | En crecimiento | Pequeño |
| Ideal para | Dispositivos diminutos, aprendizaje | Herramientas y extensiones maduras | Imágenes rápidas en alta resolución | Entrenamiento por afición |
Los tamaños y resoluciones proceden de la ficha del modelo o el artículo público de cada proyecto.
Qué esperar de los resultados
Unas expectativas honestas lo hacen más divertido. Cada imagen es de 256×256, así que los detalles finos como manos, caras en una multitud y objetos pequeños quedan difusos, y las letras dentro de las imágenes salen flojas. Solo entiende prompts en inglés. Como todas las imágenes de entrenamiento fueron generadas por FLUX, los resultados tienden a ese aspecto brillante y bien iluminado de FLUX. Si necesitas una imagen más grande, pasa el resultado por un escalador como Real-ESRGAN; si necesitas detalle nítido, un modelo más grande es la mejor herramienta.
- Muy bueno en: sujetos únicos, paisajes, ambientes, iconos sencillos y estilos artísticos.
- Flojo en: texto en imágenes, multitudes, manos y detalles diminutos.
- Consejo: escala tu resultado favorito en lugar de pedirle más detalle al modelo pequeño.
¿Es sin censura? NSFW y arte para adultos
Ejecutados en tu propio equipo, los pesos abiertos no tienen filtro en línea, y el script de inferencia no incluye ningún verificador de seguridad ni filtro NSFW, así que nada inspecciona tu prompt ni la imagen final. Eso no significa que se le dé bien el contenido adulto: aprendió de imágenes generadas por FLUX, su capacidad para dibujar escenas explícitas es desconocida y, en el momento de escribir esto, no existía ningún ajuste fino comunitario NSFW o sin censura. Si quieres arte para adultos sin filtros, con calidad completa y sin instalar nada, un generador de imágenes sin censura en línea es la vía práctica.
Arte pin-up y glamour
Pin-ups retro y retratos glamour de modelos adultas con luz de estudio suave.
Bañadores y escenas de playa
Escenas soleadas con bikini y bañador de personas adultas en la playa y junto a la piscina.
Personajes de fantasía
Hechiceras, guerreras y héroes adultos con atuendos atrevidos para tus historias.
- Describe el sujeto, la ropa, el escenario y la luz en una sola frase clara.
- Fija la semilla y cambia un detalle en cada ejecución.
- Indica que todas las personas mostradas son adultas (18+) y nunca representes a personas reales sin su consentimiento.
Crea imágenes para adultos sin filtros, sin descargas ni GPU.
Abrir el generador de imágenes →Lo que viene: Supra2.5-IMG
La ficha del modelo de SupraLabs menciona una posible continuación llamada Supra2.5-IMG, pero no se ha publicado y todavía no se sabe si aumentará la resolución o el tamaño. SupraLabs se especializa en modelos muy pequeños, desde los modelos de lenguaje Supra-50M y Supra2-100M-Instruct hasta SupraTTS, así que otro lanzamiento compacto encajaría con la tendencia. Seguir la página de SupraLabs en Hugging Face es la forma más fácil de enterarte cuando llegue.
Alojar Supra2-IMG tú mismo vs generar en línea con Spicy AI
| Despliegue local (pesos de los autores) | Spicy AI en línea | |
|---|---|---|
| Filtros de contenido | Ninguno al ejecutarlo en local | Sin filtros de contenido |
| Pesos abiertos | Sí | No hacen falta: funciona en el navegador |
| Modelo | Checkpoint de 104M parámetros, 256×256 | Modelo de imagen sin censura similar, alojado en línea |
| Coste para empezar | Tu propio ordenador | Plan gratuito disponible |
Preguntas frecuentes
¿Quién lo creó y cuándo se publicó?
SupraLabs lo publicó en Hugging Face. El repositorio se creó el 21 de septiembre de 2026 y se actualizó por última vez el 10 de octubre de 2026.
¿Puede funcionar en una CPU?
Sí. El script de los autores admite GPU NVIDIA, Apple MPS y la CPU. En CPU va más lento y no se han publicado tiempos de referencia.
¿Qué resolución genera?
Solo 256×256. Para imágenes más grandes, escala el resultado con una herramienta como Real-ESRGAN.
¿Entiende prompts en otros idiomas?
Funciona mejor en inglés. El codificador de texto Flan-T5-base y los textos de entrenamiento están en inglés, y los prompts deben quedarse por debajo de 128 tokens.
¿Puedo usarlo en un navegador o en el móvil?
Sí, mediante adaptaciones de la comunidad: versiones ONNX y WebGPU para navegadores y una versión ONNX int8 para móviles. Son proyectos incipientes.
¿Existe una versión en safetensors?
El archivo original es un checkpoint .pt de PyTorch, pero repositorios comunitarios como mondk/Supra2-Safetensors ofrecen pesos convertidos a safetensors.
¿Spicy AI está afiliado a SupraLabs?
No. Spicy AI es una plataforma independiente y no está afiliada ni respaldada por SupraLabs. El nombre del modelo pertenece a su respectivo propietario.
Fuentes
- Ficha del modelo de SupraLabs (Hugging Face)
- Configuración del modelo (config.json)
- Script de inferencia (inference.py)
- Demo en línea de los autores (Hugging Face Space)
- Conjunto de datos de entrenamiento FLUX-Reason-6M
- Codificador de texto Flan-T5-base
- Ficha del modelo Stable Diffusion v1.5
- Artículo de SANA (arXiv 2410.10629)
- Tiny-T2I-Arena (Space de la comunidad)
- Adaptación ONNX para WebGPU de Bartholomheow (comunidad)