Imagen IA sin censura · OpenMOSS
MOSS-Image-SFT sin censura: borradores en 8 pasos, degradados limpios y tags de anime
Pregunta a la IA ▾
MOSS-Image-SFT es la versión lista para usar de MOSS-Image, el modelo de pesos abiertos de 5B del equipo OpenMOSS, lanzado el 16 de octubre de 2026. En su primer mes, la comunidad lo convirtió en una herramienta mucho más amigable: una versión destilada de 8 pasos para borradores rápidos, un LoRA que elimina las bandas verticales de color, pesos FP16 para tarjetas gráficas antiguas y la costumbre creciente de escribir prompts de anime como simples tags. Esta guía reúne esos trucos, además de plantillas de prompt que puedes pegar directamente.
- Empieza gratis
- Sin filtros
- Funciona en el navegador
Generador de imágenes alternativo sin censura
Texto a imagenDescribe la imagen que quieres, con las palabras entre comillas. Añade una foto de referencia para editarla o déjalo vacío para texto a imagen.
De Base a SFT: el checkpoint pensado para crear imágenes
OpenMOSS publicó dos checkpoints del mismo modelo single-stream de 5B. Base no tiene post-entrenamiento y está pensado como punto de partida limpio para entrenar LoRAs. MOSS-Image-SFT es Base ajustado con datos seleccionados, así que da buenas imágenes desde el principio y entiende tres tipos de prompt: frases normales, listas de tags estilo anime y layouts JSON con coordenadas. Las muestras oficiales de pizarras muestran textos mejor agrupados y composiciones más ordenadas en el lado SFT, aunque OpenMOSS no ha publicado una cifra para esa diferencia. Si solo quieres imágenes, este es el checkpoint que debes cargar; si quieres entrenar tu propio estilo, empieza por Base. Un mes después del lanzamiento, la página de SFT en Hugging Face mostraba 913 likes, unas 19.500 descargas en el último mes y 68 Spaces construidos sobre él.
8 pasos en lugar de 50: destilación DMD y Spectrum
La receta oficial pide 50 pasos de muestreo con guidance, algo cuidadoso pero lento. La comunidad de MOSS-Image-SFT lo solucionó rápido. lodestones publicó MOSS-Image-SFT-8-steps-dmd, una versión destilada que genera una imagen en 8 pasos e incluye un adaptador LoRA para ComfyUI. Además, el nodo ComfyUI-Spectrum-MOSS acelera aún más el muestreo saltándose trabajo entre pasos similares. OpenMOSS dice que su propia versión DMD sigue en desarrollo. Nadie ha publicado todavía un benchmark justo de velocidad o calidad, así que prueba en tu propia tarjeta, pero el reparto que adopta la mayoría es sencillo:
| Uso | Elección | Por qué |
|---|---|---|
| Buscar una composición, ideas en lote | DMD de 8 pasos | Muchos borradores en el tiempo de un render completo |
| Pósters con mucho texto | 50 pasos oficiales | El texto y los detalles pequeños aguantan mejor |
| Foto final de producto o portada | 50 pasos, opcionalmente con Spectrum | Mantiene la calidad y recorta la espera |
Arregla las bandas de color, tarjetas FP16 y ajustes de SLG
Pronto surgieron dos quejas. Algunos usuarios de MOSS-Image-SFT vieron rayas verticales tenues, o banding, en cielos y degradados suaves. MATLOWAI respondió con MOSS-Image-SFT-DeBand, un pequeño LoRA más un preset de ComfyUI que suaviza esas rayas. El segundo problema era de hardware: los pesos oficiales están en BF16, que muchas GPU antiguas no soportan. KBlueLeaf lanzó MOSS-Image-FP16-fixed, pesos ajustados para funcionar sin problemas en FP16. El último ajuste es el skip-layer guidance (SLG). El model card hace que la rama negativa salte la capa 22, y las pruebas de la comunidad vieron que las capas 24 o 26 también funcionan.
- Rayas en cielos o paredes: carga el LoRA DeBand con su preset.
- Imágenes negras o rotas en una tarjeta antigua: cambia a los pesos FP16-fixed.
- Quieres un aspecto más fotográfico: prueba a desactivar SLG, pero vigila las manos y los detalles pequeños.
- Los prompts cortos quedan planos: sube el CFG de 3 hacia 6, como sugiere el model card.
Tres formas de escribir un prompt para MOSS-Image-SFT
La mayoría de los modelos de imagen solo leen frases. MOSS-Image-SFT lee tres formatos y acepta prompts de hasta 4K tokens, en inglés (recomendado) o chino. Las frases normales son lo mejor para fotos y pósters con texto: pon las palabras exactas entre comillas y usa \n dentro del texto citado cuando necesites un salto de línea. Las listas de tags separadas por comas resultan naturales para los fans del anime. JSON sirve para layouts estrictos, donde cada título, producto o insignia tiene su propia caja. En el formato JSON, las cajas usan el orden yxyx medido desde el centro del lienzo, así que en una imagen de 1024 por 1024 cada eje va de -512 a 512. La skill oficial Prompt Enhancer del repositorio de GitHub puede convertir un boceto en píxeles en esas coordenadas centradas por ti.
{
  "summary": { "caption": "Clean perfume ad, black stone, soft rim light" },
  "items": [
    { "label": "product", "caption": "glass perfume bottle", "bbox": [-200, -160, 360, 160] },
    { "label": "title", "caption": "thin gold serif", "bbox": [-460, -300, -320, 300], "text": "NOIR 07" }
  ],
  "bbox_format": "yxyx"
}
Plantillas de prompt para copiar y remezclar
Estas plantillas de MOSS-Image-SFT siguen el consejo oficial: describe la escena, pon el texto entre comillas y di dónde va. Usa entre 1 y 2 megapíxeles, cualquier relación de aspecto en múltiplos de 16, mantén la seed fija y cambia un detalle por tirada. La muestra oficial de la nota en la nevera es un buen calentamiento: un pósit en la puerta del frigorífico, escrito a mano en chino, recordando a alguien que compre leche y huevos.
- Póster de viaje: "Minimalist travel poster, bold title text \"EXPLORE KYOTO\" at top, red torii gate at sunset, small subtitle \"Autumn 2026\" at bottom, flat illustration, high contrast"
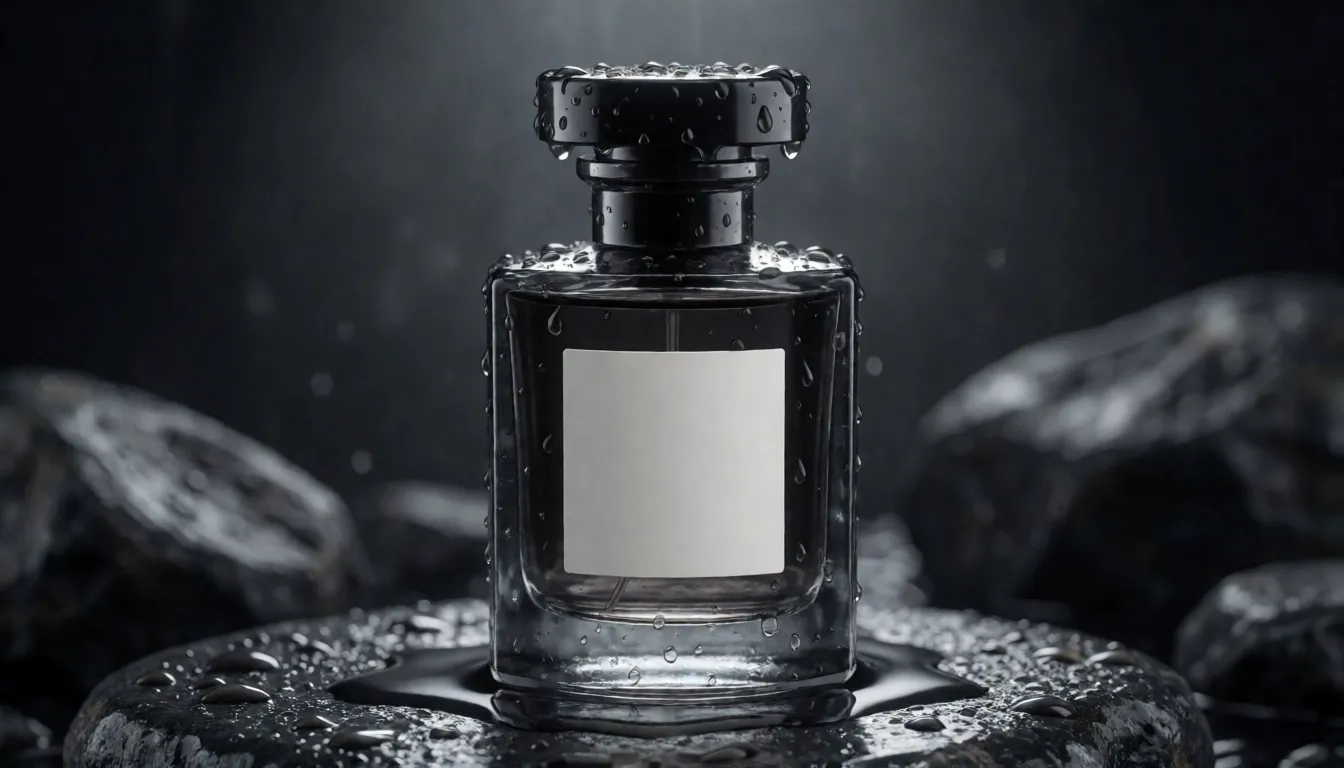
- Foto de producto: "Product photo of a glass perfume bottle on wet black stone, label text \"NOIR 07\", soft rim light, studio"
- Nota manuscrita: "A wide view of a refrigerator beside a kitchen counter, a sticky note on the door handwritten: \"Buy milk and eggs!\""
- Portada vertical: "Vertical web novel cover, adult couple in the rain under one umbrella, title \"Midnight Contract\" in silver letters, cinematic"
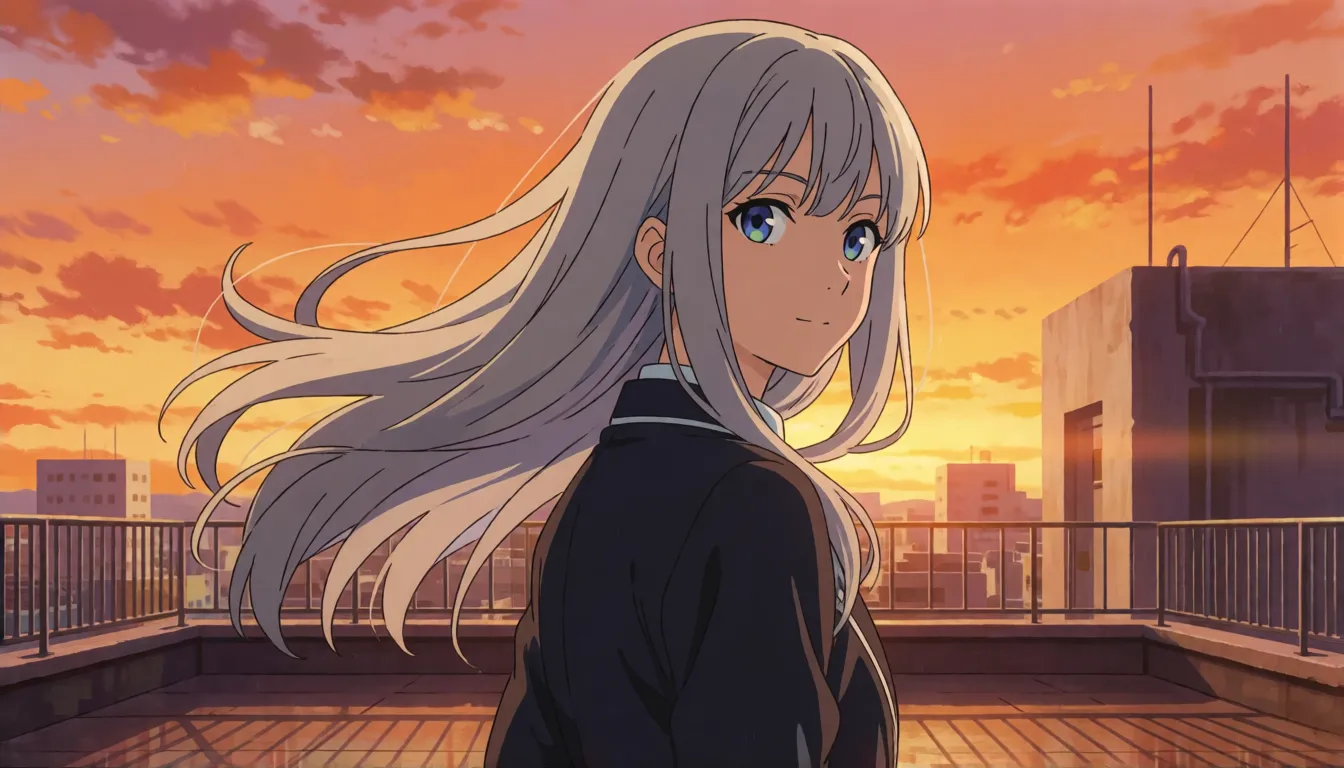
- Tags de anime: "best quality, highres, newest, 1girl, adult, silver hair, school rooftop, sunset, wind, looking back"
Arte anime con tags estilo Danbooru
Los creadores de anime se llevan una grata sorpresa con MOSS-Image-SFT: puedes olvidarte de las frases largas y escribir tags cortos, como en un sitio booru. La guía oficial de usuario incluso sugiere un orden: primero los tags de calidad, luego score, meta y año, después el personaje, la serie, el artista y por último los tags generales de pose, ropa y fondo. Seguir ese orden mantiene delante lo importante. Las primeras notas de la comunidad dicen que los tags con nombres de artistas tienen menos efecto que en modelos dedicados al anime, así que describe el estilo con palabras cuando importe y añade una frase completa tras los tags para la iluminación o el ambiente.
- Calidad → Score → Meta → Año → Personaje → Serie → Artista → Generales
- Empieza con: best quality, highres, newest
- Añade pose y escenario al final: looking back, rooftop, sunset, wind
Pósters y diseños donde las palabras importan
Las letras legibles son la razón por la que mucha gente prueba MOSS-Image-SFT. El informe técnico da una cobertura media de texto del 96,3% en el benchmark de texto largo LLTB, la mejor entre los modelos de pesos abiertos, y las muestras oficiales están llenas de pizarras, carteles y notas manuscritas en chino e inglés. Eso hace de MOSS-Image-SFT una buena opción para pósters bilingües de eventos, banners de tienda con precio, viñetas de cómic con bocadillos, infografías y portadas verticales para microdramas y web novels. Como funciona cualquier relación de aspecto, un mismo prompt sirve para un post cuadrado, un banner ancho y una story vertical para móvil.
Entrena tu propio LoRA de personaje o estilo
Pesos abiertos significa que puedes enseñarle al modelo tu propio personaje o estilo artístico. KohakuMossTrainer, lanzado el 18 de octubre, entrena adaptadores LoRA y LyCORIS con solo 6GB de VRAM, y DiffSynth-Studio admite tanto fine-tuning completo como LoRA. El consejo habitual es entrenar sobre Base y luego cargar el resultado con MOSS-Image-SFT. El ecosistema aún es pequeño pero crece rápido: el árbol de modelos de SFT en Hugging Face lista 55 adaptadores, 23 fine-tunes y 2 merges. Escribe los captions en el mismo estilo con el que piensas hacer los prompts: tags para personajes de anime y frases para estilos fotográficos.
Online, API, archivos cuantizados y servidores
No necesitas instalar nada en local para probar MOSS-Image-SFT. El Space oficial de Hugging Face lo ejecuta en el navegador, y la plataforma de API MOSI ofrece acceso alojado desde el 20 de octubre (consulta su web para ver los precios actuales). Para equipos con su propio servicio, SGLang y vLLM-Omni soportan el modelo desde el primer día y ambos publican recetas de despliegue. Quien tenga poca VRAM puede explorar las 48 versiones cuantizadas del árbol de modelos, incluidos archivos GGUF; revisa en cada card qué loader necesita. En Mac, Draw Things y DiffusionBee son las apps habituales para generar en local.
MOSS-Image-SFT vs FLUX y Qwen-Image
No hay una puntuación oficial cara a cara, así que esta es una comparación práctica. MOSS-Image-SFT es pequeño, de unos 5B parámetros, lo que facilita ejecutarlo y entrenarlo en tarjetas de consumo. Sus puntos fuertes son el texto largo en chino e inglés y el control del layout mediante JSON. FLUX y Qwen-Image son más grandes y tienen bibliotecas mucho mayores de LoRAs y fine-tunes de la comunidad, además de modelos de edición aparte, así que siguen ganando cuando necesitas un estilo concreto que alguien ya ha entrenado.
| MOSS-Image-SFT | Familia FLUX | Qwen-Image | |
|---|---|---|---|
| Tamaño | Unos 5B | Mayor | Mayor |
| Prompts de layout con coordenadas | Sí, cajas JSON | No | No |
| Texto bilingüe largo | Principal fortaleza | Sobre todo inglés | Fuerte |
| LoRAs de la comunidad | Joven, en crecimiento | Muy grande | Grande |
MOSS-Image-SFT sin censura y arte para adultos
OpenMOSS no ha lanzado una versión sin censura. Los pesos de MOSS-Image-SFT son abiertos y nada los filtra cuando los ejecutas en local, pero el propio prompt negativo recomendado contiene la palabra nsfw, lo que muestra que la configuración por defecto tiende a imágenes seguras. En la comunidad existen LoRAs de temática adulta, pero su calidad y origen varían, así que revísalos con cuidado. Las direcciones adultas más populares son editoriales de bañadores, pósters pin-up y portadas de fantasía con personajes claramente adultos. Si prefieres saltarte la configuración, Spicy AI ofrece una generación de imágenes sin censura similar en el navegador.
Editoriales de bañadores
Sesiones soleadas en playa y piscina con modelos adultos y un título de revista arriba.
Pósters pin-up
Pin-ups retro de personajes adultos con el eslogan bien colocado.
Portadas de fantasía
Héroes y hechiceras adultos para portadas de libros o juegos con títulos legibles.
- Usa la versión de 8 pasos para explorar y luego renderiza la elegida con todos los pasos.
- Pon entre comillas cada palabra que quieras impresa y di dónde va.
- Indica que todas las personas mostradas son adultas (18+) y nunca representes a personas reales sin su consentimiento.
Crea imágenes de temática adulta en tu navegador, sin GPU ni descargas.
Abrir el generador de imágenes →Lo que crea la comunidad tras un mes
Los números lo dicen todo: poco después del lanzamiento la página de SFT tenía unos 130 likes y, un mes más tarde, la página de SFT superó los 900 likes, con 48 archivos cuantizados y decenas de adaptadores en su árbol de modelos y unas 2,6k estrellas en GitHub. La mayoría de las imágenes de MOSS-Image-SFT compartidas encajan en unos pocos grupos: pósters de viaje retro, portadas de revista bilingües, notas manuscritas y memes de pizarra, personajes de anime a partir de prompts con tags y fotos de producto con mucha atmósfera para tiendas online.
- Pósters retro con títulos grandes y legibles
- Portadas bilingües y flyers de eventos
- Notas manuscritas, tickets y chistes de pizarra
- Personajes de anime a partir de tags estilo booru
- Fotos de producto con etiquetas de estilo de marca
MOSS-Image-SFT autoalojado vs generar online en Spicy AI
| Despliegue local (pesos oficiales) | Spicy AI online | |
|---|---|---|
| Filtros de contenido | Ninguno al ejecutarlo en local | Sin filtros de contenido |
| Pesos abiertos | Sí | No hacen falta — funciona en el navegador |
| Modelo | Checkpoint SFT más complementos de la comunidad | Modelo de imagen sin censura similar, alojado online |
| Precio para empezar | Tu propia GPU | Plan gratuito disponible |
Preguntas frecuentes
¿Qué diferencia hay entre MOSS-Image-SFT y Base?
SFT es Base ajustado con datos seleccionados, así que produce mejores imágenes de serie y entiende frases, tags y JSON. Base no tiene post-entrenamiento y es mejor para entrenar LoRAs. OpenMOSS no ha publicado una comparación numérica.
¿Tengo que usar 50 pasos?
50 pasos es la recomendación oficial. La versión DMD de 8 pasos de la comunidad, creada por lodestones, lo reduce mucho; una versión DMD oficial sigue en desarrollo.
¿Cómo arreglo las rayas verticales o el banding?
Prueba el LoRA comunitario MOSS-Image-SFT-DeBand con su preset de ComfyUI, o experimenta con los ajustes de skip-layer guidance.
Mi GPU no soporta BF16. ¿Puedo ejecutarlo igualmente?
Sí. Los pesos comunitarios MOSS-Image-FP16-fixed de KBlueLeaf están hechos para tarjetas que solo admiten FP16.
¿Puede escribir texto en chino?
Sí. Renderiza textos largos en chino e inglés, con una cobertura media del 96,3% en el benchmark LLTB según el informe técnico. Añade \n dentro del texto citado para saltos de línea exactos.
¿Puedo usar tags de anime?
Sí. El orden oficial es Quality, Score, Meta, Year, Character, Series, Artist y, por último, los tags General.
¿Spicy AI está afiliado a OpenMOSS?
No. Spicy AI es una plataforma independiente y no está afiliada ni respaldada por OpenMOSS. El nombre del modelo es una marca de su respectivo propietario.
Fuentes
- Model card de MOSS-Image-SFT (Hugging Face)
- Model card de MOSS-Image-Base (Hugging Face)
- Repositorio de OpenMOSS (GitHub)
- Guía de usuario: prompts y ajustes (GitHub)
- Informe técnico (arXiv 2610.23374)
- Versión destilada DMD de 8 pasos (lodestones)
- LoRA DeBand (MATLOWAI)
- Pesos FP16-fixed (KBlueLeaf)
- Nodo ComfyUI-Spectrum-MOSS
- KohakuMossTrainer
- Demo online oficial (Hugging Face Space)
- Receta de despliegue de SGLang
- Receta de vLLM-Omni