Imagen con IA sin censura · OpenMOSS
MOSS-Image sin censura: pesos abiertos que colocan el texto justo donde quieres
Pregunta a la IA ▾
MOSS-Image es un modelo de texto a imagen de unos 5B de parámetros del equipo OpenMOSS, publicado con pesos abiertos el 16 de octubre de 2026. Su gran baza es un texto que de verdad se puede leer: titulares en chino e inglés, notas manuscritas y etiquetas aparecen dentro de la imagen, y un modo de layout en JSON permite fijar cada título, producto o logo en coordenadas exactas. Como los pesos se ejecutan en tu propia GPU sin filtro en línea, los checkpoints descargables son el MOSS-Image sin censura del que hablan los creadores que trabajan en local.
- Empieza gratis
- Sin filtros
- Funciona en el navegador
Generador de imágenes alternativo a MOSS-Image sin censura
Texto a imagenDescribe la imagen que quieres, con las palabras entre comillas. Añade una foto de referencia para editarla o déjalo vacío para texto a imagen.
Prueba un prompt
Los prompts de ejemplo están en inglés, lo que da los resultados más fiables.
Por qué diseñadores y vendedores le prestan atención
Piensa en este modelo como un generador de imágenes abierto que por fin trata las palabras como parte de la imagen. Escribe un titular, un precio o una nota entre comillas y aparece legible en la imagen, en inglés o chino, justo donde lo indica el diseño. Esa habilidad convierte un juguete divertido en algo que tiendas, estudios y equipos de redes sociales pueden usar para trabajar. Los pesos se descargan gratis y funcionan en tu propia GPU, así que no hay coste por imagen ni filtro en línea entre tu prompt y el resultado.
Texto legible en chino e inglés dentro de la imagen
La mayoría de los modelos de imagen abiertos todavía desordenan las letras, y los caracteres chinos son los que más sufren. Este modelo se entrenó para renderizar ambos idiomas, y las muestras oficiales lo aprovechan: una nota en la nevera escrita a mano en chino con una lista de la compra de leche, huevos y pan, pizarras llenas de apuntes, rótulos de tiendas y titulares de pósters. El truco es sencillo. Pon las palabras exactas entre comillas y di dónde van y qué aspecto tienen, por ejemplo "a bold red headline reading \"SUMMER SALE\" across the top". Las frases cortas salen más limpias que los párrafos, y en las comparativas oficiales el checkpoint SFT agrupa y alinea el texto con más orden que Base.
- Pon entre comillas cada palabra que quieras imprimir, en el idioma que quieras.
- Describe la superficie: pósit, letrero de neón, pizarra, portada de revista.
- Indica el estilo de las letras: manuscrito, sans-serif en negrita, caligrafía a pincel.
- Mantén cada bloque de texto breve; divide los textos largos en varios elementos etiquetados.
Dónde destaca: pósters, banners de tienda e infografías
Como las palabras y la colocación son sus puntos fuertes, el modelo encaja en los trabajos donde una imagen bonita no basta. Los vendedores online maquetan banners de producto con una etiqueta de precio en la esquina, los community managers preparan portadas con títulos bilingües, y los creadores de microdramas y webcómics bocetan pósters y viñetas con los diálogos ya colocados. Profesores y profesionales del marketing lo usan para explicaciones en pizarra e infografías, los restaurantes para menús y carteles, y los equipos de marca para series de layouts iguales en los que solo cambia el titular.
| Escena | Lo que pides | Por qué funciona |
|---|---|---|
| Banner de tienda | Producto en el centro, titular arriba, etiqueta en una esquina | Las cajas JSON mantienen cada elemento donde lo planeaste |
| Portada bilingüe para redes | Título en chino y subtítulo en inglés | Ambas escrituras se leen con claridad |
| Póster de serie o cómic | Personajes, eslogan y bocadillos | Los prompts largos admiten muchos detalles a la vez |
| Explicación en pizarra | Pasos escritos a mano y dibujos sencillos | Los estilos manuscritos se ven naturales |
| Menú o cartel | Nombres de platos y precios en filas | Las líneas cortas de texto quedan nítidas |
Convertirlo en negocio: banners, menús y pruebas de anuncios
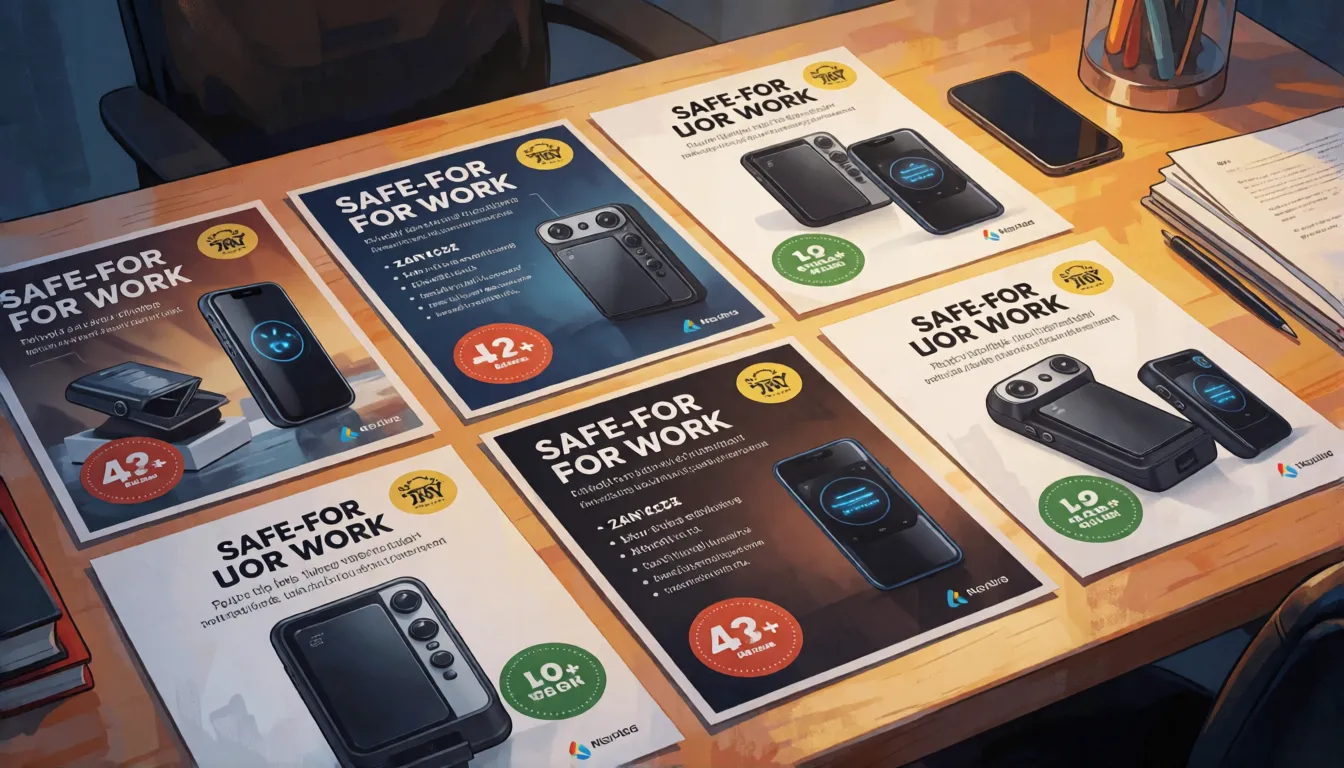
Quienes más lo aprovechan son equipos pequeños que necesitan muchas piezas con texto, rápido. Una tienda online puede preparar los banners promocionales de una semana en una tarde, cada uno con el producto al centro, el descuento en una pegatina y el titular en dos idiomas. Las agencias usan el mismo diseño JSON para sacar decenas de variantes de anuncio que solo cambian el eslogan, lo que abarata las pruebas A/B. Cafeterías y restaurantes maquetan menús y pizarras de ofertas, las imprentas ofrecen pósteres personalizados y los estudios de webcómic y microdramas esbozan portadas con el título ya colocado antes de que un diseñador pula el archivo final.
| Quién | Qué crea | Por qué compensa |
|---|---|---|
| Tienda online | Banners semanales y etiquetas de precio | Diseño fijo, solo cambia el texto |
| Agencia | Muchas variantes de eslogan para pruebas A/B | Mismo JSON, texto nuevo en segundos |
| Restaurante o cafetería | Menús, pizarras de ofertas, carteles | Las líneas cortas salen nítidas |
| Estudio de cómic o series | Bocetos de portada con título y lema | Ahorra rondas de maquetación |
| Diseñador freelance | Maquetas para clientes antes de la versión final | Primeros borradores más rápidos |
Qué dice la comunidad y qué está creando la gente
En Civitai, donde los creadores comparten imágenes y modelos, los primeros comentarios son en su mayoría positivos. Un usuario lo calificó como uno de los modelos abiertos con más conocimiento para imágenes realistas y elogió cómo maneja tanto el anime como el estilo fotográfico. Otros señalaron puntos débiles: manos y extremidades a veces salen mal, las etiquetas de estilo con nombres de artistas apenas tienen efecto y la configuración por defecto es lenta; un usuario contó más de 100 segundos por imagen hasta que una LoRA turbo de la comunidad lo redujo a una décima parte, con la piel algo más suave. Diez días después del lanzamiento, el repositorio de GitHub tenía unas 1,9 mil estrellas y la página del modelo Base 556 me gusta. ¿Qué publica la gente? Pósteres de viaje retro inventados, portadas de revista bilingües, notas de nevera y pizarras escritas a mano, memes con el texto integrado, fichas de personajes de anime con nombres y sesiones de playa glamurosas con modelos adultas.
- Pósteres retro de viajes y películas con títulos grandes y legibles
- Portadas bilingües chino-inglés para revistas y redes
- Notas, tickets y chistes de pizarra para memes
- Fichas de personajes de anime con nombres y estadísticas impresas
- Sesiones de bañador y pin-up de modelos adultas con rótulos de revista
Ejemplos de prompts de MOSS-Image para copiar
El modelo entiende tres estilos de prompt, y cada uno sirve para un objetivo distinto. Las frases naturales son mejores para fotos y pósters, las listas de etiquetas resultan familiares a quienes usan anime y LoRAs de la comunidad, y el JSON es para layouts estrictos. Parte de estas plantillas, deja la seed fija y cambia un detalle cada vez:
- Lenguaje natural: "A cozy kitchen at morning, a handwritten note on the fridge reading \"milk, eggs, bread\", warm sunlight, photorealistic."
- Póster: "Retro travel poster of a seaside town, large title \"VISIT CAPRI\" at the top in cream serif letters, grainy print texture."
- Etiquetas: "adult woman, beach, sunset, bikini, film grain, 35mm, golden hour" (solo personajes adultos).
- Infografía: "Clean whiteboard with three numbered steps titled \"How to brew coffee\", simple marker drawings, flat lighting."
- Portada bilingüe: "Magazine cover, Chinese headline in bold brush strokes, English subtitle \"Night Market Guide\" below, neon street at night."
Prompts de layout JSON: fija títulos y productos por coordenadas
El modo JSON es lo que distingue a este modelo. En lugar de esperar que el titular caiga arriba, describes toda la escena en un resumen y luego enumeras elementos, cada uno con etiqueta, descripción, caja delimitadora y texto opcional. Las cajas usan el orden yxyx (arriba, izquierda, abajo, derecha) en coordenadas de píxel medidas desde el centro del lienzo, así que en una imagen de 1024 por 1024 cada eje va de -512 a 512, y los números deben coincidir con el tamaño que generes. OpenMOSS todavía considera el layout experimental, así que cuenta con retocar alguna caja. Un esqueleto para empezar:
{
  "summary": { "caption": "Bright summer shop banner, white studio background" },
  "items": [
    { "label": "title", "caption": "bold red headline", "bbox": [-460, -400, -300, 400], "text": "SUMMER SALE" },
    { "label": "product", "caption": "glass bottle of iced lemon tea", "bbox": [-220, -200, 380, 200] },
    { "label": "badge", "caption": "yellow round sticker", "bbox": [260, 260, 460, 460], "text": "-50%" }
  ],
  "bbox_format": "yxyx",
  "bbox_coord_space": "abs_centralized"
}
Los nombres de los campos siguen la guía de layout del repositorio oficial en GitHub; la skill oficial Prompt Enhancer también puede ampliar una frase hasta convertirla en una descripción o un layout detallado.
¿MOSS-Image es sin censura? LoRAs NSFW y arte adulto
En local, los pesos abiertos no tienen filtro en línea: nada revisa tu prompt ni la imagen final, así que tú decides lo que dibuja el modelo. OpenMOSS no ha publicado un checkpoint NSFW ni describe cómo filtró sus datos de entrenamiento, así que el detalle explícito depende de complementos de la comunidad. Un informe de segunda mano de AlphaSignal afirma que un "Moss-image-nsfw-uncensored-lora" con la palabra clave moss_xvstyle apareció en pocos días y funciona con Base y SFT; no se ha confirmado en páginas de Hugging Face ni de Civitai, así que tómalo con cautela. Las temáticas adultas más populares son editoriales de baño y lencería, pósters pin-up y portadas de fantasía con personajes claramente adultos. Si prefieres saltarte la configuración de la GPU, Spicy AI ofrece una generación de imágenes sin censura similar en el navegador.
Editoriales de bikini y baño
Sesiones soleadas en playa y piscina con modelos adultas y un título de revista arriba.
Pósters pin-up y boudoir
Pin-ups adultas retro y sesiones de lencería con el eslogan ya colocado.
Portadas de fantasía
Héroes y hechiceras adultos para portadas de libros o juegos con títulos legibles.
- Escribe entre comillas las palabras que quieras y di dónde van.
- Usa etiquetas para el aspecto de los personajes y frases completas para la luz y el ambiente.
- Fija la seed y cambia un detalle en cada generación.
- Indica que todas las personas que aparecen son adultas (18+) y nunca representes a personas reales sin su consentimiento.
Crea imágenes para adultos sin filtros, sin GPU ni descargas.
Abrir el generador de imágenes →
SFT vs Base: qué checkpoint elegir
Ambos checkpoints comparten la misma arquitectura de 5B, pero están ajustados para públicos distintos. SFT recibió fine-tuning supervisado con datos seleccionados, y las comparativas oficiales muestran un texto mejor agrupado y maquetaciones más limpias, así que es el que debes cargar cuando simplemente quieres buenas imágenes. Base se salta ese post-entrenamiento y se mantiene más cerca del modelo en bruto, lo que lo convierte en el mejor punto de partida para LoRAs y fine-tunes completos.
| SFT | Base | |
|---|---|---|
| Ideal para | Generar imágenes directamente | Fine-tuning y entrenamiento de LoRA |
| Texto y layout | Agrupación más limpia en las muestras oficiales | Resultado más suelto y en bruto |
| Entrenamiento | Compatible con ambos entrenadores | Punto de partida recomendado |
Ponlo en marcha: Hugging Face, ComfyUI, diffusers y API
Hay cuatro puertas de entrada sencillas. La prueba más rápida es el Hugging Face Space gratuito de OpenMOSS-Team. Para trabajar en local, ComfyUI admite el modelo de forma nativa en las builds nightly actuales, usando los archivos reempaquetados de Comfy-Org con los loaders integrados, mientras que el plugin del repositorio oficial sigue siendo útil para cargar carpetas de diffusers. Los programadores pueden cargar los pesos en diffusers 0.38 o superior con el pipeline personalizado pipeline_moss_image y trust_remote_code, en Python 3.10+ y PyTorch 2.9+ con una GPU NVIDIA. Los equipos que prefieran no alojar nada pueden llamarlo a través de la plataforma MOSI API.
- Muestreo por defecto: 50 pasos, CFG 3, shift 5, Euler con flow matching.
- El ancho y el alto deben ser múltiplos de 16; los ejemplos oficiales usan 1024x1024 y 1456x1456.
- La guidance hace dos pasadas por paso, así que será más lento que los modelos destilados.
- Una versión destilada DMD de 8 pasos creada por la comunidad sacrifica algo de calidad a cambio de borradores mucho más rápidos.
VRAM, velocidad y versiones cuantizadas
OpenMOSS no publica una cifra mínima de VRAM. En su lugar, la demo de Gradio ofrece tres modos de memoria: GPU resident mantiene todo en la tarjeta para ganar velocidad, Component mueve partes entre CPU y GPU, y Sequential es la opción de poca memoria, la más lenta. Si te salen errores de falta de memoria, cambia a Sequential, baja la resolución o prueba un archivo cuantizado. Hugging Face lista 13 derivados cuantizados del modelo Base, hechos por la comunidad; revisa la model card de cada uno para ver su formato, como GGUF o FP8, y qué loader necesita, porque la calidad y la compatibilidad varían de un archivo a otro.
Entrena tu propio estilo con KohakuMossTrainer
El fine-tuning es donde los pesos abiertos dan sus frutos. KohakuMossTrainer, publicado dos días después del lanzamiento, permite fine-tuning completo y adaptadores LyCORIS o LoRA para ambos checkpoints, y su README indica que los adaptadores pueden entrenarse con solo 6GB de VRAM. DiffSynth-Studio también admite fine-tuning completo y LoRA. En diez días Hugging Face ya contaba 41 adaptadores y 36 fine-tunes basados en el modelo Base, desde estilos artísticos hasta correcciones como un LoRA DeBand de la comunidad que suaviza el banding de color. Entrena sobre Base, escribe las descripciones en el mismo estilo que usarás en los prompts e incluye el texto que quieres que aprenda el LoRA.
Cómo se compara con FLUX.2, Qwen-Image y Z-Image
Todavía no hay ningún benchmark oficial que compare estos modelos lado a lado, así que tómalo como una comparación práctica y no como una tabla de puntuaciones. Las diferencias claras están en el tamaño, el control del layout y la edición:
| MOSS-Image | FLUX.2 dev | Qwen-Image | Z-Image | |
|---|---|---|---|---|
| Tamaño | Unos 5B | 32B | 20B | 6B |
| Prompts de layout por coordenadas | Sí, cajas JSON | No | No | No |
| Edición de fotos / referencias | No | Sí | Modelos de edición aparte | Modelo de edición aparte |
| Ecosistema actual | Nuevo, crece rápido | Grande | Grande | Grande |
Los tamaños provienen de las notas públicas de lanzamiento de cada modelo; este modelo aún no tiene un benchmark cuantitativo publicado.
Alojar MOSS-Image por tu cuenta vs generar online en Spicy AI
| Despliegue local (pesos oficiales) | Spicy AI online | |
|---|---|---|
| Filtros de contenido | Ninguno al ejecutarlo en local | Sin filtros de contenido |
| Pesos abiertos | Sí | No hacen falta — funciona en el navegador |
| Modelo | Checkpoint Base o SFT | Modelo de imagen sin censura similar, alojado online |
| Coste para empezar | Tu propia GPU | Plan gratuito disponible |
Preguntas frecuentes
¿Qué es lo que más se crea con él?
Encabezan la lista los pósteres, banners de tienda y portadas para redes con títulos legibles, seguidos de memes con el texto integrado, explicaciones en pizarra y sesiones glamour de modelos adultos.
¿Puede editar fotos o usar una imagen de referencia?
Todavía no. Es solo un modelo de texto a imagen; la edición y las imágenes de referencia no forman parte del lanzamiento.
¿Admite texto en chino?
Sí. Renderiza chino e inglés, y poner las palabras exactas entre comillas da las letras más fiables.
¿Cuánta VRAM necesito?
No hay una cifra oficial. La demo tiene un modo Sequential de poca memoria, existen archivos cuantizados de la comunidad y los adaptadores LoRA pueden entrenarse con unos 6GB.
¿Cómo lo uso en ComfyUI?
Actualiza a una build nightly actual, que lo admite de forma nativa, y carga los archivos reempaquetados de Comfy-Org con los loaders integrados.
¿Spicy AI está vinculado a OpenMOSS?
No. Spicy AI es una plataforma independiente y no está afiliada ni respaldada por OpenMOSS. El nombre del modelo es una marca de su respectivo propietario.
Fuentes
- Model card del modelo Base (Hugging Face)
- Model card del modelo SFT (Hugging Face)
- Repositorio de OpenMOSS y guía de layout (GitHub)
- Informe técnico (arXiv 2610.23374)
- Demo online oficial (Hugging Face Space)
- Pesos en formato ComfyUI (Comfy-Org)
- Comentarios de la comunidad (archivo de Civitai)
- Informe sobre LoRA NSFW de la comunidad (AlphaSignal, sin verificar)