Unzensierte KI-Bilder · SupraLabs
Supra2-IMG unzensiert: ein Bildmodell im Taschenformat, das fast überall läuft
Kann ein Modell mit nur rund 100 Millionen Parametern wirklich zeichnen? Supra2-IMG sagt ja. Dieses winzige Text-zu-Bild-Modell, das SupraLabs im Herbst 2026 auf Hugging Face veröffentlicht hat, verwandelt einen kurzen englischen Satz in ein Bild mit 256×256 Pixeln und ist klein genug, um auf einem einfachen Laptop, einem Mac, in einem Browser-Tab oder sogar auf dem Smartphone zu laufen. Die offenen Gewichte laufen lokal ohne Online-Filter, deshalb suchen viele nach Supra2-IMG unzensiert.
- Kostenlos starten
- Keine Filter
- Läuft im Browser
Unzensierter alternativer Bildgenerator
Text zu BildBeschreibe das gewünschte Bild. Füge ein Referenzfoto hinzu, um es zu bearbeiten, oder lass das Feld leer für Text-zu-Bild.
100 Millionen Parameter, die trotzdem ein Bild malen
Die meisten bekannten Bildgeneratoren bringen Milliarden Parameter auf die Waage und brauchen eine ernsthafte Grafikkarte. Dieses Modell geht den umgekehrten Weg. Der Zeichenkern ist ein Diffusion Transformer mit nur 104,1 Millionen Parametern, etwa ein Achtel des UNet mit 860 Millionen Parametern in Stable Diffusion 1.5, und die Gewichtsdatei ist nur rund 417MB groß. Den Prompt liest es mit Googles kompaktem Text-Encoder Flan-T5-base, und die Bilder dekodiert es mit dem bekannten VAE von Stability AI. Noch erstaunlicher ist, wie günstig es entstanden ist: SupraLabs hat es von Grund auf mit 5,6 Millionen synthetischen Bildern aus dem Datensatz FLUX-Reason-6M über zehn Epochen trainiert – auf einer einzigen H100-GPU in etwa neun Stunden, Datenvorbereitung inklusive. Das Team nennt einen FID von 27,9 und einen CLIP-Score von 29,4, ohne den Testdatensatz anzugeben; betrachte diese Werte also als Eigenangaben. Es geht nicht darum, große Modelle beim Detail zu schlagen, sondern zu zeigen, dass ein erkennbares, ansprechendes Bild aus etwas entstehen kann, das auf fast jedes Gerät passt.
Wo ein winziges Bildmodell glänzt
Klein und schnell verändert, wofür ein Bildmodell gut ist. Statt eines perfekten Posters bekommst du einen Skizzenblock, der offline funktioniert, sofort startet und nie ein Konto verlangt. Genutzt wird es für schnelle Konzept-Thumbnails vor einem größeren Render, einfache Icons und Platzhaltergrafiken für Apps und Spiele, Moodboards für Geschichten und Unterrichtsdemos, die zeigen, wie Diffusion funktioniert, ohne eine Cloud-GPU zu mieten. Weil ein Bild so wenig kostet, eignet es sich auch zum Experimentieren im Stapel: Erzeuge ein Dutzend Varianten derselben Idee und behalte die, die dir gefällt.
| Szenario | Was du erstellst | Warum ein winziges Modell passt |
|---|---|---|
| Offline skizzieren | Konzept-Thumbnails im Zug oder Flugzeug | Weder Internet noch große GPU nötig |
| Indie-Apps und -Spiele | Icons, Kacheln und Platzhaltergrafiken | Kleine Ausgabegröße passt zu kleinen Assets |
| Geschichten und Moodboards | Szenen und Atmosphären zum Schreiben | Viele schnelle Varianten zur Auswahl |
| Lehren und Lernen | Ein funktionierendes Diffusionsmodell zum Studieren | Klein genug zum Lesen, Ausführen und Neutrainieren |
| Modell-Duelle | Direktvergleiche winziger Modelle | Schnell genug, um Dutzende Prompts zu vergleichen |
Prompt-Vorlagen, die bei 256 Pixeln funktionieren
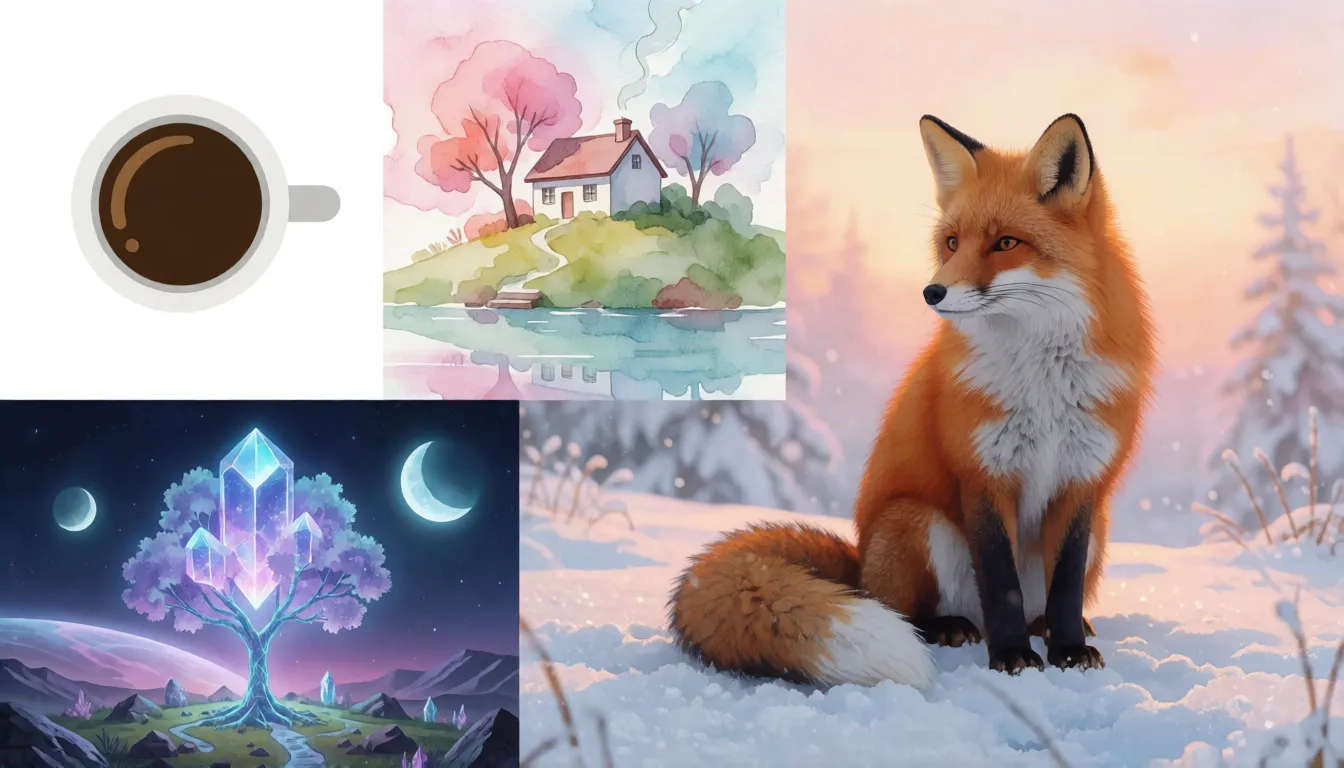
Die Trainingsbeschreibungen folgen einer einfachen Reihenfolge: zuerst die Komposition, dann das Motiv, dann Stil und Fantasie. Übernimm diese Reihenfolge, halte Prompts kurz und auf Englisch und bleib unter dem 128-Token-Limit des Text-Encoders. Ein klares Motiv pro Satz schlägt überfüllte Szenen mit vielen Personen. Probiere diese Vorlagen aus und ändere mit festem Seed jeweils nur ein Wort:
- Komposition und Motiv: "a close-up of a red fox sitting in fresh snow, centered, soft morning light"
- Stimmung und Umgebung (das Beispiel der Entwickler): "a sea jellyfish floating in the pitch-black ocean depths"
- Kunststil: "a tiny cottage on a hill, watercolor painting, pastel colors"
- Icons und Assets: "a flat minimal icon of a coffee cup, white background"
- Fantasie: "a glowing crystal tree on an alien planet, two moons in the sky, fantasy art"
- Porträt: "portrait of an adult woman with curly hair, studio lighting, neutral background"
Vermeide langen Text im Bild und komplexe Interaktionen zwischen mehreren Personen; dafür ist das Modell zu klein.
Supra2-IMG in drei Schritten ausführen
Die Einrichtung ist erfrischend einfach. Lade die Gewichte model_final_ema.pt und das Skript inference.py aus dem SupraLabs-Repository auf Hugging Face herunter, installiere PyTorch und führe einen einzigen Befehl aus. Das Skript wählt deine Hardware automatisch: zuerst eine NVIDIA-GPU in bf16, dann Apple Silicon über MPS und als Rückfallebene die CPU. Wenn du nur Ergebnisse sehen willst, kannst du es im Demo-Space von SupraLabs und im Space Supra-IMG Studio online im Browser ausprobieren, ohne etwas zu installieren.
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/model_final_ema.pt
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
  --seed 0 --cfg 3.0 --steps 50 --n 1 --out out.png
Die Standardwerte der Entwickler sind CFG 3.0, 50 Schritte und Seed 0; mit --n entstehen mehrere Bilder in einem Durchlauf.
Auf CPU, Mac oder alter Grafikkarte ausführen
Hier zahlt sich die geringe Größe richtig aus. Das komplette Paket aus Zeichenmodell, Text-Encoder und VAE ist nach heutigen Maßstäben winzig, sodass gewöhnliche Laptops, Macs mit Chips der M-Serie und ältere Gaming-Grafikkarten realistische Ziele sind. SupraLabs hat keine Geschwindigkeits- oder Speicherangaben veröffentlicht, und das Skript selbst warnt, dass CPU-Läufe langsam sind – rechne je nach Rechner mit Sekunden bis Minuten pro Bild. Ein paar Einstellungen helfen dir, Qualität gegen Tempo abzuwägen:
- Halte CFG bei etwa 3.0; Werte zwischen 2 und 5 lohnen einen Test für stärkere oder sanftere Prompt-Treue.
- Probiere auf der CPU 20 bis 30 statt 50 Schritte für schnellere Entwürfe und rendere deinen Lieblings-Seed danach mit allen Schritten.
- Nutze --n, um mehrere Bilder im Stapel zu erzeugen und das beste auszuwählen, statt eines zu perfektionieren.
- Halte den Seed fest, während du den Prompt bearbeitest, damit du siehst, was jedes Wort verändert.
Im Browser und auf dem Smartphone: ONNX, WebGPU und safetensors
Schon wenige Wochen nach dem Release begann die Community, das Modell auf neue Plattformen zu portieren. Bartholomheow/Supra2-IMG-ONNX und sm079/supra2-img-web verpacken es für WebGPU, sodass es direkt in einem Browser-Tab zeichnen kann – ganz ohne Python. mikhsol/Supra2-IMG-mobile-onnx bietet eine int8-Version für Smartphones. Wenn du das sicherere safetensors-Format der ursprünglichen .pt-Datei vorziehst, findest du bei malcolmrey/Supra2-IMG und mondk/Supra2-Safetensors konvertierte Gewichte. Das sind frühe Community-Projekte mit bislang wenigen Downloads, also rechne mit Ecken und Kanten und lies die Hinweise im jeweiligen Repository.
LoRA-Slider, Fine-Tunes und ein eigenes Training von Grund auf
Ein so kleines Modell ist ein Spielplatz für Bastler. ntc-ai/supra-particle-sliders fügt Konzept-Slider hinzu, die du hoch- oder herunterschieben kannst, um einen Look zu verändern, und NZUONG/supra2-img-face-grpo ist ein experimentelles Fine-Tune, das mit Reinforcement Learning Porträts verbessert. FlameF0X/Tiny-T2I-Arena stellt mehrere winzige Text-zu-Bild-Modelle nebeneinander, damit du über die Ergebnisse abstimmen kannst. Der größte Reiz für Lernende ist das Trainingsrezept selbst: Eine gemietete H100 für etwa neun Stunden genügt, um einen Diffusion Transformer von Grund auf zu trainieren – aus einem Forschungslabor-Projekt wird ein Wochenend-Experiment. SupraLabs nennt HobbyLM-Image von rootxhacker als Inspiration für diesen Do-it-yourself-Geist.
- Slider: ein einzelnes Konzept anpassen, ohne den Prompt umzuschreiben.
- Fine-Tunes: das Modell auf Gesichter, Icons oder einen Kunststil spezialisieren.
- Von Grund auf: mit demselben Datensatz und dem Budget einer einzigen GPU ein eigenes Modell trainieren.
Die kleinsten Text-zu-Bild-Modelle im Vergleich: Stable Diffusion und SANA
Dieses Modell will nicht bei der Bildqualität gewinnen; sein Verkaufsargument ist, dass es zu den kleinsten und günstigsten Bildmodellen gehört, die du ausführen und neu trainieren kannst. So schneidet es neben bekannten Namen ab:
| Supra2-IMG | Stable Diffusion 1.5 | SANA | HobbyLM-Image | |
|---|---|---|---|---|
| Größe des Zeichenmodells | 104M | Etwa 860M (UNet) | 0,6B bis 1,6B | Kleines Hobby-Modell |
| Auflösung | 256×256 | 512×512 | Bis zu 4096×4096 | Niedrige Auflösung |
| Community-Ökosystem | Neu und klein | Riesig | Wachsend | Klein |
| Am besten für | Winzige Geräte, Lernen | Ausgereifte Tools und Add-ons | Schnelle hochauflösende Bilder | Hobby-Training |
Größen und Auflösungen stammen aus der öffentlichen Modellkarte oder dem Paper des jeweiligen Projekts.
Was du von den Ergebnissen erwarten kannst
Ehrliche Erwartungen machen mehr Spaß. Jedes Bild hat 256×256 Pixel, daher bleiben feine Details wie Hände, Gesichter in einer Menge und kleine Objekte weich, und Schrift im Bild ist schwach. Es versteht nur englische Prompts. Da alle Trainingsbilder von FLUX erzeugt wurden, tendieren die Ergebnisse zu diesem glänzenden, gut ausgeleuchteten FLUX-Look. Brauchst du ein größeres Bild, schick das Ergebnis durch einen Upscaler wie Real-ESRGAN; brauchst du scharfe Details, ist ein größeres Modell das bessere Werkzeug.
- Stark bei: einzelnen Motiven, Landschaften, Stimmungen, einfachen Icons und Kunststilen.
- Schwach bei: Text im Bild, Menschenmengen, Händen und winzigen Details.
- Tipp: Skaliere dein Lieblingsergebnis hoch, statt vom kleinen Modell mehr Details zu verlangen.
Ist es unzensiert? NSFW und Erwachsenenkunst
Auf deinem eigenen Rechner haben die offenen Gewichte keinen Online-Filter, und das Inferenzskript enthält weder Safety-Checker noch NSFW-Filter – nichts prüft also deinen Prompt oder das fertige Bild. Das heißt aber nicht, dass es gut in Inhalten für Erwachsene ist: Es hat von FLUX-generierten Bildern gelernt, seine Fähigkeit, explizite Szenen zu zeichnen, ist unbekannt, und zum Zeitpunkt des Schreibens gab es kein NSFW- oder unzensiertes Fine-Tune aus der Community. Wenn du Erwachsenenkunst ohne Filter in voller Qualität und ohne Einrichtung willst, ist ein unzensierter Online-Bildgenerator der praktische Weg.
Pin-up- und Glamour-Kunst
Retro-Pin-ups und Glamour-Porträts erwachsener Models in weichem Studiolicht.
Bademode und Strandbilder
Sonnige Bikini- und Badeanzug-Szenen mit Erwachsenen am Strand und am Pool.
Fantasy-Figuren
Erwachsene Zauberinnen, Kriegerinnen und Helden in gewagten Kostümen für Geschichten.
- Beschreibe Motiv, Outfit, Umgebung und Licht in einem klaren Satz.
- Lege den Seed fest und ändere pro Durchlauf ein Detail.
- Gib an, dass alle gezeigten Personen erwachsen sind (18+), und stelle niemals echte Personen ohne deren Einwilligung dar.
Erstelle Bilder für Erwachsene ohne Filter – ohne Download und ohne GPU.
Bildgenerator öffnen →Was als Nächstes kommt: Supra2.5-IMG
Die Modellkarte von SupraLabs erwähnt einen möglichen Nachfolger namens Supra2.5-IMG, der aber noch nicht veröffentlicht ist; ob er die Auflösung oder die Größe erhöht, ist noch nicht bekannt. SupraLabs ist auf sehr kleine Modelle spezialisiert, von den Sprachmodellen Supra-50M und Supra2-100M-Instruct bis zu SupraTTS, daher würde ein weiteres kompaktes Release ins Muster passen. Am einfachsten erfährst du davon, wenn du der SupraLabs-Seite auf Hugging Face folgst.
Supra2-IMG selbst hosten vs. online mit Spicy AI generieren
| Lokale Installation (Gewichte der Entwickler) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Keine bei lokaler Ausführung | Keine Inhaltsfilter |
| Offene Gewichte | Ja | Nicht nötig – läuft im Browser |
| Modell | Checkpoint mit 104M Parametern, 256×256 | Ähnliches unzensiertes Bildmodell, online gehostet |
| Kosten zum Start | Dein eigener Computer | Kostenloser Tarif verfügbar |
FAQ
Wer hat es entwickelt und wann wurde es veröffentlicht?
SupraLabs hat es auf Hugging Face veröffentlicht. Das Repository wurde am 21. September 2026 erstellt und zuletzt am 10. Oktober 2026 aktualisiert.
Läuft es auf einer CPU?
Ja. Das Skript der Entwickler unterstützt NVIDIA-GPUs, Apple MPS und die CPU. CPU-Läufe sind langsamer, und es wurden keine Zeitangaben veröffentlicht.
Welche Auflösung gibt es aus?
Nur 256×256. Für größere Bilder skalierst du das Ergebnis mit einem Tool wie Real-ESRGAN hoch.
Versteht es Prompts in anderen Sprachen?
Am besten nutzt du es auf Englisch. Der Text-Encoder Flan-T5-base und die Trainingsbeschreibungen sind englisch, und Prompts sollten unter 128 Tokens bleiben.
Kann ich es im Browser oder auf dem Smartphone nutzen?
Ja, über Community-Portierungen: ONNX- und WebGPU-Versionen für Browser und eine int8-ONNX-Version für Mobilgeräte. Es sind frühe Projekte.
Gibt es eine safetensors-Version?
Die Originaldatei ist ein PyTorch-.pt-Checkpoint, aber Community-Repositories wie mondk/Supra2-Safetensors bieten in safetensors konvertierte Gewichte.
Ist Spicy AI mit SupraLabs verbunden?
Nein. Spicy AI ist eine unabhängige Plattform und steht in keiner Verbindung zu SupraLabs und wird von SupraLabs nicht unterstützt. Der Modellname gehört seinem jeweiligen Inhaber.
Quellen
- Modellkarte von SupraLabs (Hugging Face)
- Modellkonfiguration (config.json)
- Inferenzskript (inference.py)
- Online-Demo der Entwickler (Hugging Face Space)
- Trainingsdatensatz FLUX-Reason-6M
- Text-Encoder Flan-T5-base
- Modellkarte von Stable Diffusion v1.5
- SANA-Paper (arXiv 2410.10629)
- Tiny-T2I-Arena (Community-Space)
- WebGPU-ONNX-Portierung von Bartholomheow (Community)