Unzensierte KI-Bilder · OpenMOSS
MOSS-Image unzensiert: offene Gewichte, die Text genau dort platzieren, wo Sie ihn wollen
MOSS-Image ist ein Text-zu-Bild-Modell mit rund 5 Milliarden Parametern vom OpenMOSS-Team, veröffentlicht mit offenen Gewichten am 16. Oktober 2026. Seine Paradedisziplin ist Text, den man wirklich lesen kann: chinesische und englische Überschriften, handschriftliche Notizen und Beschriftungen landen direkt im Bild, und ein JSON-Layoutmodus erlaubt es, jeden Titel, jedes Produkt und jedes Logo auf exakte Koordinaten festzulegen. Da die Gewichte ohne Online-Filter auf Ihrer eigenen GPU laufen, sind die herunterladbaren Checkpoints das unzensierte MOSS-Image, über das lokale Creator sprechen.
- Kostenlos starten
- Keine Filter
- Läuft im Browser
Unzensierter Bildgenerator als MOSS-Image-Alternative
Text zu BildBeschreiben Sie das gewünschte Bild, Wörter gern in Anführungszeichen. Fügen Sie ein Referenzfoto hinzu, um es zu bearbeiten, oder lassen Sie das Feld leer für Text-zu-Bild.
Prompt ausprobieren
Die Beispiel-Prompts sind auf Englisch, das liefert die zuverlässigsten Ergebnisse.
Warum Designer und Händler genau hinschauen
Stell dir dieses Modell als offenen Bildgenerator vor, der Wörter endlich als Teil des Bildes behandelt. Schreib eine Überschrift, einen Preis oder eine Notiz in Anführungszeichen, und sie erscheint lesbar im Bild, auf Englisch oder Chinesisch, genau dort, wo das Layout es vorsieht. Diese eine Fähigkeit macht aus einem netten Spielzeug ein Werkzeug, mit dem Shops, Studios und Social-Media-Teams wirklich arbeiten können. Die Gewichte lassen sich kostenlos herunterladen und auf der eigenen GPU ausführen, also ohne Gebühr pro Bild und ohne Online-Filter zwischen Prompt und Ergebnis.
Lesbarer chinesischer und englischer Text im Bild
Die meisten offenen Bildmodelle verstümmeln Schrift noch immer, und chinesische Schriftzeichen trifft es am härtesten. Es wurde darauf trainiert, beide Sprachen darzustellen, und die offiziellen Beispiele setzen genau darauf: ein handgeschriebener chinesischer Kühlschrankzettel mit einer Einkaufsliste aus Milch, Eiern und Brot, vollgeschriebene Whiteboards, Ladenschilder und Poster-Überschriften. Der Trick ist einfach: Setzen Sie die gewünschten Wörter in Anführungszeichen und beschreiben Sie, wo sie stehen und wie sie aussehen, zum Beispiel "a bold red headline reading \"SUMMER SALE\" across the top". Kurze Phrasen gelingen sauberer als ganze Absätze, und der SFT-Checkpoint gruppiert und richtet Text in den offiziellen Vergleichen ordentlicher aus als Base.
- Setzen Sie jedes Wort, das gedruckt werden soll, in Anführungszeichen – in der gewünschten Sprache.
- Beschreiben Sie den Untergrund: Haftnotiz, Neonschild, Kreidetafel, Magazincover.
- Benennen Sie den Schriftstil: handschriftlich, fette serifenlose Schrift, Pinselkalligrafie.
- Halten Sie jeden Textblock kurz; teilen Sie lange Texte in mehrere beschriftete Elemente auf.
Wo es glänzt: Poster, Shop-Banner und Infografiken
Weil Wörter und Platzierung seine Stärken sind, passt das Modell zu Aufgaben, bei denen ein hübsches Bild allein nicht reicht. Online-Händler entwerfen Produktbanner mit Preis-Badge in der Ecke, Social-Media-Manager skizzieren Cover mit zweisprachigen Titeln, und Macher von Kurzdramen und Webcomics entwerfen Poster und Panels mit bereits platzierten Dialogen. Lehrkräfte und Marketer nutzen es für Whiteboard-Erklärgrafiken und Infografiken, Restaurants für Speisekarten und Schilder, und Markenteams für Serien einheitlicher Layouts, bei denen nur die Überschrift wechselt.
| Szenario | Was Sie anfordern | Warum es funktioniert |
|---|---|---|
| Shop-Banner | Produkt in der Mitte, Überschrift oben, Badge in einer Ecke | JSON-Boxen halten jedes Element dort, wo Sie es geplant haben |
| Zweisprachiges Social-Cover | Chinesischer Titel plus englischer Untertitel | Beide Schriftsysteme werden lesbar dargestellt |
| Drama- oder Comic-Poster | Figuren, Slogan und Sprechblasen | Lange Prompts fassen viele Details auf einmal |
| Whiteboard-Erklärung | Handgeschriebene Schritte und einfache Zeichnungen | Handschriftstile wirken natürlich |
| Speisekarte oder Schild | Gerichte und Preise in Zeilen | Kurze Textzeilen bleiben scharf |
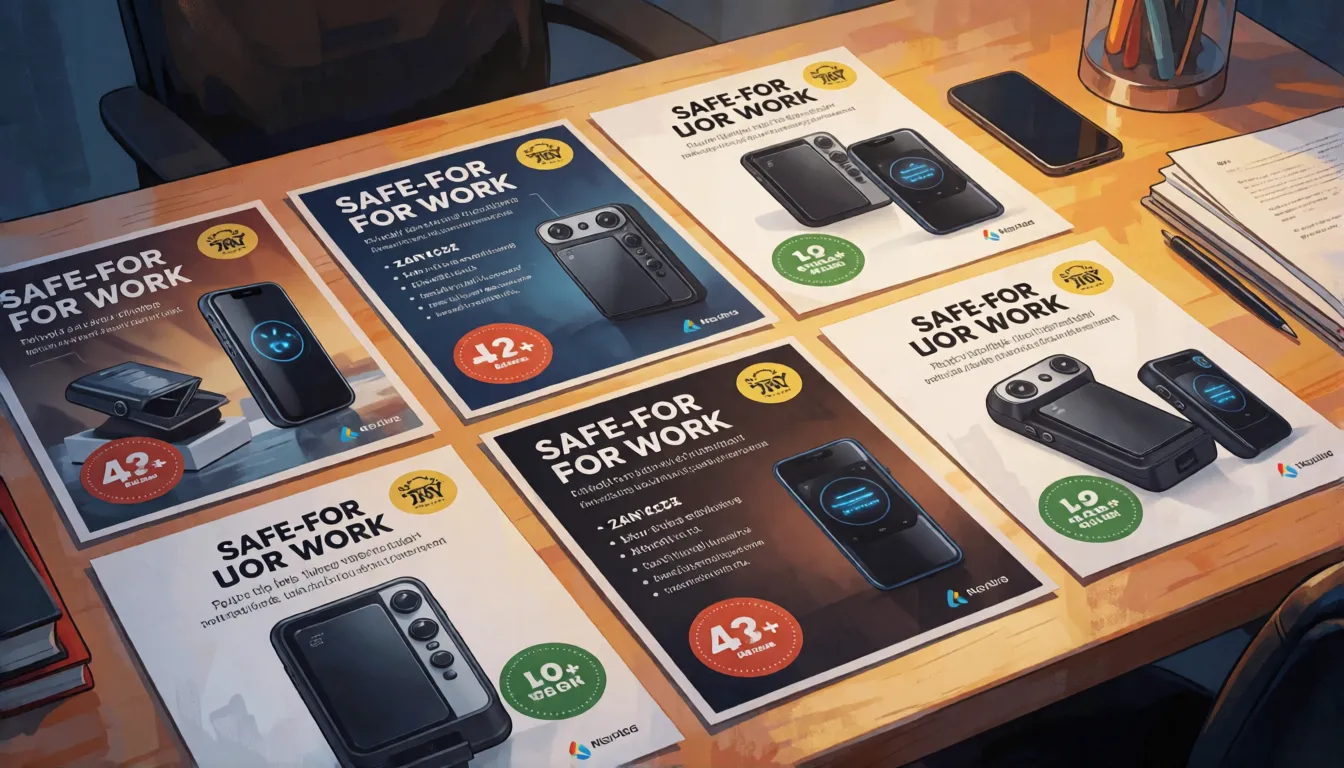
Damit Geld verdienen: Banner, Speisekarten und Anzeigentests
Am meisten profitieren kleine Teams, die schnell viele textlastige Grafiken brauchen. Ein Onlineshop entwirft an einem Nachmittag die Aktionsbanner für eine ganze Woche, jedes mit dem Produkt in der Mitte, dem Rabatt als Sticker und der Überschrift in zwei Sprachen. Agenturen nutzen dasselbe JSON-Layout für Dutzende Anzeigenvarianten, die nur den Slogan tauschen, was A/B-Tests billig macht. Cafés und Restaurants gestalten Speisekarten und Tafeln, Druckereien bieten individuelle Poster an, und Webcomic- und Kurzserien-Studios skizzieren Cover mit fertig platziertem Titel, bevor ein Designer die finale Datei verfeinert.
| Wer | Was entsteht | Warum es sich lohnt |
|---|---|---|
| Onlineshop | Wöchentliche Aktionsbanner und Preisschilder | Gleiches Layout, nur der Text wechselt |
| Werbeagentur | Viele Slogan-Varianten für A/B-Tests | Gleiches JSON, neuer Text in Sekunden |
| Restaurant oder Café | Speisekarten, Tafeln, Schaufensterposter | Kurze Textzeilen bleiben scharf |
| Comic- oder Serienstudio | Cover-Entwürfe mit Titel und Slogan | Spart Layout-Runden |
| Freiberufliche Designer | Kunden-Mockups vor dem finalen Schliff | Schnellere erste Entwürfe |
Was die Community sagt und was Leute damit machen
Auf Civitai, wo Kreative Bilder und Modelle teilen, fallen die ersten Kommentare überwiegend positiv aus. Ein Nutzer nannte es eines der wissensreichsten offenen Modelle für realistische Bilder und lobte, wie gut es Anime und Fotostil gleichermaßen beherrscht. Andere nannten Schwächen: Hände und Gliedmaßen geraten manchmal falsch, Stil-Tags mit Künstlernamen wirken kaum, und die Standardeinstellungen sind langsam; ein Nutzer berichtete von über 100 Sekunden pro Bild, bis eine Turbo-LoRA aus der Community das auf etwa ein Zehntel drückte, bei etwas weicherer Haut. Zehn Tage nach dem Start hatte das GitHub-Repository rund 1,9 Tausend Sterne und die Seite des Base-Modells 556 Likes. Was wird gepostet? Erfundene Retro-Reiseposter, zweisprachige Magazincover, handgeschriebene Kühlschrankzettel und Whiteboards, Memes mit eingebauter Bildunterschrift, Anime-Charakterbögen mit Namen und glamouröse Strandshootings mit erwachsenen Models.
- Retro-Reise- und Filmposter mit großen, lesbaren Titeln
- Zweisprachige chinesisch-englische Magazin- und Social-Cover
- Handgeschriebene Zettel, Kassenbons und Whiteboard-Witze als Memes
- Anime-Charakterbögen mit Namen und Werten daneben
- Bademode- und Pin-up-Shootings erwachsener Models mit Magazin-Schriftzug
MOSS-Image-Prompt-Beispiele zum Kopieren
Das Modell versteht drei Prompt-Stile, und jeder passt zu einem anderen Ziel. Natürliche Sätze eignen sich am besten für Fotos und Poster, Tag-Listen sind Anime- und Community-LoRA-Nutzern vertraut, und JSON ist für strikte Layouts gedacht. Beginnen Sie mit diesen Vorlagen, halten Sie den Seed fest und ändern Sie jeweils nur ein Detail:
- Natürliche Sprache: "A cozy kitchen at morning, a handwritten note on the fridge reading \"milk, eggs, bread\", warm sunlight, photorealistic."
- Poster: "Retro travel poster of a seaside town, large title \"VISIT CAPRI\" at the top in cream serif letters, grainy print texture."
- Tags: "adult woman, beach, sunset, bikini, film grain, 35mm, golden hour" (nur erwachsene Figuren).
- Infografik: "Clean whiteboard with three numbered steps titled \"How to brew coffee\", simple marker drawings, flat lighting."
- Zweisprachiges Cover: "Magazine cover, Chinese headline in bold brush strokes, English subtitle \"Night Market Guide\" below, neon street at night."
JSON-Layout-Prompts: Titel und Produkte per Koordinaten festlegen
Der JSON-Modus hebt dieses Modell von anderen ab. Statt zu hoffen, dass die Überschrift oben landet, beschreiben Sie die ganze Szene in einer Zusammenfassung und listen dann Elemente auf, jeweils mit Label, Beschreibung, Bounding Box und optionalem Text. Die Boxen verwenden die Reihenfolge yxyx (oben, links, unten, rechts) in Pixelkoordinaten, gemessen von der Bildmitte aus – bei einem Bild mit 1024 × 1024 reicht jede Achse also von -512 bis 512, und die Zahlen müssen zur erzeugten Größe passen. OpenMOSS bezeichnet das Layout noch als experimentell, rechnen Sie also damit, die eine oder andere Box nachjustieren zu müssen. Ein Grundgerüst zum Start:
{
  "summary": { "caption": "Bright summer shop banner, white studio background" },
  "items": [
    { "label": "title", "caption": "bold red headline", "bbox": [-460, -400, -300, 400], "text": "SUMMER SALE" },
    { "label": "product", "caption": "glass bottle of iced lemon tea", "bbox": [-220, -200, 380, 200] },
    { "label": "badge", "caption": "yellow round sticker", "bbox": [260, 260, 460, 460], "text": "-50%" }
  ],
  "bbox_format": "yxyx",
  "bbox_coord_space": "abs_centralized"
}
Die Feldnamen folgen dem Layout-Leitfaden im offiziellen GitHub-Repository; der offizielle Prompt-Enhancer-Skill kann außerdem einen einzelnen Satz zu einer ausführlichen Beschreibung oder einem Layout erweitern.
Ist MOSS-Image unzensiert? NSFW-LoRAs und Erwachsenenkunst
Lokal ausgeführt haben die offenen Gewichte keinen Online-Filter: Nichts prüft Ihren Prompt oder das fertige Bild, Sie entscheiden also, was das Modell zeichnet. OpenMOSS hat keinen NSFW-Checkpoint veröffentlicht und beschreibt nicht, wie die Trainingsdaten gefiltert wurden, daher hängen explizite Details von Community-Erweiterungen ab. Ein Bericht aus zweiter Hand von AlphaSignal besagt, dass innerhalb weniger Tage eine "Moss-image-nsfw-uncensored-lora" mit dem Triggerwort moss_xvstyle erschienen sei, die mit Base und SFT funktioniere; auf Hugging-Face- oder Civitai-Seiten ist sie nicht bestätigt, behandeln Sie die Angabe also mit Vorsicht. Beliebte Richtungen für Erwachsene sind Bademode- und Dessous-Editorials, Pin-up-Poster und Fantasy-Cover-Art mit eindeutig erwachsenen Figuren. Wenn Sie sich die GPU-Einrichtung sparen möchten, bietet Spicy AI eine ähnliche unzensierte Bildgenerierung direkt im Browser.
Bikini- und Bademode-Editorials
Sonnige Strand- und Pool-Shootings erwachsener Models mit Magazintitel oben.
Pin-up- und Boudoir-Poster
Retro-Pin-ups für Erwachsene und Dessous-Shootings mit passend platziertem Slogan-Schriftzug.
Fantasy-Cover-Art
Erwachsene Heldinnen, Helden und Zauberinnen für Buch- oder Spielecover mit lesbaren Titeln.
- Schreiben Sie die gewünschten Wörter in Anführungszeichen und sagen Sie, wo sie stehen sollen.
- Nutzen Sie Tags für das Aussehen von Figuren und ganze Sätze für Licht und Stimmung.
- Halten Sie den Seed fest und ändern Sie pro Durchlauf nur ein Detail.
- Geben Sie an, dass alle dargestellten Personen erwachsen (18+) sind, und stellen Sie niemals reale Personen ohne deren Einwilligung dar.
Erwachsenenbilder ohne Filter erstellen – ohne GPU und ohne Download.
Bildgenerator öffnen →
SFT oder Base: welcher Checkpoint der richtige ist
Beide Checkpoints teilen dieselbe 5B-Architektur, sind aber für unterschiedliche Nutzer abgestimmt. SFT wurde per Supervised Fine-Tuning auf kuratierten Daten trainiert, und die offiziellen Vergleichsbilder zeigen eine ordentlichere Textgruppierung und sauberere Seitenlayouts – das ist also der Checkpoint, wenn Sie einfach gute Bilder wollen. Base verzichtet auf dieses Post-Training und bleibt näher am Rohmodell, was es zum besseren Ausgangspunkt für LoRAs und vollständige Fine-Tunes macht.
| SFT | Base | |
|---|---|---|
| Am besten für | Direkte Bildgenerierung | Fine-Tuning und LoRA-Training |
| Text und Layout | Sauberere Gruppierung in offiziellen Beispielen | Lockerere, rohere Ausgabe |
| Training | Von beiden Trainern unterstützt | Empfohlener Ausgangspunkt |
Zum Laufen bringen: Hugging Face, ComfyUI, diffusers und API
Es gibt vier einfache Wege. Der schnellste Test ist der kostenlose Hugging Face Space von OpenMOSS-Team. Für lokales Arbeiten unterstützt ComfyUI das Modell in aktuellen Nightly-Builds nativ, mit den neu verpackten Dateien von Comfy-Org und den integrierten Loadern; das Plugin im offiziellen Repo bleibt nützlich, um diffusers-Ordner zu laden. Entwickler können die Gewichte in diffusers 0.38 oder neuer mit der eigenen pipeline_moss_image und trust_remote_code laden, unter Python 3.10+ und PyTorch 2.9+ mit einer NVIDIA-GPU. Teams, die nichts selbst hosten möchten, können es über die MOSI-API-Plattform aufrufen.
- Standard-Sampling: 50 Schritte, CFG 3, Shift 5, Flow-Matching-Euler.
- Breite und Höhe müssen Vielfache von 16 sein; offizielle Beispiele nutzen 1024x1024 und 1456x1456.
- Guidance läuft mit zwei Durchgängen pro Schritt, daher ist es langsamer als destillierte Modelle.
- Eine destillierte 8-Schritt-DMD-Version aus der Community tauscht etwas Qualität gegen deutlich schnellere Entwürfe.
VRAM, Geschwindigkeit und quantisierte Versionen
OpenMOSS nennt keinen Mindestwert für VRAM. Stattdessen bietet die Gradio-Demo drei Speichermodi: GPU resident hält für maximale Geschwindigkeit alles auf der Karte, Component verschiebt Teile zwischen CPU und GPU, und Sequential ist der speichersparende Notbehelf, der am langsamsten läuft. Bei Out-of-Memory-Fehlern wechseln Sie zu Sequential, senken die Auflösung oder probieren eine quantisierte Datei. Hugging Face listet 13 quantisierte Ableitungen des Base-Modells aus der Community; prüfen Sie auf jeder Model Card das Format, etwa GGUF oder FP8, und welchen Loader es braucht, denn Qualität und Unterstützung unterscheiden sich von Datei zu Datei.
Eigenen Stil mit KohakuMossTrainer trainieren
Beim Fine-Tuning zahlen sich die offenen Gewichte aus. KohakuMossTrainer, zwei Tage nach dem Start veröffentlicht, beherrscht vollständiges Fine-Tuning sowie LyCORIS- oder LoRA-Adapter für beide Checkpoints, und laut README lassen sich Adapter mit nur 6 GB VRAM trainieren. Auch DiffSynth-Studio unterstützt vollständiges Fine-Tuning und LoRA. Innerhalb von zehn Tagen zählte Hugging Face bereits 41 Adapter und 36 Fine-Tunes auf Basis des Base-Modells – von Kunststilen bis zu Korrekturen wie einer DeBand-LoRA aus der Community, die Farbbanding glättet. Trainieren Sie auf Base, verfassen Sie Captions im selben Stil, in dem Sie später prompten, und nehmen Sie den Text auf, den die LoRA lernen soll.
Vergleich mit FLUX.2, Qwen-Image und Z-Image
Noch gibt es keinen offiziellen Benchmark, der diese Modelle direkt gegenüberstellt – verstehen Sie dies also als praktischen Vergleich, nicht als Punktetabelle. Die klaren Unterschiede liegen bei Größe, Layoutsteuerung und Bearbeitung:
| MOSS-Image | FLUX.2 dev | Qwen-Image | Z-Image | |
|---|---|---|---|---|
| Größe | Etwa 5B | 32B | 20B | 6B |
| Layout-Prompts mit Koordinaten | Ja, JSON-Boxen | Nein | Nein | Nein |
| Fotobearbeitung / Referenzen | Nein | Ja | Separate Edit-Modelle | Separates Edit-Modell |
| Ökosystem heute | Neu, wächst schnell | Groß | Groß | Groß |
Die Größenangaben stammen aus den öffentlichen Release Notes der jeweiligen Modelle; für dieses Modell gibt es noch keinen veröffentlichten quantitativen Benchmark.
MOSS-Image selbst hosten vs. online generieren mit Spicy AI
| Lokale Installation (offizielle Gewichte) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Keine bei lokaler Ausführung | Keine Inhaltsfilter |
| Offene Gewichte | Ja | Nicht nötig – läuft im Browser |
| Modell | Base- oder SFT-Checkpoint | Ähnliches unzensiertes Bildmodell, online gehostet |
| Einstiegskosten | Ihre eigene GPU | Kostenloser Tarif verfügbar |
FAQ
Was wird damit am häufigsten erstellt?
Vorne liegen Poster, Shop-Banner und Social-Media-Cover mit lesbaren Titeln, gefolgt von Memes mit eingebauten Bildunterschriften, Whiteboard-Erklärgrafiken und Glamour-Shootings erwachsener Models.
Kann es Fotos bearbeiten oder ein Referenzbild verwenden?
Noch nicht. Es ist ein reines Text-zu-Bild-Modell; Bearbeitung und Referenzbilder sind nicht Teil des Releases.
Unterstützt es chinesischen Text?
Ja. Es stellt sowohl Chinesisch als auch Englisch dar, und wenn Sie die exakten Wörter in Anführungszeichen setzen, wird die Schrift am zuverlässigsten.
Wie viel VRAM brauche ich?
Eine offizielle Zahl gibt es nicht. Die Demo hat einen speichersparenden Sequential-Modus, es gibt quantisierte Community-Dateien, und LoRA-Adapter lassen sich mit etwa 6 GB trainieren.
Wie nutze ich es in ComfyUI?
Aktualisieren Sie auf einen aktuellen Nightly-Build, der es nativ unterstützt, und laden Sie die neu verpackten Dateien von Comfy-Org mit den integrierten Loadern.
Ist Spicy AI mit OpenMOSS verbunden?
Nein. Spicy AI ist eine unabhängige Plattform und steht in keiner Verbindung zu OpenMOSS und wird nicht von OpenMOSS unterstützt. Der Modellname ist eine Marke des jeweiligen Inhabers.
Quellen
- Model Card des Base-Modells (Hugging Face)
- Model Card des SFT-Modells (Hugging Face)
- OpenMOSS-Repository und Layout-Leitfaden (GitHub)
- Technischer Bericht (arXiv 2610.23374)
- Offizielle Online-Demo (Hugging Face Space)
- Gewichte im ComfyUI-Format (Comfy-Org)
- Community-Kommentare (Civitai-Archiv)
- Bericht über Community-NSFW-LoRA (AlphaSignal, unbestätigt)