Unzensierte KI-Bilder · OpenMOSS
Unzensiertes MOSS-Image-SFT: Entwürfe in 8 Schritten, saubere Verläufe und Anime-Tags
MOSS-Image-SFT ist die sofort einsatzbereite Version des 5B-Open-Weights-Modells MOSS-Image vom OpenMOSS-Team, veröffentlicht am 16. Oktober 2026. Im ersten Monat hat die Community daraus ein deutlich zugänglicheres Werkzeug gemacht: eine auf 8 Schritte destillierte Version für schnelle Entwürfe, eine LoRA gegen vertikale Farbstreifen, FP16-Gewichte für ältere Grafikkarten und die wachsende Gewohnheit, Anime-Prompts als einfache Tags zu schreiben. Dieser Guide sammelt diese Tricks sowie Prompt-Vorlagen, die du direkt einfügen kannst.
- Kostenlos starten
- Keine Filter
- Läuft im Browser
Unzensierter alternativer Bildgenerator
Text zu BildBeschreibe das gewünschte Bild, Wörter in Anführungszeichen. Füge ein Referenzfoto zum Bearbeiten hinzu oder lass es leer für Text-zu-Bild.
Von Base zu SFT: der Checkpoint zum Bildermachen
OpenMOSS hat zwei Checkpoints desselben 5B-Single-Stream-Modells veröffentlicht. Base hat kein Post-Training und ist als sauberer Ausgangspunkt für das Training von LoRAs gedacht. MOSS-Image-SFT ist Base, feinabgestimmt auf kuratierten Daten, liefert also sofort gute Bilder und versteht drei Arten von Prompts: normale Sätze, Tag-Listen im Anime-Stil und JSON-Layouts mit Koordinaten. Die Whiteboard-Beispiele der Entwickler zeigen auf der SFT-Seite ordentlicher gruppierten Text und sauberere Layouts, allerdings hat OpenMOSS keine Zahl für den Abstand veröffentlicht. Wenn du einfach Bilder willst, lade diesen Checkpoint; willst du deinen eigenen Stil trainieren, starte mit Base. Einen Monat nach dem Start zeigte die SFT-Seite auf Hugging Face 913 Likes, rund 19.500 Downloads im letzten Monat und 68 darauf aufbauende Spaces.
8 statt 50 Schritte: DMD-Destillation und Spectrum
Das Standardrezept verlangt 50 Sampling-Schritte mit Guidance – sorgfältig, aber langsam. Die MOSS-Image-SFT-Community hat das schnell gelöst. lodestones veröffentlichte MOSS-Image-SFT-8-steps-dmd, eine destillierte Version, die ein Bild in 8 Schritten zeichnet und einen LoRA-Adapter für ComfyUI mitbringt. Zusätzlich beschleunigt der Node ComfyUI-Spectrum-MOSS das Sampling weiter, indem er Arbeit zwischen ähnlichen Schritten überspringt. OpenMOSS sagt, die eigene DMD-Version sei noch in Entwicklung. Einen fairen Geschwindigkeits- oder Qualitätsbenchmark gibt es noch nicht, also teste auf deiner eigenen Karte – die Aufteilung, auf die sich die meisten einigen, ist jedoch einfach:
| Zweck | Wahl | Warum |
|---|---|---|
| Komposition finden, Ideen im Batch | 8-Schritt-DMD | Viele Entwürfe in der Zeit eines vollen Renders |
| Poster mit viel Schrift | Standard mit 50 Schritten | Text und kleine Details halten besser |
| Finales Produkt- oder Coverbild | 50 Schritte, optional mit Spectrum | Behält die Qualität und verkürzt die Wartezeit |
Farbstreifen, FP16-Karten und SLG-Einstellungen beheben
Zwei Beschwerden tauchten früh auf. Einige MOSS-Image-SFT-Nutzer sahen schwache vertikale Streifen (Banding) über glatten Himmeln und Verläufen. MATLOWAI antwortete mit MOSS-Image-SFT-DeBand, einer kleinen LoRA plus ComfyUI-Preset, die diese Streifen glättet. Das zweite Problem war die Hardware: Die Originalgewichte liegen in BF16 vor, was viele ältere GPUs nicht unterstützen. KBlueLeaf veröffentlichte MOSS-Image-FP16-fixed, Gewichte, die sauber in FP16 laufen. Die letzte Stellschraube ist Skip-Layer-Guidance (SLG). Die Model Card lässt den negativen Zweig Layer 22 überspringen, und Community-Tests ergaben, dass auch Layer 24 oder 26 funktionieren.
- Streifen in Himmel oder Wänden: die DeBand-LoRA mit ihrem Preset laden.
- Schwarze oder kaputte Bilder auf einer älteren Karte: auf die FP16-fixed-Gewichte wechseln.
- Fotografischerer Look gewünscht: SLG testweise ausschalten, aber auf Hände und kleine Details achten.
- Kurze Prompts wirken flach: CFG von 3 Richtung 6 erhöhen, wie die Model Card empfiehlt.
Drei Arten, einen MOSS-Image-SFT-Prompt zu schreiben
Die meisten Bildmodelle lesen nur Sätze. MOSS-Image-SFT liest drei Formate und akzeptiert Prompts bis zu 4K Tokens, auf Englisch (empfohlen) oder Chinesisch. Normale Sätze eignen sich am besten für Fotos und Poster mit Schrift: Setze die genauen Wörter in Anführungszeichen und nutze \n im zitierten Text, wenn du einen Zeilenumbruch brauchst. Kommagetrennte Tag-Listen fühlen sich für Anime-Fans natürlich an. JSON ist für strikte Layouts, bei denen jeder Titel, jedes Produkt oder Badge eine eigene Box bekommt. Im JSON-Format nutzen die Boxen die yxyx-Reihenfolge, gemessen von der Mitte der Leinwand, sodass bei einem 1024 × 1024-Bild jede Achse von -512 bis 512 reicht. Der Prompt-Enhancer-Skill im GitHub-Repo der Entwickler kann eine grobe Pixelskizze für dich in diese zentrierten Koordinaten umwandeln.
{
  "summary": { "caption": "Clean perfume ad, black stone, soft rim light" },
  "items": [
    { "label": "product", "caption": "glass perfume bottle", "bbox": [-200, -160, 360, 160] },
    { "label": "title", "caption": "thin gold serif", "bbox": [-460, -300, -320, 300], "text": "NOIR 07" }
  ],
  "bbox_format": "yxyx"
}
Prompt-Vorlagen zum Kopieren und Abwandeln
Diese MOSS-Image-SFT-Vorlagen folgen dem Rat der Entwickler: Szene beschreiben, Text zitieren, Position angeben. Nutze etwa 1 bis 2 Megapixel, jedes Seitenverhältnis in Vielfachen von 16, halte den Seed fest und ändere pro Durchlauf nur ein Detail. Das Beispiel mit dem Kühlschrankzettel ist ein gutes Aufwärmen: ein Haftzettel an einer Kühlschranktür, handschriftlich auf Chinesisch, der daran erinnert, Milch und Eier zu kaufen.
- Reiseposter: "Minimalist travel poster, bold title text \"EXPLORE KYOTO\" at top, red torii gate at sunset, small subtitle \"Autumn 2026\" at bottom, flat illustration, high contrast"
- Produktfoto: "Product photo of a glass perfume bottle on wet black stone, label text \"NOIR 07\", soft rim light, studio"
- Handschriftliche Notiz: "A wide view of a refrigerator beside a kitchen counter, a sticky note on the door handwritten: \"Buy milk and eggs!\""
- Hochformat-Cover: "Vertical web novel cover, adult couple in the rain under one umbrella, title \"Midnight Contract\" in silver letters, cinematic"
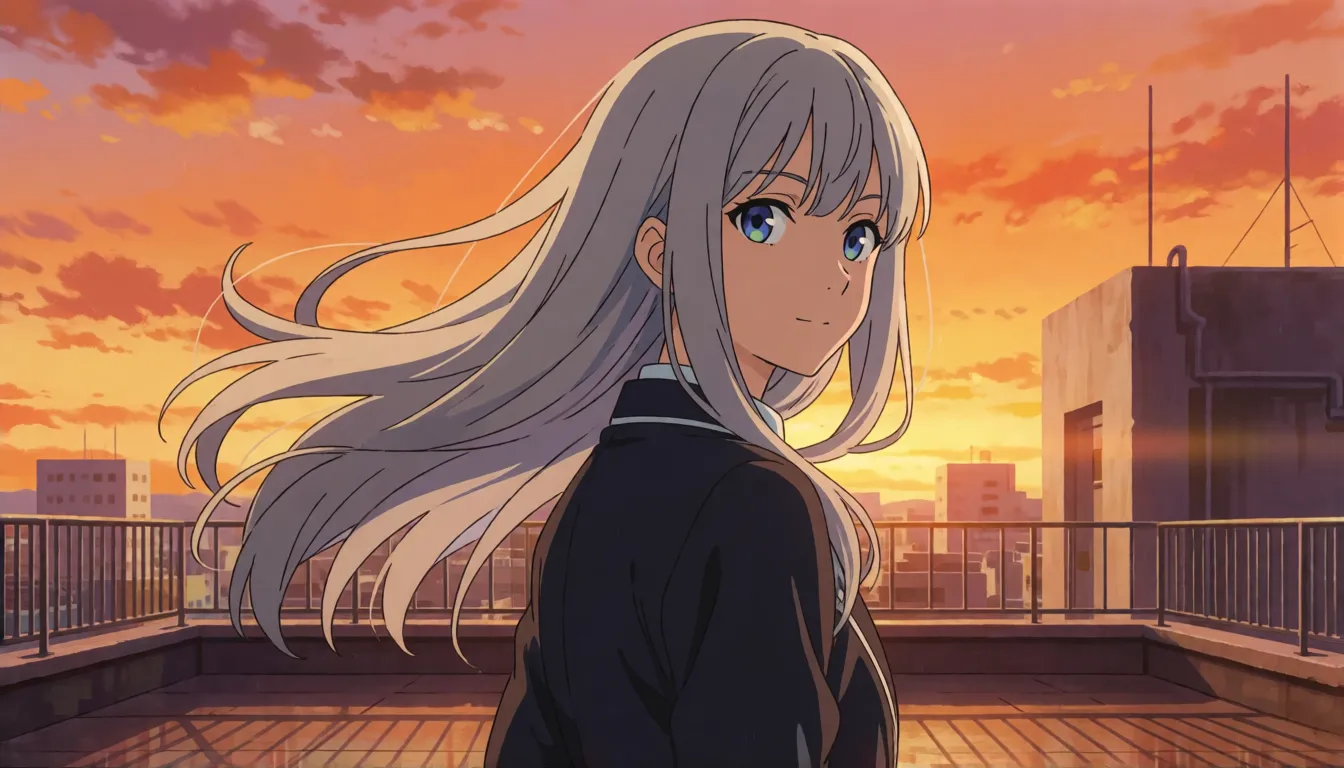
- Anime-Tags: "best quality, highres, newest, 1girl, adult, silver hair, school rooftop, sunset, wind, looking back"
Anime-Art mit Tags im Danbooru-Stil
Anime-Creator erleben mit MOSS-Image-SFT eine angenehme Überraschung: Du kannst die langen Sätze weglassen und kurze Tags schreiben, ähnlich wie auf einer Booru-Seite. Der Nutzerleitfaden schlägt sogar eine Reihenfolge vor: zuerst Qualitäts-Tags, dann Score-, Meta- und Jahres-Tags, dann Charakter, Serie, Künstler und zuletzt die allgemeinen Tags für Pose, Kleidung und Hintergrund. Diese Reihenfolge hält die wichtigen Teile vorne. Erste Community-Berichte sagen, dass Künstlernamen-Tags schwächer wirken als bei spezialisierten Anime-Modellen; beschreibe den Stil also in Worten, wenn er wichtig ist, und füge nach den Tags einen ganzen Satz für Licht oder Stimmung hinzu.
- Quality → Score → Meta → Year → Character → Series → Artist → General
- Beginne mit: best quality, highres, newest
- Pose und Umgebung zuletzt: looking back, rooftop, sunset, wind
Poster und Designs, bei denen die Worte zählen
Lesbare Schrift ist der Grund, warum viele MOSS-Image-SFT ausprobieren. Der technische Bericht nennt eine durchschnittliche Textabdeckung von 96,3 % im Langtext-Benchmark LLTB, der beste Wert unter Open-Weights-Modellen, und die Beispielbilder sind voller Whiteboards, Schilder und handschriftlicher Notizen auf Chinesisch und Englisch. Damit passt MOSS-Image-SFT gut zu zweisprachigen Eventpostern, Ladenbannern mit Preis, Comic-Panels mit Sprechblasen, Infografiken und Hochformat-Covern für Kurzserien und Webromane. Da jedes Seitenverhältnis funktioniert, lässt sich ein Prompt für einen quadratischen Post, ein breites Banner und eine hohe Handy-Story wiederverwenden.
Eigene Charakter- oder Stil-LoRA trainieren
Offene Gewichte bedeuten, dass du dem Modell deinen eigenen Charakter oder Kunststil beibringen kannst. KohakuMossTrainer, veröffentlicht am 18. Oktober, trainiert LoRA- und LyCORIS-Adapter mit nur 6 GB VRAM, und DiffSynth-Studio unterstützt sowohl volles Fine-Tuning als auch LoRA. Der übliche Rat lautet, auf Base zu trainieren und das Ergebnis dann mit MOSS-Image-SFT zu laden. Das Ökosystem ist noch klein, wächst aber schnell: Der SFT-Modellbaum auf Hugging Face listet 55 Adapter, 23 Fine-Tunes und 2 Merges. Schreibe deine Captions im selben Stil, in dem du später promptest – Tags für Anime-Charaktere, Sätze für Fotostile.
Online, API, quantisierte Dateien und Server
Du brauchst kein lokales Setup, um MOSS-Image-SFT auszuprobieren. Der Hugging Face Space der Entwickler läuft im Browser, und die MOSI-API-Plattform bietet seit dem 20. Oktober gehosteten Zugang (aktuelle Preise auf deren Website prüfen). Für Teams mit eigenem Dienst unterstützten SGLang und vLLM-Omni das Modell vom ersten Tag an und veröffentlichen beide Deployment-Rezepte. Nutzer mit wenig VRAM finden im Modellbaum 48 quantisierte Versionen, darunter GGUF-Dateien; prüfe auf jeder Karte, welchen Loader sie braucht. Auf dem Mac sind Draw Things und DiffusionBee die üblichen Apps für lokale Generierung.
MOSS-Image-SFT vs. FLUX und Qwen-Image
Es gibt keinen direkten Vergleichswert der Entwickler, daher ist dies ein praktischer Vergleich. MOSS-Image-SFT ist klein, rund 5B Parameter, was Ausführen und Training auf Consumer-Karten erleichtert. Seine Stärken sind langer chinesischer und englischer Text sowie Layout-Steuerung per JSON. FLUX und Qwen-Image sind größer und haben viel umfangreichere Bibliotheken an Community-LoRAs und Fine-Tunes plus eigene Bearbeitungsmodelle – sie gewinnen also weiterhin, wenn du einen bestimmten Stil brauchst, den schon jemand trainiert hat.
| MOSS-Image-SFT | FLUX-Familie | Qwen-Image | |
|---|---|---|---|
| Größe | Etwa 5B | Größer | Größer |
| Layout-Prompts mit Koordinaten | Ja, JSON-Boxen | Nein | Nein |
| Langer zweisprachiger Text | Hauptstärke | Überwiegend Englisch | Stark |
| Community-LoRAs | Jung, wachsend | Sehr groß | Groß |
Unzensiertes MOSS-Image-SFT und Erwachsenenkunst
OpenMOSS hat keine unzensierte Version veröffentlicht. Die MOSS-Image-SFT-Gewichte sind offen und werden lokal durch nichts gefiltert, aber der empfohlene Negativ-Prompt enthält selbst das Wort nsfw, was zeigt, dass das Standard-Setup zu harmlosen Bildern tendiert. In der Community gibt es LoRAs mit Erwachsenenthemen, deren Qualität und Herkunft jedoch schwanken – prüfe sie also sorgfältig. Beliebte Richtungen für Erwachsene sind Bademoden-Editorials, Pin-up-Poster und Fantasy-Cover mit eindeutig erwachsenen Figuren. Wenn du dir das Setup sparen willst, bietet Spicy AI ähnliche unzensierte Bildgenerierung im Browser.
Bademoden-Editorials
Sonnige Strand- und Pool-Shootings mit erwachsenen Models und einem Magazintitel oben.
Pin-up-Poster
Retro-Pin-ups erwachsener Figuren mit sauber platziertem Slogan-Schriftzug.
Fantasy-Cover
Erwachsene Helden und Zauberinnen für Buch- oder Spielcover mit lesbaren Titeln.
- Nutze die 8-Schritt-Version zum Erkunden und rendere den Favoriten dann mit vollen Schritten.
- Setze jedes Wort, das gedruckt werden soll, in Anführungszeichen und gib an, wo es hingehört.
- Gib an, dass alle Dargestellten erwachsen sind (18+), und stelle niemals reale Personen ohne Einwilligung dar.
Erstelle Bilder mit Erwachsenenthemen im Browser, ohne GPU oder Download.
Bildgenerator öffnen →Was die Community nach einem Monat erstellt
Die Zahlen sprechen für sich: Kurz nach dem Start hatte die SFT-Seite etwa 130 Likes, einen Monat später überschritt die SFT-Seite 900 Likes, mit 48 quantisierten Dateien und Dutzenden Adaptern im Modellbaum sowie rund 2,6k Sternen auf GitHub. Die meisten geteilten MOSS-Image-SFT-Bilder fallen in wenige Gruppen: Retro-Reiseposter, zweisprachige Magazincover, handschriftliche Notizen und Whiteboard-Memes, Anime-Charaktere aus Tag-Prompts und stimmungsvolle Produktfotos für Onlineshops.
- Retro-Poster mit großen, lesbaren Titeln
- Zweisprachige Cover und Event-Flyer
- Handschriftliche Notizen, Kassenbons und Whiteboard-Witze
- Anime-Charaktere aus Tags im Booru-Stil
- Produktfotos mit Etiketten im Markenstil
MOSS-Image-SFT selbst hosten vs. online auf Spicy AI generieren
| Lokale Installation (Originalgewichte) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Keine bei lokaler Ausführung | Keine Inhaltsfilter |
| Offene Gewichte | Ja | Nicht nötig – läuft im Browser |
| Modell | SFT-Checkpoint plus Community-Erweiterungen | Ähnliches unzensiertes Bildmodell, online gehostet |
| Einstiegskosten | Deine eigene GPU | Kostenlose Stufe verfügbar |
FAQ
Was ist der Unterschied zwischen MOSS-Image-SFT und Base?
SFT ist Base, feinabgestimmt auf kuratierten Daten, liefert daher direkt bessere Bilder und versteht Sätze, Tags und JSON. Base hat kein Post-Training und eignet sich besser zum Trainieren von LoRAs. OpenMOSS hat keinen zahlenmäßigen Vergleich veröffentlicht.
Muss ich 50 Schritte verwenden?
50 Schritte sind die Empfehlung der Entwickler. Die 8-Schritt-DMD-Version von lodestones aus der Community verkürzt das deutlich; eine DMD-Version von OpenMOSS ist noch in Entwicklung.
Wie behebe ich vertikale Streifen oder Banding?
Probiere die Community-LoRA MOSS-Image-SFT-DeBand mit ihrem ComfyUI-Preset oder experimentiere mit den Skip-Layer-Guidance-Einstellungen.
Meine GPU unterstützt kein BF16. Kann ich es trotzdem nutzen?
Ja. Die Community-Gewichte MOSS-Image-FP16-fixed von KBlueLeaf sind für reine FP16-Karten gemacht.
Kann es chinesischen Text schreiben?
Ja. Es rendert langen chinesischen und englischen Text, mit 96,3 % durchschnittlicher Abdeckung im LLTB-Benchmark laut technischem Bericht. Füge \n im zitierten Text für exakte Zeilenumbrüche ein.
Kann ich Anime-Tags verwenden?
Ja. Die empfohlene Reihenfolge ist Quality, Score, Meta, Year, Character, Series, Artist, dann General-Tags.
Ist Spicy AI mit OpenMOSS verbunden?
Nein. Spicy AI ist eine unabhängige Plattform und weder mit OpenMOSS verbunden noch von OpenMOSS unterstützt. Der Modellname ist eine Marke des jeweiligen Inhabers.
Quellen
- MOSS-Image-SFT Model Card (Hugging Face)
- MOSS-Image-Base Model Card (Hugging Face)
- OpenMOSS-Repository (GitHub)
- Nutzerleitfaden: Prompts und Einstellungen (GitHub)
- Technischer Bericht (arXiv 2610.23374)
- Destillierte 8-Schritt-DMD-Version (lodestones)
- DeBand-LoRA (MATLOWAI)
- FP16-fixed-Gewichte (KBlueLeaf)
- ComfyUI-Spectrum-MOSS-Node
- KohakuMossTrainer
- Online-Demo der Entwickler (Hugging Face Space)
- SGLang-Deployment-Rezept
- vLLM-Omni-Rezept