Unzensierte KI · Bild · Alibaba Tongyi Lab
Z-Image unzensiert erklärt: Modellfamilie, Basismodell und LoRAs
Z-Image (auch zimage oder Z Image geschrieben; chinesischer Name 造相) ist eine Familie offener 6B-Text-zu-Bild-Modelle von Alibabas Tongyi Lab und kein allgemeiner Begriff für "Z-Bilder". Zwei Modelle lassen sich heute herunterladen: Turbo, gebaut für Tempo, und das Basismodell vom Januar 2026, das allgemein Z-Image Base genannt wird und Negativ-Prompts, CFG und mehr Vielfalt zurückbringt. Zwei weitere, Edit und Omni-Base, sind angekündigt, aber ohne öffentliche Gewichte. Lies diese Seite als Landkarte der Familie: wofür jedes Modell gedacht ist, wann sich das Basismodell lohnt, wie Feintuning funktioniert und was "unzensiert" hier wirklich bedeutet. Für Bilder für Erwachsene ganz ohne Einrichtung ist der Bildgenerator von Spicy AI eine unzensierte Alternative.
Spicy AI ist nicht Z-Image — diese Seite läuft derzeit mit Seedream, Krea 2 und Wan 2.6.
- Kostenlos starten
- Keine Filter
- Im Browser
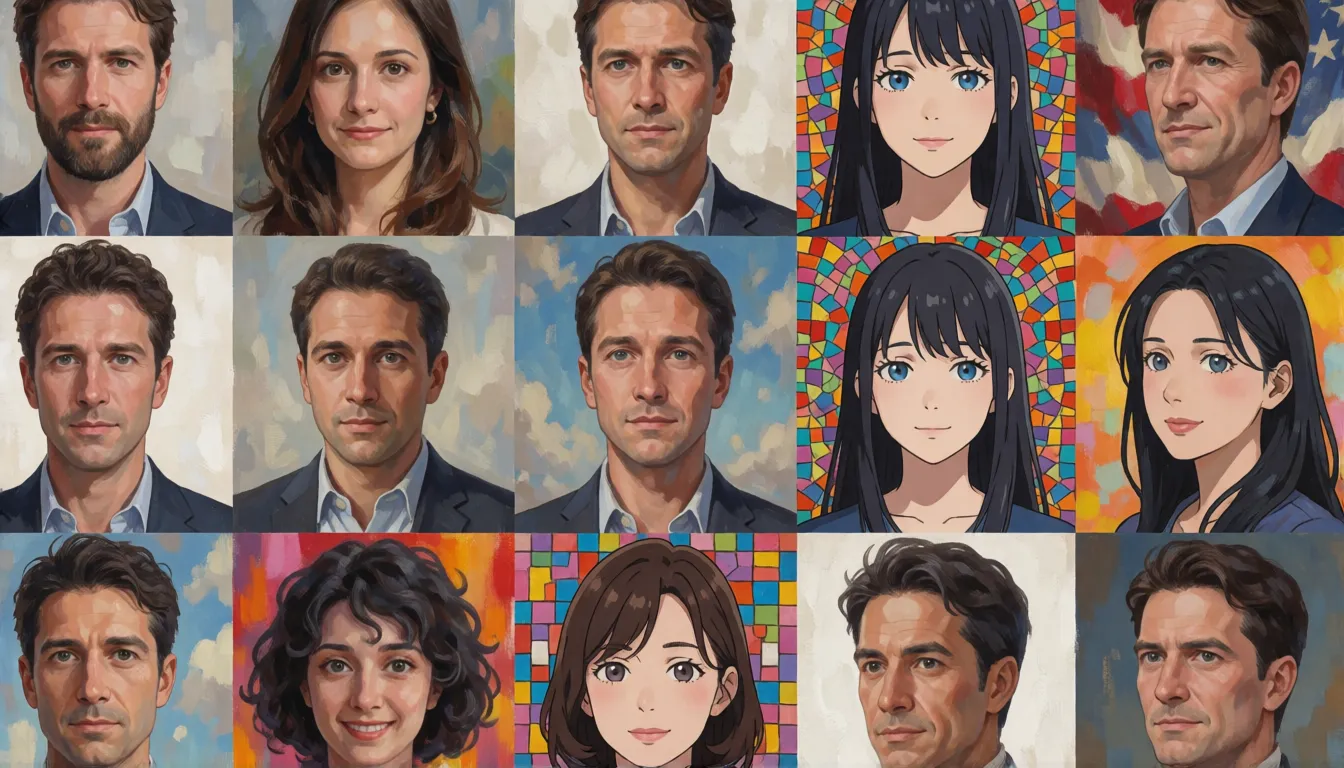
Steckbrief der Z-Image-Familie
- Entwickler
- Alibaba Tongyi Lab (Tongyi MAI)
- Öffentliche Modelle
- Turbo und das Basismodell
- Basismodell veröffentlicht
- Januar 2026
- Größe
- Rund 6,15B, S3-DiT
- Einstellungen Basismodell
- 28–50 Schritte, CFG 3–5
- Offene Gewichte?
- Ja, Apache-2.0
- Edit / Omni-Base
- Angekündigt, nicht veröffentlicht
- Unzensierte Version?
- Keine offizielle
Unzensierter Bildgenerator (Alternative zu Z-Image)
Text zu BildBeschreibe das gewünschte Bild. Füge ein Referenzfoto zum Bearbeiten hinzu oder lass es leer für Text-zu-Bild.
Prompt ausprobieren
Die Beispiel-Prompts sind auf Englisch, das liefert die zuverlässigsten Ergebnisse.
Wer hinter Z-Image steht
Z-Image ist eine Bildmodell-Reihe von Alibabas Tongyi Lab, veröffentlicht vom Team Tongyi MAI über GitHub, Hugging Face und ModelScope. Im Mittelpunkt dieser Seite steht das nicht destillierte Basismodell der Reihe: Sein Hugging-Face-Repository wurde am 23. Januar 2026 angelegt, die offizielle Ankündigung folgte am 27. Januar, etwa zwei Monate nach Turbo. Es teilt mit Turbo den Scalable Single-Stream Diffusion Transformer (S3-DiT) mit rund 6,15 Milliarden Parametern und einen Text-Encoder der Qwen3-4B-Klasse. Empfohlen werden 28 bis 50 Schritte, CFG 3 bis 5 und ein Negativ-Prompt, bei jedem Seitenverhältnis zwischen 512×512 und 2048×2048 Pixeln insgesamt. In der offiziellen Tabelle tauscht es etwas Feinschliff gegen Vielfalt und einfaches Feintuning.
Gibt es Z-Image unzensiert?
Hinter der Suche steckt eigentlich die Frage, ob die offene Veröffentlichung einen Filter enthält. Das hängt davon ab, wie du sie betreibst. Der einzige gehostete Endpunkt der Familie ist Turbo in Alibaba Cloud Model Studio, und der prüft Prompts und Bilder; für das Basismodell gibt es überhaupt keine gehostete API. Die Gewichte selbst sind unter Apache-2.0 offen, eine Kopie auf deiner eigenen GPU hat also keine serverseitige Prüfung, und wer feintunt, wählt für LoRAs mit Erwachsenenfokus oft das Basismodell. Trotzdem hat Alibaba nie ein unzensiertes Z-Image veröffentlicht, und Community-Builds, die auf echten Personen trainiert wurden, bergen rechtliche Risiken. Spicy AI hostet Z-Image nicht; sein Generator nutzt Seedream, Krea 2 und Wan 2.6 ohne Inhaltsfilter für Erwachsene (18+) – als Ersatz, nicht als dasselbe Modell.
Keine Lust, eine GPU einzurichten? Nutze die browserbasierte Alternative.
Generator öffnen →Vier Namen, zwei Downloads
Die Z-Image-Familie umfasst vier Modellnamen, aber nur zwei kommen mit herunterladbaren Gewichten. Der Blog des Teams beschreibt bereits Edit, ein Modell für zusammengesetzte Bearbeitungsanweisungen, doch die GitHub-Tabelle führt es weiterhin als "to be released", und auf ModelScope gibt es keinen Eintrag dazu. Die Veröffentlichungsdaten weichen zwischen Hugging Face und den News-Meldungen um etwa einen Tag ab, daher sind beide angegeben.
| Modell | Gedacht für | Gewichte | Datum | Schritte / CFG |
|---|---|---|---|---|
| Turbo | Tempo, fotorealistische Entwürfe | Öffentlich | 25.–26. Nov. 2025 | 8 Schritte, kein CFG |
| Basismodell | Vielfalt, Feintuning | Öffentlich | 23.–27. Jan. 2026 | 28–50 Schritte, CFG 3–5 |
| Edit | Bearbeitung per Anweisung | Nicht öffentlich | Nicht veröffentlicht | Unbekannt |
| Omni-Base | Nicht näher beschrieben | Nicht öffentlich | Nicht veröffentlicht | Unbekannt |
"Base" ist ein Spitzname aus der Community; die offizielle Tabelle führt dieses Modell nur unter dem Namen der Reihe.
Im Inneren des 6B-Single-Stream-Designs
Viele große Bildmodelle führen Text und Bild in zwei parallelen Strömen. Hier verkettet das Team Prompt-Tokens, visuelle semantische Tokens und VAE-Bild-Tokens zu einer einzigen Sequenz und schickt sie durch einen Transformer – mit dem Argument, dass so mehr aus weniger Parametern herauszuholen ist. Die veröffentlichte Konfiguration nennt 30 Schichten, Hidden Size 3840, 30 Attention Heads, Patch Size 2 und einen Latent mit 16 Kanälen. Laut technischem Bericht verbrauchte die gesamte Trainings-Pipeline 314.000 H800-GPU-Stunden, rund 630.000 US-Dollar – bescheiden für diese Klasse; das sind einmalige Trainingskosten, nicht die Kosten pro Bild.
Wann sich das langsamere Basismodell lohnt
Die Destillation hat Turbo Tempo verschafft, auf Kosten der Bandbreite. Im Test von Gigazine wiederholte Turbo Layouts, wenn sich nur der Seed änderte, und gab mehreren Personen dasselbe Gesicht, während das Basismodell vielfältigere Besetzungen und stärkere Illustrationen lieferte und Negativ-Prompts befolgte. Du zahlst dafür mit Zeit: 28 bis 50 Schritte dauern auf derselben Karte etwa vier- bis sechsmal so lange wie 8. Entscheide anhand der Tabelle je nach Projekt.
| Wenn du … brauchst | Wahl | Grund |
|---|---|---|
| eine Reihe klar unterschiedlicher Gesichter | Basismodell | Mehr Vielfalt über Seeds hinweg |
| ein wiederkehrendes Artefakt unterdrücken | Basismodell | Negativ-Prompt und CFG greifen |
| Anime- oder malerische Illustration | Basismodell | Besser in Tests zu Darstellungsstilen |
| eine eigene LoRA | Basismodell | Als leicht feintunbar eingestuft |
| viele Fotoentwürfe pro Minute | Turbo | 8 Schritte, polierter Look |
Eine Z-Image-LoRA trainieren, ohne das Modell zu ruinieren
Die offizielle Tabelle stuft das Basismodell als leicht feintunbar ein, Turbo als nicht zutreffend. DiffSynth-Studio erklärt den Unterschied: Turbo ist destilliert, und gewöhnliches Training zerstört schnell sein Tempo mit wenigen Schritten. Wenn du unbedingt auf Turbo trainieren musst, schlägt die Doku entweder normales Feintuning mit anschließend langsamerer Inferenz (etwa 30 Schritte, CFG 2) vor oder eine Differential-LoRA bzw. Trajektorien-Destillation, die die Beschleunigung erhält. Für die meisten ist der einfachere Weg, auf dem Basismodell zu trainieren und mit 30 bis 50 Schritten zu samplen. Die Szene ist rege: Eine beliebte LoRA-Sammlung kam in den 30 Tagen vor Oktober 2026 auf rund 241.000 Downloads.
- Schritt 1, Werkzeuge: DiffSynth-Studio übernimmt volles Feintuning und LoRA; ComfyUI lädt das Ergebnis.
- Schritt 2, Daten: Stelle einen einheitlichen, gut beschrifteten Datensatz für einen Stil oder eine Figur zusammen.
- Schritt 3, Rechte: Apache-2.0 deckt das Modell ab, nicht die Personen in deinen Bildern; nutze nur Material, das dir gehört oder für das eine Einwilligung vorliegt.
- Schritt 4, Kontrolle: Lass vor und nach dem Training einige feste Prompts laufen, um verlorene Vielfalt oder kaputte Schrift zu erkennen.
Warten auf Z-Image Edit? Was heute schon funktioniert
Z-Image Edit soll zusammengesetzte Anweisungen umsetzen, etwa Kleidung und Hintergrund in einer Anfrage austauschen und dabei die Person erkennbar lassen. Erschienen ist es noch nicht: Es gibt keine offiziellen Gewichte auf Hugging Face oder ModelScope und weder ein angekündigtes Datum noch eine Lizenz. Bis dahin kannst du Bild-zu-Bild mit dem Basismodell oder Turbo nutzen, ein ControlNet zum Halten der Pose ergänzen oder auf ein anderes Bearbeitungsmodell ausweichen; keine dieser Lösungen sichert die Identität so wie ein spezialisierter Editor. Bei Spicy AI lädst du ein eigenes Foto in den Bildeditor und beschreibst die Änderung; dort laufen andere Modelle, nicht Edit.
Das Basismodell auf dem eigenen Rechner einrichten
Wenn Turbo bei dir schon läuft, ist der Großteil der Einrichtung erledigt, denn das Basismodell nutzt denselben Text-Encoder und dasselbe VAE. Seine offiziellen Gewichte liegen in BF16 vor und sind damit etwa halb so groß wie Turbos ursprüngliche F32-Dateien. Eine gehostete API gibt es dafür nicht, eine eigene oder gemietete GPU ist also die einzige Option.
- Diffusers: ZImagePipeline in bfloat16 laden, dann mit etwa 50 Schritten, Guidance 4 und Negativ-Prompt samplen.
- ComfyUI: das z_image-Repack von Comfy-Org herunterladen und in dieselben Ordner wie Turbo legen.
- Auflösung: jedes Seitenverhältnis zwischen 512×512 und 2048×2048 Pixeln insgesamt.
- Tempo: Rechne auf derselben Karte mit einem Mehrfachen von Turbos Renderzeit.
Von beiden Seiten steuern: positive und negative Prompts
Anders als Turbo liest das Basismodell einen Negativ-Prompt und berücksichtigt CFG, du formst Bilder also aus zwei Richtungen. Beschreibe Motiv und Szene in einfachen Sätzen, dann Licht, Objektiv und Stil; halte den Negativ-Prompt kurz und beschränke ihn auf Probleme, die du tatsächlich siehst. Ein CFG um 4 ist ein sicherer Start – höher für striktere Prompt-Treue, niedriger für weichere, natürlichere Ergebnisse.
| Einstellung | Entwurf | Final |
|---|---|---|
| Schritte | 28 | 40–50 |
| CFG | 3–4 | 4–5 |
| Negativ-Prompt | 2–3 Begriffe | Nur Artefakte, die du gesehen hast |
| Seeds | Frei wechseln | Den besten fixieren |
Prompt-Paare zum Kopieren
Jede Zeile kombiniert einen Prompt mit einem passenden Negativ-Prompt. Ersetze die Klammern; jede abgebildete Person ist erwachsen.
| Ziel | Prompt | Negativ-Prompt |
|---|---|---|
| Vielfältige Porträts | Porträt einer erwachsenen [Person], [Haare, Outfit], [Umgebung], [Licht], 50-mm-Foto, natürliche Haut. | unscharf, Plastikhaut, doppelte Gesichter |
| Anime-Illustration | Anime-Illustration einer erwachsenen [Figur] in [Outfit], [Pose], [Hintergrund], saubere Linien, weiches Cel-Shading. | zusätzliche Gliedmaßen, unsaubere Linien, Text |
| Zweisprachiges Poster | [Stil]-Poster, Überschrift "[chinesischer Text]" über "[englischer Text]", [Hauptmotiv], ausgewogenes Layout. | falsch geschriebener Text, Unordnung, Wasserzeichen |
| Gruppenfoto | Ungestelltes Foto von [Anzahl] Erwachsenen in [Ort], jeweils mit anderer Frisur und Kleidung, [Licht]. | identische Gesichter, abgeschnittene Köpfe |
Wofür Kreative das Basismodell nutzen
Da das Basismodell mehr Vielfalt bewahrt, greifen Leute darauf zurück, wenn sie erkunden statt zu sprinten. Diese Einsatzzwecke tauchen auf Modellkarten und LoRA-Seiten immer wieder auf.
- Look-Entwicklung: ein Prompt über viele Seeds, um eine Richtung zu finden, danach eine LoRA, um sie festzuhalten.
- Illustration und Anime: Charakterbögen und malerische Szenen, bei denen es Turbo in Tests zu Darstellungsstilen schlägt.
- Vielfältige Besetzung: Lookbooks und Gruppenaufnahmen, in denen jede erwachsene Person ein eigenes Gesicht braucht.
- Zweisprachiges Design: Poster mit chinesischem und englischem Text, die Kombination, die das Team hervorhebt.
- Synthetische Referenzen: vielfältige Bilder zum Trainieren eines eigenen Stilmodells.
Darf man es herunterladen, verändern und weitergeben?
Ja. Beide öffentlichen Modelle haben offene Gewichte unter Apache-2.0, wie im GitHub-Repository und auf den Hugging-Face-Modellkarten angegeben, und auch der Inferenz-Code ist offen. Du darfst das Modell nutzen, verändern und weiterverbreiten. Rechte am Namen Z-Image, am Abbild von Personen in deinen Bildern oder an urheberrechtlich geschützten Figuren erhältst du dadurch nicht, und eine vollständige Liste der Trainingsdaten hat das Team nicht veröffentlicht.
Wofür sich das Basismodell eignet
Looks erkunden
Wirklich unterschiedliche Umsetzungen einer Idee, bevor du dich auf einen Stil festlegst.
Illustration
Erwachsene Anime- und malerische Figuren mit sauberer Linienführung.
Deine eigene LoRA
Eine trainierbare Basis für einen Stil, ein Produkt oder eine Figur.
Checkliste vor dem Generieren
- Nutze 28–50 Schritte und CFG 3–5; mit Turbos Einstellungen bleibt das Basismodell unfertig.
- Halte Negativ-Prompts kurz und beschränke sie auf sichtbare Probleme.
- Trainiere LoRAs auf dem Basismodell statt auf Turbo.
- Warte nicht auf Edit; Bild-zu-Bild oder ein anderer Editor funktioniert schon jetzt.
- Beschreibe jede Figur als erwachsen (18+) und trainiere nur mit Bildern, an denen du die Rechte hast.
Z-Image selbst hosten vs. online auf Spicy AI generieren
| Lokale Bereitstellung (offizielle Gewichte) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Von Alibaba Tongyi Lab festgelegt | Keine Inhaltsfilter |
| Offene Gewichte | Ja | Nicht nötig — läuft im Browser |
| Modell | Z-Image | Seedream, Krea 2 und Wan 2.6 |
| Einstiegspreis | Je nach Tarif | Kostenloser Tarif verfügbar |
- Text-zu-Bild aus einem Prompt
- Bild-zu-Bild-Bearbeitung mit Referenzfoto
- Bis zu 4 Bilder pro Durchlauf in mehreren Formaten
Häufige Fragen
Was ist Z-Image?
Eine Familie offener 6B-Text-zu-Bild-Modelle von Alibabas Tongyi Lab. Turbo ist das schnelle Modell mit 8 Schritten; das Basismodell ist langsamer, vielfältiger und für Feintuning gedacht.
Ist Z-Image Base ein eigenes Produkt?
Nein. "Base" ist der Community-Name für das Basismodell in der offiziellen Tabelle, veröffentlicht im Januar 2026.
Ist Z-Image Edit verfügbar?
Noch nicht. Der Blog des Teams beschreibt es, aber es ist als noch nicht veröffentlicht gelistet und hat keine öffentlichen Gewichte.
Gibt es eine offizielle unzensierte Version?
Nein. Lokale Ausführungen der offenen Gewichte haben keinen gehosteten Filter, und Community-LoRAs sind inoffiziell.
Ist Spicy AI mit Alibaba Tongyi Lab verbunden?
Nein. Spicy AI ist eine unabhängige Plattform und weder mit Alibaba Tongyi Lab verbunden noch von dort unterstützt. Z-Image ist eine Marke des jeweiligen Inhabers.
Ist es kostenlos?
Du kannst mit täglichen Generierungen kostenlos starten und Credits kaufen, wenn du mehr brauchst.
Quellen
Spicy AI ist nicht mit Alibaba Tongyi Lab verbunden. Z-Image und andere Produktnamen sind Marken ihrer jeweiligen Inhaber und werden hier nur zur Kennzeichnung verwendet. Alle Inhalte müssen Erwachsene (18+) darstellen.