Schnelle KI-Bildgenerierung · Speed-Erweiterung
P-Q-Image-2.1: Bilder und Bearbeitungen in nur 6 Schritten
Bei jedem Bild vierzig Sampling-Schritte abzuwarten, nimmt dem Experimentieren jeden Spaß. P-Q-Image-2.1 löst das Problem. Veröffentlicht von PrunaAI, dem auf Geschwindigkeit spezialisierten Team hinter dem Open-Source-Toolkit pruna, ist es eine kleine Erweiterung für Alibabas Open-Weights-Modell Qwen-Image-2.1, die neue Bilder erzeugt und vorhandene bearbeitet – in nur sechs Schritten und ohne Negativ-Prompt, den man feinjustieren müsste. PrunaAI nennt eine bis zu etwa 6,3-mal schnellere Generierung als mit der regulären 40-Schritt-Basis.
- Kostenlos starten
- Schnelle Entwürfe
- Läuft im Browser
- Entwickelt von
- PrunaAI
- Funktioniert mit
- Qwen-Image-2.1 (Basisgewichte erforderlich)
- Neueste Version
- v0.2: 6-steps und 6-steps-upsampled
- Kann
- Text zu Bild und Bearbeitung mit bis zu 3 Referenzen
- Angegebene Geschwindigkeit
- Bis zu ~6,3× gegenüber der 40-Schritt-Basis
- Offene Gewichte
- Ja, auf Hugging Face
Unzensierter alternativer Bildgenerator
Text zu BildBeschreibe das gewünschte Bild oder lade ein Foto hoch und beschreibe die Bearbeitung.
Ein Turbo-Knopf für Qwen-Image-2.1
Stell dir P-Q-Image-2.1 eher als Tuning-Chip denn als neuen Motor vor. Es ist eine LoRA, also eine schlanke Datei, die auf Qwen-Image-2.1 aufsetzt und dem Modell beibringt, mit deutlich weniger Schritten zu einem fertigen Bild zu kommen. Basismodell, Text-Encoder und VAE bleiben exakt gleich – du brauchst also weiterhin die Originalgewichte und behältst alles, wofür die Basis geschätzt wird: scharfen Text im Bild, Ausgabe mit transparentem Hintergrund und Bearbeitung per Anweisung. Was sich ändert, ist die Wartezeit. Du setzt CFG auf 1, lässt den Negativ-Prompt weg und erhältst je nach Adapter in 5, 6 oder 8 Schritten ein Ergebnis. PrunaAI hat seinen Spitzenwert von bis zu etwa 6,3× auf einer einzelnen H100 in BF16 bei Batchgröße 1 gemessen, verglichen mit dem üblichen 40-Schritt-Durchlauf. Das Projekt startete im September 2026 als Pruna-Qage-2.1, bevor es seinen heutigen Namen bekam.
Von v0.1 zu v0.2: eine Schrittzahl, zwei klügere Adapter
Die erste Version, v0.1, erschien um den 23. September 2026 und bot die Wahl zwischen einem 8-Schritt-Adapter, der empfohlenen Standardoption, und einem 5-Schritt-Adapter, der schneller, aber sichtbar weicher ist. Version 0.2 ersetzt diesen Kompromiss durch einen einzigen 6-Schritt-Ablauf, der per Distillation weiter optimiert wurde, und teilt ihn dann in zwei Varianten auf. Der einfache 6-steps-Adapter bleibt beim Bearbeiten näher am Originalfoto, sodass Gesichter, Logos und Produktdetails erhalten bleiben. Im 6-steps-upsampled-Adapter ist der offizielle Prompt-Expander bereits eingebaut: Eine Idee aus fünf Wörtern kommt als detailreiche Szene zurück, ganz ohne separaten Aufruf eines Sprachmodells. Mit derselben Version kam auch der erste offizielle ComfyUI-Export mit sechs fertigen Workflows; zu Zeiten von v0.1 mussten Community-Mitglieder die Dateien noch selbst konvertieren.
| Adapter | Schritte | Stärke | Ideal für |
|---|---|---|---|
| v0.1 8-steps | 8 | Höchste Qualität der ersten Version | Sichere Standardwahl bei älteren Setups |
| v0.1 5-steps | 5 | Schnellste Option | Grobe Entwürfe, bei denen die Qualität sinken darf |
| v0.2 6-steps | 6 | Bleibt beim Bearbeiten nah am Ausgangsbild | Outfit-Wechsel, Produktbearbeitung, Porträts |
| v0.2 6-steps-upsampled | 6 | Eingebaute Prompt-Erweiterung | Kurze Prompts, die opulent wirken sollen |
Upsampled oder 6-steps: den richtigen Adapter wählen
Beide v0.2-Dateien haben dieselbe Größe, Stärke und denselben Sampler, die Wahl hängt also ganz davon ab, wie du gern schreibst. Wenn du lange, präzise Prompts verfasst oder ein Foto bearbeitest, auf dem Person oder Produkt erkennbar bleiben müssen, lade den 6-steps-Adapter. Wenn du lieber eine schnelle Idee wie "Cyberpunk-Heldin in einer verregneten Neon-Gasse, filmisch" eintippst und das Modell Licht, Objektiv und Ausstattung erfinden lässt, macht der upsampled-Adapter mehr Spaß. PrunaAI weist darauf hin, dass er den offiziellen Expander zwar eng, aber nicht perfekt nachahmt; die Ergebnisse können also von denen abweichen, die man mit einem echten vorgeschalteten Prompt-Erweiterungsmodell erhält.
- Ein Gesicht, ein Produkt oder ein Markendetail bearbeiten: 6-steps.
- Kurze, verspielte Prompts und Moodboards: 6-steps-upsampled.
- Maximales Tempo, Qualität zweitrangig: v0.1 5-steps.
- Vorsichtigste Wahl für einen bestehenden v0.1-Workflow: v0.1 8-steps.
- Immer nur einen Adapter laden und den dazugehörigen Sigma-Ablauf verwenden.
Trainiert wurde mit 1K-Bildern und bis zu drei Referenzbildern. Beginne mit 1024×1024; 2K-Ausgabe oder mehr Referenzen können funktionieren, liegen aber außerhalb dessen, worauf die Adapter trainiert wurden.
Wo sich Rendering in sechs Schritten wirklich lohnt
Tempo zählt vor allem dann, wenn du viele Bilder brauchst, nicht nur eines. Deshalb hat sich die Erweiterung bei Creators durchgesetzt, die in großen Mengen iterieren. Der Sprung von vierzig auf sechs Schritte macht aus einem langsamen Batch über Nacht etwas, dem man live zusehen kann, und lässt das Feintuning in ComfyUI fast interaktiv wirken.
Im Erwachsenenbereich sind die beliebtesten Sets leicht vorstellbar: ein Strandurlaub-Shooting, ein Poolparty-Look oder ein Retro-Pin-up-Badeanzugposter, erstellt durch Bearbeiten eines vorhandenen Fotos, bei dem nur die Kleidung ersetzt wird. Weil das Basismodell Schrift gut darstellt, setzen Händler und Postergestalter es auch für Überschriften ein, während sie dank des Tempos mehrere Layouts in der Zeit ausprobieren können, die früher ein einzelnes 40-Schritt-Rendering gedauert hat.
| Wer | Was entsteht | Warum weniger Schritte helfen |
|---|---|---|
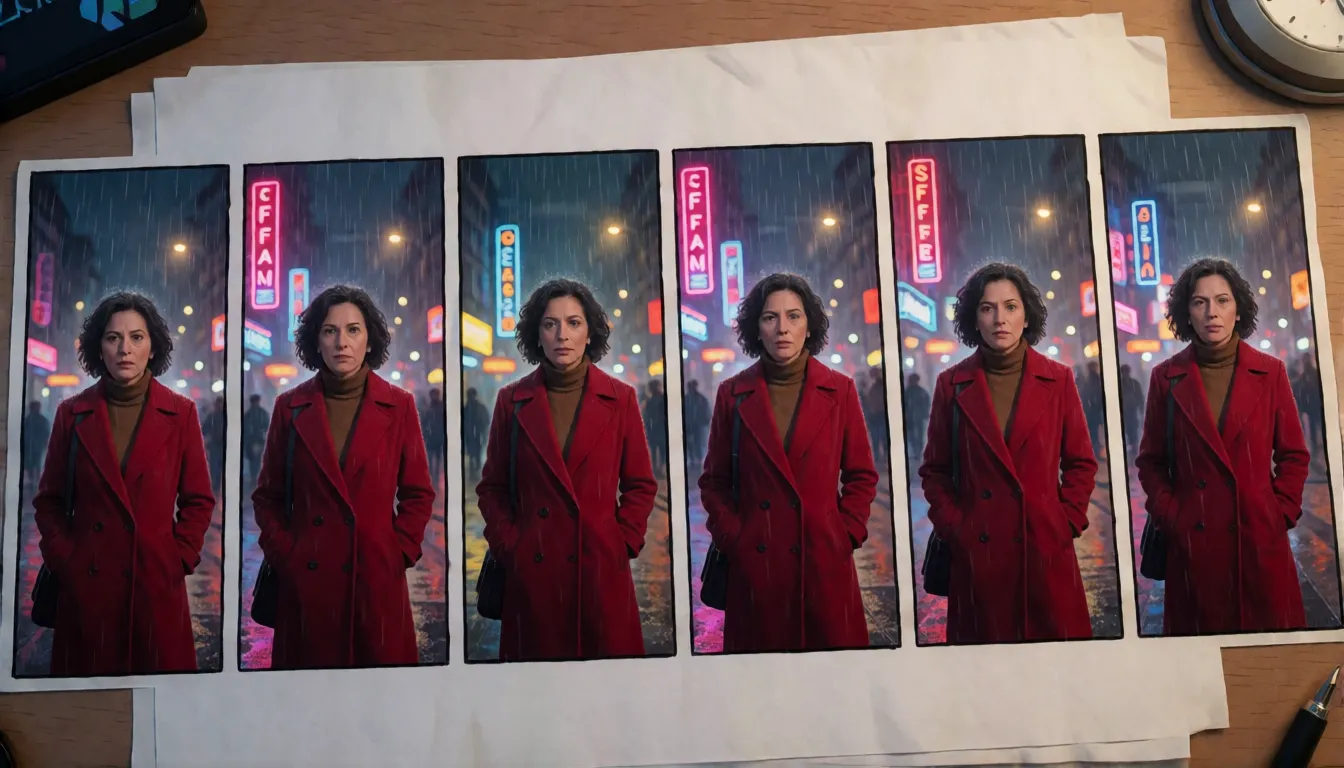
| Teams für Kurzdramen und KI-Comics | Dutzende vertikale Storyboard-Frames mit einer wiederkehrenden Figur | Viele Blickwinkel und Stimmungen ausprobieren, bevor die besten ausgearbeitet werden |
| Online-Händler | Produktfotos auf weißem Hintergrund, neue Hintergründe, Farbvarianten, Sale-Poster | Einen ganzen Katalog an Varianten in einem Durchgang erstellen |
| Fashion- und Try-on-Creators | Person + Outfit + Location, kombiniert aus bis zu drei Referenzen | Looks schnell wechseln und das Gesicht konsistent halten |
| ComfyUI-Tüftler | Sitzungen aus Prompt und Vorschau | Jede Änderung fast so schnell sehen, wie man tippt |
| Erwachsenen-Creators (18+) | Bikini-, Badeanzug- und Dessous-Outfitwechsel fiktiver oder einwilligender Erwachsener | Der 6-steps-Adapter erhält Gesicht und Figur, während sich das Outfit ändert |
Prompt-Vorlagen zum Kopieren und Einfügen
Diese Vorlagen folgen dem, was mit dem Basismodell am besten funktioniert: zuerst das Motiv beschreiben, dann Umgebung, Licht und Objektiv, und Text im Bild in Anführungszeichen setzen. Mit dem 6-steps-Adapter die vollständige Vorlage verwenden; mit dem upsampled-Adapter reicht eine kurze Zeile. Es sind Ausgangspunkte zum Anpassen, keine offiziellen Beispiele.
- Vollständiges Text zu Bild (6-steps): "[Motiv], [Pose oder Handlung], [Outfit-Details], [Ort und Tageszeit], [Licht: weiches Fensterlicht / Gegenlicht zur goldenen Stunde], [Objektiv: 35mm Halbtotale / Untersicht], [Stil: Werbefoto / Anime], Postertitel "DEIN TITEL" oben"
- Kurzer Prompt (upsampled): "Cyberpunk-Heldin auf einer verregneten Neon-Straße, filmisch"
- Outfit-Wechsel (18+, fiktive oder einwilligende erwachsene Person): "Gesicht, Frisur, Pose und Hintergrund unverändert lassen, das Oberteil durch einen roten String-Bikini ersetzen, realistischer Stoff, Beleuchtung passend zum Original"
- Neuer Hintergrund: "Motiv und seine Kanten beibehalten, Hintergrund durch einen Strand auf den Malediven ersetzen, natürlichen Schatten hinzufügen"
- Kombination aus drei Referenzen: "Die Person aus Bild 1 trägt das Outfit aus Bild 2 und steht in der Szene aus Bild 3, Ganzkörper, natürliches Licht"
- Storyboard-Frame: "Vertikal 9:16, [Figur aus Bild 1], dreht sich um und blickt über die Schulter zurück, angespannte Stimmung, filmische Beleuchtung, geringe Schärfentiefe"
- Produktposter: "Produkt aus Bild 1 auf einer Marmortheke, großer Titel "SUMMER DROP" links, darunter kleine Zeile "20 % Rabatt diese Woche", hochwertiges weiches Licht"
Schreibtipp: Kurze, vage Prompts wirken mit den einfachen Adaptern flacher – also entweder Details ergänzen oder zur upsampled-Datei wechseln.
P-Q-Image-2.1: ComfyUI-Workflow und Einstellungen
PrunaAI veröffentlicht ein ComfyUI-fertiges Repository, PrunaAI/P-Q-Image-2.1-Comfy, mit BF16-LoRAs als Einzeldateien und sechs Workflow-Dateien: Text zu Bild und Bearbeitung für jede Version. Benutzerdefinierte Nodes sind nicht nötig, solange dein ComfyUI-Build Qwen-Image-2.1 nativ unterstützt; der Adapter wird über den eingebauten Node LoraLoaderModelOnly mit Stärke 1.0 geladen.
Speicher: PrunaAI hat keine Werte für Consumer-GPUs veröffentlicht. Der praktische Hebel ist die int8-Basis plus der int8-Text-Encoder, was den Speicherbedarf senkt; Quantisierung und Speed-Adapter lösen unterschiedliche Probleme und lassen sich kombinieren.
- ComfyUI aktualisieren, dann das Basis-Diffusionsmodell (BF16 oder zum Speichersparen den int8-convrot-Build), den qwen3vl_8b-int8-Text-Encoder, das VAE und die LoRA in die üblichen Ordner legen.
- Den passenden offiziellen Workflow auf die Arbeitsfläche ziehen.
- Sampler euler, CFG 1, leerer Negativ-Prompt, LoRA-Stärke 1.0.
- v0.2 ManualSigmas: 1.0, 0.961054, 0.918949, 0.769302, 0.545554, 0.222292, 0.
- Mit 1024×1024 beginnen und erst danach größere Formate testen.
| Häufiger Fehler | Was du stattdessen tun solltest |
|---|---|
| Turbo-Basis laden | Die reguläre Basis aus Comfy-Org/Qwen-Image-2.1 verwenden; laut PrunaAI nicht mit Turbo kombinieren |
| Sigmas von v0.1 und v0.2 mischen | Jeder Adapter hat seinen eigenen Ablauf; aus dem Workflow der jeweiligen Version kopieren |
| Zwei Pruna-Adapter stapeln | Immer nur einen laden |
| Direkt auf 2K springen | Mit 1K beginnen, der Größe, auf die die Adapter trainiert wurden |
Ausführen mit Diffusers
Für Python-Nutzer zeigt die Modellkarte einen Weg über Diffusers: QwenImage21Pipeline aus Qwen/Qwen-Image-2.1 laden, load_lora_weights mit dem Repository PrunaAI/P-Q-Image-2.1 und der gewünschten Adapterdatei aufrufen und einen FlowMatch-Euler-Scheduler mit dynamischem Shifting verwenden. num_inference_steps auf 6 und true_cfg_scale auf 1 setzen und den KV-Cache aktivieren; zum Bearbeiten die Bilder über das Argument image übergeben. Die Diffusers-Variante nutzt ungeshiftete Sigmas [1.0, 0.925, 0.85, 0.625, 0.375, 0.125] plus dynamischen Shift. Die Karte legt einen bestimmten Diffusers-Commit und transformers 5.17 oder neuer fest – halte dich an diese Versionen, um Überraschungen zu vermeiden.
P-Q-Image-2.1 vs. Lightning, Turbo und int8
Wer Qwen-Image-2.1 beschleunigen will, vergleicht meist drei Wege. Die Community-LoRA Lightning geht noch tiefer, auf 4 Schritte. Der Adapter von PrunaAI kontert mit 6 Schritten, einem eingebauten Prompt-Expander und offiziellen Bearbeitungs-Workflows. Die Turbo-Basis ist ein separater schneller Checkpoint, und PrunaAI sagt ausdrücklich, dass sie nicht mit dieser Erweiterung kombiniert werden soll. Int8- oder GGUF-Quantisierung spart Speicher statt Schritte und passt daher zu beiden LoRAs. Einen offiziellen direkten Vergleich unter identischen Bedingungen gibt es nicht; der fairste Rat lautet also, die eigenen Prompts mit beiden zu testen.
| Weg | Schritte | Was du gewinnst | Worauf achten |
|---|---|---|---|
| PrunaAI v0.2 LoRA | 6 | Option zur Prompt-Erweiterung, originalgetreue Bearbeitungen, offizielle ComfyUI-Workflows | Auf 1K trainiert; nicht für die Turbo-Basis |
| Lightning LoRA | 4 | Wenigste Schritte | Keine eingebaute Prompt-Erweiterung |
| Turbo-Basis | Wenige | Tempo ohne LoRA | Nicht kompatibel mit den Pruna-Adaptern |
| Int8 / GGUF | Unverändert | Geringerer Speicherbedarf | Beschleunigt allein nichts |
Was die Community sagt
Das Upstream-Repository verzeichnete im letzten Monat mehr als 480.000 Downloads, 177 Likes, neun Diskussions-Threads und den Einsatz in mehreren Hugging Face Spaces, während das ComfyUI-Repository innerhalb weniger Tage seine ersten Likes sammelte. ComfyUI Wiki berichtete über den Start von v0.1, und die deutsche Seite Mind-Verse schrieb über die Veröffentlichung als Möglichkeit, Qwen-Image-2.1 zu beschleunigen. Noch bevor es den offiziellen ComfyUI-Export gab, hatten Nutzer bereits inoffizielle Konvertierungen geteilt – ein Zeichen dafür, wie ungeduldig lokale Creators waren. PrunaAI geht offen mit den Kompromissen um: v0.1-Bilder reichen nicht an die volle 40-Schritt-Basis heran, kurze oder vage Prompts leiden am stärksten, die Ausgaben stimmen eventuell nicht exakt mit der Basis überein, und die Gewichte sind nicht final. Genau diese Ehrlichkeit ist auch der Grund, warum v0.2 Aufmerksamkeit bekommt, denn es zielt genau auf diese Schwachstellen.
Gibt es ein unzensiertes P-Q-Image-2.1?
Nein. Die Erweiterung ändert nur das Tempo; es gibt keine NSFW-Edition, und sie lockert nicht, was das Basismodell darstellt – das hängt von den Basisgewichten und weiteren geladenen LoRAs ab. Community-Uploads mit der Bezeichnung "uncensored" Qwen-Image-2.1 entpuppten sich Berichten zufolge entweder als die Originalgewichte oder als bloß ausgetauschter Text-Encoder ohne sichtbaren Unterschied, und die Turbo-basierte Variante lässt sich mit diesem Adapter ohnehin nicht nutzen. Für schnelle, uneingeschränkte Erwachsenen-Bearbeitungen wie Badeanzug- oder Dessous-Looks im Browser bietet Spicy AI einen ähnlichen unzensierten Bildeditor.
Badeanzug- und Bikini-Wechsel
Das Outfit einer erwachsenen Person in einen Bikini oder Einteiler ändern, während Gesicht und Pose bleiben.
Strand- und Pool-Sets
Ein Porträt an einen sonnigen Strand oder auf eine Rooftop-Poolparty versetzen.
Retro-Pin-up-Poster
Badeanzüge mit Polka Dots, Filmkorn und kräftige Überschriften.
- Erst sagen, was gleich bleiben muss, dann, was sich ändern soll.
- Licht und Objektiv benennen: Gegenlicht zur goldenen Stunde, 85mm-Porträt.
- Angeben, dass jede Person erwachsen ist (18+).
Lade ein Foto einer erwachsenen Person hoch oder beschreibe eine Szene und probiere online einen Bikini-, Strand- oder Pin-up-Look aus.
Bildeditor öffnen →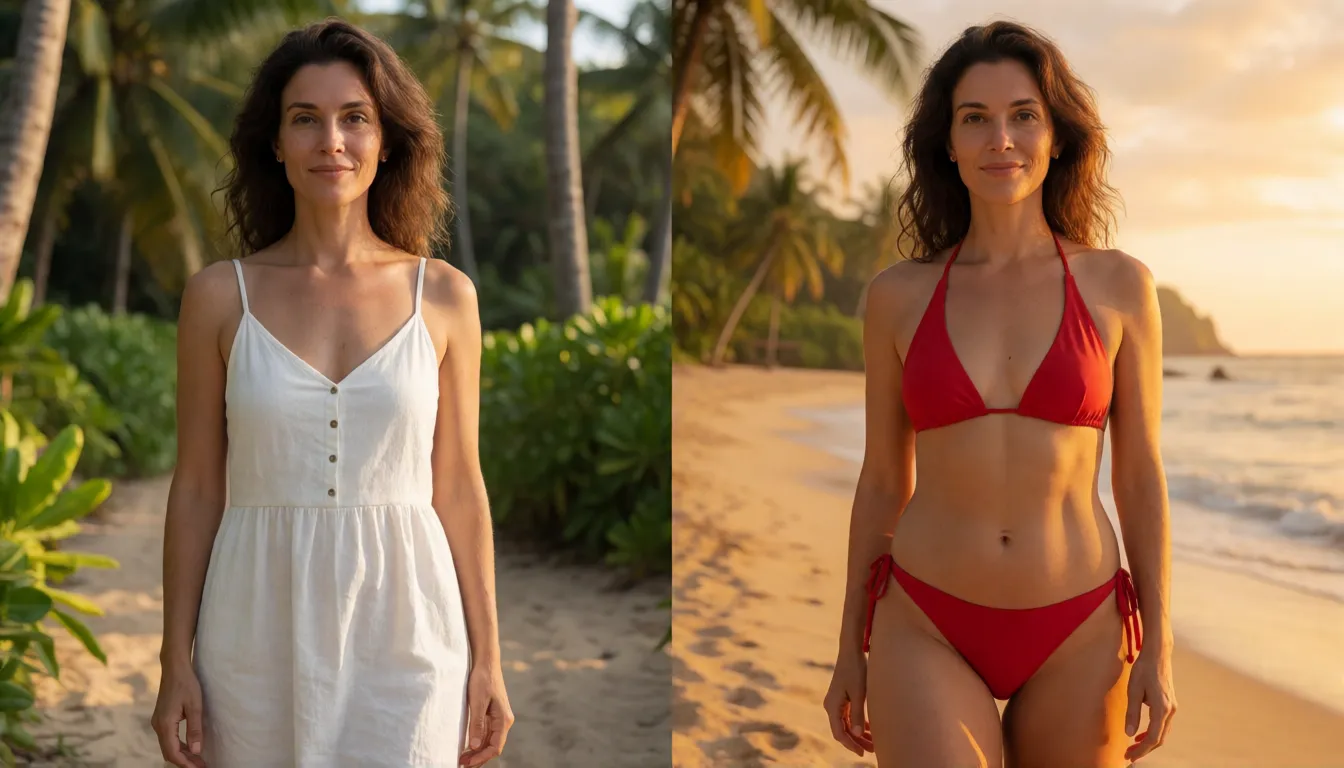
P-Q-Image-2.1 selbst hosten vs. online generieren mit Spicy AI
| Lokale Installation (Originalgewichte) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Wie beim geladenen Basismodell | Keine Inhaltsfilter |
| Offene Gewichte | Ja | Nicht nötig – läuft im Browser |
| Modell | Qwen-Image-2.1 plus Speed-Adapter | Ähnlicher unzensierter Bildeditor, online gehostet |
| Einstiegskosten | Deine eigene GPU | Kostenloser Tarif verfügbar |
FAQ
Ist P-Q-Image-2.1 ein eigenständiges Modell?
Nein. Es ist eine LoRA für wenige Schritte von PrunaAI, die auf Qwen-Image-2.1 aufsetzt. Basismodell, Text-Encoder und VAE bleiben unverändert, du brauchst also die Basisgewichte.
Was hat sich zwischen v0.1 und v0.2 geändert?
v0.1 bot Adapter mit 5 und 8 Schritten. v0.2 legt sich auf 6 Schritte fest und teilt sich in einen 6-steps-Adapter, der beim Bearbeiten mehr erhält, und einen 6-steps-upsampled-Adapter mit eingebauter Prompt-Erweiterung – dazu offizielle ComfyUI-Dateien und Workflows.
Wie viel schneller ist es?
PrunaAI gibt bis zu etwa 6,3× gegenüber der 40-Schritt-Basis an, gemessen auf einer H100 in BF16 bei Batchgröße 1. Werte für Consumer-Grafikkarten wurden nicht veröffentlicht.
Welche ComfyUI-Einstellungen sollte ich verwenden?
Einen ComfyUI-Build mit nativer Qwen-Image-2.1-Unterstützung, LoraLoaderModelOnly mit Stärke 1.0, euler, CFG 1, keinen Negativ-Prompt und die ManualSigmas, die zu deinem Adapter gehören. Die reguläre Basis verwenden, nicht Turbo.
Kann es Bilder mit mehreren Referenzen bearbeiten?
Ja. Trainiert wurde die Bearbeitung mit bis zu drei Referenzbildern. Mehr Referenzen oder 2K-Ausgabe können funktionieren, liegen aber außerhalb des Trainingsbereichs.
Hieß es früher Pruna-Qage-2.1?
Ja. Die Version v0.1 wurde als PrunaAI/Pruna-Qage-2.1 veröffentlicht; heute liegt sie unter neuem Namen im Hugging-Face-Konto von PrunaAI, mit einem separaten Repository für die ComfyUI-Dateien.
Soll ich es oder die Lightning-LoRA mit 4 Schritten wählen?
Lightning braucht weniger Schritte. PrunaAIs v0.2 bietet zusätzlich eine Option zur Prompt-Erweiterung und offizielle Bearbeitungs-Workflows. Einen offiziellen Vergleich unter gleichen Bedingungen gibt es nicht, also teste beide mit deinen eigenen Prompts.
Ist Spicy AI mit PrunaAI oder dem Qwen-Team verbunden?
Nein. Spicy AI ist eine unabhängige Plattform und steht mit keinem der beiden in Verbindung oder wird von ihnen unterstützt. Alle Marken gehören ihren jeweiligen Inhabern.
Ist es kostenlos?
Du kannst kostenlos mit täglichen Generierungen starten und Credits kaufen, wenn du mehr brauchst.
Quellen
- Modellkarte PrunaAI/P-Q-Image-2.1 (Hugging Face)
- PrunaAI/P-Q-Image-2.1-Comfy: Dateien und Workflows (Hugging Face)
- v0.1-Repository, PrunaAI/Pruna-Qage-2.1 (Hugging Face)
- Basismodell Qwen-Image-2.1 (Hugging Face)
- Comfy-Org: Qwen-Image-2.1-Dateien (Hugging Face)
- Bericht zum Start von v0.1 (ComfyUI Wiki)
- Bericht zur Veröffentlichung (Mind-Verse, Deutsch)
- Open-Source-Toolkit pruna (GitHub)