高速AI画像生成 · 高速化アドオン
P-Q-Image-2.1:わずか6ステップで画像生成と編集
1枚ごとに40ステップのサンプリングを待っていては、試行錯誤の楽しさが台無しです。P-Q-Image-2.1 はその問題を解決します。オープンソースの pruna ツールキットを手がける高速化専門チーム PrunaAI が公開したもので、Alibaba のオープンウェイトモデル Qwen-Image-2.1 に追加する小さなアドオンです。わずか6ステップで新しい画像を描き、既存の画像を編集でき、ネガティブプロンプトの調整も不要です。PrunaAI によれば、通常の40ステップのベースと比べて最大約6.3倍高速に生成できます。
- 無料で始められる
- 素早い下描き
- ブラウザで動作
- 開発元
- PrunaAI
- 対応モデル
- Qwen-Image-2.1(ベースウェイトが必要)
- 最新バージョン
- v0.2:6-steps と 6-steps-upsampled
- できること
- テキストからの画像生成と、最大3枚の参照画像を使った編集
- 速度
- 40ステップのベース比で最大約6.3倍
- オープンウェイト
- あり(Hugging Face で公開)
無修正の代替画像ジェネレーター
テキストから画像欲しい画像を説明するか、写真をアップロードして編集内容を説明してください。
Qwen-Image-2.1 のターボボタン
P-Q-Image-2.1 は新しいエンジンというより、性能を引き上げるチップのようなものです。これは LoRA、つまり Qwen-Image-2.1 の上に載る軽量ファイルで、はるかに少ないステップで完成した画像にたどり着けるようモデルを学習させます。ベースモデル、そのテキストエンコーダーと VAE はまったく変わらないため、元のウェイトは引き続き必要ですが、ベースが愛される理由である画像内のくっきりした文字、背景透過の出力、指示ベースの編集はすべてそのまま使えます。変わるのは待ち時間です。CFG を1にし、ネガティブプロンプトを省けば、アダプターに応じて5、6、8ステップで結果が得られます。PrunaAI は最大約6.3倍という数値を、H100 1基・BF16・バッチサイズ1の条件で、通常の40ステップ実行と比較して計測しました。このプロジェクトは2026年9月に Pruna-Qage-2.1 として始まり、その後現在の名前に変わりました。
v0.1 から v0.2 へ:ステップ数はひとつ、アダプターは賢く2種類
最初のリリース v0.1 は2026年9月23日ごろに登場し、推奨デフォルトの8ステップ版と、より速いものの目に見えて甘くなる5ステップ版から選ぶ形でした。バージョン0.2 ではこのトレードオフをやめ、蒸留をさらに進めた単一の6ステップスケジュールに統一したうえで、2つのタイプに分けています。素の 6-steps アダプターは編集時に元の写真をよりよく保つため、顔やロゴ、商品のディテールが崩れません。6-steps-upsampled アダプターには Qwen 純正のプロンプト拡張機能が組み込まれており、数語のアイデアでも、別途言語モデルを呼び出すことなく細部まで描き込まれたシーンとして返ってきます。同じリリースで、PrunaAI 自身による初の ComfyUI 向けエクスポートと、すぐに使える6つのワークフローも提供されました。v0.1 の頃は、コミュニティのメンバーが自分でファイルを変換する必要がありました。
| アダプター | ステップ数 | 強み | 向いている用途 |
|---|---|---|---|
| v0.1 8-steps | 8 | 初期リリースで最高の品質 | 古い環境での無難なデフォルト |
| v0.1 5-steps | 5 | 最速の選択肢 | 品質が落ちてもよいラフ案 |
| v0.2 6-steps | 6 | 編集時に元画像を忠実に保つ | 衣装の差し替え、商品の編集、ポートレート |
| v0.2 6-steps-upsampled | 6 | プロンプト拡張を内蔵 | 短いプロンプトでも豊かに見せたいとき |
Upsampled と 6-steps:最適なアダプターの選び方
v0.2 の2つのファイルはサイズ、強度、サンプラーが同じなので、選択はプロンプトの書き方の好み次第です。長く正確なプロンプトを書く人や、写真を編集していて人物や商品をそれと分かる状態に保ちたい場合は、6-steps アダプターを読み込みましょう。「雨のネオン路地に立つサイバーパンクのヒロイン、シネマティック」のような短いアイデアを打ち込んで、ライティングやレンズ、セットの作り込みはモデルに任せたいなら、upsampled アダプターが楽しい選択です。PrunaAI によると、このアダプターは純正のプロンプト拡張機能をかなり忠実に模倣しますが完全ではないため、本物のプロンプト拡張モデルを先に通した場合とは結果が異なることがあります。
- 顔、商品、ブランドのディテールを編集する:6-steps。
- 短く遊び心のあるプロンプトやムードボード:6-steps-upsampled。
- 速度最優先で品質は二の次:v0.1 5-steps。
- 既存の v0.1 ワークフローで最も保守的な選択:v0.1 8-steps。
- アダプターは一度に1つだけ読み込み、それに対応するシグマスケジュールを使いましょう。
学習は1K画像と最大3枚の参照画像を対象にしています。まずは1024×1024から始めましょう。2K出力やそれ以上の参照画像も動作する可能性はありますが、アダプターの学習範囲外です。
6ステップ描画が本当に効く場面
速度が最も重要になるのは、1枚ではなく大量の画像が必要なときです。だからこそ、このアドオンは大量に試行を重ねるクリエイターの間で人気を集めています。40ステップから6ステップに減らせば、一晩かかっていた遅いバッチ処理が目の前で進むものに変わり、ComfyUI でのリアルタイム調整もほぼインタラクティブな感覚になります。
成人向けの分野で人気のセットは想像しやすいものです。ビーチでのバカンス撮影、プールサイドのパーティールック、レトロなピンナップ水着ポスターなどを、既存の写真を編集して服だけを置き換えることで作ります。ベースモデルは文字の描画が得意なので、販売者やポスター制作者は見出しテキストにも活用しており、その速さのおかげで、かつて40ステップの描画1回にかかっていた時間で複数のレイアウトを試せます。
| 誰が | 何を作るか | ステップ削減が役立つ理由 |
|---|---|---|
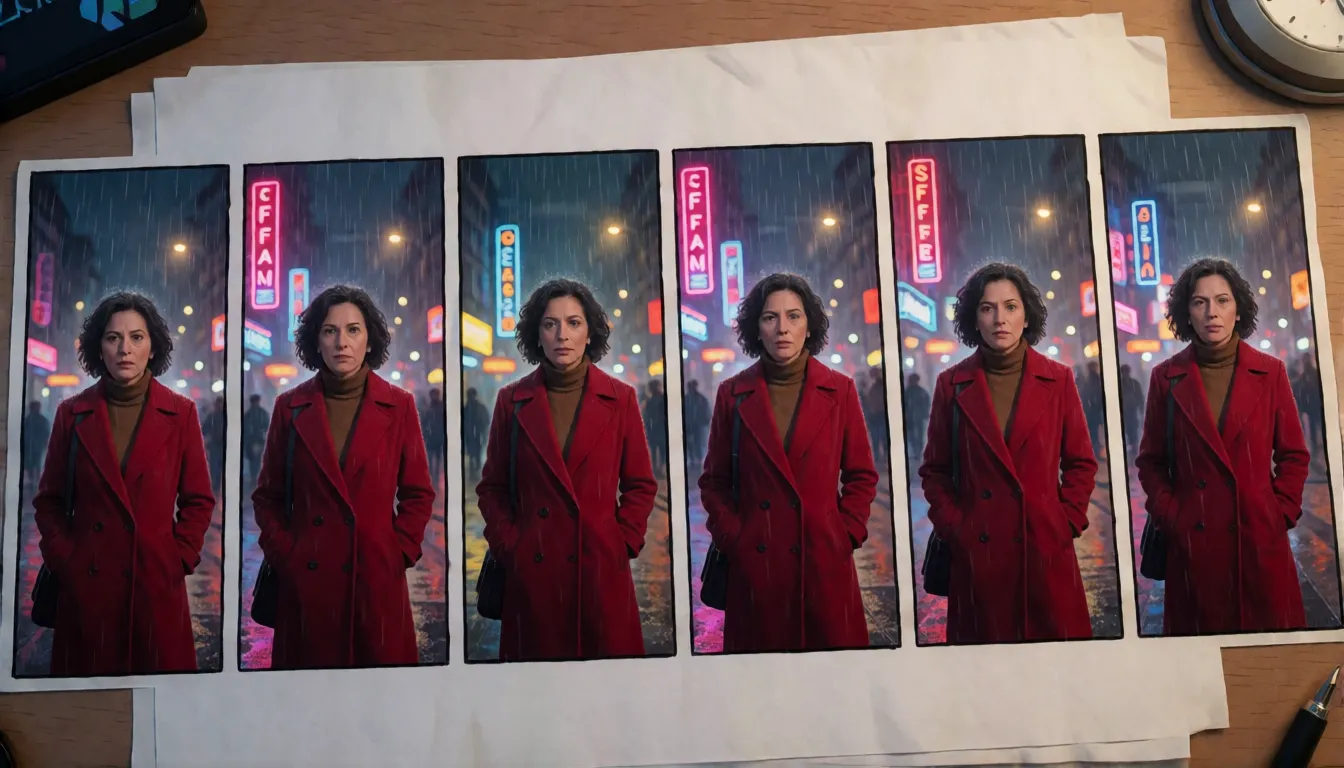
| ショートドラマやAIコミックのチーム | 同じキャラクターが登場する縦型絵コンテを数十コマ | 多くのアングルや雰囲気を試してから、良いものを仕上げられる |
| ネットショップの販売者 | 白背景の商品写真、背景の差し替え、カラーバリエーション、セール用ポスター | カタログ全体のバリエーションを一度に作れる |
| ファッション・試着系クリエイター | 最大3枚の参照画像から人物+衣装+ロケーションを合成 | 顔の一貫性を保ちながら素早くルックを切り替えられる |
| ComfyUI のいじり好き | プロンプト入力とプレビューを繰り返すセッション | 入力とほぼ同じ速さで変更を確認できる |
| 成人向け(18歳以上)クリエイター | 架空の成人または同意した成人のビキニ、水着、ランジェリーへの衣装差し替え | 6-steps アダプターなら衣装だけ変えて顔と体型を保てる |
コピペで使えるプロンプトテンプレート
これらのテンプレートはベースモデルで最も効果的な書き方に沿っています。まず被写体、次に舞台、光、レンズを書き、画像内に入れる文字は引用符で囲みます。6-steps アダプターではテンプレート全体を、upsampled アダプターでは短い1行で十分です。あくまで調整して使うための出発点であり、開発元のサンプルではありません。
- テキストから画像(フル版、6-steps):"[被写体]、[ポーズや動作]、[衣装の詳細]、[場所と時間帯]、[光:窓からの柔らかな光/ゴールデンアワーの逆光]、[レンズ:35mm 半身/ローアングル]、[スタイル:広告写真/アニメ]、上部にポスタータイトル "YOUR TITLE""
- 短いプロンプト(upsampled):"雨のネオン街に立つサイバーパンクのヒロイン、シネマティック"
- 衣装の差し替え(18歳以上、架空または同意した成人):"顔、髪型、ポーズ、背景はそのまま、トップスを赤いストリングビキニに置き換え、リアルな生地感、ライティングは元画像に合わせる"
- 背景の差し替え:"被写体とその輪郭は保ち、背景をモルディブのビーチに置き換え、自然な影を追加"
- 参照画像3枚の合成:"画像1の人物が画像2の衣装を着て、画像3の場所に立っている、全身、自然光"
- 絵コンテのコマ:"縦型 9:16、[画像1のキャラクター]、振り返って肩越しに後ろを見る、緊張感のある雰囲気、シネマティックなライティング、浅い被写界深度"
- 商品ポスター:"画像1の商品を大理石のカウンターに置く、左側に大きなタイトル "SUMMER DROP"、その下に小さく "今週20%オフ"、上質で柔らかな光"
書き方のコツ:短く曖昧なプロンプトは素のアダプターでは平板に見えがちなので、詳細を足すか upsampled 版に切り替えましょう。
P-Q-Image-2.1 の ComfyUI ワークフローと設定
PrunaAI は ComfyUI ですぐ使えるリポジトリ PrunaAI/P-Q-Image-2.1-Comfy を公開しており、BF16 の単一ファイル LoRA と、各バージョンのテキストから画像・編集用の6つのワークフローファイルが含まれています。お使いの ComfyUI が Qwen-Image-2.1 をネイティブにサポートしていればカスタムノードは不要で、アダプターは組み込みの LoraLoaderModelOnly ノードで強度1.0で読み込めます。
メモリについて:PrunaAI は一般向けGPUでの数値を公表していません。実用的な手段は int8 ベースと int8 テキストエンコーダーの組み合わせで、メモリ使用量を抑えられます。量子化と高速化アダプターは別々の課題に効くため、併用できます。
- ComfyUI を更新し、ベースの拡散モデル(BF16、またはメモリ節約用の int8 convrot 版)、qwen3vl_8b int8 テキストエンコーダー、VAE、LoRA をそれぞれ通常のフォルダに配置します。
- 対応する配布ワークフローをキャンバスにドラッグします。
- サンプラーは euler、CFG 1、ネガティブプロンプトは空、LoRA 強度1.0。
- v0.2 の ManualSigmas:1.0, 0.961054, 0.918949, 0.769302, 0.545554, 0.222292, 0。
- まずは1024×1024から始め、その後で大きなサイズを試しましょう。
| よくある間違い | 代わりにすべきこと |
|---|---|
| Turbo ベースを読み込む | Comfy-Org/Qwen-Image-2.1 の通常ベースを使う。PrunaAI は Turbo との組み合わせを避けるよう明言している |
| v0.1 と v0.2 のシグマを混ぜる | アダプターごとに専用のスケジュールがあるので、そのバージョンのワークフローからコピーする |
| Pruna のアダプターを2つ重ねる | 一度に1つだけ読み込む |
| いきなり2Kにする | アダプターの学習サイズである1Kから始める |
Diffusers で動かす
Python ユーザー向けに、モデルカードには Diffusers での手順が記載されています。Qwen/Qwen-Image-2.1 から QwenImage21Pipeline を読み込み、PrunaAI/P-Q-Image-2.1 リポジトリと使いたいアダプターファイルを指定して load_lora_weights を呼び出し、dynamic shifting を有効にした FlowMatch Euler スケジューラーを使います。num_inference_steps を6、true_cfg_scale を1にし、KV キャッシュを有効にしてください。編集する場合は image 引数で画像を渡します。Diffusers 版ではシフトなしのシグマ [1.0, 0.925, 0.85, 0.625, 0.375, 0.125] に dynamic shift を組み合わせます。カードでは特定の Diffusers コミットと transformers 5.17 以降が指定されているので、想定外の不具合を避けるためにバージョンを合わせましょう。
P-Q-Image-2.1 と Lightning、Turbo、int8 の比較
Qwen-Image-2.1 を高速化したい人は、たいてい3つの方法を比較します。コミュニティ製の Lightning LoRA はさらに少ない4ステップまで下げます。PrunaAI のアダプターは6ステップに加え、プロンプト拡張の内蔵と、開発元が用意した編集ワークフローで応えます。Turbo ベースは別の高速チェックポイントで、PrunaAI はこのアドオンと組み合わせないよう明言しています。int8 や GGUF の量子化はステップ数ではなくメモリを節約するもので、どちらの LoRA とも併用できます。同一条件で並べた信頼できる比較テストは存在しないため、最も公平なアドバイスは、自分のプロンプトで両方を試すことです。
| 方法 | ステップ数 | 得られるもの | 注意点 |
|---|---|---|---|
| PrunaAI v0.2 LoRA | 6 | プロンプト拡張の選択肢、忠実な編集、開発元提供の ComfyUI ワークフロー | 1Kで学習、Turbo ベースには非対応 |
| Lightning LoRA | 4 | 最少のステップ数 | プロンプト拡張は内蔵されていない |
| Turbo ベース | 少数 | LoRA なしで高速化 | Pruna のアダプターとは互換性がない |
| int8 / GGUF | 変わらない | メモリ使用量の削減 | 単体では何も速くならない |
コミュニティの反応
アップストリームのリポジトリは直近1か月で48万回以上のダウンロード、177件のいいね、9件のディスカッションスレッドを記録し、複数の Hugging Face Spaces で使われています。ComfyUI 用リポジトリも公開から数日で最初のいいねを集めました。ComfyUI Wiki は v0.1 のリリースを取り上げ、ドイツのサイト Mind-Verse も Qwen-Image-2.1 を高速化する手段としてこのリリースを紹介しました。開発元による ComfyUI 向けエクスポートが登場する前から、ユーザーは有志による変換版を共有しており、ローカル環境のクリエイターがいかに待ち望んでいたかが分かります。PrunaAI はトレードオフについて率直です。v0.1 の画像は40ステップのフルベースに及ばず、短いプロンプトや曖昧なプロンプトで最も影響が出やすく、出力がベースと完全には一致しない場合があり、ウェイトも最終版ではありません。その率直さこそが v0.2 が注目される理由でもあり、まさにそうした弱点を狙って改善されています。
無修正版の P-Q-Image-2.1 はある?
ありません。このアドオンが変えるのは速度だけで、NSFW 版は存在せず、ベースモデルが描ける内容を緩めることもありません。それはベースウェイトや一緒に読み込む他の LoRA によって決まります。「uncensored」とラベル付けされたコミュニティ版の Qwen-Image-2.1 は、元のウェイトそのものか、テキストエンコーダーを差し替えただけで目に見える変化がないものだと報告されており、Turbo ベースのものはそもそもこのアダプターと併用できません。水着やランジェリーのルックなど、ブラウザで手軽に制限なしの成人向け編集をしたいなら、Spicy AI が同様の無修正画像エディターを提供しています。
水着・ビキニへの差し替え
顔とポーズはそのままに、成人の衣装をビキニやワンピース水着に変更。
ビーチ・プールのセット
ポートレートを晴れたビーチや屋上のプールパーティーに移動。
レトロなピンナップポスター
水玉の水着、粒子感、大胆な見出しテキスト。
- 変えたい部分より先に、変えてはいけない部分を書きましょう。
- 光とレンズを指定しましょう:ゴールデンアワーの逆光、85mm ポートレート。
- 登場人物が全員成人(18歳以上)であることを明記しましょう。
成人の写真をアップロードするかシーンを説明して、ビキニ、ビーチ、ピンナップのルックをオンラインで試してみましょう。
画像エディターを開く →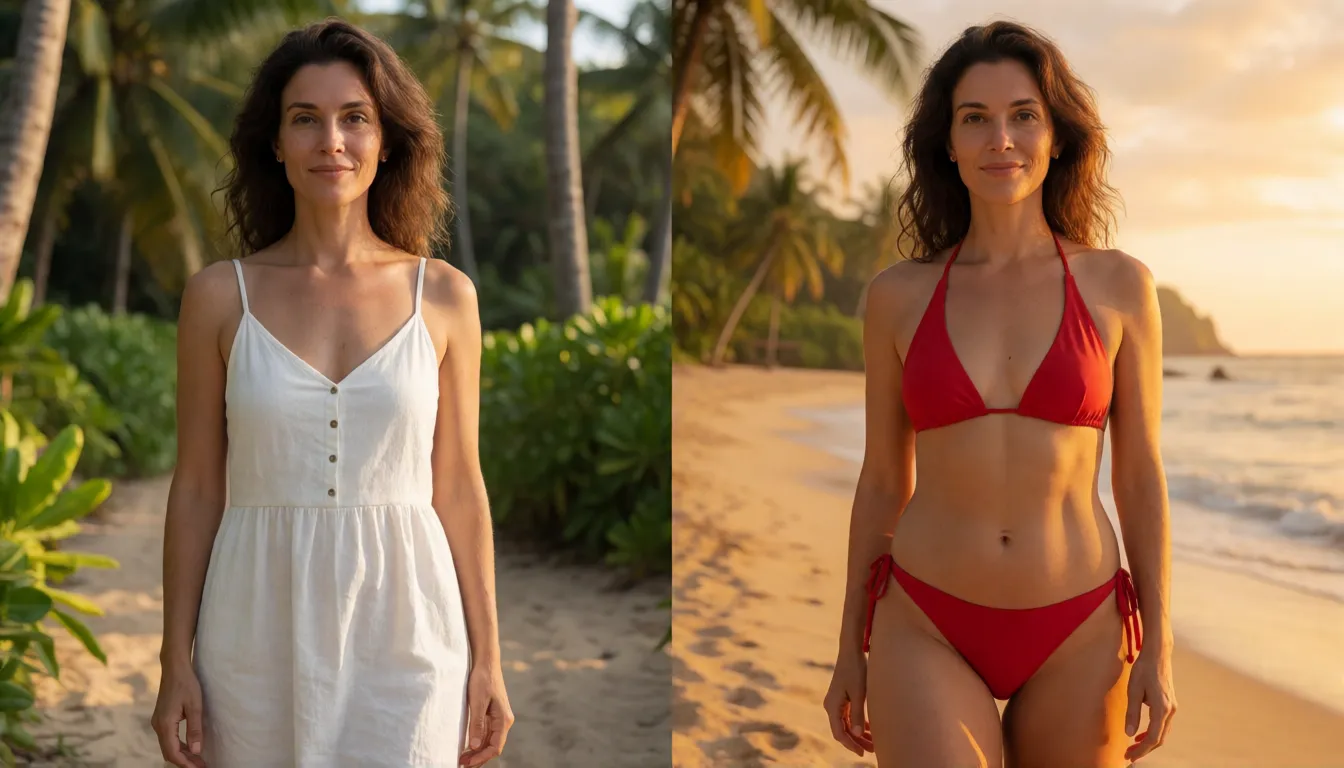
P-Q-Image-2.1 のセルフホストと Spicy AI でのオンライン生成の比較
| ローカル環境(配布ウェイト) | Spicy AI オンライン | |
|---|---|---|
| コンテンツフィルター | 読み込むベースモデルと同じ | コンテンツフィルターなし |
| オープンウェイト | あり | 不要 — ブラウザで動作 |
| モデル | Qwen-Image-2.1 と高速化アダプター | 同様の無修正画像エディターをオンラインで提供 |
| 始めるための費用 | 自前のGPU | 無料プランあり |
よくある質問
P-Q-Image-2.1 は単体のモデルですか?
いいえ。PrunaAI による少ステップ用の LoRA で、Qwen-Image-2.1 の上に読み込んで使います。ベースモデル、テキストエンコーダー、VAE は変わらないため、ベースウェイトが必要です。
v0.1 と v0.2 では何が変わりましたか?
v0.1 は5ステップと8ステップのアダプターを提供していました。v0.2 は6ステップに統一し、編集をより忠実に保つ 6-steps アダプターと、プロンプト拡張を内蔵した 6-steps-upsampled アダプターに分かれました。あわせて開発元提供の ComfyUI 用ファイルとワークフローも公開されています。
どのくらい速くなりますか?
PrunaAI によると、40ステップのベースと比べて最大約6.3倍で、H100 1基・BF16・バッチサイズ1で計測した数値です。一般向けグラフィックカードでの数値は公表されていません。
ComfyUI ではどの設定を使えばよいですか?
Qwen-Image-2.1 をネイティブにサポートする ComfyUI を使い、LoraLoaderModelOnly を強度1.0、euler、CFG 1、ネガティブプロンプトなし、そしてお使いのアダプターに対応する ManualSigmas を設定してください。ベースは Turbo ではなく通常版を使います。
複数の参照画像で編集できますか?
はい。学習には最大3枚の参照画像を使った編集が含まれています。それ以上の参照画像や2K出力も動作する可能性はありますが、学習範囲外です。
以前は Pruna-Qage-2.1 という名前でしたか?
はい。v0.1 リリースは PrunaAI/Pruna-Qage-2.1 として公開されました。現在は PrunaAI の Hugging Face アカウントで新しい名前のもとに置かれており、ComfyUI 用ファイルは別のリポジトリにあります。
これと Lightning の4ステップ LoRA、どちらを選ぶべきですか?
Lightning のほうがステップ数は少なくなります。PrunaAI の v0.2 はプロンプト拡張の選択肢と、開発元提供の編集ワークフローを備えています。同一条件で行われた信頼できる比較はないため、自分のプロンプトで両方を試してください。
Spicy AI は PrunaAI や Qwen チームと提携していますか?
いいえ。Spicy AI は独立したプラットフォームであり、いずれとも提携しておらず、承認も受けていません。すべての商標はそれぞれの所有者に帰属します。
無料ですか?
毎日の生成枠で無料で始められ、もっと必要になったらクレジットを購入できます。
出典
- PrunaAI/P-Q-Image-2.1 モデルカード(Hugging Face)
- PrunaAI/P-Q-Image-2.1-Comfy のファイルとワークフロー(Hugging Face)
- v0.1 リポジトリ PrunaAI/Pruna-Qage-2.1(Hugging Face)
- Qwen-Image-2.1 ベースモデル(Hugging Face)
- Comfy-Org の Qwen-Image-2.1 ファイル(Hugging Face)
- v0.1 リリースの報道(ComfyUI Wiki)
- リリースの報道(Mind-Verse、ドイツ語)
- pruna オープンソースツールキット(GitHub)