Image IA non censurée · Workflow ComfyUI
MOSS PiD SuperFast HighRes non censuré : d'une esquisse rapide à une image 4K nette
Envie d'images IA immenses et nettes sans attendre une éternité à chaque essai ? MOSS PiD SuperFast HighRes est un workflow ComfyUI communautaire et gratuit, partagé sur Hugging Face par lvladikov le 30 octobre 2026. Il dessine un petit aperçu avec MOSS-Image en seulement 4 étapes, puis laisse PiD de NVIDIA repeindre cet aperçu en une image quatre fois plus large et quatre fois plus haute, par exemple 2816×1536 ou même 4096×2304. Un seul flux, pas d'upscaler à part, et des résultats prêts à servir de fond d'écran.
- Jusqu'à 4096×2304
- 4 + 4 étapes
- Poids ouverts
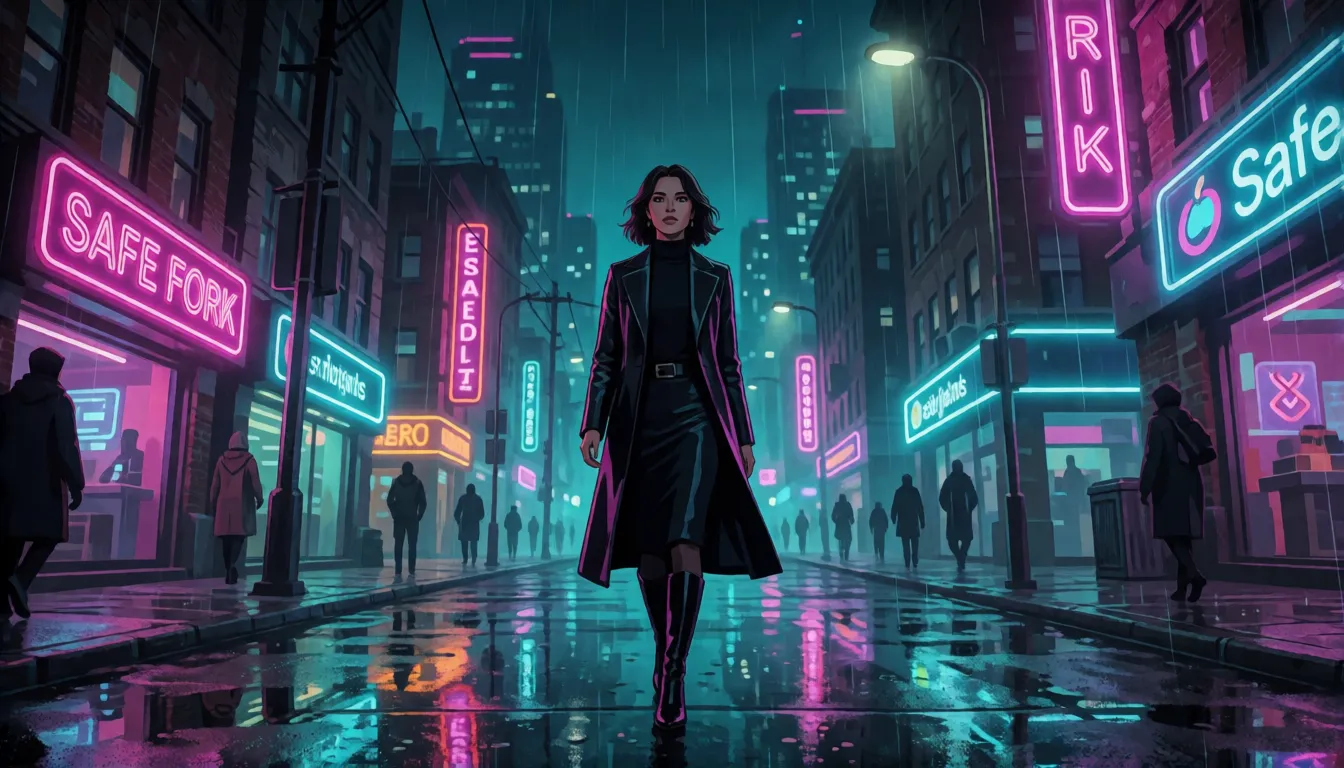
Générateur d'images alternatif non censuré
Texte vers imageDécrivez toute la scène : sujet, lieu, lumière et style. Ajoutez une photo de référence pour la modifier, ou laissez vide pour du texte vers image.
Un petit brouillon en entrée, une grande image en sortie
Voyez MOSS PiD SuperFast HighRes comme une équipe de deux artistes. Le premier, MOSS-Image SFT de l'équipe OpenMOSS, esquisse toute la scène en petit format, 704×384 par défaut, avec une LoRA 4 étapes signée akhaliq pour aller vite. Le second, PiD de NVIDIA (pixel diffusion decoder, version 1.5), reprend cette esquisse et la repeint à quatre fois la largeur et la hauteur en 4 étapes de plus. Il lit votre prompt pendant qu'il travaille, donc il ajoute de vrais détails au lieu de simplement étirer les pixels. Ce workflow n'est pas un nouveau modèle : c'est une recette toute prête qui enchaîne des modèles ouverts existants, avec un script Python et 100 images d'exemple à parcourir pour trouver des idées.
Pourquoi c'est si rapide
Tout se joue sur l'endroit où se fait le gros du travail. Le grand modèle d'image ne dessine qu'à un quart de la largeur et de la hauteur finales, il ne traite donc qu'un seizième des pixels : environ 1 056 tokens d'image au lieu de 16 896 pour une image en taille réelle. La peinture en pleine taille est confiée à PiD, plus petit, qui ne tourne lui aussi qu'en 4 étapes. Sur la RTX 5090 (32GB) de l'auteur, MOSS PiD SuperFast HighRes a été chronométré avec l'offloading activé : une image prenait environ 75 secondes chargement des modèles compris, dont 25,8 secondes pour l'étape MOSS et seulement 1,8 seconde pour l'étape PiD. Tester dix idées prend donc bien moins de temps que rendre dix images en pleine taille.
| Petit brouillon | Image finale | Idéal pour |
|---|---|---|
| 704×384 (par défaut) | 2816×1536 | Fonds d'écran larges, bannières |
| 768×432 | 3072×1728 | Écrans 16:9, miniatures vidéo |
| 1024×576 | 4096×2304 | Fonds d'écran 4K, impressions |
| 512×512 | 2048×2048 | Avatars, posts carrés, cartes |
Fonds d'écran 4K, affiches et couvertures créés avec
La haute résolution compte surtout quand une image sera vue en grand. Comme la sortie arrive directement entre 2K et 4K, les résultats haute résolution de MOSS-Image sont prêts pour les endroits où les petites images IA paraissent floues ou pixellisées. L'auteur a testé le flux avec 100 prompts, 50 portraits et 50 sujets au hasard, et a publié tous les résultats : un tableau d'idées bien pratique avant d'écrire vos propres prompts.
- Fonds d'écran cinématographiques : rues néon, ruelles cyberpunk et couchers de soleil en montagne en 16:9 pour ordinateur ou TV.
- Portraits en gros plan : portraits éditoriaux et photos de mode, idéalement avec le raffineur de peau activé.
- Affiches et couvertures : couvertures de mini-séries et de romans en ligne, affiches d'événements et miniatures YouTube, aidées par le bon lettrage de MOSS-Image.
- Images carrées 2048×2048 : photos de profil, cartes imprimées et posts sur les réseaux.
- Séances d'idées en série : lancez plein de petits brouillons, gardez les meilleures compositions, profitez des grandes versions.
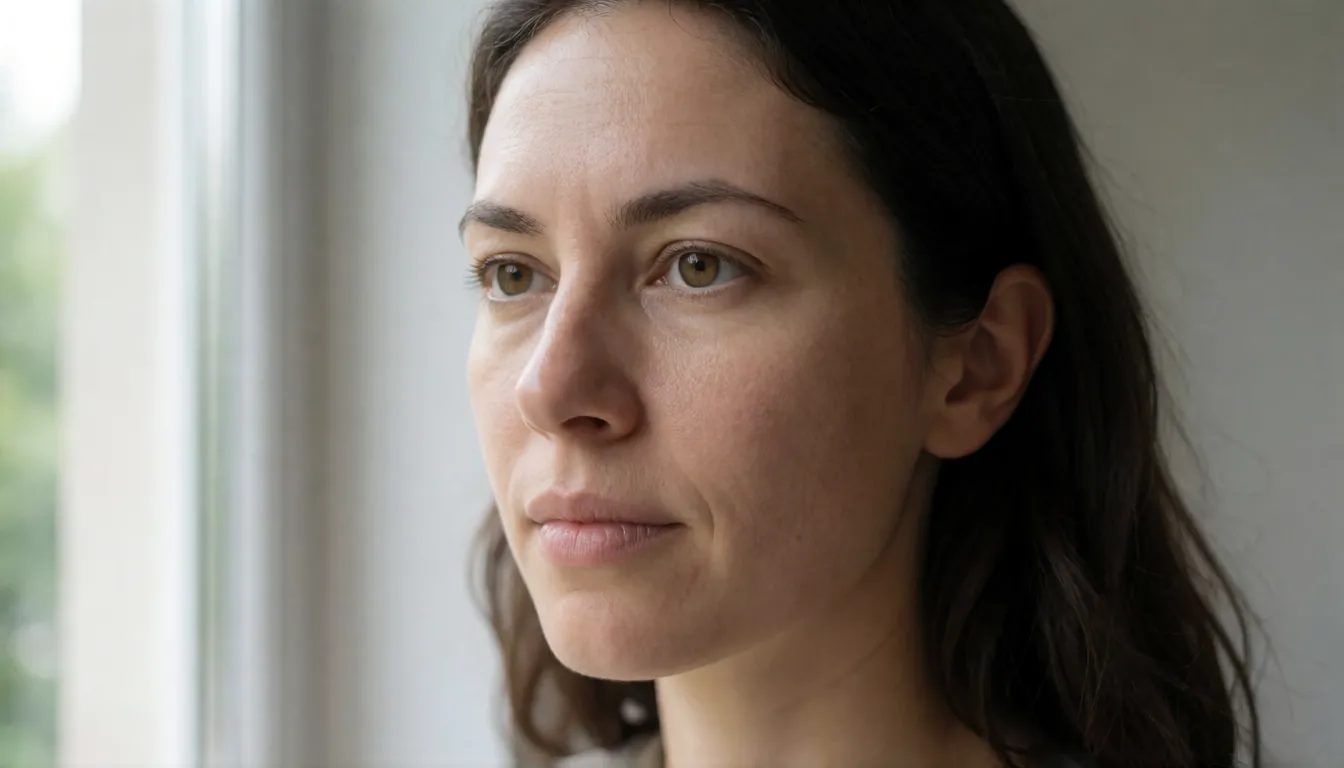
NVIDIA PiD face au décodage VAE et aux upscalers ESRGAN
D'habitude, un modèle d'image transmet son résultat à un décodeur VAE, qui en fait une image de même taille, puis on ajoute un upscaler comme ESRGAN pour l'agrandir. PiD réunit les deux tâches : il décode directement les données internes du modèle en une image haute résolution, guidé par votre prompt. Les chercheurs de NVIDIA le décrivent dans leur article et sur leur page de projet, et la version 1.5, sortie en juillet 2026, a amélioré la fidélité des couleurs, supprimé les marques de grille dans les coins et affiné les détails des visages et de l'anime. Le revers : un décodeur génératif peut inventer de petits détails absents du brouillon, alors qu'un upscaler classique se contente surtout d'affiner ce qui existe déjà.
| Décodage VAE + upscaler | Décodeur PiD 4× | |
|---|---|---|
| Étapes après le dessin | Décodage, puis une passe d'agrandissement à part | Une seule passe de 4 étapes |
| Utilise votre prompt | En général non | Oui, ajoute des détails fidèles au prompt |
| Rendu typique | Fidèle mais parfois flou | Plus de détails, la peau peut paraître trop lisse |
| Conseil de version | N'importe quel modèle d'upscaler | Utilisez PiD v1.5 ; la v1 peut laisser des motifs de grille colorés |
Retrouver une vraie texture de peau avec une passe de raffinage
L'auteur le dit franchement : PiD est rapide mais a tendance à lisser la peau jusqu'à lui donner un aspect cireux. C'est pourquoi le workflow existe en versions avec une troisième étape facultative. Celle qui est recommandée utilise Qwen-Image-2.1 avec une LoRA Lightning en 2 étapes et un léger denoise de 0,3, ce qui remet pores et ridules tout en gardant le visage reconnaissable. L'alternative, Krea 2 Turbo avec une LoRA 3 étapes à un denoise de 0,12, ajoute encore plus de texture mais peut vieillir les personnes. Dans les tests de l'auteur sur trois portraits, dépasser environ 0,4 de denoise commençait à modifier le visage lui-même : restez en douceur.
- Qwen-Image-2.1 Lightning, 2 étapes, denoise 0,3 : pores naturels, même visage.
- Krea 2 Turbo, 3 étapes, denoise 0,12 : texture la plus marquée, peut vieillir le sujet.
- Au-delà d'environ 0,4 de denoise : le visage commence à dériver, restez plus bas pour les portraits.
Modèles de prompts pour scènes larges, portraits et affiches
MOSS-Image préfère des descriptions de scène complètes à de courtes listes de tags, et le même prompt est envoyé aux deux étapes, donc PiD sait quels détails peindre. Un bon ordre : sujet, décor, lumière, matières et style. Pas besoin de prompt négatif, car le flux tourne à CFG 1. Remplacez les mots entre crochets et gardez le reste :
- Paysage large : "A wide cinematic photograph of [lieu] at [moment de la journée], [météo et lumière], [détail au premier plan] in the foreground, [paysage lointain], shot on a 35mm lens, rich color grading, ultra detailed textures."
- Portrait (avec raffineur) : "A close-up portrait of an adult [tranche d'âge] [description de la personne], soft window light from the left, natural skin texture with visible pores, shallow depth of field, [tenue], neutral background, editorial photography."
- Affiche : "A vertical movie poster for a [genre] short drama titled \"[titre]\", [personnage principal], dramatic rim lighting, bold title typography at the top, cinematic composition." Réglez le brouillon sur 384×704 pour obtenir un format vertical de 1536×2816.
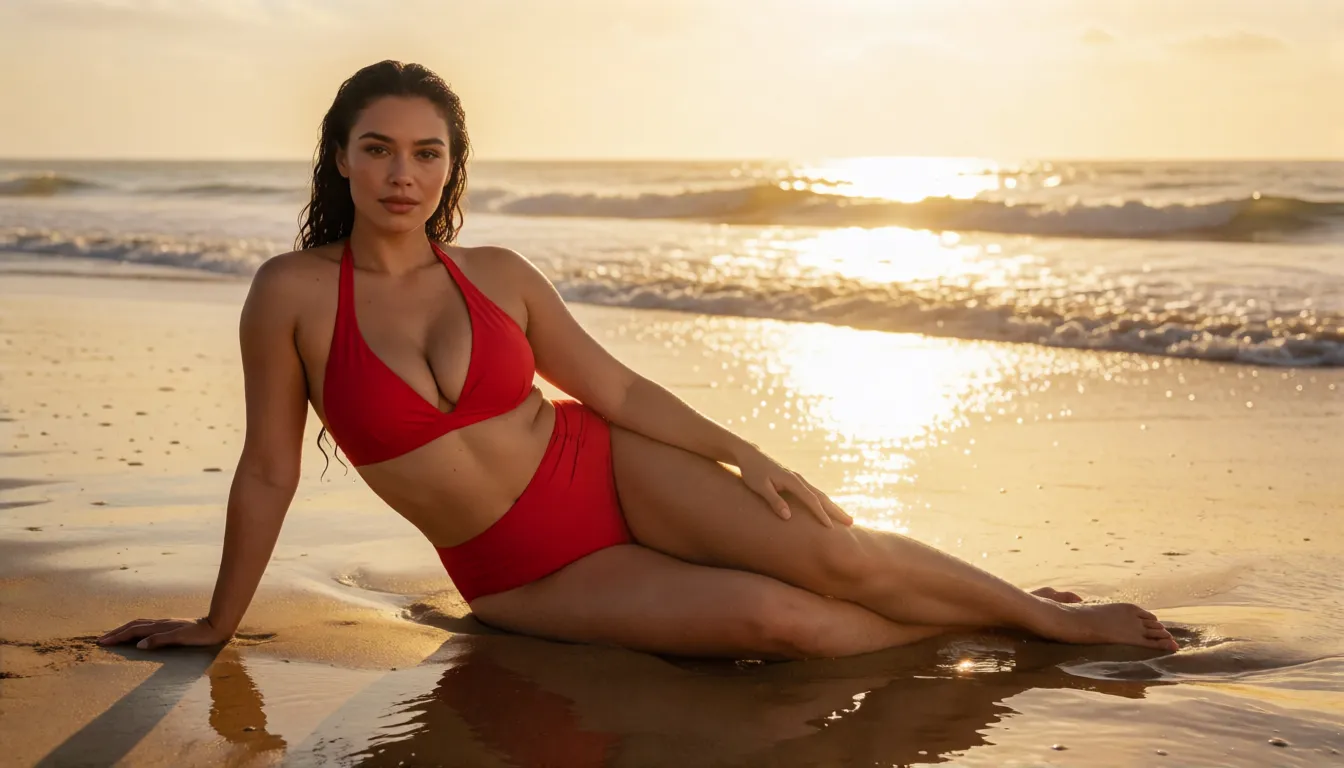
- Glamour (18+, adultes fictifs) : "A glamorous beach photoshoot of a fictional adult model in a [couleur] bikini, golden hour backlight, wet sand reflections, high-end swimwear catalog style, 4K detail."
Workflow ComfyUI, Comfy Cloud et VRAM nécessaire
Lancer MOSS PiD SuperFast HighRes est simple. Si vous utilisez déjà ComfyUI, mettez-le à jour vers une version compatible avec MOSS-Image et PiD, glissez le fichier du workflow sur le canevas, réglez la taille dans le groupe "0 · Size", tapez votre idée dans "1 · Prompt" et cliquez sur Run. Tout repose sur des nœuds de base, donc aucun pack personnalisé à chercher. Sans carte graphique puissante, la version Comfy Cloud ne demande d'importer que deux fichiers, la LoRA 4 étapes et PiD, et l'auteur a mesuré environ 0,83 crédit par image, ou environ 1,7 avec le raffineur Qwen. Gardez en tête ces limites pratiques :
- Les fichiers de modèles sont lourds : les poids complets bf16 de MOSS-Image font 10,2GB et l'encodeur de texte 19,3GB ; des versions int8 plus légères existent.
- Avec le raffineur, garder tous les modèles chargés en même temps demande environ 72GB de mémoire ; les versions récentes de ComfyUI libèrent la mémoire automatiquement.
- Gardez le grand côté du brouillon à 512px ou plus ; un brouillon 256×256 agrandi en 1024 paraît flou.
- Le script Python exige une carte NVIDIA CUDA ; sur Mac, utilisez le workflow ComfyUI.
MOSS-Image 4K non censuré et art NSFW haute résolution
MOSS-Image est publié avec des poids ouverts sous licence Apache-2.0 : quand vous le faites tourner sur votre propre machine, aucune modération en ligne ne s'interpose entre vous et l'image, et PiD n'a pas non plus de filtre de contenu annoncé. Il n'existe toutefois aucune édition spéciale non censurée de MOSS PiD SuperFast HighRes, et les résultats pour adultes dépendent toujours de LoRA communautaires chargées dans la première étape, ce que l'auteur n'a pas testé. Les créateurs adultes utilisent surtout la grande sortie pour des séances glamour où le détail se voit vraiment : tissus, gouttes d'eau, lumière dorée sur la peau. Assurez-vous que tout le monde soit clairement adulte et fictif, ou utilisez des personnes qui ont donné leur consentement.
Affiches maillots de bain
Photos de plage et de piscine à l'heure dorée avec des modèles adultes, assez nettes pour un tirage mural.
Portraits glamour
Portraits rapprochés style boudoir, avec le raffineur qui ajoute une texture de peau naturelle.
Fonds d'écran fantasy
Héroïnes et sorcières adultes dans de larges scènes 4K pour fonds d'écran.
- Choisissez d'abord la pose en taille brouillon, puis ne passez du temps que sur celle que vous gardez.
- Ajoutez le raffineur avec un denoise faible pour les portraits afin que les visages restent identiques.
- Précisez que toutes les personnes représentées sont adultes (18+), et ne représentez jamais de vraies personnes sans leur consentement.
Des images haute résolution rapides sur Spicy AI
Vous pouvez reprendre la même habitude en ligne sans rien installer : brouillon en petit, choix du meilleur, puis passage en grand. Sur Spicy AI, vous décrivez une scène, générez des versions rapides jusqu'à ce que la pose et le cadrage vous plaisent, puis agrandissez votre préférée et, pour les portraits, ajoutez une légère retouche pour que la peau reste réaliste. Le générateur d'images offre une création non censurée similaire, donc les idées de maillots de bain, lingerie et affiches glamour fonctionnent aussi. Petit bonus sympa : utilisez votre image nette comme première image d'un court clip dans l'outil image vers vidéo.
Esquissez, choisissez et agrandissez votre prochaine image dans le navigateur, sans GPU.
Ouvrir le générateur d'images →Ce qu'en disent les premiers utilisateurs
C'est encore un projet de niche, très jeune. Trois semaines après sa sortie, la page Hugging Face affichait 63 téléchargements et 13 likes, donc pas encore de grands avis de la communauté. L'avis le plus clair sur MOSS PiD SuperFast HighRes vient de l'auteur : le flux est très rapide, PiD lisse trop la peau sans le raffineur, et les brouillons trop petits donnent des images floues. La page de comparaison de NVIDIA pour PiD v1.5 est le meilleur endroit pour voir côte à côte des exemples de couleurs, de visages et de détails anime.
Héberger le workflow soi-même ou générer en ligne sur Spicy AI
| Déploiement local (poids officiels) | Spicy AI en ligne | |
|---|---|---|
| Filtres de contenu | Aucun en local | Aucun filtre de contenu |
| Poids ouverts | Oui | Inutile — tourne dans le navigateur |
| Modèle | MOSS-Image SFT + PiD v1.5, raffineur en option | Modèle d'image non censuré similaire, hébergé en ligne |
| Coût de départ | Votre propre GPU ou des crédits Comfy Cloud | Offre gratuite disponible |
FAQ
Est-ce un nouveau modèle d'IA ?
Non. C'est un workflow ComfyUI communautaire de lvladikov, sorti le 30 octobre 2026, qui enchaîne MOSS-Image SFT avec une LoRA 4 étapes et le décodeur PiD de NVIDIA.
Quelle taille peuvent atteindre les images ?
La sortie fait quatre fois la largeur et la hauteur du brouillon : 2816×1536 par défaut et 4096×2304 à partir d'un brouillon 1024×576. PiD v1.5 a été entraîné pour des sorties entre 2048 et 4096 pixels.
Pourquoi est-ce plus rapide que de dessiner directement en 4K ?
Le grand modèle ne traite qu'un seizième des pixels, et le petit PiD peint la pleine taille en 4 étapes. L'auteur a mesuré environ 1,8 seconde pour PiD et environ 75 secondes par image sur une RTX 5090, chargement compris.
Pourquoi la peau paraît-elle trop lisse ?
PiD a tendance à lisser la peau. Utilisez la version avec raffineur : Qwen-Image-2.1 Lightning en 2 étapes à un denoise de 0,3 ramène les pores sans changer le visage.
Puis-je l'utiliser pour des projets clients payants ?
MOSS-Image, la LoRA 4 étapes et le workflow sont sous Apache-2.0, mais PiD est sous licence non commerciale de NVIDIA : prévoyez un autre décodeur ou upscaler pour les travaux commerciaux.
Puis-je le faire tourner sans grosse carte graphique ?
Oui, via la version Comfy Cloud ou les fichiers de modèles int8 plus légers. Le script Python exige une carte NVIDIA CUDA, alors que le workflow ComfyUI fonctionne aussi sur Mac.
Spicy AI est-il affilié à OpenMOSS, NVIDIA ou à l'auteur du workflow ?
Non. Spicy AI est une plateforme indépendante, ni affiliée à OpenMOSS, NVIDIA ou lvladikov, ni approuvée par eux. Les noms de modèles sont des marques de leurs propriétaires respectifs.
Sources
- Workflow MOSS-PiD-SuperFast-HighRes et README (Hugging Face)
- 100 images d'exemple et leurs prompts
- Fiche du modèle NVIDIA PiD (Hugging Face)
- Article PiD (arXiv 2605.23902)
- Page du projet PiD (NVIDIA Research)
- Page de comparaison PiD v1.5
- Fiche du modèle MOSS-Image SFT (OpenMOSS)
- LoRA 4 étapes pour MOSS-Image SFT (akhaliq)
- LoRA Lightning pour Qwen-Image-2.1
- LoRA 3 étapes Krea 2 Turbo