Image IA sans censure · OpenMOSS
MOSS-Image sans censure : des poids ouverts qui placent le texte exactement où vous voulez
MOSS-Image est un modèle texte-vers-image d'environ 5B de paramètres signé par l'équipe OpenMOSS, publié avec des poids ouverts le 16 octobre 2026. Son atout majeur : un texte vraiment lisible. Titres en chinois et en anglais, notes manuscrites et étiquettes s'intègrent dans l'image, et un mode de mise en page JSON permet d'ancrer chaque titre, produit ou logo à des coordonnées précises. Comme les poids tournent sur votre propre GPU sans filtre en ligne, les checkpoints téléchargeables sont le MOSS-Image sans censure dont parlent les créateurs qui travaillent en local.
- Gratuit pour commencer
- Sans filtres
- Dans le navigateur
Générateur d'images alternatif à MOSS-Image sans censure
Texte vers imageDécrivez l'image souhaitée, avec les mots entre guillemets. Ajoutez une photo de référence pour la modifier, ou laissez vide pour du texte-vers-image.
Essayer un prompt
Les prompts d'exemple sont en anglais, ce qui donne les résultats les plus fiables.
Pourquoi designers et commerçants s'y intéressent
Voyez ce modèle comme un générateur d'images ouvert qui traite enfin les mots comme une partie de l'image. Tapez un titre, un prix ou un mot manuscrit entre guillemets, et il apparaît lisible dans l'image, en anglais ou en chinois, exactement là où la mise en page l'indique. Cette seule compétence transforme un jouet amusant en outil de travail pour les boutiques, les studios et les équipes réseaux sociaux. Les poids se téléchargent gratuitement et tournent sur votre propre GPU : aucun coût par image et aucun filtre en ligne entre votre prompt et le résultat.
Du texte lisible en chinois et en anglais dans l'image
La plupart des modèles d'image ouverts brouillent encore les lettres, et les caractères chinois en souffrent le plus. Ce modèle a été entraîné à rendre les deux langues, et les exemples officiels en tirent parti : un mot sur le frigo écrit à la main en chinois avec une liste de courses (lait, œufs, pain), des tableaux blancs couverts de notes, des enseignes de boutiques et des titres d'affiches. L'astuce est simple. Mettez les mots exacts entre guillemets et précisez où ils se placent et à quoi ils ressemblent, par exemple "a bold red headline reading \"SUMMER SALE\" across the top". Les phrases courtes sortent plus proprement que les paragraphes, et dans les comparaisons officielles, le checkpoint SFT regroupe et aligne le texte plus soigneusement que Base.
- Mettez entre guillemets chaque mot à imprimer, dans la langue voulue.
- Décrivez le support : post-it, enseigne néon, tableau noir, couverture de magazine.
- Précisez le style des lettres : manuscrit, sans-serif gras, calligraphie au pinceau.
- Gardez chaque bloc de texte court ; découpez les longs textes en plusieurs éléments étiquetés.
Là où il excelle : affiches, bannières de boutique et infographies
Puisque les mots et leur placement sont ses points forts, le modèle convient aux tâches où une jolie image ne suffit pas. Les e-commerçants maquettent des bannières produit avec un badge de prix dans un coin, les community managers préparent des couvertures aux titres bilingues, et les créateurs de mini-séries et de webcomics esquissent affiches et cases avec les dialogues déjà en place. Enseignants et marketeurs s'en servent pour des explications au tableau blanc et des infographies, les restaurants pour leurs menus et ardoises, et les équipes de marque pour des séries de mises en page identiques où seul le titre change.
| Scène | Ce que vous demandez | Pourquoi ça marche |
|---|---|---|
| Bannière de boutique | Produit au centre, titre en haut, badge dans un coin | Les boîtes JSON gardent chaque élément là où vous l'avez prévu |
| Couverture bilingue pour les réseaux | Titre en chinois et sous-titre en anglais | Les deux écritures restent lisibles |
| Affiche de série ou de BD | Personnages, accroche et bulles de dialogue | Les longs prompts gèrent beaucoup de détails à la fois |
| Explication au tableau blanc | Étapes manuscrites et dessins simples | Les styles manuscrits ont l'air naturels |
| Menu ou ardoise | Noms de plats et prix en lignes | Les lignes de texte courtes restent nettes |
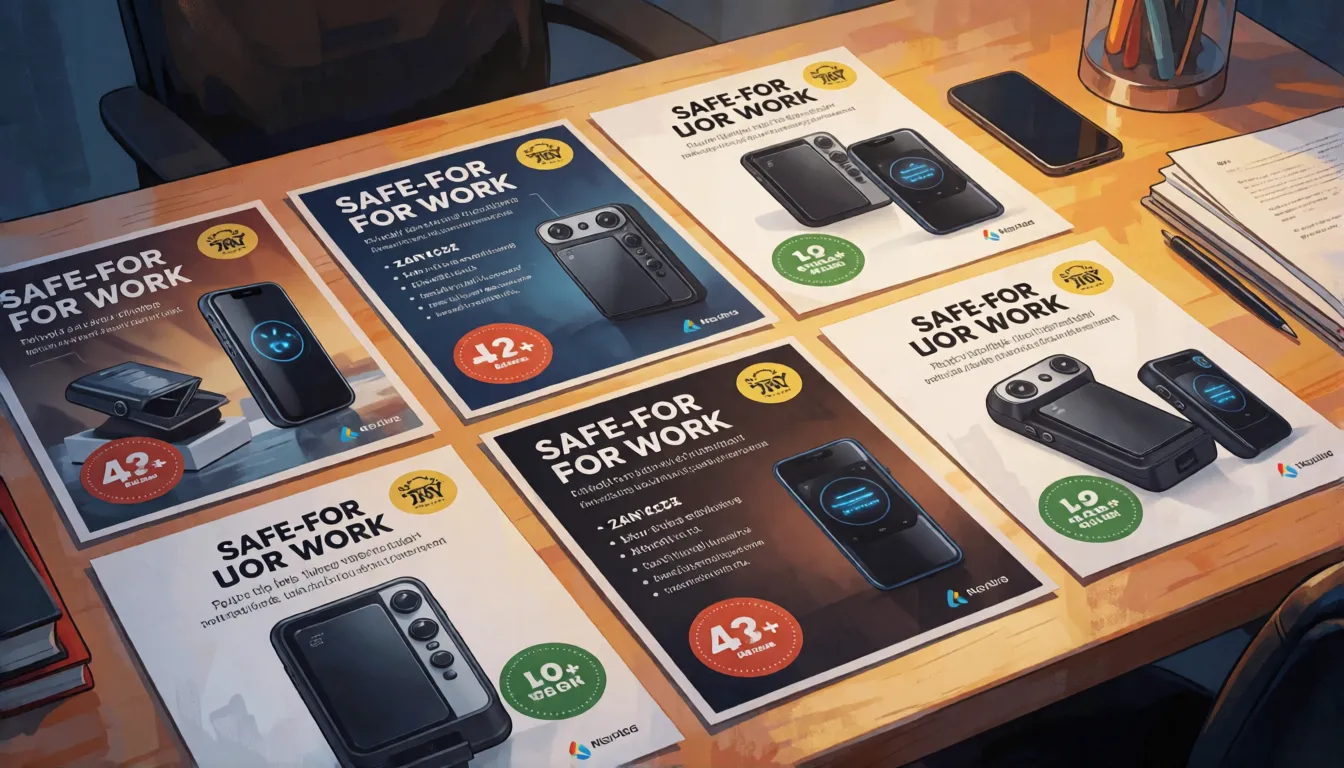
En faire un business : bannières, menus et tests publicitaires
Ceux qui en tirent le plus sont les petites équipes qui ont besoin de beaucoup de visuels riches en texte, vite. Une boutique en ligne peut préparer en un après-midi les bannières promo d'une semaine, chacune avec le produit au centre, la remise dans une pastille et le titre en deux langues. Les agences réutilisent la même mise en page JSON pour produire des dizaines de variantes d'annonces qui ne changent que le slogan, ce qui rend les tests A/B bon marché. Cafés et restaurants maquettent menus et ardoises, les imprimeurs proposent des affiches personnalisées, et les studios de webtoons et de mini-séries ébauchent des couvertures avec le titre déjà placé avant qu'un graphiste ne finalise.
| Qui | Ce qu'ils produisent | Pourquoi c'est rentable |
|---|---|---|
| Boutique en ligne | Bannières promo hebdomadaires et étiquettes de prix | Mise en page fixe, seul le texte change |
| Agence | De nombreuses variantes de slogan pour tests A/B | Même JSON, nouveau texte en quelques secondes |
| Restaurant ou café | Menus, ardoises, affiches de vitrine | Les lignes courtes restent nettes |
| Studio de BD ou de séries | Ébauches de couverture avec titre et accroche | Économise des allers-retours de mise en page |
| Graphiste freelance | Maquettes client avant la version finale | Premiers jets plus rapides |
Ce que dit la communauté et ce que les gens créent
Sur Civitai, où les créateurs partagent images et modèles, les premiers commentaires sont plutôt enthousiastes. Un utilisateur l'a décrit comme l'un des modèles ouverts les plus riches en connaissances pour les images réalistes et a salué sa maîtrise de l'anime comme du style photo. D'autres ont relevé des faiblesses : mains et membres parfois ratés, tags de style au nom d'artistes presque sans effet, et réglages par défaut lents ; un utilisateur a parlé de plus de 100 secondes par image jusqu'à ce qu'une LoRA turbo communautaire divise ce temps par dix environ, avec une peau un peu plus lisse. Dix jours après la sortie, le dépôt GitHub comptait environ 1,9 k étoiles et la page du modèle Base 556 likes. Que publient les gens ? De fausses affiches de voyage rétro, des couvertures de magazine bilingues, des mots manuscrits sur le frigo et des tableaux blancs, des mèmes avec la légende intégrée, des fiches de personnages d'anime avec leur nom et des shootings de plage glamour avec des modèles adultes.
- Affiches rétro de voyage et de films aux grands titres lisibles
- Couvertures bilingues chinois-anglais pour magazines et réseaux
- Mots manuscrits, tickets et blagues de tableau blanc pour les mèmes
- Fiches de personnages d'anime avec noms et statistiques imprimés
- Shootings maillot et pin-up de modèles adultes avec lettrage de magazine
Exemples de prompts MOSS-Image à copier
Le modèle comprend trois styles de prompt, chacun adapté à un objectif. Les phrases naturelles conviennent le mieux aux photos et aux affiches, les listes de tags sont familières aux habitués de l'anime et des LoRA communautaires, et le JSON sert aux mises en page strictes. Partez de ces modèles, gardez la seed fixe et changez un seul détail à la fois :
- Langage naturel : "A cozy kitchen at morning, a handwritten note on the fridge reading \"milk, eggs, bread\", warm sunlight, photorealistic."
- Affiche : "Retro travel poster of a seaside town, large title \"VISIT CAPRI\" at the top in cream serif letters, grainy print texture."
- Tags : "adult woman, beach, sunset, bikini, film grain, 35mm, golden hour" (personnages adultes uniquement).
- Infographie : "Clean whiteboard with three numbered steps titled \"How to brew coffee\", simple marker drawings, flat lighting."
- Couverture bilingue : "Magazine cover, Chinese headline in bold brush strokes, English subtitle \"Night Market Guide\" below, neon street at night."
Prompts de mise en page JSON : placez titres et produits par coordonnées
Le mode JSON est ce qui distingue ce modèle. Au lieu d'espérer que le titre tombe en haut, vous décrivez toute la scène dans un résumé, puis listez des éléments, chacun avec une étiquette, une description, une boîte englobante et un texte facultatif. Les boîtes suivent l'ordre yxyx (haut, gauche, bas, droite) en coordonnées pixel mesurées depuis le centre du canevas : sur une image de 1024 par 1024, chaque axe va donc de -512 à 512, et les valeurs doivent correspondre à la taille générée. OpenMOSS qualifie encore la mise en page d'expérimentale, attendez-vous donc à ajuster une ou deux boîtes. Un squelette de départ :
{
  "summary": { "caption": "Bright summer shop banner, white studio background" },
  "items": [
    { "label": "title", "caption": "bold red headline", "bbox": [-460, -400, -300, 400], "text": "SUMMER SALE" },
    { "label": "product", "caption": "glass bottle of iced lemon tea", "bbox": [-220, -200, 380, 200] },
    { "label": "badge", "caption": "yellow round sticker", "bbox": [260, 260, 460, 460], "text": "-50%" }
  ],
  "bbox_format": "yxyx",
  "bbox_coord_space": "abs_centralized"
}
Les noms de champs suivent le guide de mise en page du dépôt GitHub officiel ; la skill officielle Prompt Enhancer peut aussi développer une phrase en une description ou une mise en page détaillée.
MOSS-Image est-il sans censure ? LoRA NSFW et art adulte
En local, les poids ouverts n'ont aucun filtre en ligne : rien ne vérifie votre prompt ni l'image finale, c'est donc vous qui décidez de ce que le modèle dessine. OpenMOSS n'a pas publié de checkpoint NSFW et ne décrit pas comment ses données d'entraînement ont été filtrées ; les détails explicites dépendent donc d'extensions communautaires. Un rapport de seconde main d'AlphaSignal affirme qu'un "Moss-image-nsfw-uncensored-lora" avec le mot déclencheur moss_xvstyle est apparu en quelques jours et fonctionne avec Base et SFT ; il n'a pas été confirmé sur les pages Hugging Face ou Civitai, à prendre donc avec prudence. Les thèmes adultes populaires sont les éditoriaux maillot de bain et lingerie, les affiches pin-up et les couvertures de fantasy mettant en scène des personnages clairement adultes. Si vous préférez éviter la configuration GPU, Spicy AI propose une génération d'images sans censure similaire dans le navigateur.
Éditoriaux bikini et maillots de bain
Shootings ensoleillés à la plage et à la piscine avec des mannequins adultes et un titre de magazine en haut.
Affiches pin-up et boudoir
Pin-up adultes rétro et shootings lingerie avec l'accroche déjà en place.
Couvertures de fantasy
Héros et sorcières adultes pour couvertures de livres ou de jeux aux titres lisibles.
- Écrivez les mots voulus entre guillemets et indiquez où ils se placent.
- Utilisez des tags pour l'apparence des personnages et des phrases complètes pour la lumière et l'ambiance.
- Fixez la seed et changez un seul détail à chaque génération.
- Précisez que toutes les personnes représentées sont adultes (18+) et ne représentez jamais de vraies personnes sans leur consentement.
Créez des images pour adultes sans filtres, sans GPU ni téléchargement.
Ouvrir le générateur d'images →
SFT ou Base : quel checkpoint choisir
Les deux checkpoints partagent la même architecture de 5B, mais ils sont réglés pour des publics différents. SFT a reçu un fine-tuning supervisé sur des données sélectionnées, et les comparaisons officielles montrent un texte mieux regroupé et des mises en page plus propres : c'est celui à charger si vous voulez simplement de belles images. Base saute ce post-entraînement et reste plus proche du modèle brut, ce qui en fait le meilleur point de départ pour les LoRA et les fine-tunes complets.
| SFT | Base | |
|---|---|---|
| Idéal pour | Générer des images directement | Fine-tuning et entraînement de LoRA |
| Texte et mise en page | Regroupement plus propre dans les exemples officiels | Rendu plus libre et plus brut |
| Entraînement | Pris en charge par les deux outils | Point de départ recommandé |
Le faire tourner : Hugging Face, ComfyUI, diffusers et API
Il y a quatre portes d'entrée faciles. Le test le plus rapide est le Hugging Face Space gratuit d'OpenMOSS-Team. En local, ComfyUI prend en charge le modèle nativement dans les builds nightly actuelles, avec les fichiers reconditionnés de Comfy-Org et les loaders intégrés, tandis que le plugin du dépôt officiel reste utile pour charger des dossiers diffusers. Les développeurs peuvent charger les poids dans diffusers 0.38 ou plus récent avec le pipeline personnalisé pipeline_moss_image et trust_remote_code, sous Python 3.10+ et PyTorch 2.9+ avec un GPU NVIDIA. Les équipes qui préfèrent ne rien héberger peuvent l'appeler via la plateforme MOSI API.
- Échantillonnage par défaut : 50 étapes, CFG 3, shift 5, Euler en flow matching.
- La largeur et la hauteur doivent être des multiples de 16 ; les exemples officiels utilisent 1024x1024 et 1456x1456.
- La guidance effectue deux passes par étape, attendez-vous donc à plus de lenteur qu'avec les modèles distillés.
- Une version distillée DMD en 8 étapes, créée par la communauté, sacrifie un peu de qualité pour des brouillons bien plus rapides.
VRAM, vitesse et versions quantifiées
OpenMOSS ne publie pas de VRAM minimale. La démo Gradio propose plutôt trois modes mémoire : GPU resident garde tout sur la carte pour la vitesse, Component déplace des parties entre CPU et GPU, et Sequential est le mode basse mémoire, le plus lent. En cas d'erreurs de mémoire insuffisante, passez en Sequential, baissez la résolution ou essayez un fichier quantifié. Hugging Face recense 13 dérivés quantifiés du modèle Base, créés par la communauté ; consultez la model card de chacun pour connaître son format, comme GGUF ou FP8, et le loader requis, car la qualité et la compatibilité varient d'un fichier à l'autre.
Entraînez votre propre style avec KohakuMossTrainer
C'est avec le fine-tuning que les poids ouverts prennent tout leur sens. KohakuMossTrainer, publié deux jours après le lancement, gère le fine-tuning complet ainsi que les adaptateurs LyCORIS ou LoRA pour les deux checkpoints, et son README indique que les adaptateurs peuvent s'entraîner avec seulement 6GB de VRAM. DiffSynth-Studio prend aussi en charge le fine-tuning complet et les LoRA. En dix jours, Hugging Face comptait déjà 41 adaptateurs et 36 fine-tunes basés sur le modèle Base, des styles artistiques aux correctifs comme un LoRA DeBand communautaire qui lisse le banding des couleurs. Entraînez sur Base, rédigez les légendes dans le style que vous utiliserez en prompt et incluez le texte que le LoRA doit apprendre.
Comparaison avec FLUX.2, Qwen-Image et Z-Image
Aucun benchmark officiel ne compare encore ces modèles côte à côte : voyez ceci comme une comparaison pratique plutôt qu'un tableau de scores. Les différences nettes portent sur la taille, le contrôle de la mise en page et l'édition :
| MOSS-Image | FLUX.2 dev | Qwen-Image | Z-Image | |
|---|---|---|---|---|
| Taille | Environ 5B | 32B | 20B | 6B |
| Prompts de mise en page par coordonnées | Oui, boîtes JSON | Non | Non | Non |
| Retouche photo / références | Non | Oui | Modèles d'édition séparés | Modèle d'édition séparé |
| Écosystème actuel | Récent, en forte croissance | Vaste | Vaste | Vaste |
Les tailles proviennent des notes de version publiques de chaque modèle ; ce modèle n'a pas encore de benchmark quantitatif publié.
Héberger MOSS-Image soi-même ou générer en ligne sur Spicy AI
| Déploiement local (poids officiels) | Spicy AI en ligne | |
|---|---|---|
| Filtres de contenu | Aucun en local | Aucun filtre de contenu |
| Poids ouverts | Oui | Inutile — fonctionne dans le navigateur |
| Modèle | Checkpoint Base ou SFT | Modèle d'image sans censure similaire, hébergé en ligne |
| Coût de départ | Votre propre GPU | Offre gratuite disponible |
FAQ
Que crée-t-on le plus souvent avec ?
En tête viennent les affiches, bannières de boutique et couvertures pour les réseaux sociaux aux titres lisibles, suivies des mèmes avec légende intégrée, des schémas façon tableau blanc et des séances glamour de modèles adultes.
Peut-il retoucher des photos ou utiliser une image de référence ?
Pas encore. C'est uniquement un modèle texte-vers-image ; l'édition et les images de référence ne font pas partie de cette version.
Prend-il en charge le texte chinois ?
Oui. Il rend le chinois et l'anglais, et mettre les mots exacts entre guillemets donne le lettrage le plus fiable.
De combien de VRAM ai-je besoin ?
Aucun chiffre officiel n'est donné. La démo propose un mode Sequential basse mémoire, des fichiers quantifiés communautaires existent et les adaptateurs LoRA peuvent s'entraîner avec environ 6GB.
Comment l'utiliser dans ComfyUI ?
Passez à une build nightly récente, qui le prend en charge nativement, et chargez les fichiers reconditionnés de Comfy-Org avec les loaders intégrés.
Spicy AI est-il lié à OpenMOSS ?
Non. Spicy AI est une plateforme indépendante, ni affiliée à OpenMOSS ni approuvée par elle. Le nom du modèle est une marque de son propriétaire respectif.
Sources
- Model card du modèle Base (Hugging Face)
- Model card du modèle SFT (Hugging Face)
- Dépôt OpenMOSS et guide de mise en page (GitHub)
- Rapport technique (arXiv 2610.23374)
- Démo en ligne officielle (Hugging Face Space)
- Poids au format ComfyUI (Comfy-Org)
- Commentaires de la communauté (archive Civitai)
- Rapport sur un LoRA NSFW communautaire (AlphaSignal, non vérifié)