Génération rapide d'images IA · Module de vitesse
P-Q-Image-2.1 : images et retouches en seulement 6 étapes
Attendre quarante étapes d'échantillonnage pour chaque image gâche tout le plaisir d'expérimenter. P-Q-Image-2.1 règle ce problème. Publié par PrunaAI, l'équipe spécialisée dans la vitesse à l'origine de la boîte à outils open source pruna, c'est un petit module complémentaire pour Qwen-Image-2.1, le modèle à poids ouverts d'Alibaba, qui crée de nouvelles images et retouche des images existantes en six étapes seulement, sans prompt négatif à régler. PrunaAI annonce une génération jusqu'à environ 6,3× plus rapide que la base habituelle à 40 étapes.
- Gratuit pour commencer
- Brouillons rapides
- Fonctionne dans le navigateur
- Créé par
- PrunaAI
- Fonctionne avec
- Qwen-Image-2.1 (poids de base requis)
- Dernière version
- v0.2 : 6-steps et 6-steps-upsampled
- Fonctions
- Texte vers image et retouche avec jusqu'à 3 références
- Vitesse annoncée
- Jusqu'à ~6,3× par rapport à la base à 40 étapes
- Poids ouverts
- Oui, sur Hugging Face
Générateur d'images alternatif non censuré
Texte vers imageDécrivez l'image souhaitée, ou importez une photo et décrivez la retouche.
Un bouton turbo pour Qwen-Image-2.1
Voyez P-Q-Image-2.1 comme une puce de performance plutôt qu'un nouveau moteur. C'est une LoRA, un fichier léger qui se greffe sur Qwen-Image-2.1 et lui apprend à obtenir une image finie en beaucoup moins d'étapes. Le modèle de base, son encodeur de texte et son VAE restent strictement identiques : vous avez donc toujours besoin des poids d'origine, et vous conservez tout ce qui fait le succès de la base, à savoir un texte net dans les images, une sortie sur fond transparent et la retouche par instructions. Ce qui change, c'est l'attente. Vous réglez le CFG sur 1, vous vous passez du prompt négatif et vous obtenez un résultat en 5, 6 ou 8 étapes selon l'adaptateur. PrunaAI a mesuré son chiffre phare d'environ 6,3× maximum sur une seule H100 en BF16 avec un batch size de 1, par rapport à l'exécution habituelle en 40 étapes. Le projet a vu le jour sous le nom Pruna-Qage-2.1 en septembre 2026 avant d'adopter son nom actuel.
De la v0.1 à la v0.2 : un seul nombre d'étapes, deux adaptateurs plus malins
La première version, la v0.1, est sortie vers le 23 septembre 2026 avec le choix entre un adaptateur à 8 étapes, le réglage recommandé par défaut, et un adaptateur à 5 étapes plus rapide mais visiblement plus flou. La version 0.2 remplace ce compromis par un planning unique de 6 étapes poussé plus loin par distillation, puis le décline en deux variantes. L'adaptateur 6-steps simple respecte mieux la photo d'origine lors des retouches, si bien que visages, logos et détails de produit sont préservés. L'adaptateur 6-steps-upsampled intègre l'expanseur de prompts officiel : une idée de cinq mots revient sous forme de scène richement détaillée sans appel séparé à un modèle de langage. Cette même version a apporté le premier export officiel pour ComfyUI avec six workflows prêts à l'emploi ; à l'époque de la v0.1, les membres de la communauté devaient convertir les fichiers eux-mêmes.
| Adaptateur | Étapes | Point fort | Idéal pour |
|---|---|---|---|
| v0.1 8-steps | 8 | Meilleure qualité de la première version | Choix sûr sur les configurations anciennes |
| v0.1 5-steps | 5 | Option la plus rapide | Brouillons où la qualité peut baisser |
| v0.2 6-steps | 6 | Reste fidèle à l'image source lors des retouches | Changements de tenue, retouches produit, portraits |
| v0.2 6-steps-upsampled | 6 | Expansion de prompt intégrée | Prompts courts qui doivent paraître riches |
Upsampled ou 6-steps : choisir le bon adaptateur
Les deux fichiers de la v0.2 ont la même taille, la même force et le même sampler : le choix dépend donc de votre façon d'écrire. Si vous rédigez des prompts longs et précis, ou si vous retouchez une photo et que la personne ou le produit doit rester reconnaissable, chargez l'adaptateur 6-steps. Si vous préférez taper une idée rapide comme "héroïne cyberpunk dans une ruelle néon sous la pluie, cinématographique" et laisser le modèle inventer l'éclairage, l'objectif et le décor, l'adaptateur upsampled est le plus amusant. PrunaAI précise qu'il imite de près l'expanseur officiel, sans le reproduire parfaitement, si bien que les résultats peuvent différer de ceux obtenus en passant d'abord par un vrai modèle d'expansion de prompts.
- Retoucher un visage, un produit ou un détail de marque : 6-steps.
- Prompts courts et ludiques, mood boards : 6-steps-upsampled.
- Vitesse maximale, la qualité passant au second plan : v0.1 5-steps.
- Choix le plus prudent sur un workflow v0.1 existant : v0.1 8-steps.
- Ne chargez qu'un seul adaptateur à la fois et utilisez le planning de sigmas qui lui correspond.
L'entraînement a porté sur des images 1K et jusqu'à trois images de référence. Commencez en 1024×1024 ; une sortie 2K ou davantage de références peuvent fonctionner, mais sortent du cadre d'entraînement des adaptateurs.
Là où le rendu en six étapes est vraiment rentable
La vitesse compte surtout quand il vous faut beaucoup d'images, pas une seule. C'est pourquoi ce module a séduit les créateurs qui itèrent en volume. Passer de quarante à six étapes transforme un lot lent qui tournait toute la nuit en quelque chose que l'on peut regarder se dérouler, et rend les réglages en direct dans ComfyUI presque interactifs.
Côté adulte, les séries les plus populaires sont faciles à imaginer : une séance photo de vacances à la plage, un look de pool party ou une affiche pin-up rétro en maillot de bain, obtenus en retouchant une photo existante et en ne remplaçant que les vêtements. Comme le modèle de base rend bien les lettres, vendeurs et créateurs d'affiches s'en servent aussi pour les titres, tandis que la vitesse leur permet d'essayer plusieurs mises en page dans le temps qu'il fallait autrefois pour un seul rendu à 40 étapes.
| Qui | Ce qu'ils créent | Pourquoi moins d'étapes aide |
|---|---|---|
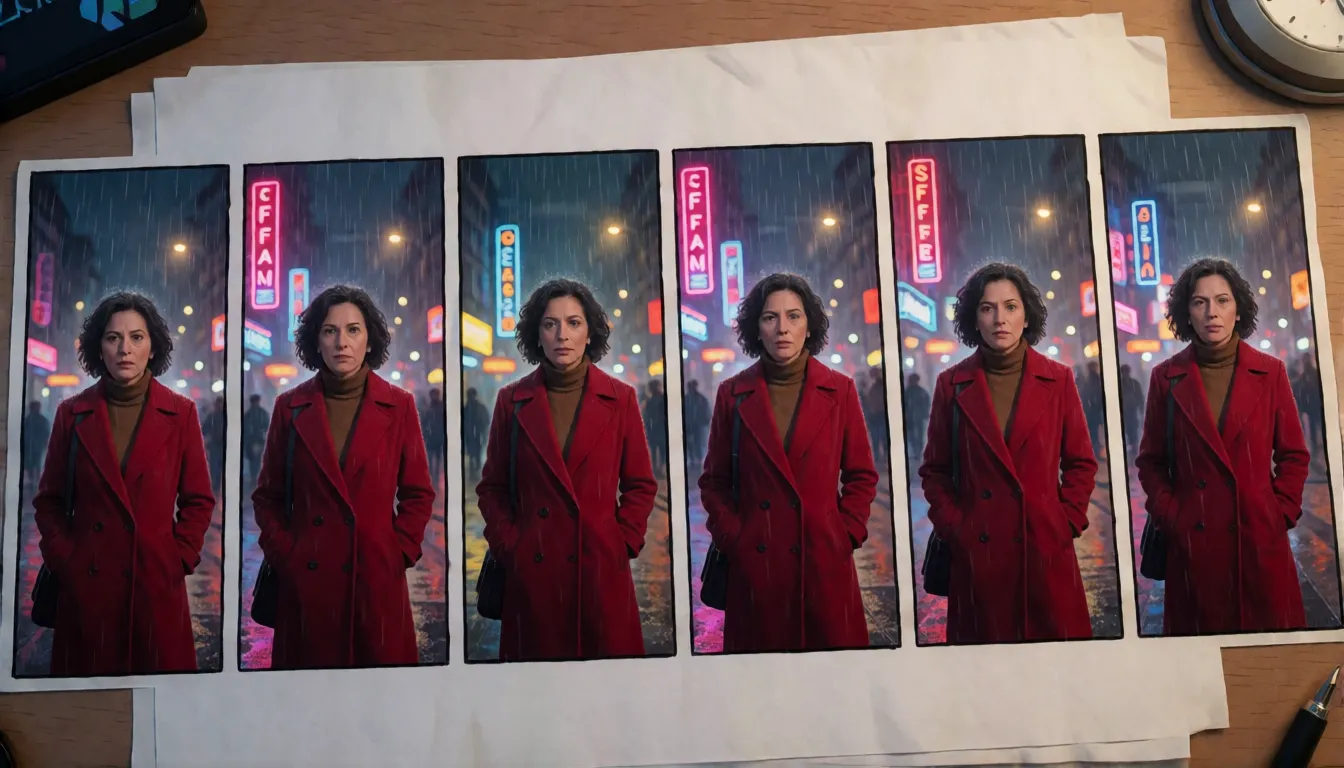
| Équipes de micro-séries et de BD IA | Des dizaines de cases de storyboard verticales avec un personnage récurrent | Tester de nombreux angles et ambiances avant de peaufiner les meilleurs |
| Vendeurs en ligne | Photos produit sur fond blanc, nouveaux arrière-plans, variantes de couleur, affiches promotionnelles | Produire tout un catalogue de variantes d'une traite |
| Créateurs mode et essayage virtuel | Personne + tenue + lieu fusionnés à partir de jusqu'à trois références | Changer de look rapidement en gardant un visage cohérent |
| Bidouilleurs ComfyUI | Sessions prompt et aperçu | Voir chaque modification presque aussi vite que vous tapez |
| Créateurs adultes (18+) | Changements de tenue en bikini, maillot de bain et lingerie de personnes adultes fictives ou consentantes | L'adaptateur 6-steps conserve le visage et la silhouette pendant que la tenue change |
Modèles de prompts à copier-coller
Ces modèles reprennent ce qui marche le mieux avec le modèle de base : décrivez d'abord le sujet, puis le décor, la lumière et l'objectif, et mettez entre guillemets tout texte devant apparaître sur l'image. Avec l'adaptateur 6-steps, utilisez le modèle complet ; avec l'adaptateur upsampled, une ligne courte suffit. Ce sont des points de départ à adapter, pas des exemples officiels.
- Texte vers image complet (6-steps) : "[sujet], [pose ou action], [détails de la tenue], [lieu et moment de la journée], [lumière : lumière douce de fenêtre / contre-jour à l'heure dorée], [objectif : 35mm plan taille / contre-plongée], [style : photo commerciale / anime], titre d'affiche "VOTRE TITRE" en haut"
- Prompt court (upsampled) : "héroïne cyberpunk dans une rue néon sous la pluie, cinématographique"
- Changement de tenue (18+, adulte fictif ou consentant) : "Garder le visage, la coiffure, la pose et l'arrière-plan inchangés, remplacer le haut par un bikini rouge à nouer, tissu réaliste, éclairage identique à l'original"
- Nouvel arrière-plan : "Garder le sujet et ses contours, remplacer l'arrière-plan par une plage des Maldives, ajouter une ombre naturelle"
- Fusion de trois références : "La personne de l'image 1 porte la tenue de l'image 2 et se tient dans la scène de l'image 3, en pied, lumière naturelle"
- Case de storyboard : "Vertical 9:16, [personnage de l'image 1], se retourne et regarde par-dessus son épaule, ambiance tendue, éclairage cinématographique, faible profondeur de champ"
- Affiche produit : "Produit de l'image 1 sur un comptoir en marbre, grand titre "SUMMER DROP" à gauche, petite ligne "-20 % cette semaine" en dessous, lumière douce haut de gamme"
Conseil de rédaction : les prompts courts et vagues donnent un rendu plus plat avec les adaptateurs simples, alors ajoutez des détails ou passez au fichier upsampled.
Workflow et réglages de P-Q-Image-2.1 dans ComfyUI
PrunaAI publie un dépôt prêt pour ComfyUI, PrunaAI/P-Q-Image-2.1-Comfy, avec des LoRAs BF16 en fichier unique et six fichiers de workflow : texte vers image et retouche pour chaque version. Aucun nœud personnalisé n'est nécessaire tant que votre version de ComfyUI prend en charge Qwen-Image-2.1 nativement ; l'adaptateur se charge via le nœud intégré LoraLoaderModelOnly avec une force de 1.0.
Mémoire : PrunaAI n'a pas publié de chiffres pour les GPU grand public. Le levier pratique est la base int8 associée à l'encodeur de texte int8, qui réduit l'utilisation de la mémoire ; la quantification et l'adaptateur de vitesse s'attaquent à des problèmes différents et peuvent être combinés.
- Mettez ComfyUI à jour, puis placez le modèle de diffusion de base (BF16, ou la version int8 convrot pour économiser de la mémoire), l'encodeur de texte qwen3vl_8b int8, le VAE et la LoRA dans leurs dossiers habituels.
- Glissez le workflow officiel correspondant sur le canevas.
- Sampler euler, CFG 1, prompt négatif vide, force de la LoRA 1.0.
- ManualSigmas de la v0.2 : 1.0, 0.961054, 0.918949, 0.769302, 0.545554, 0.222292, 0.
- Commencez en 1024×1024 et n'essayez des tailles plus grandes qu'ensuite.
| Erreur fréquente | Que faire à la place |
|---|---|
| Charger la base Turbo | Utilisez la base standard de Comfy-Org/Qwen-Image-2.1 ; PrunaAI déconseille de l'associer à Turbo |
| Mélanger les sigmas v0.1 et v0.2 | Chaque adaptateur a son propre planning ; copiez-le depuis le workflow de cette version |
| Empiler deux adaptateurs Pruna | N'en chargez qu'un à la fois |
| Passer directement en 2K | Commencez en 1K, la taille sur laquelle les adaptateurs ont été entraînés |
L'utiliser avec Diffusers
Pour les utilisateurs de Python, la fiche du modèle décrit une méthode avec Diffusers : chargez QwenImage21Pipeline depuis Qwen/Qwen-Image-2.1, appelez load_lora_weights avec le dépôt PrunaAI/P-Q-Image-2.1 et le fichier d'adaptateur souhaité, et utilisez un scheduler FlowMatch Euler avec dynamic shifting. Réglez num_inference_steps sur 6, true_cfg_scale sur 1 et activez le KV cache ; pour la retouche, passez vos images via l'argument image. La version Diffusers utilise des sigmas non décalés [1.0, 0.925, 0.85, 0.625, 0.375, 0.125] plus un dynamic shift. La fiche impose un commit précis de Diffusers et transformers 5.17 ou plus récent : alignez-vous sur ces versions pour éviter les surprises.
P-Q-Image-2.1 face à Lightning, Turbo et int8
Ceux qui accélèrent Qwen-Image-2.1 comparent généralement trois voies. La LoRA Lightning de la communauté descend encore plus bas, à 4 étapes. L'adaptateur de PrunaAI répond avec 6 étapes, un expanseur de prompts intégré et des workflows officiels de retouche. La base Turbo est un checkpoint rapide distinct, et PrunaAI déconseille explicitement de la combiner avec ce module. La quantification int8 ou GGUF économise de la mémoire et non des étapes : elle se combine donc avec l'une ou l'autre LoRA. Il n'existe aucun test officiel côte à côte dans des conditions identiques ; le conseil le plus honnête est donc de passer vos propres prompts dans les deux.
| Voie | Étapes | Ce que vous y gagnez | Points d'attention |
|---|---|---|---|
| LoRA PrunaAI v0.2 | 6 | Option d'expansion de prompt, retouches fidèles, workflows officiels pour ComfyUI | Entraînée en 1K ; incompatible avec la base Turbo |
| LoRA Lightning | 4 | Le moins d'étapes | Pas d'expansion de prompt intégrée |
| Base Turbo | Peu | Vitesse sans LoRA | Incompatible avec les adaptateurs Pruna |
| Int8 / GGUF | Inchangé | Moins de mémoire | N'accélère rien à elle seule |
Ce qu'en dit la communauté
Le dépôt d'origine affichait plus de 480 000 téléchargements le mois dernier, 177 likes, neuf fils de discussion et une utilisation dans plusieurs Hugging Face Spaces, tandis que le dépôt pour ComfyUI a récolté ses premiers likes en quelques jours. ComfyUI Wiki a couvert le lancement de la v0.1, et le site allemand Mind-Verse a présenté cette version comme un moyen d'accélérer Qwen-Image-2.1. Avant même l'export officiel pour ComfyUI, des utilisateurs avaient déjà partagé des conversions non officielles, signe de l'enthousiasme des créateurs en local. PrunaAI est franc sur les compromis : les images de la v0.1 restent en deçà de la base complète à 40 étapes, les prompts courts ou vagues en pâtissent le plus, les résultats peuvent ne pas correspondre exactement à la base et les poids ne sont pas définitifs. Cette transparence explique aussi l'attention portée à la v0.2, qui cible précisément ces points faibles.
Existe-t-il un P-Q-Image-2.1 non censuré ?
Non. Le module ne change que la vitesse ; il n'a pas d'édition NSFW et n'assouplit pas ce que le modèle de base accepte de dessiner, ce qui dépend des poids de base et des autres LoRAs que vous chargez. Les publications communautaires étiquetées Qwen-Image-2.1 "non censuré" se sont révélées être soit les poids d'origine, soit un simple encodeur de texte remplacé sans changement visible, et celle basée sur Turbo ne peut de toute façon pas être utilisée avec cet adaptateur. Pour des retouches adultes rapides et sans restriction, comme des looks maillot de bain ou lingerie dans le navigateur, Spicy AI propose un éditeur d'images non censuré similaire.
Changements en maillot et bikini
Remplacez la tenue d'un adulte par un bikini ou un maillot une pièce, en gardant le visage et la pose.
Décors plage et piscine
Transportez un portrait sur une plage ensoleillée ou à une pool party sur un toit.
Affiches pin-up rétro
Maillots à pois, grain et titres percutants.
- Indiquez ce qui doit rester identique avant ce qui doit changer.
- Précisez la lumière et l'objectif : contre-jour à l'heure dorée, portrait au 85mm.
- Précisez que toutes les personnes sont adultes (18+).
Importez la photo d'un adulte ou décrivez une scène, et essayez en ligne un look bikini, plage ou pin-up.
Ouvrir l'éditeur d'images →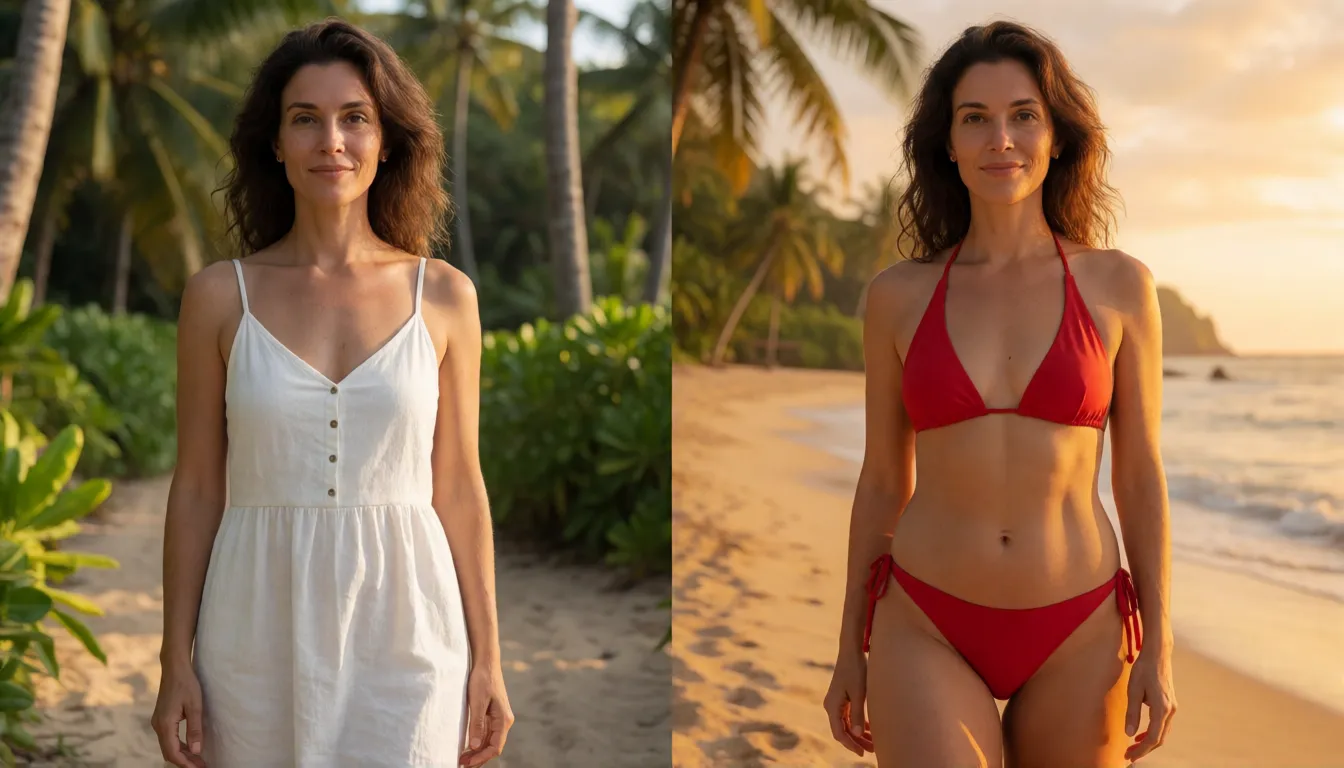
Héberger P-Q-Image-2.1 soi-même ou générer en ligne sur Spicy AI
| Déploiement local (poids officiels) | Spicy AI en ligne | |
|---|---|---|
| Filtres de contenu | Identiques à ceux du modèle de base chargé | Aucun filtre de contenu |
| Poids ouverts | Oui | Inutile — fonctionne dans le navigateur |
| Modèle | Qwen-Image-2.1 plus l'adaptateur de vitesse | Éditeur d'images non censuré similaire, hébergé en ligne |
| Coût de départ | Votre propre GPU | Offre gratuite disponible |
FAQ
P-Q-Image-2.1 est-il un modèle autonome ?
Non. C'est une LoRA en quelques étapes de PrunaAI qui se charge par-dessus Qwen-Image-2.1. Le modèle de base, l'encodeur de texte et le VAE restent inchangés : vous avez donc besoin des poids de base.
Qu'est-ce qui a changé entre la v0.1 et la v0.2 ?
La v0.1 proposait des adaptateurs à 5 et 8 étapes. La v0.2 se fixe sur 6 étapes et se décline en un adaptateur 6-steps qui préserve mieux les retouches et un adaptateur 6-steps-upsampled avec expansion de prompt intégrée, accompagnés de fichiers et workflows officiels pour ComfyUI.
À quel point est-il plus rapide ?
PrunaAI annonce jusqu'à environ 6,3× par rapport à la base à 40 étapes, mesuré sur une H100 en BF16 avec un batch size de 1. Aucun chiffre n'a été publié pour les cartes graphiques grand public.
Quels réglages ComfyUI utiliser ?
Utilisez une version de ComfyUI qui prend en charge Qwen-Image-2.1 nativement, LoraLoaderModelOnly avec une force de 1.0, euler, CFG 1, sans prompt négatif et les ManualSigmas propres à votre adaptateur. Utilisez la base standard, pas Turbo.
Peut-il retoucher des images avec plusieurs références ?
Oui. L'entraînement a couvert la retouche avec jusqu'à trois images de référence. Davantage de références ou une sortie 2K peuvent fonctionner, mais sortent du cadre d'entraînement.
S'appelait-il Pruna-Qage-2.1 auparavant ?
Oui. La version v0.1 a été publiée sous le nom PrunaAI/Pruna-Qage-2.1 ; elle se trouve aujourd'hui sous un nouveau nom sur le compte Hugging Face de PrunaAI, avec un dépôt séparé pour les fichiers ComfyUI.
Faut-il le choisir plutôt que la LoRA Lightning en 4 étapes ?
Lightning utilise moins d'étapes. La v0.2 de PrunaAI ajoute une option d'expansion de prompt et des workflows officiels de retouche. Il n'existe aucune comparaison officielle dans les mêmes conditions : testez les deux avec vos propres prompts.
Spicy AI est-il affilié à PrunaAI ou à l'équipe Qwen ?
Non. Spicy AI est une plateforme indépendante, ni affiliée ni approuvée par l'un ou l'autre. Toutes les marques appartiennent à leurs propriétaires respectifs.
Est-ce gratuit ?
Vous pouvez commencer gratuitement avec des générations quotidiennes, puis acheter des crédits quand il vous en faut davantage.
Sources
- Fiche du modèle PrunaAI/P-Q-Image-2.1 (Hugging Face)
- Fichiers et workflows PrunaAI/P-Q-Image-2.1-Comfy (Hugging Face)
- Dépôt de la v0.1, PrunaAI/Pruna-Qage-2.1 (Hugging Face)
- Modèle de base Qwen-Image-2.1 (Hugging Face)
- Fichiers Qwen-Image-2.1 de Comfy-Org (Hugging Face)
- Couverture du lancement de la v0.1 (ComfyUI Wiki)
- Couverture de la sortie (Mind-Verse, en allemand)
- Boîte à outils open source pruna (GitHub)