語音轉影片 · 開放權重
無審查 Kandinsky S2V 1.0 Pro:讓任何照片開口說話、比手勢、唱歌
Kandinsky S2V 1.0 Pro 只需要三樣簡單的東西:一張照片、一段某人說話的錄音,以及一小段場景描述,就能產出一支影片,讓照片中的人物對嘴說話、擺動雙手與肩膀,並從頭到尾維持同一個人的樣貌。它出自打造 Kandinsky 5.0 與 6.0 的 Kandinsky Lab,權重可免費下載。本指南介紹創作者把它用在哪些地方、結果為何看起來自然、哪個版本適合你的 GPU、可直接複製的提示詞,以及它與其他開源說話頭像模型的比較。
- 照片 + 語音 → 影片
- 全身動作,不只是臉
- 25 fps,長度不限
- 16 步快速版
無審查替代影片生成器
圖片轉影片和 Kandinsky S2V 1.0 Pro 一樣,從一張人像開始:上傳照片,描述人物該怎麼動、場景長什麼樣子,我們就會開啟已填好所有內容的圖片轉影片工作室。只要畫面中所有人都已年滿 18 歲,也歡迎成人主題。
一張照片、一段語音,就是一整場表演
大多數讓照片說話的工具只會動臉:嘴巴一開一合,畫面其他部分卻一動也不動。Kandinsky S2V 1.0 Pro 不一樣。給它一張參考圖片、一段乾淨的語音錄音(16 kHz 單聲道)和一段文字提示詞,它就能生成 25 fps 的影片,讓整個人活起來。嘴唇跟著每個音節動,雙手做出人們解說時常見的手勢,背景也照你的提示詞呈現。輸出會保留照片的長寬比並附上原始音軌,可以直接發布。
長度也不是固定的。Kandinsky S2V 1.0 Pro 以 125 影格、每段五秒的區塊運作,每個新區塊都從上一個結束處接續,因此兩分鐘的旁白就會變成同一個人的兩分鐘影片。大家最先注意到的是對嘴效果:每一格影格只聆聽屬於自己的那一小段音訊,所以嘴型會準確落在對應的聲音上,不會慢半拍。
單張照片說話影片正在爆紅的領域
語音驅動頭像已經從技術展示走進日常內容製作,Kandinsky S2V 1.0 Pro 正好適用。以下是研究資料與創作者社群最常提到的用途,它們都有同一個需求:不必租攝影棚或找主持人,就能讓一個逼真的人物在畫面中一字不差地說出你的音訊內容。
- 短劇與動態漫畫:為每個角色肖像配上對白音軌,就能得到像真正場景、而不像貼圖的全身對話鏡頭。
- 商品與直播電商短片:一張模特兒照片加一段商品介紹錄音,幾分鐘就能變成主持人風格的解說影片。
- 課程、新聞摘要與培訓:把旁白稿變成一堂長課,由虛擬老師持續比手勢講上好幾分鐘。
- 虛擬主播與 AI 伴侶:把角色圖片搭配文字轉語音的聲音,角色就能在鏡頭前回應你。
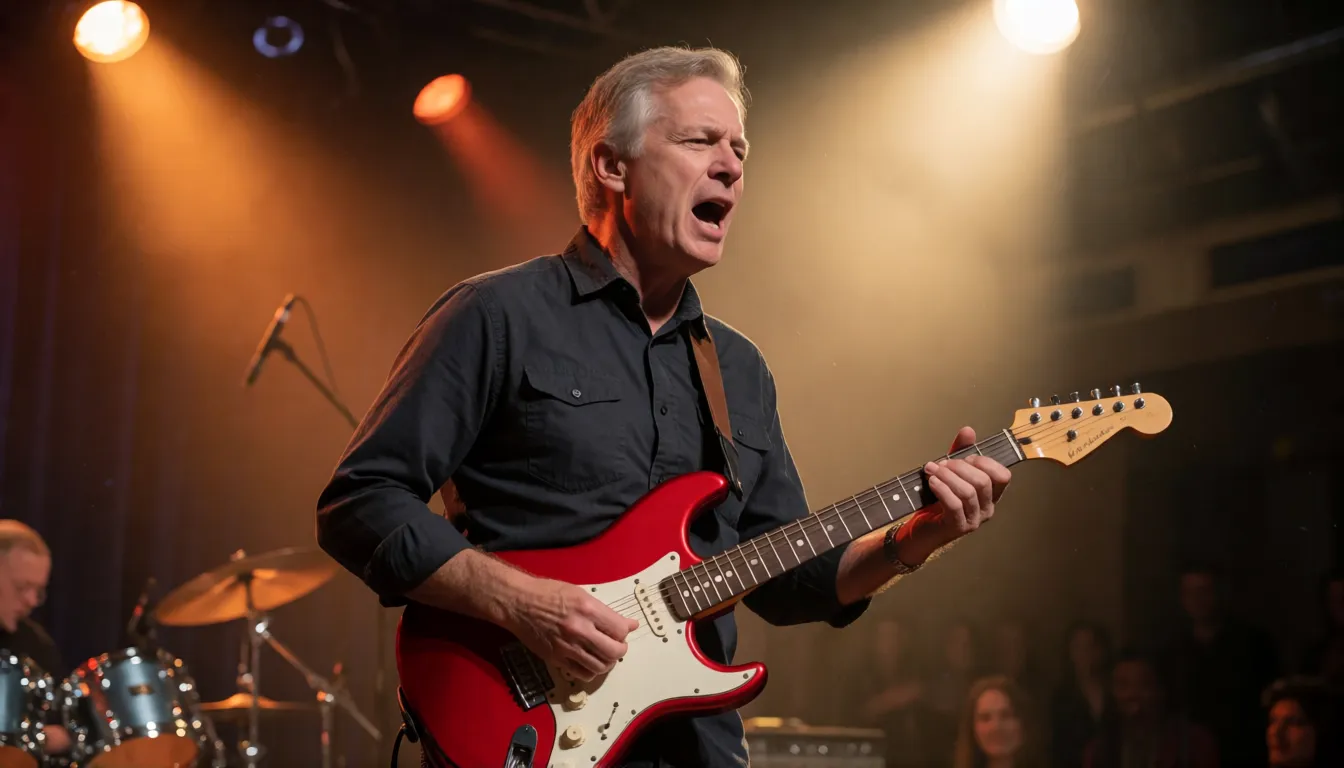
- 音樂與 Podcast:官方 Diffusers 範例是一位彈紅色電吉他的灰髮男子,暗示表演短片也做得到(團隊尚未對歌唱品質做基準測試)。
- 多語配音:保留同一張照片,換上不同語言的語音軌即可;訓練字幕為英文和俄文,大型專案前請先測試其他語言。
短劇對白
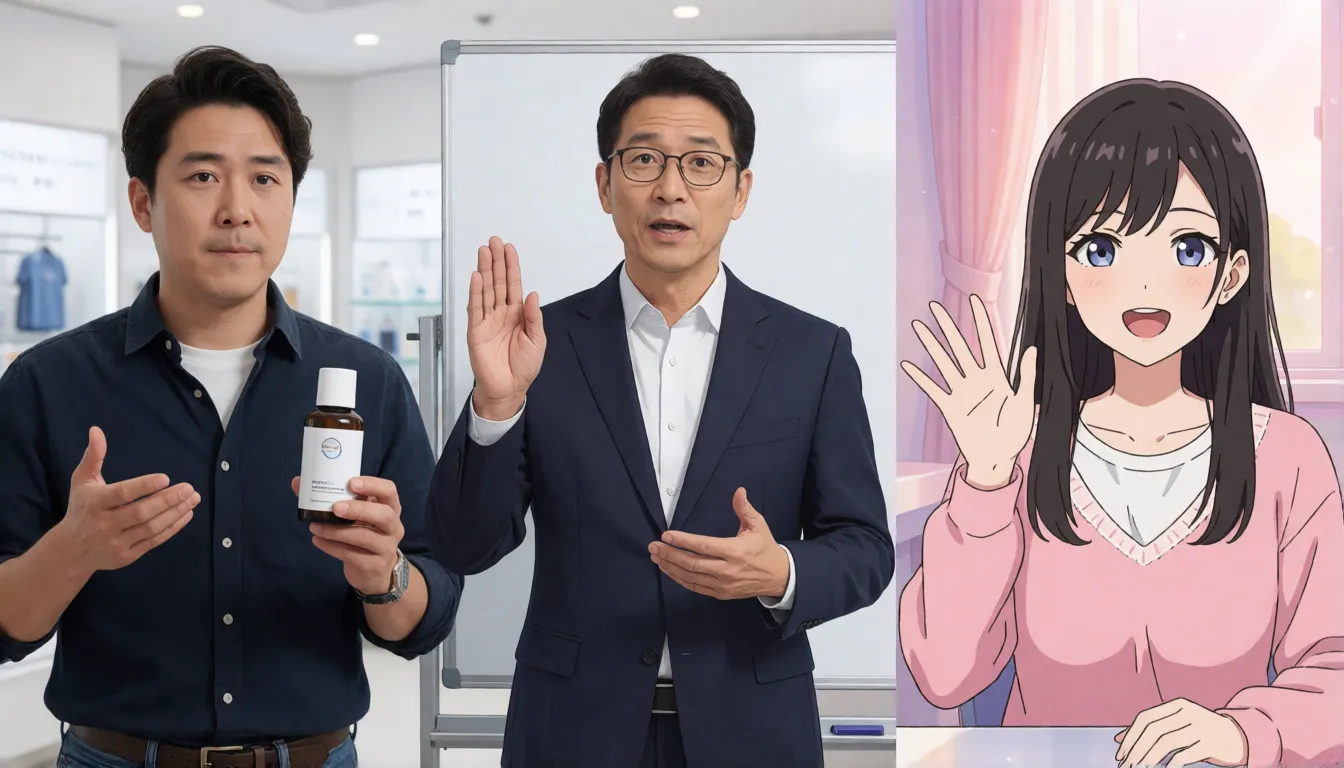
為每個角色肖像配上台詞,Kandinsky S2V 1.0 Pro 就會產出對嘴精準的全身場景。
商品解說
一張模特兒照片加一段錄好的介紹,就能成為適合網店與直播電商的主持人風格短片。
虛擬主持人
把角色圖片搭配 TTS 聲音,打造會回話的主播、老師與 AI 伴侶。
結果為何看起來自然
有三個設計選擇讓 Kandinsky S2V 1.0 Pro 和過去眾多對嘴工具區隔開來。第一,它是全身動畫:模型以 Kandinsky 5.0 Video 為基礎,本來就懂得身體、衣服和場景如何移動,提示詞也能引導手勢與場景。第二,它同時理解文字和聲音:Qwen2.5-Omni 會讀取你的文字提示詞,並以每秒 25 個 token 聆聽語音,讓動作貼合說話的情緒能量。第三,三層記憶機制會把參考照片的樣貌一個區塊接一個區塊地傳下去,讓長鏡頭中的臉孔和服裝保持一致。
Kandinsky S2V 1.0 Pro 也有蒸餾版。Pro distill 只要 16 步而非 50 步就能得到結果,並把引導直接融入權重;團隊表示速度約快五倍(依配置介於 4.5× 到 5.6×),而幾乎所有指標都與基礎模型相當。在論文中與最強開源基準及兩項商業服務比較的人工評測裡,Kandinsky S2V 1.0 Pro 平均獲評為相當或更好,其中最受青睞的是對嘴效果。
- 用文字提示詞控制全身動作與場景
- 逐影格音訊注意力帶來精準到影格的對嘴
- 逐區塊接續生成,沒有硬性長度上限
- MIT 授權的開放權重,可在本機執行
- Pro 模型需要 48 GB GPU(HD 需 80 GB)
- 不會生成聲音,需自備語音或 TTS
- 尚無適用 24 GB 顯示卡的官方量化版本
- HD 模式未在該解析度下訓練或評估
Lite 還是 Pro、基礎版還是蒸餾版:如何挑選版本
Kandinsky S2V 1.0 Pro 屬於一個共有四個檢查點的模型家族。2B Lite 模型是快速、輕量的選擇;21B Pro 模型的臉部、手部與動作品質最好。在同一尺寸中,蒸餾版適合日常使用,50 步的基礎模型則適合追求極致細節的人。兩個 Pro 檢查點都能以 1280×768 的 HD 配置執行。
| 版本 | 規模與步數 | 適合用途 | 單張 H100 速度(每秒影片) |
|---|---|---|---|
| Lite 2B distill | 2B,蒸餾版 | 快速草稿、較小的 GPU | 約 8.7 秒 |
| Lite 2B | 2B,基礎版 | 未蒸餾的 Lite 品質 | 比 Lite distill 慢 |
| Pro 21B distill | 21B,16 步 | 日常使用的最佳平衡 | 約 41.5 秒(編譯後 33.6 秒) |
| Pro 21B | 21B,50 步 | 最高擬真度,支援負面提示詞 | 約 189 秒 |
| Pro distill HD | 21B,1280×768 | 更大畫面(品質未經測試) | 約 137 秒 |
GPU 記憶體與速度:心裡要有數
Kandinsky S2V 1.0 Pro 是個大模型,下載約 65 GB 的檔案之前請先規劃硬體。官方需求是單張至少 48 GB 記憶體的 GPU(HD 需 80 GB),以及 580 或更新版本的驅動程式。在單張 H100 上,標準解析度的 Pro distill 峰值約 46 GiB,HD 峰值約 55 GiB。因此一段十秒的短片在單張卡上大約需要六到七分鐘,而官方的八 GPU 配置可把每秒影片縮短到約 11 秒。
記憶體不夠嗎?開啟 VAE 分塊可將峰值降到約 28 GB,代價是出現淡淡的接縫;使用 CPU 卸載的 Diffusers 路線峰值約 50 GiB;想在較小的顯示卡上實驗,Lite 2B distill 模型是最簡單的選擇。由於目前還沒有官方量化檔案,消費級 24 GB 顯示卡的常見替代方案是租一個下午的雲端 GPU。
三種試用方式:線上 Demo、ComfyUI 與 Diffusers
想看看 Kandinsky S2V 1.0 Pro 的能耐,完全不必安裝任何東西。團隊在 Hugging Face 上提供免費的 Demo Space,也有 Colab 和 Kaggle 筆記本給想多一點控制權的人。準備好自己執行時,挑一條最符合你現有工作方式的路線。
- 1線上:在 Hugging Face 開啟 Kandinsky-S2V-1.0-Demo Space,上傳一張人像和一段短 WAV 檔,加上提示詞後生成。
- 2命令列:clone kandinsky-s2v 的 GitHub 儲存庫,執行 uv sync,再用 s2v_pro_distill.yaml 設定及你的 --audio、--image、--out 路徑執行 uv run kandy-s2v generate;加上 --prompt 和 --seed 可引導並重現結果。
- 3ComfyUI:切換到儲存庫的 dev/comfyui 分支,其中提供 Lite distill 與 Pro distill 的節點,把圖片、音訊和提示詞接到取樣器上。
- 4Diffusers:從 main 分支安裝 diffusers,用 ModularPipeline 載入 kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers,並以 16 kHz 讀取音訊。
無論選哪條路線,對 Kandinsky S2V 1.0 Pro 來說,好的輸入檔案比任何設定都重要。請記住以下幾點:
- 使用清晰的正面照片,讓人物佔據畫面大部分;照片的長寬比就是影片的長寬比。
- 錄製沒有背景音樂的乾淨語音,存成 16 kHz 單聲道音訊。
- 得到滿意的結果後固定 --seed,只修改提示詞來探索變化。
說話影片提示詞範本
在 Kandinsky S2V 1.0 Pro 中,承載台詞的不是文字提示詞,而是你的音訊。用提示詞描述人物、動作、場景和鏡頭,並讓服裝與背景貼近參考照片,以免外觀走樣。以下範本涵蓋最熱門的格式;替換細節、保留結構即可。
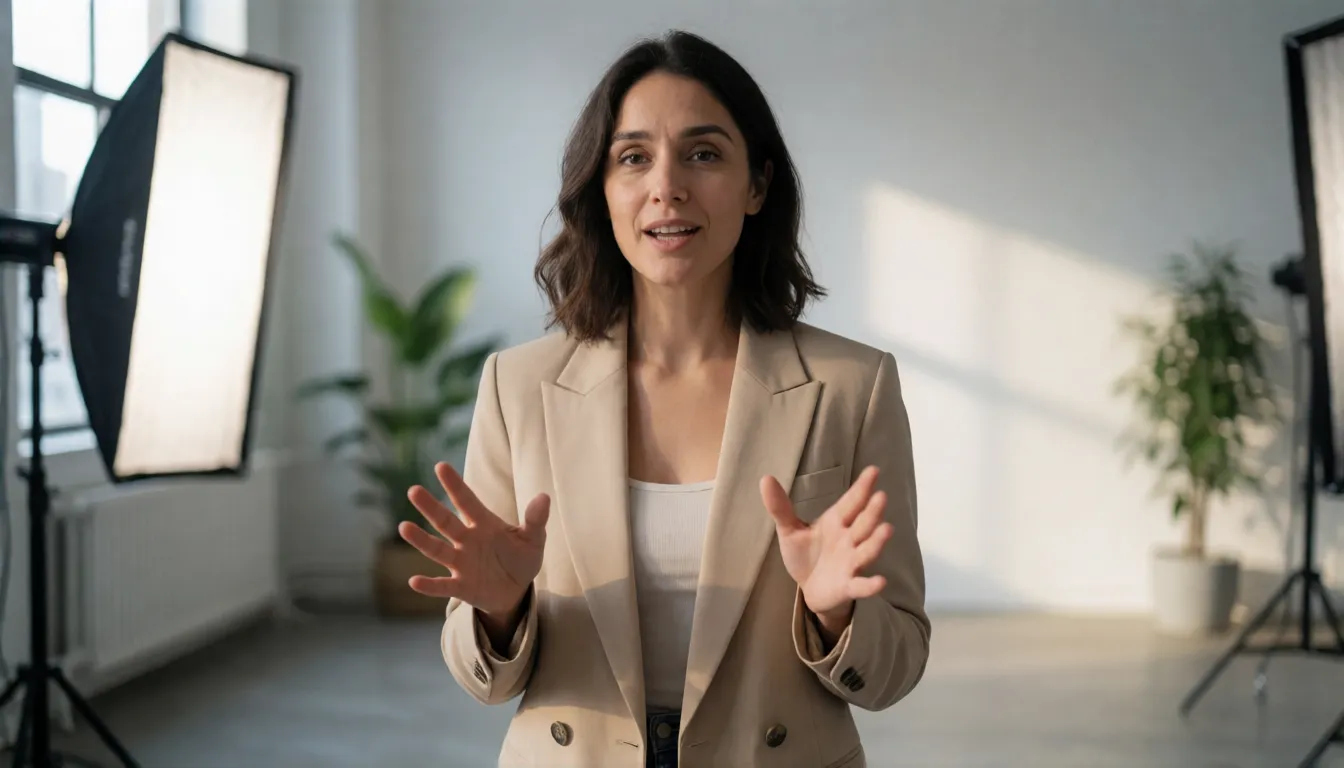
- 主持人: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
- 商品介紹: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- 戲劇對白: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- 音樂人: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- 老師: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- 虛擬主播: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- 海灘閒聊(18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- 負面提示詞(僅限 50 步模型): blurry face, distorted mouth, extra fingers, flickering, static body.
與 Wan 2.2 S2V、InfiniteTalk 等開源頭像模型的比較
開源說話頭像模型越來越多,和 Kandinsky S2V 1.0 Pro 相比各有所長。阿里巴巴的 Wan2.2-S2V-14B 已有社群製作的 GGUF 檔,對較小的 GPU 更友善。InfiniteTalk 和 MultiTalk 專注於超長影片與多人對話。LongCat-Video-Avatar 1.5 也有適用 ComfyUI 的 GGUF 版本。Kandinsky S2V 1.0 Pro 的亮點是寬鬆的 MIT 授權、可用文字引導的全身動作,以及 16 步蒸餾版;目前的弱點是記憶體門檻高、社群生態系仍很年輕。論文並未列出比較基準的名稱,因此正面對比的說法應視為未經驗證,請用你自己的素材測試。
| 模型 | 強項 | 較小 GPU 上容易執行嗎? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | 全身動作、文字控制場景、16 步蒸餾版 | 僅 Lite;Pro 需 48 GB |
| Wan2.2-S2V-14B | 生態系成熟、電影感動作 | 是,有社群 GGUF |
| InfiniteTalk / MultiTalk | 超長片段、多人對話 | 視配置而定 |
| LongCat-Video-Avatar 1.5 | 支援 ComfyUI 的頭像影片 | 是,有社群 GGUF |
無審查說話頭像:現在能做什麼
目前還沒有 Kandinsky S2V 1.0 Pro 的官方或社群無審查微調版本。開放權重可在本機執行、沒有線上審核層,但訓練資料是單人說話的影片,所以它並非為成人場景打造,而且模型卡要求使用者只能為已同意的人製作動畫。如果你想不安裝任何東西,就讓 18 歲以上虛構角色的照片說話、調情,或穿泳裝、內衣擺姿勢,可以用我們的圖片轉影片工作室上傳人像、描述動作,直接在瀏覽器中生成。
在瀏覽器中讓 18 歲以上角色人像動起來,不需要 GPU。
開始圖片轉影片 →自行架設 Kandinsky S2V 1.0 Pro vs 在 Spicy AI 線上生成
| 本機部署(官方權重) | Spicy AI 線上 | |
|---|---|---|
| 內容過濾 | 自行執行時沒有線上過濾 | 允許成人(18+)內容 |
| 開放權重 | 是,在 Hugging Face 以 MIT 授權釋出 | 不適用,線上執行 |
| 實際使用的模型 | Kandinsky S2V Lite 或 Pro | Spicy AI 自家影片模型 |
| 價格 | 權重免費,GPU 費用自付 | 免費開始,更多用量使用點數 |
- 本機:用你自己的音訊做語音驅動對嘴,長度不限,完全掌控。
- Spicy AI:從一張照片開始,在瀏覽器中製作動畫,不需要硬體。
常見問題
Kandinsky S2V 1.0 Pro 是什麼?
Kandinsky S2V 1.0 Pro 是 Kandinsky Lab 推出的 210 億參數語音轉影片模型。給它一張參考照片、一段語音錄音和文字提示詞,就能生成帶有對嘴效果的 25 fps 全身說話影片。權重以 MIT 授權開放。
Pro 和 Pro distill 有什麼差別?
兩者都有 21B 參數。distill 版本使用 pi-Flow 蒸餾,只需 16 步而非 50 步,並把引導融入權重,因此速度約快五倍,而幾乎所有指標的分數都接近基礎模型。
Kandinsky S2V 1.0 Pro 需要多少 GPU 記憶體?
團隊建議單張至少 48 GB 的 GPU(HD 需 80 GB)。Pro distill 在標準解析度下峰值約 46 GiB;VAE 分塊可降到約 28 GB,但會有淡淡的接縫。目前還沒有官方量化版本。
Kandinsky S2V 1.0 Pro 的影片可以多長?
和你的音訊一樣長。模型會生成五秒的區塊,並讓每個區塊從上一個接續下去。在單張 H100 上,用 Pro distill 生成一秒標準解析度影片約需 41.5 秒。
Kandinsky S2V 1.0 Pro 也會生成聲音嗎?
不會。語音由你提供,可以是真人錄音或文字轉語音,完成的影片會帶有那段原始音軌。
有線上 Demo 或 ComfyUI 支援嗎?
有。Kandinsky Lab 在 Hugging Face 上提供 Demo Space,GitHub 儲存庫的 dev/comfyui 分支加入了 Lite distill 與 Pro distill 的 ComfyUI 節點,Diffusers 支援則可從 main 分支取得。
有無審查版的 Kandinsky S2V 1.0 Pro 嗎?
截至 2026 年 11 月還沒有:官方和社群都尚未釋出無審查微調版本。你可以自行執行開放權重,或使用允許 18 歲以上虛構內容的線上圖片轉影片生成器。
資料來源
- Kandinsky-S2V-1.0-Pro-distill 模型卡(Hugging Face)
- Kandinsky-S2V-1.0-Pro-distill-Diffusers 模型卡(Hugging Face)
- Kandinsky-S2V-1.0-Pro 基礎模型(Hugging Face)
- Kandinsky S2V 1.0 線上 Demo(Hugging Face Space)
- kandinskylab/kandinsky-s2v 儲存庫(GitHub)
- Kandinsky S2V 1.0:音訊驅動頭像影片生成(arXiv)
- Kandinsky Avatar 專案頁面
- Wan2.2-S2V-14B GGUF(Hugging Face)
更多無審查影片模型指南
- 無審查 Kandinsky 6.0
- 無審查 Kling
- 無審查 Kling 2.6
- 無審查 Kling O1
- 無審查 Sora
- 無審查 Veo
- 無審查 Hailuo AI
- 無審查 MiniMax H3 Max
- 無審查 Wan
- 無審查 Wan 3.0
- 無審查 Seedance
- 無審查 Seedance 2.5
- 無審查 Seedance 2.0
- 無審查 Seedance 2.0 Mini
- 無審查 HunyuanVideo
- 無審查 LTX Video
- 無審查 Runway
- 無審查 Pika
- 無審查 Luma Dream Machine
- 無審查 Vidu
- 無審查 PixVerse
- 無審查 EdenLive
- 無審查 Grok Imagine
- 無審查 AI Avatars
- 無審查 HappyHorse 1.0
- 無審查 MiniMax H3 FL2VA Ref2VA
- 無審查 Kling 4.0
- 無審查 Kling 3.0
- 無審查 MiniMax H3 RefMods
- 無審查 Looking Ahead
- 無審查 TaoMate-H3
- 無審查 SANA-Video 2.0
- 無審查 MiniMax H3 Remix
- 無審查 Sora 2
- 無審查 Wan 2.6
- 無審查 LTX-2.5 Slow Motion
- 無審查 VDN MiniMax H3
Spicy AI 為獨立網站,與 Kandinsky Lab 或 Sber 並無關聯。所有內容僅能涉及成年人(18 歲以上);未經本人同意,請勿為真實人物製作動畫。