開放 LoRA · 串流音訊 + 影片
無審查 TaoMate-H3:還在生成就能開始播放的 AI 影片
為了一段十秒短片等上三分鐘,AI 影片的樂趣就沒了。TaoMate-H3 改變了這個節奏:它不是把整段影片算完才呈現,而是把畫面和聲音切成小段逐步生成,大約 17 秒就交出第一段可播放的內容。它由阿里巴巴淘寶直播 AIGC 團隊(也就是打造淘寶直播 AI 工具的團隊)以開放 LoRA 形式發布,建立在開放權重的 MiniMax H3 模型之上,只要你持續餵提示詞,它就會一直生成下去。這讓它天生適合說話主持人、產品示範和連載式故事。以下介紹它能做什麼、擅長哪些場景、怎麼寫提示詞,以及執行需要什麼條件。
- 3 步 LoRA
- 邊算繪邊播放
- 480p · 768p · 1080p
- 開放權重
TaoMate-H3 與 MiniMax H3 對比:從三分鐘縮短到十七秒
最大的亮點是速度。MiniMax H3 是很強的開放音訊影片模型,但和大多數影片生成器一樣,要等整段影片完成才能看到第一格畫面。TaoMate-H3 加入一個 LoRA,訓練成每個片段只需三步去噪,再依序把片段串流輸出。在團隊自己使用八張 NVIDIA H20 的測試中,一段十秒 480×864 的影片從 183.3 秒縮短到 17.3 秒就能觀看,核心擴散運算也從將近 170 秒降到 15 秒以內。
記憶體用量幾乎沒變,所以加速並不是靠更大的機器。團隊尚未公布畫質或動態幅度的並排比較,因此畫質好壞請用自己的眼睛判斷,不要當成已證實的優勢。
| 官方測試(8×H20,480×864,10 秒) | MiniMax H3 | 加上 LoRA | 提升 |
|---|---|---|---|
| 第一段可播放影片 | 183.3 秒 | 17.3 秒 | 快 10.6 倍 |
| 第一個完成的片段 | 170.1 秒 | 6.1 秒 | 快 27.7 倍 |
| 擴散(DiT)時間 | 169.6 秒 | 14.8 秒 | 快 11.45 倍 |
| DiT 峰值記憶體 | 32.03 GiB | 31.37 GiB | 大致相同 |
每段三步:用白話解釋串流式音訊影片生成
想像一台印表機,每印好一頁就先交給你,而不是等整份報告印完。模型把影片和配樂切成短小的片段,每段以三次去噪完成。每個完成的片段會寫入記憶快取,下一段再以此為基礎生成,所以故事可以一直延續、沒有固定結尾。以十秒影片來說,官方說明共計 24 次生成和 8 次快取更新。
長鏡頭中要維持臉孔和聲音穩定是最難的部分。專案背後的研究論文提出「錨點引導記憶」:用一個參考狀態鎖定角色的長相與聲音,減少隨著時間推移出現的色彩漂移和身分晃動。畫面與聲音是一起生成的,所以嘴型、說話和環境音能保持同步,而不是事後硬貼上去。
論文的基準測試相當亮眼:三張 GPU 跑出每秒 35 幀,而 LiveAvatar 用五張是 23 幀、LongLive-2.0 用四張是 16 幀,對嘴分數也居冠。但要注意,這些數字是在從 LTX-2.3 初始化的 220 億參數生成器上測得,並非 H3 版本,所以代表的是方法的潛力,而不是這個模型的實際成績。在即時 AI 影片的開源選項中,它是少數能同時串流聲音與畫面的方案之一。
數位人主持、直播風格產品示範與短劇
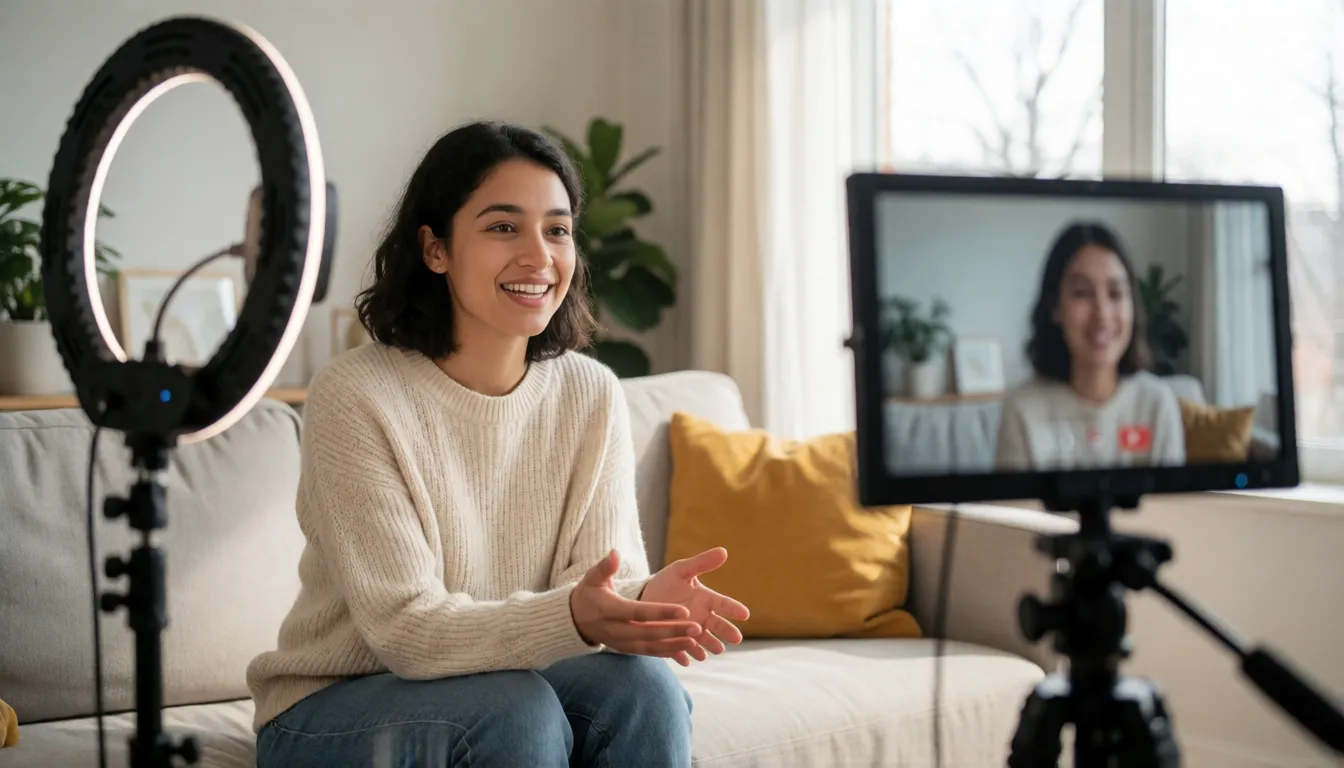
由於出自淘寶直播團隊,最理所當然的舞台就是說話的主持人。官方首尾幀示範是一段 30 秒影片:主持人坐在家中客廳講解收納技巧,正是購物直播整天在播的那種段落。專案從未承諾提供完整的直播電商產品,但要素都已具備:穩定的臉孔、自然的聲音,以及夠快的產出速度,足以讓製作排程順利推進。
說話主持人與講解影片
一位主持人、一個房間、把腳本拆成短小段落。非常適合教學短片、居家小技巧,以及需要親切面孔出鏡的頻道開場。
產品示範與廣告草稿
草擬多個版本的 15 秒推銷影片,換台詞或換產品角度,在預約實際拍攝前並排比較。
分集短劇
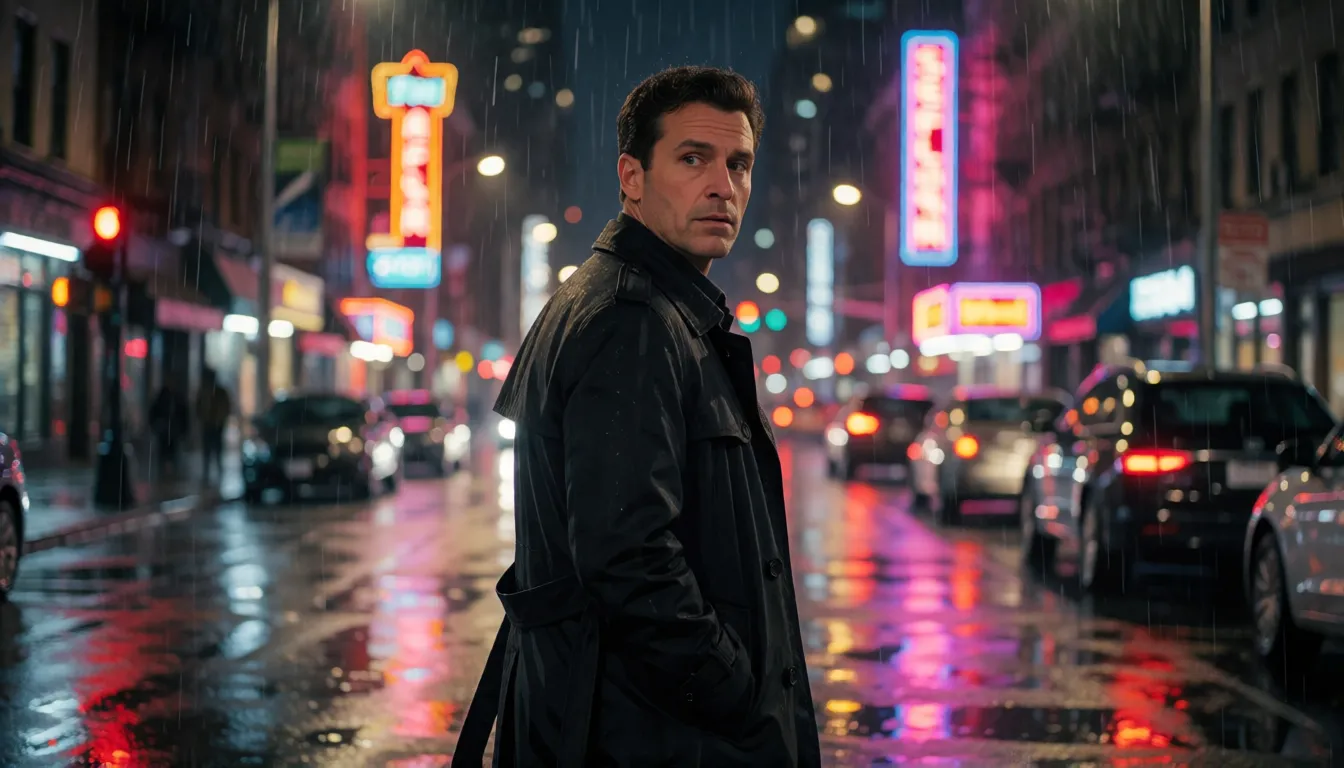
把五秒段落串成連續場景。雨、霓虹、一句低語和一個反轉,每段都維持同一位演員。
直式優先的社群影片
原生 768×1376 與 1088×1920 直式尺寸,可直接放進短影音動態,無需裁切。論文也測試了中文和英文語音。
每次五秒,打造一分鐘的 AI 影片
長篇 AI 影片正是串流真正發揮價值的地方。長度以五秒為單位設定,你可以整段沿用同一個提示詞,也可以傳入 JSON 清單,每個五秒區塊各一個提示詞,並可選擇各一個種子。把它想成分鏡表:第一段介紹主持人,第二段展示產品,第三段是特寫,模型會在每次變化中延續同一個人和同一個房間。官方範例長 30 秒,論文則測試了完整一分鐘、共 1,441 幀。
輸出有三種尺寸:480p 用於快速草稿、768p 為預設、1080p 用於交付,每種都有橫式或直式。首尾幀版本固定以 24 fps、768×1376 直式執行,當每個鏡頭都必須以精確姿勢開始和結束時特別好用。
說話主持人與連續場景的提示詞範本
長鏡頭保持一致的訣竅就是重複。每個區塊都重述人物的外貌、服裝和場景,每段只給一個主要動作,台詞放進引號,聲音另外描述。以下範本遵循這個模式,可作為你自己腳本的初稿。
說話主持人 · 區塊 1
中景,一位穿米白色毛衣的年輕女子坐在明亮客廳的沙發上,對著鏡頭說話,講解如何把毛巾摺好放進收納盒,手勢自然,溫暖日光,鏡頭穩定。音訊:清晰的女聲,柔和的室內環境音。
說話主持人 · 區塊 2(延續)
同一位女子,同一件米白色毛衣,同一個客廳。她把盒子舉向鏡頭並微笑:「這個可以放三條毛巾。」鏡頭緩緩推近。音訊:同一個聲音,輕微的布料摩擦聲。
短劇段落
雨夜街頭,一名穿黑色風衣的男子轉身,特寫,他低聲說:「你還是來了。」霓虹倒映在濕漉漉的柏油路上。音訊:持續的雨聲,遠處雷鳴。
成人泳裝廣告(18+,虛構模特兒)
一位二十多歲後半的成年時裝模特兒穿著紅色比基尼,沿著陽光海灘行走,對著鏡頭介紹今夏泳裝,笑容輕鬆,跟拍鏡頭。音訊:她的聲音、海浪、微風。
TaoMate-H3-FL2VA 與 TaoMate-HD:持續壯大的家族
這個專案進展很快。2026 年 9 月的首次發布為 H3 帶來文字轉音訊影片串流。2026 年 10 月 15 日,團隊推出 TaoMate-H3-FL2VA,輸入首幀與尾幀即可串流生成中間的影片,團隊稱就其所知,這是第一個即時首尾幀音訊影片模型。當分鏡表規定了每個鏡頭如何開始與結束時,就該用這個版本。
2026 年 11 月 3 日推出 TaoMate-HD,基於 H3 執行環境,採用漸進式生成以追求更清晰的成果;詳情請見其專案頁面。參考圖生成(Ref2AV)列為後續推出,目前尚無日期。
從 Hugging Face 與 GitHub 執行 TaoMate-H3
LoRA 本身很小,只有一個 config、一個 adapter config 和一個 safetensors 檔案(rank 128),發布在 Hugging Face,並有 ModelScope 鏡像。安裝說明位於 GitHub 儲存庫。問題在於硬體:唯一驗證過的配置是八張 NVIDIA H20 96 GB,腳本接受四張或八張 Hopper 等級 GPU。
- 1準備 Linux 環境,安裝 Python 3.10 或 3.11、CUDA 12.8、PyTorch 2.8、vLLM 0.11.1、適用 Hopper 的 FlashAttention 以及 FFmpeg。
- 2從 Hugging Face 下載 MiniMax H3 基礎模型(model_index.json 及其資料夾)與 TaoMate LoRA。
- 3選擇尺寸(480p、768p 或 1080p),並將 --duration 設為 5 秒的倍數。
- 4整段影片傳入一個 --prompt,或使用 --prompt-json,每個五秒區塊各一個提示詞並可選擇種子。
- 5以 --gpus 4 或 8 執行,在其餘部分仍在生成時就能觀看最先完成的片段。
- GPU 需求:未公布最低 VRAM,也沒有針對 RTX 4090 或 5090 顯示卡的官方方案。
- ComfyUI:目前尚無官方節點,命令列是受支援的使用方式。
- 線上示範:Hugging Face 上有兩個社群 Space 可在瀏覽器中試用 3 步模型,模型頁面也列出了一個託管推論服務商。
為什麼創作者關注這次發布
開放的即時音訊影片生成相當少見,這正是吸引眾人目光的原因。大約兩個月內,GitHub 儲存庫突破 800 顆星,Hugging Face 頁面獲得超過 130 個讚,社群也架設了兩個公開示範 Space。大家興奮的是影片幾乎立刻開始播放,以及長鏡頭能維持同一張臉。阻礙多數人的主因在需求中一目了然:需要多 GPU 的資料中心配置,目前尚無官方的消費級顯示卡或 ComfyUI 方案。
無審查 TaoMate-H3:開放權重對成人創作者的意義
TaoMate-H3 並沒有另外的無審查版本,一般意義上也不需要:LoRA 和 H3 基礎模型都是開放權重,官方頁面未描述任何內容過濾器或安全分類器,本機執行也不會經過雲端審核服務。對成人創作者來說,這代表規則由模型本身的授權條款和你自己的配置決定。如果你沒有八 GPU 的設備,Spicy AI 提供類似、過濾較寬鬆的線上圖片轉影片工具,適用於成人虛構角色。
上傳你原創成人角色的靜態圖,讓它帶著聲音動起來,無需 GPU。
開啟圖片轉影片無審查替代影片生成器
從一張原創成人角色的照片開始,描述動作和他們要說的台詞,就能在瀏覽器中得到一段簡短的說話影片。
開始生成自行架設 TaoMate-H3 與在 Spicy AI 線上生成的比較
自己執行能獲得即時串流與完全掌控;線上方式則以此換取零設定。
| 本機部署(官方權重) | Spicy AI 線上 | |
|---|---|---|
| 內容過濾 | 由你自行配置 | 成人內容(18+)過濾較寬鬆 |
| 開放權重 | 是(LoRA + H3 基礎模型) | 不需要,在瀏覽器中執行 |
| 實際使用的模型 | MiniMax H3 上的 TaoMate LoRA | 託管的圖片轉影片模型 |
| 起步成本 | 四到八張 Hopper GPU | 提供免費方案 |
常見問題
TaoMate-H3 是什麼?
由阿里巴巴淘寶直播 AIGC 團隊基於 MiniMax H3 打造的 3 步 LoRA 與串流執行環境。它以分段方式同時生成音訊和影片,所以其餘部分仍在算繪時就能開始播放。
它比 MiniMax H3 快多少?
在八張 H20 GPU、480×864、10 秒的官方測試中,第一段可播放影片在 17.3 秒後就出現,相較之下原本需要 183.3 秒,擴散時間則縮短為 11.45 分之一。
能在 RTX 4090 或 5090 上執行嗎?
官方不支援。只支援 Hopper GPU,驗證過的配置是八張 H20 96 GB,可使用四張或八張 GPU,且未公布最低 VRAM。
支援首尾幀影片嗎?
主要版本是文字轉音訊影片。首尾幀串流來自 2026 年 10 月 15 日發布的 TaoMate-H3-FL2VA。參考圖生成尚未推出。
影片可以多長?
長度以五秒為單位增加,並可持續延長。官方範例長 30 秒,論文則評估了 1,441 幀的一分鐘影片。
有 ComfyUI 節點嗎?
團隊目前沒有提供。受支援的執行方式是 GitHub 儲存庫中的命令列腳本。
有無審查版本嗎?
沒有專屬版本。權重是開放的,官方頁面也未描述內建過濾器,因此本機執行受 H3 社群授權條款規範,而非雲端審核。