MiniMax H3 · 社群參考轉接器
MiniMax H3 RefMods:每個鏡頭都是同一位主角,完全免訓練
每位 AI 影片創作者都懂這種痛:女主角在第一個鏡頭完美無瑕,到了第三個鏡頭臉卻走樣了。MiniMax H3 RefMods 借用 LoRA 文化的巧思解決這個問題。只要把幾張照片、一段短片或一段音訊樣本送進 ComfyUI 一次,就能產出約 1 到 1.6 MB 的小檔案,牢牢記住你的角色是誰。把它接進任何 MiniMax H3 影片工作流程,同樣的臉孔、服裝或畫風就能隨叫隨到,完全不必訓練模型。下面會介紹它的功能、創作者的應用場景、逐步設定教學、提示詞範本,以及一份坦白的「目前仍有問題」清單。
- 免訓練
- 約 1–1.6 MB 檔案
- 最多 8 個插槽
- ComfyUI + Fizgig
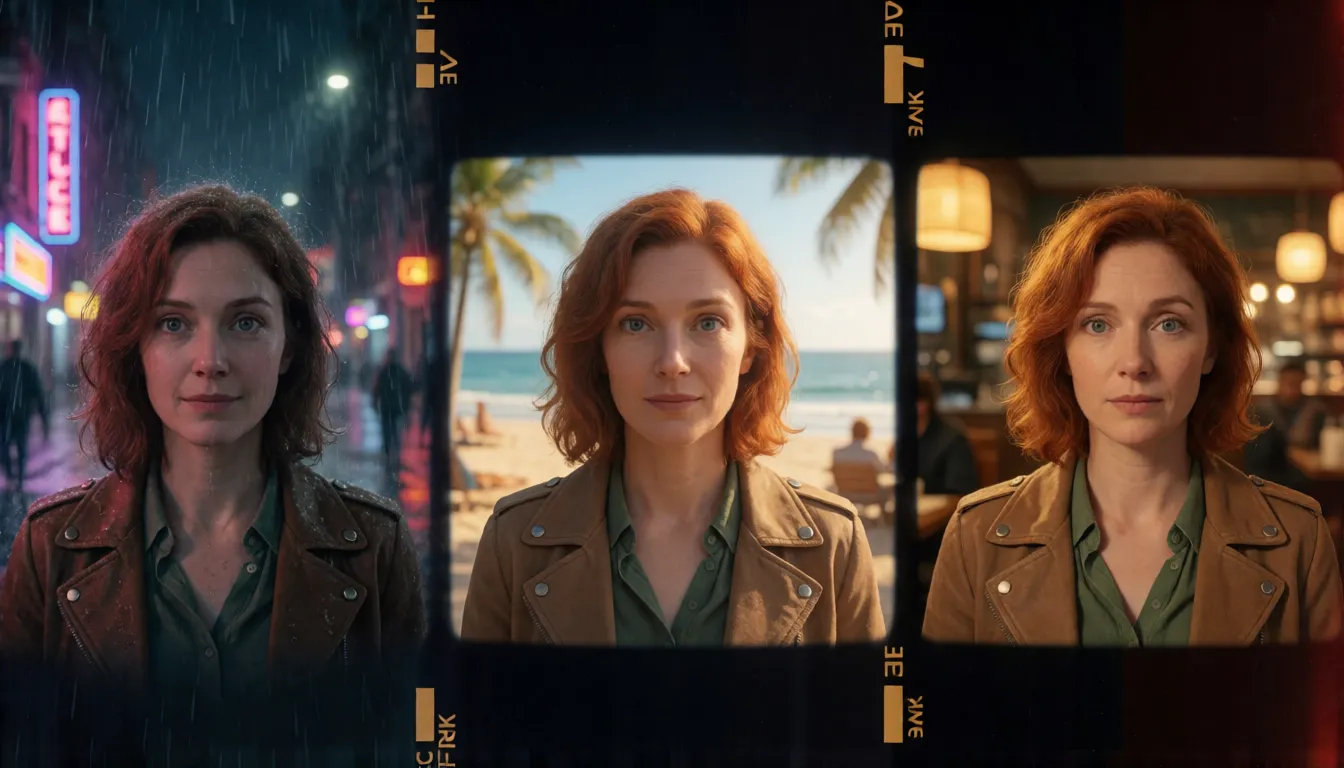
把整個角色裝進一個小檔案
MiniMax H3 RefMods 是 Reference Latent Adapters(參考潛在轉接器)的簡稱,是專為開放權重 H3 音訊影片模型打造的社群格式。你可以把它想成一份存檔的選角資料:不必每次都上傳同樣的參考圖、手動調整 <Picture 1> 位置標籤,而是透過 VAE 編碼一次,把結果存成 .safetensors 檔案。之後就像載入 LoRA 一樣使用,在生成影片時注入 H3 的參考條件串流。H3 本身的權重完全不用重新訓練,所以製作一個只需幾分鐘,而不是好幾個小時。
這個格式和相關節點來自開發者 @Luisacaotica 的 ComfyUI-MiniMaxH3Mod 套件,採用 MIT 授權釋出。它是社群專案,並非 MiniMax 的產品,README 也仍標示為開發中,因此節點名稱與輸入可能會隨版本更動。但這絲毫沒有減緩大家的熱情:專案上線短短幾週,GitHub 星星數就突破 500。
| 設定 | 作用 | 最適合 |
|---|---|---|
| Full Reference(完整參考編碼) | 保留所有編碼細節,使用較多 token | 需要清晰銳利的臉孔與服裝 |
| Compressed Reference(壓縮參考) | 彙整參考以節省 token,會損失部分細節與動態 | 長片段或疊加大量檔案 |
| identity_encode 預設 | 捕捉人物或角色的身分特徵 | 反覆登場的主角、主持人和吉祥物 |
| style_experimental 預設 | 把一種風格壓縮進 8×8 網格 | 統一調色或畫風的系列作品 |
| motion_sequence 預設 | 儲存短片中的動作 | 重複使用舞蹈、走路姿態或手勢 |
創作者如何運用參考轉接器
MiniMax H3 RefMods 的魅力很簡單:一個檔案,無限集數。過去每個固定角色都要訓練一個 LoRA 的創作者,現在改為建立一個小型的角色、風格與動作資料庫,再依每個鏡頭自由搭配。以下是社群討論串與分享的工作流程中最常見的用法。
短劇與 AI 漫畫
讓同一位原創主角貫穿數十個鏡頭。場景、運鏡和動作都能換,臉孔卻從這集到下一集都不走樣。
虛擬主持人與原創 IP
把吉祥物或虛擬主持人鎖定在單一檔案裡,每週發布新影片,外觀也不會慢慢偏離品牌形象。
時尚與產品展示
讓同一位成人模特兒保持穩定,同時透過提示詞更換服裝。參考圖中的衣著可能會滲入畫面,所以請清楚描述新造型。
變身鏡頭
Axis 載入器可在兩個角色之間從 A 平滑過渡到 B,非常適合變形特效、前後對比揭曉和夢境段落。
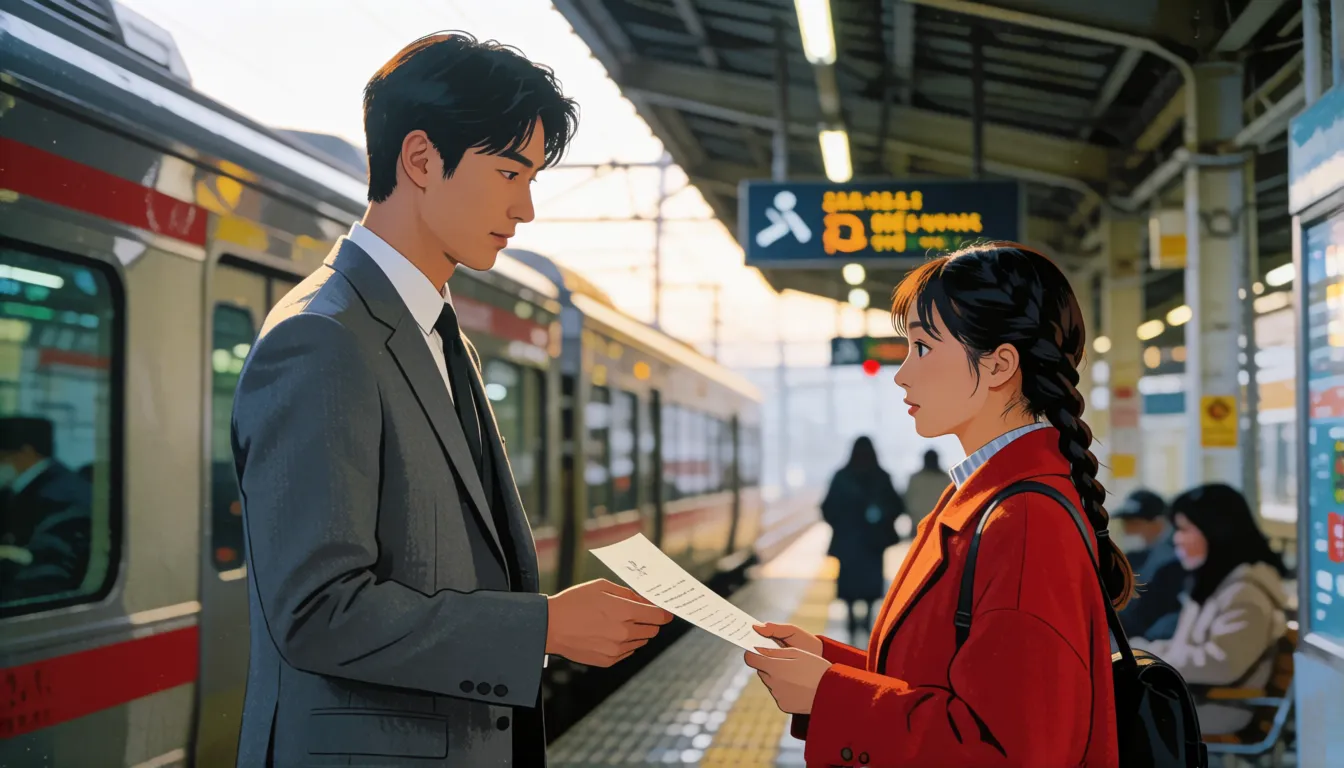
在 ComfyUI 中把八張照片變成可重複使用的角色
在 ComfyUI 中製作 MiniMax H3 RefMods,請依照節點套件的 README 操作。先從優質素材開始:5 到 10 張清晰、單人、不同角度的圖片,或一段短片。音訊一般建議 5 到 15 秒的乾淨聲音。避免雜亂的背景,因為畫面裡的任何東西都可能跟著臉孔一起被收進檔案。
- 1透過 ComfyUI Manager 安裝 ComfyUI-MiniMaxH3Mod,或把 GitHub 儲存庫複製到 custom_nodes,然後重新啟動 ComfyUI。
- 2把參考圖片載入 Extract H3 RefMod 節點,選擇 identity_encode 預設並搭配 Full Reference,以取得最多細節。
- 3將輸出存到 ComfyUI/models/refmods/,讓載入節點找得到。
- 4加入 Load H3 RefMods(最多八個插槽,各自可設定強度與複本數),並設定初始強度。
- 5把 Apply H3 RefMod 接到 MiniMax H3 ImageToVideo 或 ReferenceToVideo 節點的條件輸入,再照常取樣。
- 6用相同種子先在不載入檔案的情況下算一次作為基準,就能清楚看出參考檔帶來了什麼差異。
- Step Curve 節點:選擇 concept_at_start、concept_at_middle 或 concept_at_ends,決定參考在去噪過程中的作用時機,例如先求神似、後段再放開動作。
- Load H3 RefMod Folder:指定一個資料夾,就能一次切換整組角色。
比起節點更愛按鈕?用 Fizgig v6 製作
shootthesound 開發的創作工具 Fizgig 在 2026 年 9 月中推出的第 6 版加入了 MiniMax H3 RefMods 製作功能。它把擷取流程包進更友善的介面,並提供現成配方:社群配方使用 8 張 1 百萬像素圖片,Fizgig lite 使用 16 張 0.5 百萬像素圖片,Fizgig 1MP 選項則介於兩者之間。另外還有風格預設、動作與音訊參考,以及能並排算出 A/B 比較的 RefMod Studio,讓你不用憑感覺就能判斷強度設定。Fizgig 自家文件也附有 how-do-I 教學,逐一說明每種配方。
兩個角色、同一場景:疊加多個檔案
群體鏡頭正是 MiniMax H3 RefMods 悄悄勝過單張圖片參考的地方。為每個角色各做一個檔案,載入不同插槽,並在提示詞中以 <Subject 1>、<Subject 2> 等標籤稱呼。每個檔案只放一個人:同時混入兩張臉的檔案容易把兩人融在一起。如果主角開始失去細節,先調低配角的強度,並在提示詞中保留髮型、服裝和體型描述,讓模型分得清誰是誰。
不只是臉孔:風格、動作與聲音參考
對 MiniMax H3 RefMods 來說,角色只是故事的一半。用 style_experimental 製作的風格檔,能把一組影格壓縮成可套用到整個系列的視覺風格,非常適合讓整個頻道維持同一種調色。用 motion_sequence 製作的動作檔,則能把短片變成動作範本,讓招牌走路姿態或舞蹈換個角色也能重現。
音訊檔也有,大約每秒聲音 80 個 token。請把它當成實驗功能:在目前的測試中,說話者身分無法穩定轉移,音訊預設從片段開頭開始編碼,也沒有對嘴同步。未經同意,絕對不要用它模仿真人的聲音。
讓臉孔穩定不走樣的提示詞範本
使用 MiniMax H3 RefMods 撰寫提示詞時,請記得參考檔不是觸發詞,檔名放進提示詞也毫無作用。有效的做法是把角色當作沒有檔案一樣完整描述,再讓參考把細節校正到位。以下範本是為原創成人角色撰寫的,請換成你自己的細節。
- 務必用文字鎖定外觀與動作:年齡、髮型、眼睛、服裝,接著是動作與運鏡。
- 一個檔案一個角色,每個角色一個 <Subject N> 標籤。
- 從中等強度開始,臉孔走樣時才調高;如果背景開始照搬參考照片,就調低。
- 換裝時明確寫出新服裝名稱,並加上 same face,避免參考圖中的衣著喧賓奪主。
單一角色
<Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, wearing a white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting.
兩個角色
<Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light.
換裝(18+ 原創角色)
<Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, standing by a sunlit pool, slow dolly-in.
RefMod、LoRA 與直接放參考圖的比較
每種方法都有適用場合。Fizgig 作者指出,訓練好的 LoRA 泛化能力仍然更好、相似度也更高,但對於接近參考素材的鏡頭,差距其實不大。直接使用參考圖完全不需準備,但每次執行都要重新編碼,圖片一多,位置標籤也會變得很麻煩。
| RefMod | LoRA | 直接放參考圖 | |
|---|---|---|---|
| 訓練 | 不需要,擷取一次即可 | 需要,準備資料集並執行訓練 | 不需要 |
| 首次可用時間 | 幾分鐘 | 數小時 | 立即 |
| 檔案大小 | 約 1–1.6 MB | 通常大得多 | 無檔案 |
| 新角度下的相似度 | 接近參考時表現良好 | 最強 | 每次結果不一 |
| 疊加多個角色 | 最多 8 個插槽 | 可行,但可能互相衝突 | 每張圖都需位置標籤 |
目前仍有的問題:坦白說明限制
MiniMax H3 RefMods 還很年輕,節點套件的 README 也坦率列出了不完美之處。事先了解能省下好幾個小時的重算,而且大多有簡單的解法,例如使用更乾淨的參考素材或調低強度。
- 快速動作可能讓臉孔糊掉;放慢運鏡較能維持身分特徵。
- Compressed Reference 會損失臉部細節,特寫請改用 Full Reference。
- 身分、服裝、背景和構圖可能一起被轉移,無法保證只轉移指定部分。
- 目前用音訊檔複製聲音並不可靠,音訊也不含對嘴同步。
- 部分工作流程尚未在所有 GPU 上完整驗證,也沒有正式的基準測試。
現成檔案:社群在哪裡分享
你不必從零開始製作所有 MiniMax H3 RefMods。創作者 malcolmrey 在 Hugging Face 上以 Apache-2.0 授權發布了數百個現成檔案的大型資料庫,另附教學、範例與工作流程範例的資料集。下載檔案後放進 ComfyUI/models/refmods/,就會出現在載入器中。也有一些規模較小的個人上傳,但許多都不太活躍,部分還含有真人或受著作權保護角色的肖像,使用前請先確認內容,並只使用原創或已妥善授權的角色。
無審查用途:參考檔能改變與不能改變的事
搜尋 uncensored MiniMax H3 RefMods 的人,通常是希望找到無過濾版本。但這種版本並不存在:參考檔只告訴模型要呈現誰或什麼,並不會改變模型願意生成的內容。由於 H3 是開放權重模型,本地使用者本來就能自行決定設定,成人創作者通常會把原創 18+ 角色的檔案,搭配社群的 H3 LoRA 來製作海灘裝、內衣或私房寫真系列。如果你想省去本地安裝,Spicy AI 提供線上 H3 圖片轉影片服務,針對成人、虛構或已同意的角色放寬過濾。
上傳一張原創成人角色的靜態圖,不需要 GPU 就能讓它動起來。
開啟圖片轉影片線上試試角色一致性提示詞
從角色的一張靜態圖開始,貼上提示詞,剩下的交給影片模型。這些入門範本專為原創成人角色撰寫,直接使用即可。
- <Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting
- <Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light
- <Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, stands by a sunlit pool and turns toward the camera, slow dolly-in
- <Subject 1>, adult man with a trimmed beard, open white shirt, laughs on a yacht deck at golden hour, wind in his hair, camera orbits slowly
自己部署 H3+參考檔 vs 在 Spicy AI 線上生成
本地 ComfyUI 提供完整的節點工具;線上方案則以這份掌控換取零設定。
| 本地部署(官方權重) | Spicy AI 線上 | |
|---|---|---|
| 內容過濾 | 自行設定 | 針對成人內容(18+)放寬過濾 |
| 開放權重 | 是 | 不需要,直接在瀏覽器執行 |
| 角色一致性 | RefMod 檔案、LoRA 與節點控制 | 從角色的一張靜態圖開始 |
| 入門成本 | 自備 GPU | 提供免費方案 |
常見問題
MiniMax H3 RefMods 是 MiniMax 做的嗎?
不是。它是由 @Luisacaotica 以 ComfyUI-MiniMaxH3Mod 節點套件打造的社群格式,採用 MIT 授權。MiniMax 尚未對此發表立場。
需要訓練任何東西嗎?
不需要。參考素材只需通過 VAE 一次,就會存成約 1 到 1.6 MB 的檔案。H3 權重完全不會重新訓練。
應該用幾張圖片?
README 建議使用 5 到 10 張清晰的單人圖片,或一段短片。Fizgig 配方則使用 8 張 1 百萬像素或 16 張 0.5 百萬像素的圖片。
RefMod 比 LoRA 好嗎?
它更快、檔案更小。訓練好的 LoRA 在相似度和特殊角度上仍然勝出,但對於接近參考素材的鏡頭,差異很小。
一次可以載入幾個?
Load H3 RefMods 節點最多有八個插槽,各自可設定強度。群體場景請每個角色各用一個檔案。
檔案要放在哪裡?
放在 ComfyUI/models/refmods/,然後在載入節點中選取,或讓資料夾載入器指向某個子資料夾。
可以複製聲音嗎?
目前還不可靠。在現有測試中,說話者身分的轉移並不穩定,而且未經本人同意,絕對不要使用他人的聲音。