VDN-H3 · OpenVDN · 開放權重
無審查 VDN MiniMax H3:生成比播放還快的 AI 影片
為了幾秒鐘的 AI 影片等上好幾分鐘,再好的興致也會被磨光。VDN MiniMax H3 徹底扭轉這個局面:在高效能伺服器上,一段含同步音效的 14 秒短片約 9 秒就能完成,影片在你看完之前就已經生成好了。它是 OpenVDN 研究團隊為開放的影片模型 MiniMax H3 打造的加速版本,畫面風格與聲音表現都維持不變。更棒的是,一款名為 FreeVideo 的桌面應用程式讓一般的遊戲電腦也能執行它。以下介紹這樣的速度對你有什麼意義、大家用它創作什麼、如何在家裡試用,以及馬上就能貼上使用的提示詞。
- 比播放還快
- 影片自帶音效
- 家用電腦就能跑
- 開放權重
還沒看完,短片就已經做好了
一句話就能說完它的承諾:製作影片的時間比播放的時間還短。在搭載八張頂級顯示卡的伺服器上,VDN-H3 的快速模式約 9 秒就能把一段提示詞變成 14.4 秒的寬螢幕短片,連音效都一併完成。背後的研究論文表示,這大約比同樣機器上的原版 H3 快 14.5 倍。
你不需要一整間機房也能感受到差別。在單張高階顯示卡上,原版模型生成一段短片需要將近 14 分鐘。新的高畫質模式把時間縮短到約 5 分鐘,快速模式更是不到一分鐘。這就是每次喝咖啡休息只能做出一個測試鏡頭,與同樣時間內勾勒出整個場景的差別。
| 版本 | 執行環境 | 生成一段 14 秒短片的時間 |
|---|---|---|
| 原版 H3 | 一張高階伺服器顯示卡 | 約 14 分鐘 |
| VDN 高畫質模式 | 同一張顯示卡 | 約 5 分鐘 |
| VDN 快速模式 | 同一張顯示卡 | 不到 1 分鐘 |
| VDN 快速模式(8 張顯示卡) | 八張伺服器顯示卡 | 約 9 秒 |
所列時間來自開發者在 NVIDIA B200 顯示卡上的自行測試,公布於 GitHub、專案部落格與論文中。
速度為你帶來的改變
速度聽起來像是工程師才在意的數字,但它其實改變了創作的感受。當草稿幾秒內就送到眼前,你不必再猜測提示詞會產生什麼效果,直接看就知道了。以下是這個模型為一般創作者帶來的好處。
十個點子,而不只一個
在過去生成一段短片的時間裡,嘗試不同的服裝、氛圍、運鏡與台詞,再留下你最喜歡的那一版。
聲音隨畫面一起到位
人聲、腳步聲、雨聲與現場環境音都以立體聲和畫面一起生成,不需要另外配音。
保留 H3 的質感
開發者形容成果與一般 H3 幾乎一樣:同樣的電影感畫面、同樣的對嘴效果,也同樣忠於你的提示詞。
自己的電腦就夠用
多虧了 FreeVideo 應用程式,搭載 8GB 顯示卡的遊戲電腦也能試試看,不需要工作室等級的設備。
不只幾秒鐘的故事
模型會記得短片前面發生過的事,因此一分鐘以上的影片成了實際可行的目標。
對所有人開放
權重與程式碼都已公開,社群也不斷為它加入應用程式、ComfyUI 節點與示範。
創作者用近乎即時的影片做些什麼
快速又自帶音效的影片,最適合需要大量短片而不是單一完美鏡頭的人。以下是它最能發揮的場景,從接案工作到純粹好玩都有。
短劇,一個鏡頭接一個鏡頭
用起始圖和結束圖鎖定角色,把多個鏡頭串在一起,每個都能很快預覽,再用高畫質模式精修最好的幾個。
直式廣告與商品短片
並排測試各種開場鉤子、台詞與商品角度,再把最適合你版面的那個版本發布出去。
會說話的肖像與活起來的作品
從一張靜態圖片開始,加上一句台詞和一些背景聲音,就能看著肖像、插畫或 AI 照片開口說話、動起來。
用各別的照片合成群體鏡頭
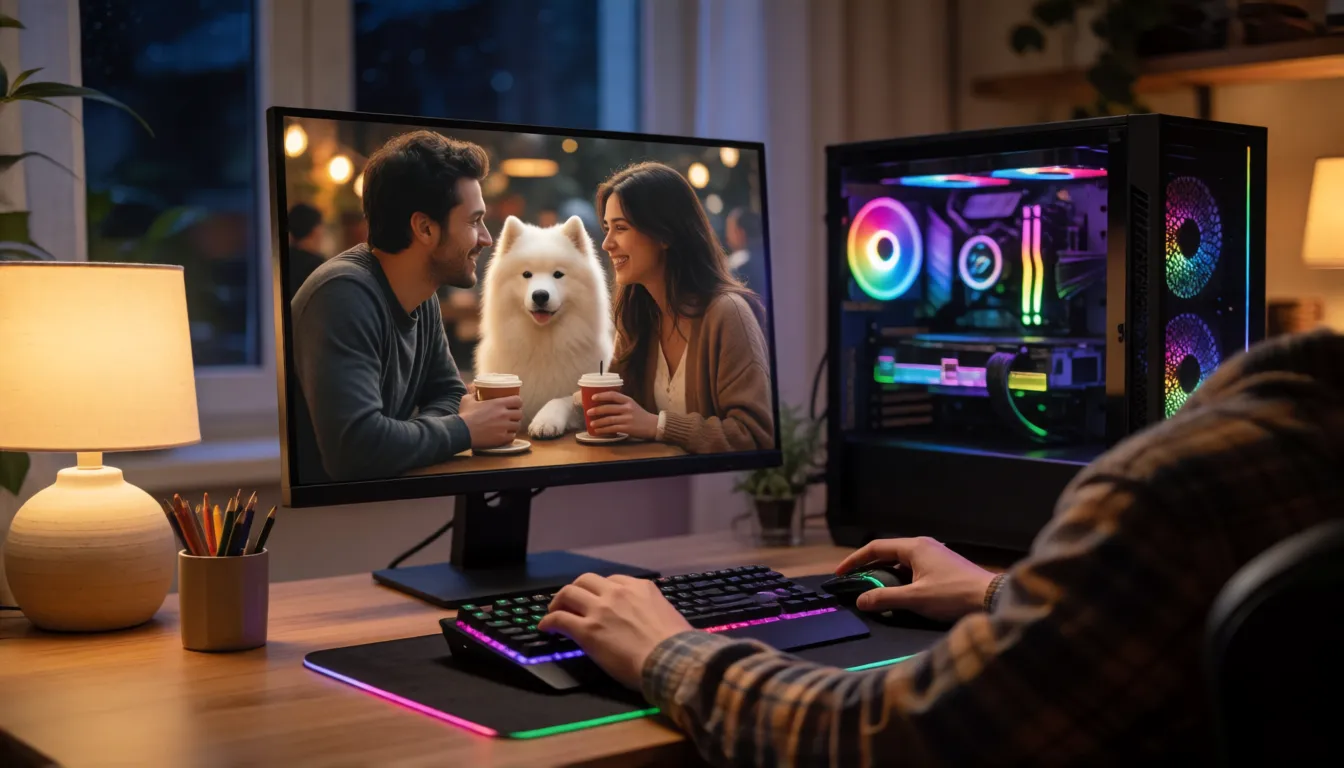
官方示範把來自不同參考圖的兩個人、一隻薩摩耶犬和一間咖啡館放進同一個動態場景,還加上了咖啡館的交談聲。
大型專案的分鏡腳本
電影創作者和遊戲編劇可以用一個下午排出一場戲,讓團隊看到會動的草稿,而不是一頁筆記。
虛擬主持人與直播用的循環片段
這篇論文的主題正是直播影片。接連不斷的短片很適合虛擬主持人和選擇式故事,不過目前仍在早期階段,值得你親自測試。
浪漫與魅力場景
穿著泳裝漫步海灘、燭光約會、慢舞:搭配原創成人角色(18 歲以上),快速出草稿讓你輕鬆找到對的氛圍。
迷因與祝福短片
把自拍或寵物照片變成一段短片,配上一句笑點或生日祝福,直接分享到聊天室。
近處仔細看,其餘靠記憶:為什麼這麼快
VDN MiniMax H3 由 OpenVDN 於 2026 年 9 月 6 日發布,這個團隊的研究人員來自 UC Berkeley、UT Austin 與 Impossible, Inc.。他們的論文名為 Video DeltaNet,從一個簡單的發現出發:原版模型有超過 85% 的時間,都花在把每一個畫格與所有其他畫格互相比對。這就像電影剪輯師每剪一刀之前,都要把整部電影重看一遍。
新的設計採用優秀剪輯師真正的工作方式。它只仔細查看緊鄰的畫格,其餘的部分則隨時記下簡短的筆記,所以故事從頭到尾依然說得通。第一個和最後一個畫格就像定位點,讓開場與結尾保持一致。文字與聲音仍然受到完整的處理,因此提示詞會被確實遵循,嘴型也對得上聲音。接著,快速模式再把繪製過程從 50 遍縮減到 8 遍。
快速草稿還是最終成品:如何選擇版本
有兩種版本可選。快速版只用 8 遍就能畫出一段短片,是團隊推薦日常使用的版本。高畫質版保留傳統的 50 遍,適合每個細節都很重要的最終算繪。聰明的習慣是先用快速模式探索點子,再用高畫質重做你最喜歡的那一個。
VDN-H3 和其他加速 H3 的方式相比如何?開發者表示,它的畫面幾乎與原版相同,並在畫質與指令遵循上都勝過 MiniMax FastH3。社群的 Turbo LoRA 只減少了繪製的遍數,而這個模型還改變了畫格的比對方式。這些是團隊根據並排範例得出的自身看法;目前沒有公布任何測試分數,所以請相信你自己的眼睛。
| VDN 快速模式 | VDN 高畫質 | H3 Turbo LoRA | MiniMax FastH3 | |
|---|---|---|---|---|
| 最適合 | 草稿與日常使用 | 最終算繪 | 加速一般的 H3 | MiniMax 自家的快速選項 |
| 省時的方式 | 更聰明的畫格比對 + 8 遍 | 更聰明的畫格比對 | 只減少遍數 | 獨立的快速版本 |
| 音效 | 有,立體聲 | 有,立體聲 | 有 | 有 |
| 額外下載 | H3 之外約 5.1GB | H3 之外約 4.3GB | 一個 LoRA 檔案 | 獨立權重 |
一分鐘影片與無限延續的故事鏈
單次執行可以得到約 14 秒的影片。由於模型是做筆記而不是重新檢查每一個畫格,把影片拉長不再讓等待時間暴增。2026 年 10 月 13 日發布的 FreeVideo 0.4.0 版表示可以產生超過一分鐘的影片。
有個在任何工具都適用的簡單做法:把故事寫成每章約 14 秒的段落,並在每一章開頭重複角色的外觀與地點,這樣主角就不會在中途換了件大衣。你也可以把一段短片的最後一個畫面當作下一段的第一個畫面。場景就會自然銜接,能像真正的劇集一樣剪輯在一起。
用 FreeVideo 在家裡的 8GB 遊戲 GPU 上執行
官方程式碼預設使用 RTX 4090 這類 24GB 顯示卡。FreeVideo 是 2026 年 10 月 2 日發布的開源桌面應用程式,大幅降低了門檻:它列出的最低需求為 8GB 顯示記憶體加上 16GB 系統記憶體,並會自動為你的顯示卡挑選合適的輕量設定。這讓 RTX 3060 也有機會執行這個模型。
老實說,目前沒有人公布過小顯示卡生成一段短片要花多久,所以請預期會比上述伺服器時間慢上許多。FreeVideo 支援 Windows 與 Linux,有 macOS 預覽版,也提供 ComfyUI 外掛。
- 1從 FreeVideo 的 GitHub 頁面下載適合你系統的版本,或安裝 ComfyUI 外掛。
- 2讓它下載模型檔案,並預留約 82GB 的磁碟空間。
- 3加入它要求的輔助檔案:文字編碼器、放大器與極速 LoRA。
- 4選擇快速模式,貼上提示詞,在嘗試長片之前先做一段短的測試片段。
- 5如果想要特別的風格,把社群 LoRA 放進應用程式的 LoRA 資料夾即可。
| 你的硬體 | 最簡單的方式 | 預期表現 |
|---|---|---|
| 8–12GB 顯示卡(例如 RTX 3060) | FreeVideo 應用程式 | 符合列出的最低需求;速度未公布 |
| 24GB 顯示卡(例如 RTX 4090) | FreeVideo 或官方程式碼 | 可以執行,約使用 20–22GB 記憶體 |
| 一張伺服器顯示卡 | 官方程式碼 | 快速模式下每段短片不到一分鐘 |
| 八張伺服器顯示卡 | SGLang 伺服器 | 每段短片約 9 秒 |
起始圖與結束圖,加上 ComfyUI 工作流程
除了純文字之外,VDN-H3 也能以圖片作為引導:首幀、尾幀、兩者同時使用(稱為 FL2VA),以及自 2026 年 9 月 17 日起,把多張參考照片放進同一個場景。首尾幀模式最受說故事的人喜愛。你決定鏡頭從哪裡開始、在哪裡結束,中間的動作與聲音則交給模型補上。
ComfyUI 使用者有兩個社群選項:現成的 t8star/Vdn-Minimax-H3-Comfy 檔案,以及 FreeVideo 外掛,通常會搭配放大器讓畫面更清晰。載入起始圖與結束圖,描述兩者之間發生的事,並在服裝與光線上使用和兩張圖相同的字詞。這樣轉場看起來就會很自然。
去哪裡下載,以及團隊如何提供服務
模型放在 Hugging Face 的 OpenVDN/vdn-minimax-h3,程式碼則在 GitHub。你需要約 72GB 的 MiniMax H3 基礎檔案,加上一個小型的 VDN 附加檔:快速版 5.1GB,高畫質版 4.3GB。第一次啟動時軟體需要幾分鐘做準備,之後就很快了。
想要達到九秒成績的工作室,會用 SGLang 在八張 GPU 上執行,這是專案原生支援的服務工具。這種配置目前可處理文字轉影片與首尾幀的工作。團隊也建議在生成之前,先讓 H3-Context-IR 這類提示詞輔助工具潤飾粗略的想法。
今天就能直接貼上的提示詞範本
這個模型偏好讀起來像導演筆記的提示詞:畫面裡有誰、依序做了什麼、鏡頭往哪裡移動、我們聽到什麼。以下範本遵循這個模式,並使用原創成人角色。
- 用 first、then、finally 依序描述動作;這個模型很擅長遵循順序。
- 把聲音放在最後,用 audio: 和 dialogue: 標示,讓人聲與背景聲音貼合場景。
- 長影片請寫成每章 14 秒,並在每一章重複角色外觀與地點。
- 先用快速模式打草稿,再用高畫質重做喜歡的作品。
通用含音效影片
[shot type], [subject and look], [action: first…, then…, finally…], [setting and light], [camera move], audio: [ambience], dialogue: "[line]"
短劇
Medium close-up, a young woman in a red trench coat stands under a neon-lit awning in the rain, she turns toward the camera and whispers, slow push-in, cinematic teal-orange grade, audio: rain on metal, distant traffic, dialogue: "You came back."
首幀與尾幀
From the first frame to the last frame, the character walks from the doorway to the window, camera tracks left smoothly, consistent outfit and lighting, soft room tone.
用多張照片合成群體鏡頭
[character A] and [character B] sit at the cafe table from reference 4, the Samoyed from reference 3 rests at their feet, they laugh and clink coffee cups, handheld warm look, cafe chatter.
泳池畔魅力鏡頭(18 歲以上)
Wide shot, an adult woman in a navy swimsuit walks along a sunlit pool, she turns toward the camera and smiles, slow dolly-in, golden hour light, audio: water splashing, soft summer music.
社群怎麼說
關注度迅速攀升。在本頁進行調查時,這個模型在 Hugging Face 上約有 360 個讚、一個月約 3,300 次下載,並有 22 個以它為基礎的社群示範,包括熱門的 minimax-h3-ultra-fast Space。它的 GitHub 頁面約有 670 顆星,FreeVideo 則已突破 2,800 顆。
大家對 VDN-H3 的情緒是興奮:單張顯示卡不到一分鐘就能出草稿,在家製作長影片也真的有了希望。最常見的抱怨是安裝設定,包括下載量大、要準備好幾個輔助檔案,還有早期版本的錯誤,從 FreeVideo 一長串尚未解決的問題回報就看得出來。畫質方面的回饋正面,但都是個人觀感,而不是實測分數。
無審查 VDN MiniMax H3:開放權重實際帶給你什麼
很多人會問,這個快速版本有沒有內建過濾機制。目前沒有特別的無審查版或 NSFW 版,開發者也沒有提到任何內建的內容過濾器。權重是開放的,並在你自己的電腦上執行,因此中間沒有線上審核,不過沒有人確切知道模型在訓練中學到了什麼。FreeVideo 可以載入社群 LoRA,但由於內部設計已經改變,現有的 H3 成人向 LoRA 是否仍能運作尚未經過測試。如果你想省去安裝設定,可以使用在瀏覽器中執行的無審查影片生成器,為原創成人(18 歲以上)角色製作影片。
不用下載大檔案,也不需要顯示卡:在線上讓你的成人原創角色靜態圖動起來。
開啟圖片轉影片無審查替代影片生成器
上傳一張靜態圖片,描述你想要的動作、鏡頭與聲音,就能在瀏覽器中取得一段短片。僅限成人(18 歲以上)原創角色。
開始生成自行架設 VDN MiniMax H3 vs 在 Spicy AI 線上生成
自己執行能讓你完全掌控,並享有快速模式的原始速度;線上方式則以此換來完全不必安裝設定。
| 本機部署(開放權重) | Spicy AI 線上版 | |
|---|---|---|
| 內容過濾 | 由你自行設定環境 | 對成人內容(18 歲以上)放寬過濾 |
| 開放權重 | 有,總計約 82GB | 不需要,直接在瀏覽器執行 |
| 使用的模型 | VDN 快速版或高畫質版 | 類似的雲端影片模型 |
| 如何開始 | 下載、安裝,加上一張夠力的顯示卡 | 打開頁面並上傳一張圖片 |
常見問題
VDN MiniMax H3 是什麼?
它是 OpenVDN 為開放的 MiniMax H3 影片模型打造的加速版。它運用名為 Video DeltaNet 的更聰明畫格比對方式,以及只需 8 遍的快速模式,從文字或圖片生成含音效的寬螢幕 768p 影片。
實際上有多快?
開發者表示,在八張伺服器顯示卡上,一段 14.4 秒的短片約需 9 秒,單張顯示卡則不到一分鐘。他們的論文稱它比原版 50 遍的 H3 快 14.5 倍。
畫面會變差嗎?
團隊根據並排比較的範例,形容它幾乎無損,且優於 MiniMax FastH3。目前尚未公布任何測試分數。
我的顯示卡跑得動嗎?
官方程式碼需要 24GB 顯示卡,約使用 20 到 22GB。FreeVideo 列出的最低需求為 8GB 顯示記憶體與 16GB 系統記憶體,但未公布小顯示卡的速度。
可以讓照片動起來,或使用首尾幀嗎?
可以。它能從文字、首幀、尾幀、兩者同時使用(FL2VA)或多張參考照片生成影片。八張 GPU 的 SGLang 配置只支援文字與首尾幀。
下載檔案有多大?
總計約 82GB:H3 基礎模型大約 72GB,加上 VDN 附加檔與輔助檔案。
有無審查版本嗎?
沒有專門的無審查版本。在家裡執行開放權重不會有線上過濾,而社群的 H3 LoRA 是否仍可使用,需要你自行測試。
資料來源
更多 MiniMax H3 與影片相關頁面
瀏覽所有無審查 AI 模型 →本頁提及的產品與專案名稱均屬於其各自的擁有者。所有角色都必須是成人(18 歲以上);未經本人同意,請勿製作真實人物的內容。