無審查 AI 影片 · MiniMax H3 社群合併模型
無審查 MiniMax H3 FL2VA Ref2VA 混合模型:記得住角色的清晰影片
MiniMax 把 H3 影片模型拆成兩個獨立的檢查點發布。FL2VA 畫面和聲音更乾淨,卻只看得懂首幀與尾幀;Ref2VA 能依照一整組參考照片、影片和聲音生成,但畫面偏糊。社群打造的 MiniMax H3 FL2VA Ref2VA 混合模型把兩者縫進同一個檔案,不論是短劇、穿搭短片還是動漫角色,都能在每個鏡頭間保持辨識度,同時不犧牲質感。以下帶你了解它能做什麼、該下載哪個檔案,以及怎麼寫提示詞。
- 角色一致性
- 原生音訊
- 開放權重
無審查替代影片生成器
圖片轉影片上傳一張角色照片當作首幀,描述動作、運鏡和聲音,就能變成一段短影片。
FL2VA 與 Ref2VA:同一個影片模型,兩種個性
H3 是 MiniMax 的 330 億參數音訊影片模型:同一個網路同時生成畫面與音軌,所以腳步聲、浪聲和對白一出來就是同步的。MiniMax 沒有推出一個包山包海的檔案,而是發布了兩個檢查點。FL2VA 接受文字提示詞加上零到兩張圖片,涵蓋純文字轉影片、首幀動畫、尾幀收尾,以及首尾幀之間的轉場。Ref2VA 則接受提示詞加上一組參考素材,最多 9 張圖片、3 段影片和 3 段音訊,總共最多 12 個檔案。
兩者預設都輸出 4 到 15 秒、每秒 24 幀、32 kHz 立體聲、短邊 768 像素的影片。問題在於,根據把兩者並排實測的社群作者說法,FL2VA 的畫質和音質明顯更好,但真正記得你的角色是誰的,卻是 Ref2VA。混合模型要解決的正是這個取捨。
| FL2VA | Ref2VA | |
|---|---|---|
| 輸入 | 文字 + 最多 2 幀(首幀、尾幀或兩者) | 文字 + 最多 9 張圖片、3 段影片、3 段音訊 |
| 擅長 | 乾淨的畫面與聲音、首幀到尾幀的運動 | 讓臉孔、服裝、場景和聲音保持一致 |
| 弱點 | 無法依照角色設定圖生成 | 依社群測試,畫質偏軟 |
| 典型用途 | 讓靜態圖動起來、銜接兩個關鍵幀 | 系列劇集、服裝展示、重複出現的場景 |
社群為什麼把兩者融合成一個混合模型
靈感來自逐一比對兩個檔案的權重。上傳者 smhfacct 發現兩者幾乎一模一樣,餘弦相似度至少 0.9997,真正的差異集中在每個 Transformer 區塊裡的一小層:adaln_proj 調變權重。把這些層從 Ref2VA 換進 FL2VA,模型就能借來參考能力,同時保留 FL2VA 大部分的畫面與聲音。
MiniMax H3 FL2VA Ref2VA 混合模型說穿了就是這樣:以 FL2VA 為底,把 Ref2VA 的調變層複製到選定範圍的區塊中。不重新訓練,也不做平均混合,只是精準移植。這是社群實驗,不是 MiniMax 官方發布,兩位作者也都表示自己的判斷偏主觀。即便如此,對想要 Ref2VA 的記憶力、又不想要它那份模糊的人來說,這是目前最直接的解法。
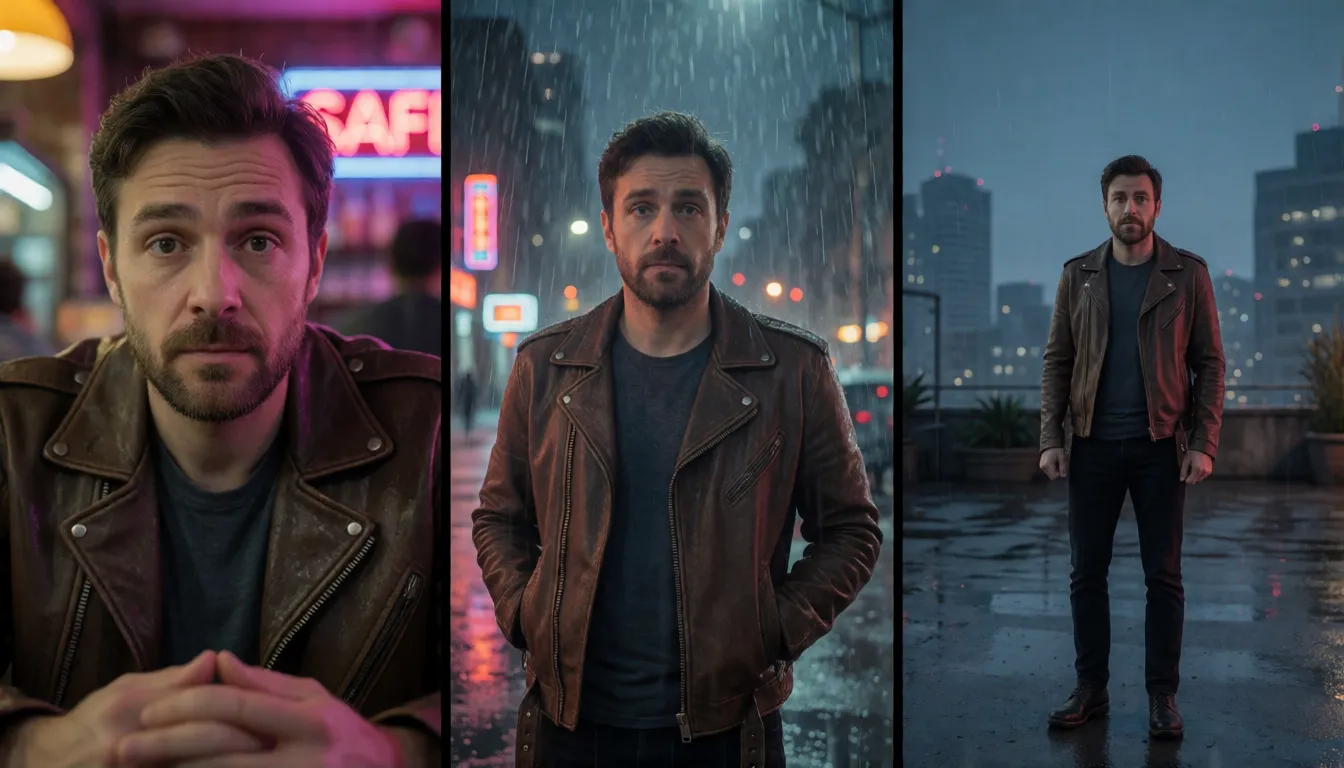
擅長的場景:系列劇、穿搭短片與重複場景
大家會去找 MiniMax H3 FL2VA Ref2VA 合併模型,就是為了角色一致性。短劇創作者只要放進一張大頭照和一張服裝照,就能拍出咖啡廳對峙、雨中街頭漫步和頂樓告別,主角始終是同一張臉。由於底模是 FL2VA,這些劇集也保有讓直式短劇看起來夠完整的銳利畫面與原生音效。
- 連續劇情與 AI 短劇:一張參考人像就能讓主角在每個場景、角度和光線變化中維持同一個樣子。
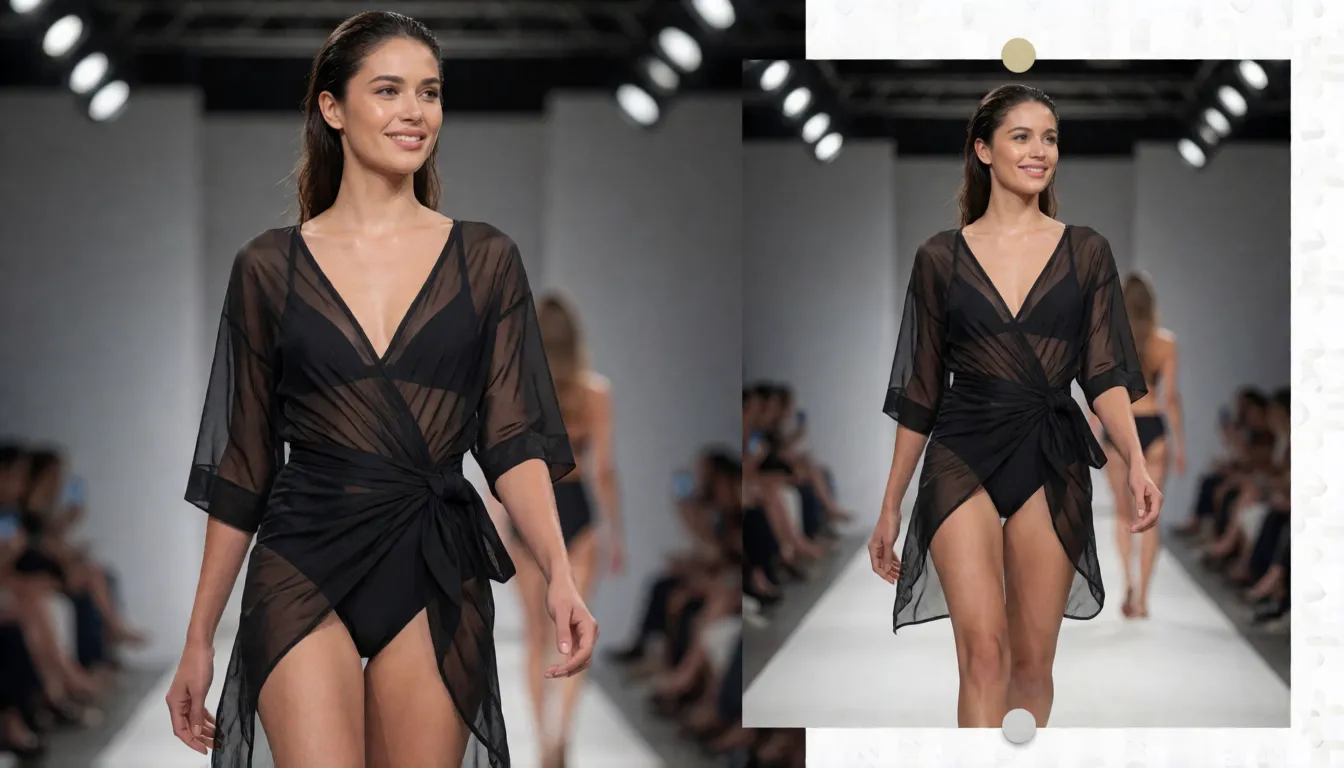
- 服裝與造型展示:把服裝當作一張參考、模特兒當作另一張,再描述伸展台轉身或緩慢旋轉。用參考強度較輕的檔案,可以讓衣服主導結果,又不會把鏡頭鎖死。
- 重複出現的場景:重複使用一張公寓、酒吧或海灘的照片,從不同位置生成新的 4 到 15 秒鏡頭。
- 聲音與音樂的連貫性:Ref2VA 接受 2 到 15 秒的音訊片段,所以角色的聲音或主題氛圍可以在多段影片中延續。混合模型保留了這個輸入,不過還沒有人做過效果評測。
- 成人(18+)造型:穿泳裝、內衣或比基尼的虛構成年角色,拍海灘、泳池與私房風短片,全部在你自己的電腦上執行。
b15 到 b49:挑選合適的混合檔案
每個檔名都告訴你哪些區塊換進了 Ref2VA 的層。範圍越廣,越會緊跟參考素材,畫面也越接近 Ref2VA 偏軟的質感;範圍越窄,保留越多 FL2VA 的精緻度。smhfacct 發布了四個建立在剪枝 int8 底模上的 int8 檔案,diobrando0 則發布了兩個未剪枝的 bf16 檔案,每個約 66.28 GB,只改動最後幾個區塊。
| 檔案 | 精度 | 參考強度 | 適合誰 |
|---|---|---|---|
| b15-49 | int8 | 最強 | 參考素材很多,能接受畫面稍軟 |
| b20-49 | int8 | 強 | 以參考為優先的專案 |
| b25-49 | int8 | 均衡 | 作者推薦的起點 |
| b30-49 | int8 | 中等 | 畫質優先 |
| b40-49 | bf16,約 66.28 GB | 輕(約 7.9% 的權重來自 Ref2VA) | 以全精度做細微引導 |
| b45-49 | bf16,約 66.28 GB | 最輕 | diobrando0 建議先試這個 |
最常被討論的是 b25-49 和 b30-49 怎麼選。先從 b25-49 開始;如果臉孔和服裝已經對上,想要更銳利的畫面,就退到 b30-49。反過來也一樣:參考素材被忽略,就換範圍更廣的;畫面糊掉或聲音變薄,就換範圍更窄的。
硬體方面,兩位作者都沒給出具體數字,只說記憶體需求與對應的 FL2VA 檔案相同。所以 int8 的 MiniMax H3 FL2VA Ref2VA 檔案和 int8 FL2VA 屬於同一級,而 66 GB 的 bf16 檔案實際上是工作站等級,單張消費級顯示卡很難應付。
用 AdaLN 合併腳本調出你自己的配方
diobrando0 在 bf16 檔案旁附上了 h3_adaln_merge.py。它會在你用 --lo 和 --hi 指定的區塊範圍內,把 Ref2VA 的 adaln_proj 權重逐位元組複製進 FL2VA 檔案,不做任何插值。它在 CPU 上幾分鐘內就能直接修補檔案,可以用 --backup 保留備份、用 --restore 還原,並以 BLAKE2b 雜湊檢查結果。
如果覺得 b40-49 太輕、b25-49 太重,這就很好用:試試 b35-49,看幾段影片再判斷,不喜歡就還原。記得保留原始的 Comfy-Org FL2VA 與 Ref2VA bf16 檔案,因為腳本需要兩者作為來源。
讓參考素材確實生效的提示詞範本
參考提示詞照固定順序寫效果最好:先說明哪個參考是什麼,接著是動作,再來是運鏡,最後是聲音。疊加的參考素材越多,b20-49 或 b25-49 這類範圍較廣的檔案就越划算。以下範本專為 MiniMax H3 FL2VA Ref2VA 混合模型撰寫,所有角色皆為成年人。
海灘換裝
參考圖 1 中的女性穿著參考圖 2 的紅色比基尼,在黃金時刻沿著海灘散步。中景,鏡頭緩緩推近,她回頭微笑。浪聲與輕柔的木吉他。
同一角色,新場景
參考圖 1 中的同一位男性坐在安靜的咖啡廳裡,側臉特寫。他輕聲說:「你遲到了。」自然窗光,35mm 底片質感,低沉的咖啡廳人聲。
伸展台轉身
參考圖 1 中的成年模特兒穿著參考圖 2 的黑色泳裝與透膚罩衫走在白色伸展台上,停下後緩緩轉身。全身跟拍鏡頭,閃爍的相機閃光燈,低沉的電子節拍。
重複出現的場景
在參考圖 1 的閣樓裡,參考圖 2 和 3 的情侶在夜晚的窗邊慢舞。廣角鏡頭緩緩移成雙人鏡頭,城市燈火,柔和爵士樂。
- 依照附加的順序,用編號稱呼每個參考素材。
- 每段影片只描述一個主要動作;4 到 15 秒一下就過了。
- 寫出你想要的聲音,台詞用引號框起來。
- 如果某個參考一直被忽略,先換檔案,再考慮改寫提示詞。
社群評價與坦白說的限制
在 MiniMax H3 FL2VA Ref2VA 的各種上傳中,大家最常討論的是 smhfacct 的 int8 套組:截至調查時約有 384 個讚、14 則討論串,還有 4 個以它為基礎的 Hugging Face Spaces。diobrando0 的 bf16 雙檔較新也較低調,有 7 個讚,日期為 2026 年 9 月 1 日。兩位作者都強調比較是用肉眼判斷,沒有正式評測,所以版本表請當成起點地圖,而不是鐵律。
限制很明確:沒有參考素材的提示詞,混合模型贏不了 FL2VA;區塊分界是實驗出來的;記憶體需求不會變小;而且 MiniMax 的 2K 精修階段沒有開源,所以本機輸出只能維持基礎解析度。
無審查 H3 混合模型:哪些不同、哪些一樣
合併過程不會移除或加入任何安全訓練,只是在兩個官方檢查點之間搬移調變層。真正改變體驗的是在哪裡執行。MiniMax 的雲端 API 會過濾色情、違法與侵權內容,而在自己電腦上跑開放權重則不會多出這層過濾,這也是成人創作者偏好本機 H3 的原因。沒有大顯卡也沒關係,這裡的圖片轉影片工具只要一張照片,就能生成類似、無過濾的成人(18+)場景動態。
在瀏覽器裡把角色照片變成 18+ 影片片段。
開啟圖片轉影片線上生成:Spicy AI 上免安裝的替代方案
不是每個人都有 66 GB 的工作站,或願意在多個檢查點之間來回切換。Spicy AI 提供同類短片的線上替代生成器:上傳一張角色照片,描述動作、鏡頭與聲音,就能直接在瀏覽器裡拿到一段短影片,不用下載、不用裝驅動,成人(18+)場景也沒有內容過濾。
它適合在漫長的本機算圖前先快速試拍、只用手機創作的人,以及只想要成品的人。從一張清楚的成年角色照片開始,每段只安排一個主要動作,並在每一集重複使用同一張照片,臉孔和服裝就能一直認得出來。
試用線上圖片轉影片生成器 →常見問題
FL2VA 和 Ref2VA 有什麼不同?
FL2VA 以文字加上最多兩張首幀或尾幀,生成有聲影片。Ref2VA 使用文字加上一組參考素材,最多 9 張圖片、3 段影片和 3 個音訊檔。社群測試者表示 FL2VA 的畫質和音質較好。
MiniMax H3 FL2VA Ref2VA 混合模型是 MiniMax 做的嗎?
不是。這是 smhfacct(int8)和 diobrando0(bf16)在 Hugging Face 上發布的社群合併模型,兩人都表示這屬於實驗性質,且是以肉眼判斷。
應該先下載哪個混合檔案?
int8 套組從 b25-49 開始,bf16 套組從 b45-49 開始。參考素材被忽略就換範圍更廣的,品質下降就換更窄的。
混合模型需要多少 VRAM?
作者只說 MiniMax H3 FL2VA Ref2VA 檔案與對應的 FL2VA 檔案相當。bf16 檔案約 66.28 GB,int8 檔案較小,目前沒有官方記憶體數據。
可以加速嗎?
可以。搭配 ref2v turbo 4 步 LoRA 就能快速出草稿,最終算圖時隨時可以拿掉 LoRA、跑完整步數。
資料來源
更多無審查 AI 影片模型
- 無審查 MiniMax H3
- 無審查 MiniMax H3 Max
- 無審查 Kling
- 無審查 Kling 2.6
- 無審查 Kling O1
- 無審查 Sora
- 無審查 Veo
- 無審查 Hailuo AI
- 無審查 Wan
- 無審查 Wan 3.0
- 無審查 Seedance
- 無審查 Seedance 2.5
- 無審查 Seedance 2.0
- 無審查 Seedance 2.0 Mini
- 無審查 HunyuanVideo
- 無審查 LTX Video
- 無審查 Runway
- 無審查 Pika
- 無審查 Luma Dream Machine
- 無審查 Vidu
- 無審查 PixVerse
- 無審查 EdenLive
- 無審查 Grok Imagine
- 無審查 AI Avatars
- 無審查 HappyHorse 1.0
- 無審查 Kling 4.0
- 無審查 Kling 3.0
- 無審查 MiniMax H3 RefMods
- 無審查 Kandinsky 6.0
MiniMax 與 H3 為其各自所有者的商標。混合檔案為社群作品。所有內容皆須描繪成年人(18+)。