Sprache-zu-Video · Offene Gewichte
Unzensiertes Kandinsky S2V 1.0 Pro: Jedes Foto sprechen, gestikulieren und singen lassen
Kandinsky S2V 1.0 Pro braucht drei einfache Dinge – ein einzelnes Foto, eine Aufnahme einer sprechenden Person und eine kurze Szenenbeschreibung – und liefert ein Video, in dem diese Person mit passenden Lippenbewegungen spricht, Hände und Schultern bewegt und von der ersten bis zur letzten Sekunde in ihrer Rolle bleibt. Es stammt von Kandinsky Lab, dem Team hinter Kandinsky 5.0 und 6.0, und die Gewichte können kostenlos heruntergeladen werden. Dieser Leitfaden zeigt, wofür Creator es einsetzen, warum die Ergebnisse natürlich wirken, welche Version zu deiner GPU passt, Prompts zum Kopieren und wie es sich im Vergleich mit anderen offenen Talking-Avatar-Modellen schlägt.
- Foto + Stimme → Video
- Ganzer Körper, nicht nur ein Gesicht
- 25 fps, beliebige Länge
- Schnelle 16-Schritt-Version
Unzensierter alternativer Videogenerator
Bild zu VideoWie Kandinsky S2V 1.0 Pro startet er mit einem Porträt: Lade es hoch, beschreibe, wie sich die Person bewegen soll und wie die Szene aussieht, und wir öffnen das Bild-zu-Video-Studio mit allen Angaben bereits ausgefüllt. Erwachsenenthemen sind willkommen, sofern alle gezeigten Personen 18+ sind.
Ein Foto, eine Sprachaufnahme, eine ganze Performance
Die meisten Talking-Photo-Tools animieren nur ein Gesicht: Der Mund öffnet und schließt sich, während der Rest des Bildes eingefroren bleibt. Kandinsky S2V 1.0 Pro arbeitet anders. Du gibst ein Referenzbild, eine saubere Sprachaufnahme (16 kHz mono) und einen Text-Prompt vor, und es erzeugt ein Video mit 25 fps, in dem die ganze Person lebendig wird. Die Lippen folgen jeder Silbe, die Hände machen die Gesten, die Menschen beim Erklären verwenden, und der Hintergrund verhält sich so, wie dein Prompt es beschreibt. Das Ergebnis behält das Seitenverhältnis deines Fotos und enthält deine Original-Tonspur, sodass der Clip direkt veröffentlicht werden kann.
Auch die Länge ist nicht festgelegt. Kandinsky S2V 1.0 Pro arbeitet in Fünf-Sekunden-Blöcken mit 125 Frames, und jeder neue Block setzt dort an, wo der vorherige aufgehört hat – so wird aus einem zweiminütigen Voice-over ein zweiminütiges Video derselben Person. Die Lippensynchronität fällt als Erstes auf: Jeder Videoframe hört nur auf seinen eigenen Ausschnitt des Audios, weshalb die Mundformen genau auf dem richtigen Laut landen, statt hinterherzuhinken.
Wo sprechende Videos aus einem einzigen Foto gerade durchstarten
Sprachgesteuerte Avatare sind von Tech-Demos in die alltägliche Content-Arbeit gewandert, und Kandinsky S2V 1.0 Pro passt genau dorthin. Die folgenden Aufgaben werden im Forschungspaket und in Creator-Communities am häufigsten genannt, und sie alle haben eines gemeinsam: eine glaubwürdige Person vor der Kamera, die genau das sagt, was dein Audio sagt – ohne Studio oder Moderator buchen zu müssen.
- Kurzdramen und animierte Comics: Gib jedem Charakterporträt seine Dialogspur und erhalte Ganzkörper-Dialogszenen, die wie echte Szenen wirken, nicht wie Sticker.
- Produkt- und Live-Commerce-Clips: Ein Modelfoto plus eine aufgenommene Produktpräsentation wird in Minuten zu einem Erklärvideo im Moderatorenstil.
- Kurse, Nachrichtenrückblicke und Schulungen: Mach aus einem Sprechertext eine lange Vorlesung mit einer virtuellen Lehrkraft, die minutenlang gestikuliert.
- Virtuelle Streamer und KI-Begleiter: Kombiniere ein Charakterbild mit einer Text-to-Speech-Stimme, und die Figur antwortet vor der Kamera.
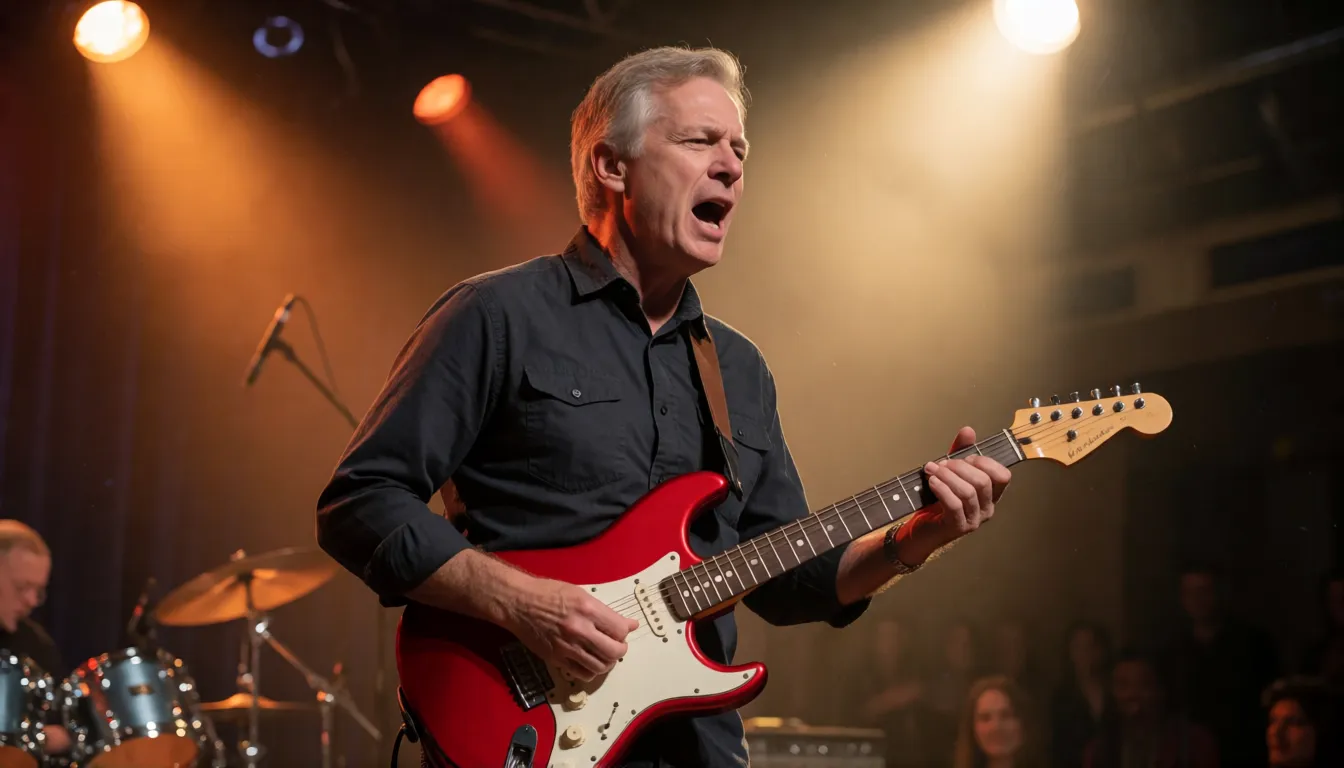
- Musik und Podcasts: Das offizielle Diffusers-Beispiel zeigt einen grauhaarigen Mann mit einer roten E-Gitarre – ein Hinweis darauf, dass Performance-Clips möglich sind (die Gesangsqualität wurde vom Team nicht gebenchmarkt).
- Mehrsprachige Synchronisation: Behalte ein Foto und tausche Tonspuren in verschiedenen Sprachen aus; die Trainingsbeschriftungen waren Englisch und Russisch, also teste andere Sprachen vor einem großen Projekt.
Dialoge für Kurzdramen
Gib jedem Charakterporträt seine Dialogzeile, und Kandinsky S2V 1.0 Pro liefert Ganzkörperszenen mit präziser Lippensynchronität.
Produkt-Erklärvideos
Ein Modelfoto und eine aufgenommene Präsentation werden zu einem Clip im Moderatorenstil für Shops und Live-Commerce.
Virtuelle Moderatoren
Kombiniere ein Charakterbild mit einer TTS-Stimme für Streamer, Lehrkräfte und KI-Begleiter, die antworten.
Warum die Ergebnisse natürlich wirken
Drei Designentscheidungen unterscheiden Kandinsky S2V 1.0 Pro von den vielen Lip-Sync-Tools davor. Erstens ist es Ganzkörperanimation: Das Modell baut auf Kandinsky 5.0 Video auf, weiß also bereits, wie sich Körper, Kleidung und Szenen bewegen, und der Prompt kann Gesten und Umgebung steuern. Zweitens versteht es sowohl die Worte als auch die Stimme: Qwen2.5-Omni liest deinen Text-Prompt und hört die Sprache mit 25 Tokens pro Sekunde, was hilft, die Bewegung an die Energie des Vortrags anzupassen. Drittens trägt ein dreistufiges Gedächtnis das Aussehen des Referenzfotos von Block zu Block weiter, sodass Gesichter und Outfits auch in langen Takes konsistent bleiben.
Kandinsky S2V 1.0 Pro gibt es auch als destillierte Edition. Pro distill erreicht sein Ergebnis in 16 statt 50 Schritten und backt das Guidance direkt in die Gewichte ein; laut Team ist das etwa fünfmal schneller (je nach Setup zwischen 4,5× und 5,6×), bei nahezu gleichen Werten wie das Basismodell in fast allen Metriken. In der menschlichen Bewertungsstudie des Papers gegen die stärkste offene Baseline und zwei kommerzielle Dienste wurde Kandinsky S2V 1.0 Pro im Durchschnitt als gleichwertig oder besser bewertet, wobei die Lippensynchronität am meisten bevorzugt wurde.
- Ganzkörperbewegung und Szenensteuerung per Text-Prompt
- Framegenaue Lippensynchronität durch Audio-Attention pro Frame
- Keine harte Längenbegrenzung dank blockweiser Fortsetzung
- Offene Gewichte unter MIT-Lizenz, läuft lokal
- Benötigt eine 48-GB-GPU für das Pro-Modell (80 GB für HD)
- Erzeugt keinen Ton, du bringst deine eigene Stimme oder TTS mit
- Noch kein offizieller quantisierter Build für 24-GB-Karten
- Der HD-Modus wurde in dieser Auflösung weder trainiert noch evaluiert
Lite oder Pro, Base oder Distill: Die passende Version wählen
Kandinsky S2V 1.0 Pro gehört zu einer Familie von vier Checkpoints. Die 2B-Lite-Modelle sind die schnelle, leichtere Option; die 21B-Pro-Modelle liefern die besten Gesichter, Hände und Bewegungen. Innerhalb jeder Größe ist die destillierte Edition die Wahl für den Alltag, und das 50-Schritt-Basismodell ist für alle, die das letzte bisschen Detail herausholen wollen. Beide Pro-Checkpoints können außerdem eine HD-Konfiguration mit 1280×768 ausführen.
| Version | Größe und Schritte | Geeignet für | Geschwindigkeit auf einer H100 (pro Sekunde Video) |
|---|---|---|---|
| Lite 2B distill | 2B, destilliert | Schnelle Entwürfe, kleinere GPUs | Etwa 8,7 s |
| Lite 2B | 2B, Basis | Lite-Qualität ohne Destillation | Langsamer als Lite distill |
| Pro 21B distill | 21B, 16 Schritte | Beste Balance für den Alltag | Etwa 41,5 s (33,6 s kompiliert) |
| Pro 21B | 21B, 50 Schritte | Maximale Detailtreue, unterstützt negative Prompts | Etwa 189 s |
| Pro distill HD | 21B, 1280×768 | Größere Frames (Qualität ungetestet) | Etwa 137 s |
GPU-Speicher und Geschwindigkeit: Was dich erwartet
Kandinsky S2V 1.0 Pro ist ein großes Modell, also plane deine Hardware, bevor du rund 65 GB an Dateien herunterlädst. Offiziell wird eine einzelne GPU mit mindestens 48 GB Speicher (80 GB für HD) und eine Treiberversion ab 580 verlangt. Auf einer H100 liegt Pro distill in Standardauflösung bei einem Spitzenwert von etwa 46 GiB; HD bei etwa 55 GiB. Ein zehnsekündiger Clip dauert daher auf einer Karte rund sechs bis sieben Minuten, und das offizielle Setup mit acht GPUs senkt die Zeit pro Videosekunde auf etwa 11 Sekunden.
Zu wenig Speicher? Mit aktiviertem VAE-Tiling sinkt der Spitzenwert auf etwa 28 GB, allerdings mit leichten Nahtstellen; der Diffusers-Weg mit CPU-Offload erreicht knapp 50 GiB, und das Modell Lite 2B distill ist der einfachste Weg, auf einer kleineren Karte zu experimentieren. Eine Cloud-GPU für einen Nachmittag zu mieten, ist die übliche Lösung für 24-GB-Consumer-Karten, da es noch keine offiziellen quantisierten Dateien gibt.
Drei Wege zum Ausprobieren: Online-Demo, ComfyUI und Diffusers
Du musst nichts installieren, um zu sehen, was Kandinsky S2V 1.0 Pro kann. Das Team hostet einen kostenlosen Demo-Space auf Hugging Face, und es gibt Colab- und Kaggle-Notebooks für alle, die etwas mehr Kontrolle wollen. Wenn du es selbst ausführen möchtest, wähle den Weg, der zu deiner Arbeitsweise passt.
- 1Online: Öffne den Space Kandinsky-S2V-1.0-Demo auf Hugging Face, lade ein Porträt und eine kurze WAV-Datei hoch, füge einen Prompt hinzu und starte die Generierung.
- 2Kommandozeile: Klone das GitHub-Repo kandinsky-s2v, führe uv sync aus, dann uv run kandy-s2v generate mit der Konfiguration s2v_pro_distill.yaml und deinen Pfaden für --audio, --image und --out; ergänze --prompt und --seed, um Ergebnisse zu steuern und zu reproduzieren.
- 3ComfyUI: Wechsle in den Branch dev/comfyui des Repos, der Nodes für Lite distill und Pro distill mitbringt, und verbinde Bild, Audio und Prompt mit dem Sampler.
- 4Diffusers: Installiere diffusers aus dem main-Branch, lade kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers mit ModularPipeline und lies dein Audio mit 16 kHz ein.
Welchen Weg du auch wählst: Kandinsky S2V 1.0 Pro belohnt gute Eingabedateien mehr als jede Einstellung. Beachte Folgendes:
- Verwende ein scharfes, frontales Foto, auf dem die Person einen großen Teil des Bildes ausfüllt; sein Seitenverhältnis wird zu dem des Videos.
- Nimm saubere Sprache ohne Hintergrundmusik auf und speichere sie als 16-kHz-Mono-Audio.
- Fixiere den --seed, sobald dir ein Ergebnis gefällt, und ändere dann nur den Prompt, um Varianten zu erkunden.
Prompt-Vorlagen für sprechende Videos
Bei Kandinsky S2V 1.0 Pro enthält der Text-Prompt nicht das Skript – das übernimmt dein Audio. Nutze den Prompt, um die Person, ihre Bewegung, die Umgebung und die Kamera zu beschreiben, und halte Kleidung und Hintergrund nah am Referenzfoto, damit der Look nicht abdriftet. Diese Vorlagen decken die beliebtesten Formate ab; tausche die Details aus und behalte die Struktur bei.
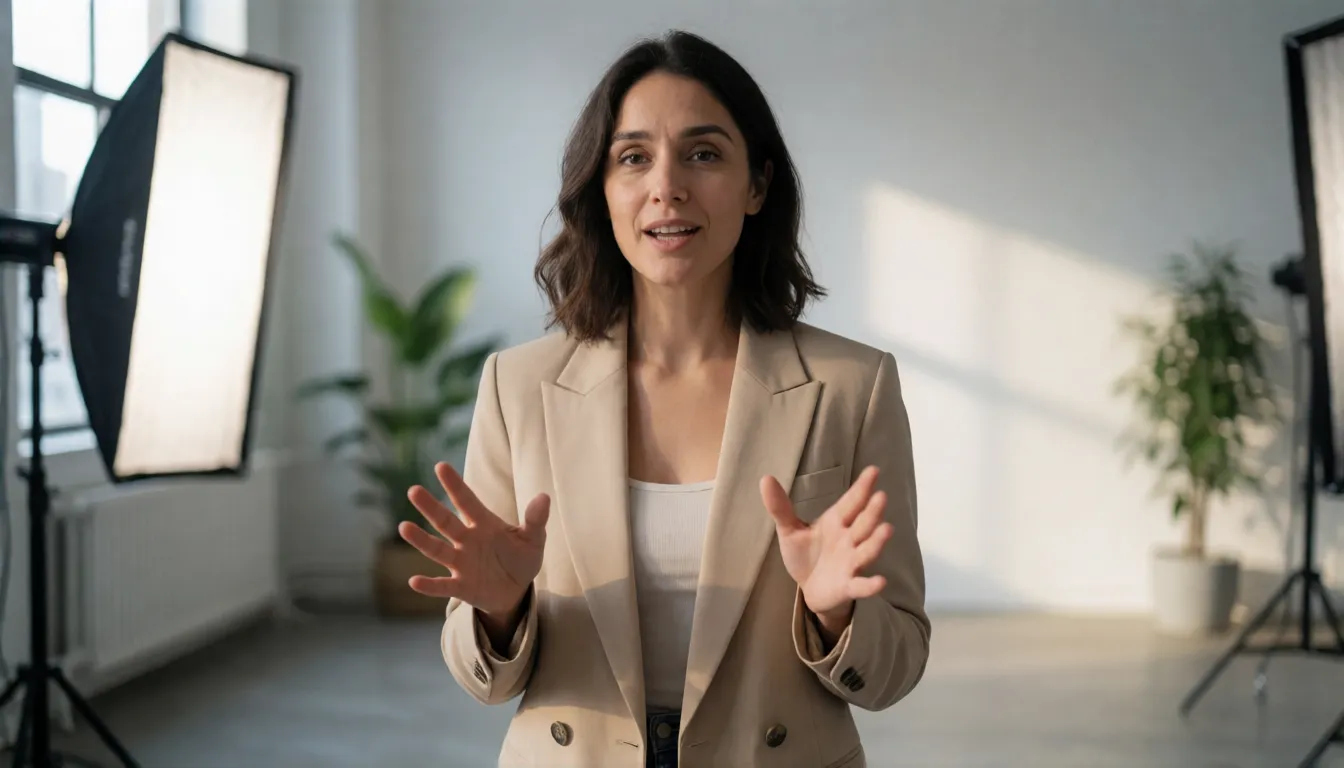
- Moderatorin: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
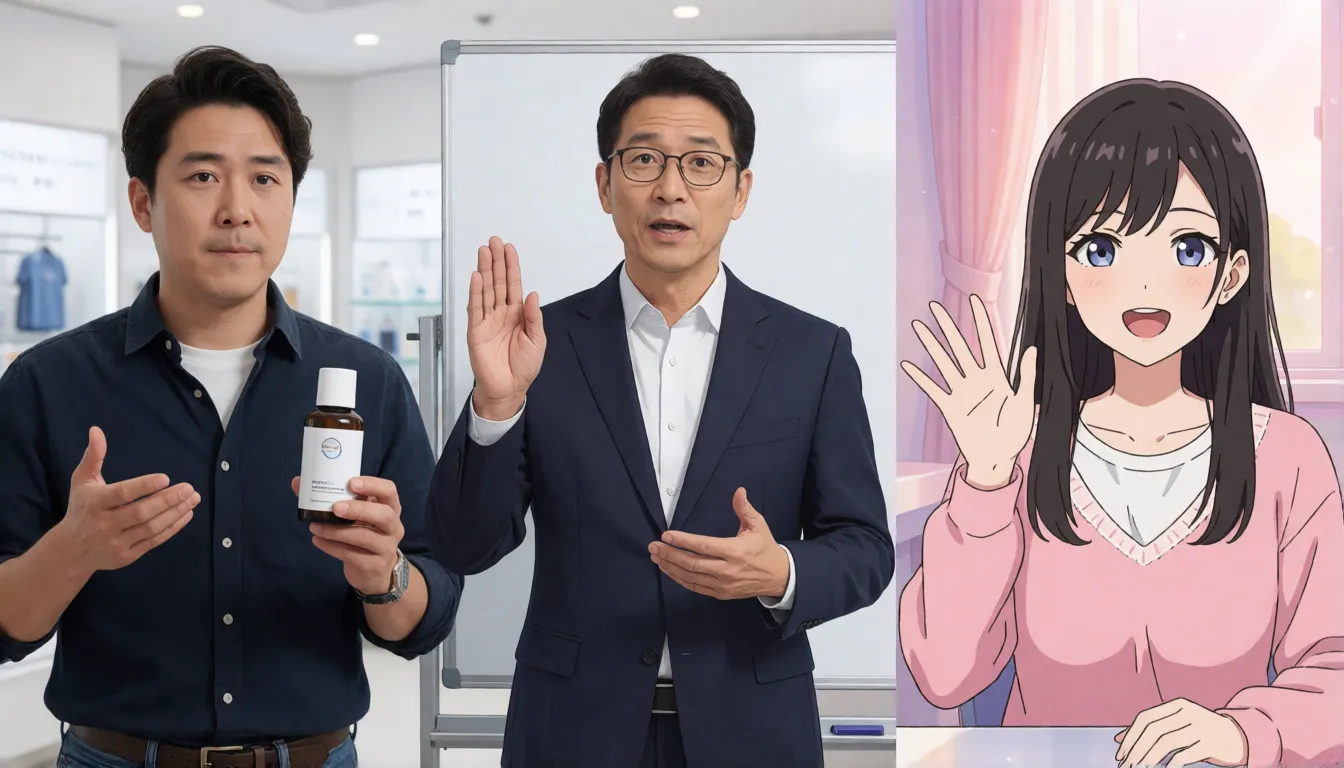
- Produktpräsentation: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- Drama-Dialog: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- Musiker: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- Lehrkraft: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- Virtuelle Streamerin: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- Strandgespräch (18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- Negativer Prompt (nur 50-Schritt-Modell): blurry face, distorted mouth, extra fingers, flickering, static body.
Vergleich mit Wan 2.2 S2V, InfiniteTalk und anderen offenen Avataren
Offene Talking-Avatar-Modelle haben sich vervielfacht, und jedes hat neben Kandinsky S2V 1.0 Pro eine andere Stärke. Wan2.2-S2V-14B von Alibaba hat bereits GGUF-Dateien aus der Community und ist damit freundlicher für kleinere GPUs. InfiniteTalk und MultiTalk konzentrieren sich auf sehr lange Videos und Gespräche mit mehreren Personen. LongCat-Video-Avatar 1.5 hat ebenfalls GGUF-Builds für ComfyUI. Kandinsky S2V 1.0 Pro sticht durch seine freizügige MIT-Lizenz, textgesteuerte Ganzkörperbewegung und das destillierte 16-Schritt-Release hervor; seine Schwachstellen sind derzeit die hohe Speicheranforderung und ein noch junges Community-Ökosystem. Das Paper nennt seine Baselines nicht, also betrachte direkte Vergleiche als unbestätigt und teste mit deinen eigenen Clips.
| Modell | Stärke | Am einfachsten auf kleineren GPUs? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | Ganzkörperbewegung, textgesteuerte Szenen, 16-Schritt-Distill | Nur Lite; Pro benötigt 48 GB |
| Wan2.2-S2V-14B | Ausgereiftes Ökosystem, kinoreife Bewegung | Ja, Community-GGUF |
| InfiniteTalk / MultiTalk | Sehr lange Clips, Dialoge mit mehreren Personen | Abhängig vom Setup |
| LongCat-Video-Avatar 1.5 | Avatar-Video mit ComfyUI-Unterstützung | Ja, Community-GGUF |
Unzensierte sprechende Avatare: Was heute möglich ist
Es gibt noch kein offizielles oder Community-Fine-Tune von Kandinsky S2V 1.0 Pro ohne Zensur. Die offenen Gewichte laufen lokal ohne Online-Moderationsschicht, aber die Trainingsdaten bestehen aus Aufnahmen einzelner sprechender Personen, daher wurde das Modell nicht für Erwachsenenszenen gebaut, und die Model Card bittet darum, nur Personen zu animieren, die zugestimmt haben. Wenn du ein Foto ohne Installation sprechen, flirten oder in Bademode oder Dessous posieren lassen möchtest – für fiktive Figuren ab 18 –, kannst du in unserem Bild-zu-Video-Studio ein Porträt hochladen, die Bewegung beschreiben und direkt im Browser generieren.
Animiere ein Charakterporträt (18+) im Browser, ganz ohne GPU.
Bild zu Video starten →Kandinsky S2V 1.0 Pro selbst hosten vs. online bei Spicy AI generieren
| Lokale Bereitstellung (offizielle Gewichte) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Kein Online-Filter, wenn du es selbst betreibst | Erwachseneninhalte (18+) erlaubt |
| Offene Gewichte | Ja, MIT-Lizenz auf Hugging Face | Nicht zutreffend, läuft online |
| Tatsächlich verwendetes Modell | Kandinsky S2V Lite oder Pro | Eigene Videomodelle von Spicy AI |
| Preis | Kostenlose Gewichte, du zahlst für die GPU | Kostenlos starten, Credits für mehr |
- Lokal: sprachgesteuerte Lippensynchronität aus deinem eigenen Audio, unbegrenzte Länge, volle Kontrolle.
- Spicy AI: Starte mit einem Foto und animiere es im Browser, keine Hardware nötig.
Häufig gestellte Fragen
Was ist Kandinsky S2V 1.0 Pro?
Kandinsky S2V 1.0 Pro ist ein Sprache-zu-Video-Modell mit 21 Milliarden Parametern von Kandinsky Lab. Du gibst ein Referenzfoto, eine Sprachaufnahme und einen Text-Prompt vor, und es erzeugt ein sprechendes Ganzkörpervideo mit 25 fps und Lippensynchronität. Die Gewichte sind unter einer MIT-Lizenz offen.
Was ist der Unterschied zwischen Pro und Pro distill?
Beide haben 21B Parameter. Die Distill-Version nutzt pi-Flow-Destillation, um in 16 statt 50 Schritten fertig zu werden, und backt das Guidance in die Gewichte ein. Dadurch ist sie etwa fünfmal schneller und erreicht in fast allen Metriken Werte nahe am Basismodell.
Wie viel GPU-Speicher braucht Kandinsky S2V 1.0 Pro?
Das Team empfiehlt eine einzelne GPU mit mindestens 48 GB (80 GB für HD). Pro distill erreicht in Standardauflösung einen Spitzenwert von etwa 46 GiB; VAE-Tiling senkt das auf rund 28 GB mit leichten Nahtstellen. Einen offiziellen quantisierten Build gibt es noch nicht.
Wie lang können Videos mit Kandinsky S2V 1.0 Pro sein?
So lang wie dein Audio. Das Modell erzeugt Fünf-Sekunden-Blöcke und setzt jeden am vorherigen fort. Auf einer H100 dauert eine Sekunde Video in Standardauflösung mit Pro distill etwa 41,5 Sekunden.
Erzeugt Kandinsky S2V 1.0 Pro auch die Stimme?
Nein. Du lieferst die Sprache, entweder eine echte Aufnahme oder Text-to-Speech, und das fertige Video enthält diese Original-Tonspur.
Gibt es eine Online-Demo oder ComfyUI-Unterstützung?
Ja. Kandinsky Lab hostet einen Demo-Space auf Hugging Face, der Branch dev/comfyui des GitHub-Repos ergänzt ComfyUI-Nodes für Lite distill und Pro distill, und Diffusers-Unterstützung ist im main-Branch verfügbar.
Gibt es ein unzensiertes Kandinsky S2V 1.0 Pro?
Stand November 2026 nicht: Es wurde kein offizielles oder Community-Fine-Tune ohne Zensur veröffentlicht. Du kannst die offenen Gewichte selbst ausführen oder einen Online-Bild-zu-Video-Generator nutzen, der fiktive Inhalte ab 18 erlaubt.
Quellen
- Model Card Kandinsky-S2V-1.0-Pro-distill (Hugging Face)
- Model Card Kandinsky-S2V-1.0-Pro-distill-Diffusers (Hugging Face)
- Basismodell Kandinsky-S2V-1.0-Pro (Hugging Face)
- Online-Demo Kandinsky S2V 1.0 (Hugging Face Space)
- Repository kandinskylab/kandinsky-s2v (GitHub)
- Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation (arXiv)
- Projektseite Kandinsky Avatar
- Wan2.2-S2V-14B GGUF (Hugging Face)
Weitere Leitfäden zu unzensierten Videomodellen
- Unzensiertes Kandinsky 6.0
- Unzensiertes Kling
- Unzensiertes Kling 2.6
- Unzensiertes Kling O1
- Unzensiertes Sora
- Unzensiertes Veo
- Unzensiertes Hailuo AI
- Unzensiertes MiniMax H3 Max
- Unzensiertes Wan
- Unzensiertes Wan 3.0
- Unzensiertes Seedance
- Unzensiertes Seedance 2.5
- Unzensiertes Seedance 2.0
- Unzensiertes Seedance 2.0 Mini
- Unzensiertes HunyuanVideo
- Unzensiertes LTX Video
- Unzensiertes Runway
- Unzensiertes Pika
- Unzensiertes Luma Dream Machine
- Unzensiertes Vidu
- Unzensiertes PixVerse
- Unzensiertes EdenLive
- Unzensiertes Grok Imagine
- Unzensiertes AI Avatars
- Unzensiertes HappyHorse 1.0
- Unzensiertes MiniMax H3 FL2VA Ref2VA
- Unzensiertes Kling 4.0
- Unzensiertes Kling 3.0
- Unzensiertes MiniMax H3 RefMods
- Unzensiertes Looking Ahead
- Unzensiertes TaoMate-H3
- Unzensiertes SANA-Video 2.0
- Unzensiertes MiniMax H3 Remix
- Unzensiertes Sora 2
- Unzensiertes Wan 2.6
- Unzensiertes LTX-2.5 Slow Motion
- Unzensiertes VDN MiniMax H3
Spicy AI ist eine unabhängige Website und steht in keiner Verbindung zu Kandinsky Lab oder Sber. Alle Inhalte dürfen ausschließlich Erwachsene (18+) zeigen; animiere keine realen Personen ohne deren Zustimmung.