MiniMax H3 · Referenz-Adapter aus der Community
MiniMax H3 RefMods: Derselbe Star in jeder Einstellung, ganz ohne Training
Jeder KI-Videocreator kennt das Problem: In der ersten Einstellung sieht die Heldin perfekt aus, doch spätestens in der dritten verändert sich ihr Gesicht. MiniMax H3 RefMods lösen das mit einem Trick aus der LoRA-Kultur. Du gibst einmalig ein paar Fotos, einen kurzen Clip oder eine Audioprobe in ComfyUI ein und erhältst eine winzige Datei von etwa 1 bis 1,6 MB, die sich merkt, wer dein Charakter ist. Binde sie in einen beliebigen MiniMax-H3-Video-Workflow ein, und dasselbe Gesicht, Outfit oder derselbe Kunststil kehrt auf Abruf zurück – ganz ohne Modelltraining. Unten erfährst du, was sie leisten, wo Creator sie einsetzen, wie die Einrichtung Schritt für Schritt funktioniert, findest Prompt-Vorlagen und eine ehrliche Liste dessen, was noch nicht klappt.
- Kein Training
- Dateien ~1–1,6 MB
- Bis zu 8 Slots
- ComfyUI + Fizgig
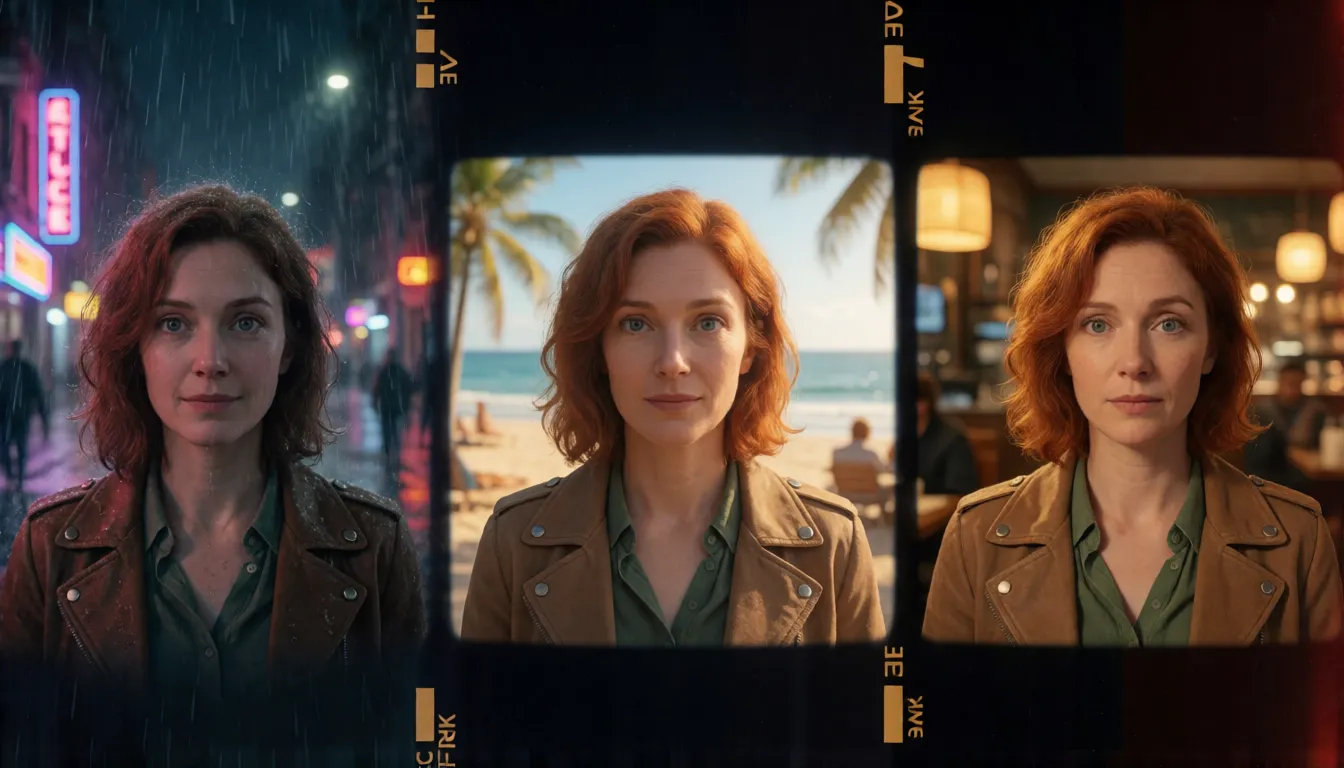
Ein ganzer Charakter in einer winzigen Datei
MiniMax H3 RefMods, kurz für Reference Latent Adapters, sind ein Community-Format für das Open-Weight-Audio-Video-Modell H3. Stell dir eine solche Datei wie ein gespeichertes Casting vor: Statt jedes Mal dieselben Referenzbilder hochzuladen und mit <Picture 1>-Positions-Tags zu jonglieren, kodierst du sie einmal durch den VAE und speicherst das Ergebnis als .safetensors-Datei. Später lädst du sie genau wie eine LoRA, und sie wird während der Videogenerierung in den Referenz-Conditioning-Stream von H3 eingespeist. An den Gewichten von H3 selbst wird nichts neu trainiert, daher dauert die Erstellung Minuten statt Stunden.
Das Format und seine Nodes stammen aus dem Paket ComfyUI-MiniMaxH3Mod des Entwicklers @Luisacaotica, veröffentlicht unter der MIT-Lizenz. Es handelt sich um ein Community-Projekt, nicht um ein Produkt von MiniMax, und die README weist noch darauf hin, dass es sich im Aufbau befindet – Node-Namen und Eingänge können sich also zwischen Releases ändern. Gebremst hat das niemanden: Das Repository knackte wenige Wochen nach dem Start die Marke von 500 GitHub-Sternen.
| Einstellung | Funktion | Ideal für |
|---|---|---|
| Full Reference (Kodierung) | Behält jedes kodierte Detail, verbraucht mehr Tokens | Gesichter und Outfits, die gestochen scharf sein sollen |
| Compressed Reference | Bündelt die Referenz, um Tokens zu sparen, verliert etwas Detail und Bewegung | Lange Clips oder viele gestapelte Dateien |
| Preset identity_encode | Erfasst, wer eine Person oder ein Charakter ist | Wiederkehrende Helden, Moderatoren und Maskottchen |
| Preset style_experimental | Packt einen Look in ein 8×8-Raster | Serien mit einheitlichem Color Grading oder Kunststil |
| Preset motion_sequence | Speichert die Bewegung eines kurzen Clips | Wiederverwendung eines Tanzes, Gangs oder einer Geste |
Wo Creator Referenz-Adapter einsetzen
Der Reiz von MiniMax H3 RefMods ist einfach: eine Datei, endlos viele Episoden. Creator, die früher für jedes wiederkehrende Gesicht eine LoRA trainiert haben, bauen sich jetzt eine kleine Bibliothek aus Charakteren, Stilen und Bewegungen auf und kombinieren sie pro Einstellung. Diese Einsatzzwecke tauchen in Community-Threads und geteilten Workflows am häufigsten auf.
Kurzserien und KI-Comics
Nutze eine originale Hauptfigur in Dutzenden Einstellungen. Ändere Ort, Kamerafahrt und Handlung, während das Gesicht von Episode zu Episode gleich bleibt.
Virtuelle Moderatoren und eigene IP
Fixiere ein Maskottchen oder einen virtuellen Moderator in einer einzigen Datei und veröffentliche wöchentlich Clips, ohne dass der Look langsam von der Marke abdriftet.
Mode- und Produktpräsentationen
Halte ein erwachsenes Model stabil, während der Prompt die Outfits wechselt. Kleidung aus der Referenz kann durchsickern, beschreibe den neuen Look also deutlich.
Verwandlungsszenen
Der Axis-Loader gleitet zwischen zwei Charakteren von A nach B – ideal für Morphs, Vorher-nachher-Effekte und Traumsequenzen.
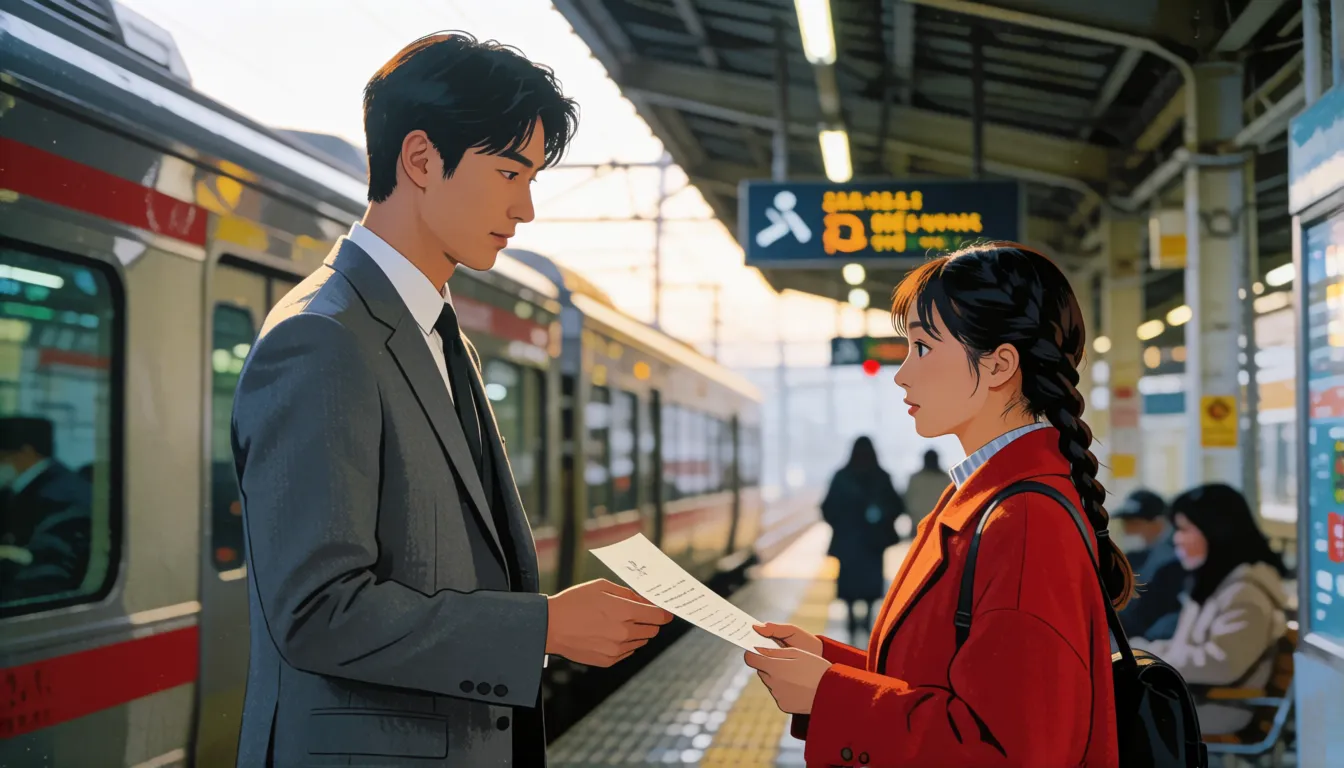
Von acht Fotos zum wiederverwendbaren Charakter in ComfyUI
Die Erstellung von MiniMax H3 RefMods in ComfyUI folgt der README des Node-Pakets. Beginne mit gutem Material: 5 bis 10 scharfe Bilder mit jeweils einer Person aus verschiedenen Winkeln oder ein kurzer Clip. Für Audio sind 5 bis 15 Sekunden sauberer Ton der übliche Bereich. Vermeide unruhige Hintergründe, denn alles im Bild kann zusammen mit dem Gesicht in die Datei wandern.
- 1Installiere ComfyUI-MiniMaxH3Mod über den ComfyUI Manager oder klone das GitHub-Repository in custom_nodes und starte ComfyUI anschließend neu.
- 2Lade deine Referenzbilder in den Node Extract H3 RefMod und wähle das Preset identity_encode mit Full Reference für maximale Details.
- 3Speichere die Ausgabe in ComfyUI/models/refmods/, damit die Loader-Nodes sie finden.
- 4Füge Load H3 RefMods hinzu (bis zu acht Slots, jeder mit eigener Stärke und Kopienanzahl) und lege eine Anfangsstärke fest.
- 5Verbinde Apply H3 RefMod mit dem Conditioning deines MiniMax H3 ImageToVideo- oder ReferenceToVideo-Nodes und sample wie gewohnt.
- 6Rendere denselben Seed einmal ohne die Datei als Vergleichsbasis, damit du genau siehst, was die Referenz beiträgt.
- Step-Curve-Node: Wähle concept_at_start, concept_at_middle oder concept_at_ends, um festzulegen, wann die Referenz beim Denoising wirkt – zum Beispiel erst Ähnlichkeit, später freie Bewegung.
- Load H3 RefMod Folder: Verweise auf ein Verzeichnis, um ganze Charaktersets auf einmal auszutauschen.
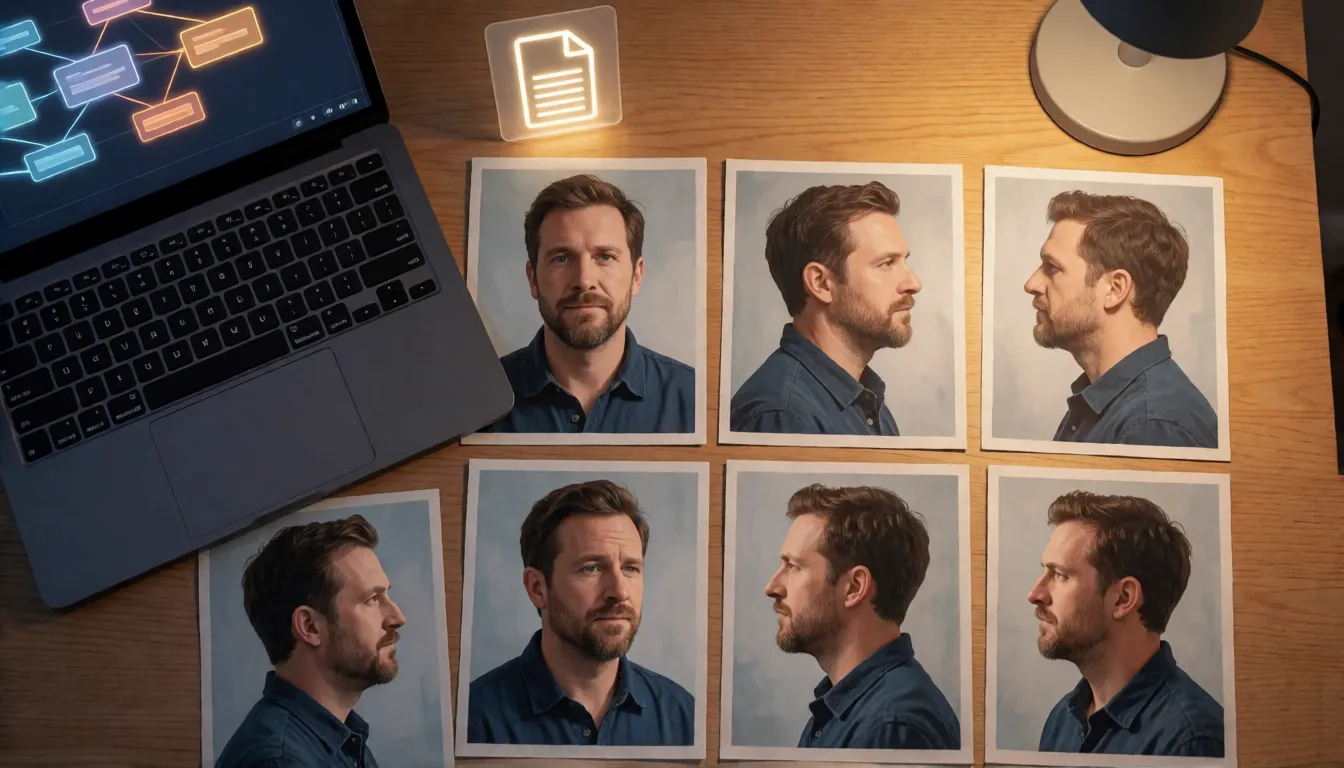
Lieber Buttons als Nodes? Erstelle sie in Fizgig v6
Fizgig, das Creator-Tool von shootthesound, hat Mitte September 2026 mit Version 6 die Erstellung von MiniMax H3 RefMods eingeführt. Es verpackt die Extraktion in eine freundlichere Oberfläche mit fertigen Rezepten: Das Community-Rezept nutzt 8 Bilder mit 1 Megapixel, Fizgig lite 16 Bilder mit 0,5 Megapixel, und eine Fizgig-1MP-Option liegt dazwischen. Außerdem gibt es Stil-Presets, Bewegungs- und Audioreferenzen sowie ein RefMod Studio, das A/B-Vergleiche nebeneinander rendert, sodass du Stärkeeinstellungen ohne Raten beurteilen kannst. Fizgigs eigene Dokumentation enthält eine How-do-I-Anleitung, die jedes Rezept durchgeht.
Zwei Charaktere, eine Szene: Dateien stapeln
Bei Gruppenszenen schlagen MiniMax H3 RefMods das Referenzieren mit Einzelbildern ganz unauffällig. Gib jedem Charakter eine eigene Datei, lade sie in separate Slots und sprich sie im Prompt als <Subject 1>, <Subject 2> und so weiter an. Beschränke jede Datei auf eine Person: Eine Datei, die zwei Gesichter mischt, verschmilzt sie tendenziell. Senke zuerst die Stärke der Nebenfigur, wenn die Hauptfigur an Details verliert, und behalte Beschreibungen von Haaren, Kleidung und Statur im Prompt, damit das Modell weiß, wer wer ist.
Mehr als Gesichter: Stil-, Bewegungs- und Stimmreferenzen
Charaktere sind bei MiniMax H3 RefMods nur die halbe Geschichte. Eine mit style_experimental erstellte Stildatei komprimiert eine Reihe von Frames zu einem Look, den du auf eine ganze Serie anwenden kannst – praktisch, um ein einheitliches Color Grading über einen Kanal hinweg zu halten. Eine mit motion_sequence erstellte Bewegungsdatei macht aus einem kurzen Clip eine Bewegungsvorlage, sodass sich ein charakteristischer Gang oder Tanz mit einem anderen Charakter wiederverwenden lässt.
Auch Audiodateien gibt es, mit etwa 80 Tokens pro Sekunde Ton. Betrachte sie als experimentell: In aktuellen Tests wird die Sprecheridentität nicht zuverlässig übertragen, das Audio wird standardmäßig ab dem Anfang des Clips kodiert, und es gibt keine Lippensynchronisation. Verwende sie niemals, um ohne Erlaubnis die Stimme einer realen Person nachzuahmen.
Prompt-Vorlagen, die das Gesicht stabil halten
Beim Prompten mit MiniMax H3 RefMods gilt: Eine Referenzdatei ist kein Trigger-Wort, und ihr Dateiname bewirkt im Prompt nichts. Was funktioniert, ist den Charakter so zu beschreiben, als gäbe es die Datei nicht, und die Referenz dann die Details angleichen zu lassen. Diese Vorlagen sind für originale erwachsene Charaktere geschrieben; setze deine eigenen Details ein.
- Verankere Aussehen und Handlung immer in Worten: Alter, Haare, Augen, Kleidung, dann Bewegung und Kamera.
- Ein Charakter pro Datei, ein <Subject N>-Tag pro Charakter.
- Beginne bei mittlerer Stärke, erhöhe sie nur, wenn das Gesicht abdriftet, und senke sie, wenn der Hintergrund die Referenzfotos zu kopieren beginnt.
- Benenne bei Outfitwechseln das neue Kleidungsstück ausdrücklich und füge same face hinzu, damit sich die Kleidung aus der Referenz nicht durchsetzt.
Einzelner Charakter
<Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, wearing a white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting.
Zwei Charaktere
<Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light.
Outfitwechsel (originaler Charakter ab 18)
<Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, standing by a sunlit pool, slow dolly-in.
RefMod vs. LoRA vs. direktes Referenzbild
Jede Methode hat ihren Platz. Der Autor von Fizgig merkt an, dass eine trainierte LoRA immer noch besser generalisiert und eine höhere Ähnlichkeit erreicht, während der Unterschied bei Einstellungen nahe am Referenzmaterial gering ist. Einfache Referenzbilder brauchen keine Vorbereitung, werden aber bei jedem Durchlauf neu kodiert, und Positions-Tags werden bei mehreren Bildern schnell umständlich.
| RefMod | LoRA | Direktes Referenzbild | |
|---|---|---|---|
| Training | Keins, eine Extraktion | Ja, Datensatz und Trainingslauf | Keins |
| Zeit bis zur ersten Nutzung | Minuten | Stunden | Sofort |
| Dateigröße | Etwa 1–1,6 MB | Meist deutlich größer | Keine Datei |
| Ähnlichkeit bei neuen Winkeln | Gut nahe der Referenz | Am stärksten | Schwankt pro Durchlauf |
| Charaktere stapeln | Bis zu 8 Slots | Möglich, kann kollidieren | Positions-Tags pro Bild |
Was noch nicht klappt: ehrliche Grenzen
MiniMax H3 RefMods sind noch jung, und die README des Node-Pakets spricht die Schwachstellen offen an. Wer sie vorab kennt, spart sich stundenlanges Neugenerieren, und für die meisten gibt es einfache Lösungen wie sauberere Referenzen oder eine geringere Stärke.
- Schnelle Bewegungen können das Gesicht verschmieren; langsamere Kamerafahrten halten die Identität besser.
- Compressed Reference verliert Gesichtsdetails, verwende für Nahaufnahmen daher Full Reference.
- Identität, Kleidung, Hintergrund und Bildaufbau können gemeinsam übertragen werden; eine selektive Übertragung ist nicht garantiert.
- Stimmklonen aus Audiodateien ist derzeit unzuverlässig, und Audio liefert keine Lippensynchronisation.
- Einige Workflows wurden noch nicht auf jeder GPU vollständig validiert, und es gibt keine offiziellen Benchmarks.
Fertige Dateien: Wo die Community sie teilt
Du musst nicht alle deine MiniMax H3 RefMods von Grund auf selbst bauen. Der Creator malcolmrey veröffentlicht auf Hugging Face unter Apache-2.0 eine große Bibliothek mit Hunderten fertiger Dateien, dazu Datensätze mit Anleitungen, Beispielen und Beispiel-Workflows. Lade eine Datei herunter, lege sie in ComfyUI/models/refmods/ ab, und sie erscheint im Loader. Es gibt auch kleinere private Uploads, doch viele davon sind wenig aktiv und manche enthalten Abbilder realer oder urheberrechtlich geschützter Figuren – prüfe also vor der Nutzung, was darin steckt, und bleib bei originalen oder ordnungsgemäß lizenzierten Charakteren.
Unzensierte Nutzung: Was Referenzdateien ändern können und was nicht
Wer nach unzensierten MiniMax H3 RefMods sucht, hofft meist auf eine ungefilterte Version. Die gibt es nicht: Eine Referenzdatei sagt dem Modell nur, wen oder was es zeigen soll, sie ändert nicht, was das Modell zu erzeugen bereit ist. Da H3 ein Open-Weight-Modell ist, bestimmen lokale Nutzer ihr Setup ohnehin selbst, und Creator von Inhalten für Erwachsene kombinieren typischerweise eine Datei eines originalen Charakters ab 18 mit H3-LoRAs aus der Community für Bademode-, Dessous- oder Boudoir-Serien. Wenn du dir die lokale Installation lieber sparst, bietet Spicy AI online H3-Bild-zu-Video mit gelockerten Filtern für erwachsene, fiktive oder einwilligende Charaktere.
Lade ein Standbild deines originalen erwachsenen Charakters hoch und animiere es ohne GPU.
Bild zu Video öffnenTeste online einen Prompt für konsistente Charaktere
Beginne mit einem Standbild deines Charakters, füge einen Prompt ein und lass das Videomodell den Rest erledigen. Diese Startvorlagen wurden für originale erwachsene Charaktere geschrieben und funktionieren so, wie sie sind.
- <Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting
- <Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light
- <Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, stands by a sunlit pool and turns toward the camera, slow dolly-in
- <Subject 1>, adult man with a trimmed beard, open white shirt, laughs on a yacht deck at golden hour, wind in his hair, camera orbits slowly
H3 mit Referenzdateien selbst hosten vs. online auf Spicy AI generieren
Lokales ComfyUI bietet dir das komplette Node-Toolkit; der Online-Weg tauscht diese Kontrolle gegen null Einrichtungsaufwand.
| Lokale Installation (offizielle Gewichte) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Du konfigurierst dein eigenes Setup | Gelockerte Filter für Inhalte für Erwachsene (18+) |
| Offene Gewichte | Ja | Nicht nötig – läuft im Browser |
| Charakterkonsistenz | RefMod-Dateien, LoRAs und Node-Steuerung | Start mit einem Standbild deines Charakters |
| Einstiegspreis | Deine eigene GPU | Kostenlose Stufe verfügbar |
FAQ
Werden MiniMax H3 RefMods von MiniMax entwickelt?
Nein. Sie sind ein Community-Format, entstanden mit dem Node-Paket ComfyUI-MiniMaxH3Mod von @Luisacaotica unter der MIT-Lizenz. MiniMax hat sich dazu bisher nicht geäußert.
Muss ich etwas trainieren?
Nein. Deine Referenzen durchlaufen einmal den VAE und werden als Datei von etwa 1 bis 1,6 MB gespeichert. Die H3-Gewichte werden nie neu trainiert.
Wie viele Bilder sollte ich verwenden?
Die README empfiehlt 5 bis 10 scharfe Bilder mit jeweils einer Person oder einen kurzen Clip. Fizgig-Rezepte nutzen 8 Bilder mit 1 Megapixel oder 16 mit 0,5 Megapixel.
Ist ein RefMod besser als eine LoRA?
Er ist schneller und kleiner. Eine trainierte LoRA gewinnt weiterhin bei Ähnlichkeit und ungewöhnlichen Winkeln, doch bei Einstellungen nahe an deinen Referenzen ist der Unterschied gering.
Wie viele kann ich gleichzeitig laden?
Der Node Load H3 RefMods hat bis zu acht Slots, jeder mit eigener Stärke. Verwende für Gruppenszenen eine Datei pro Charakter.
Wohin kommen die Dateien?
Lege sie in ComfyUI/models/refmods/ ab und wähle sie dann im Loader-Node aus oder richte den Ordner-Loader auf ein Unterverzeichnis.
Können sie eine Stimme klonen?
Noch nicht zuverlässig. Die Übertragung der Sprecheridentität ist in aktuellen Tests uneinheitlich, und du solltest niemals die Stimme einer Person ohne deren Einwilligung verwenden.