Offene LoRA · Audio + Video im Stream
Unzensiert TaoMate-H3: KI-Video, das schon abspielt, während es noch entsteht
Drei Minuten auf einen Zehn-Sekunden-Clip zu warten, nimmt KI-Video jeden Reiz. TaoMate-H3 ändert den Rhythmus: Statt den ganzen Clip zu rendern und ihn erst dann zu zeigen, baut es Bild und Ton in kleinen Stücken auf und liefert den ersten abspielbaren Teil nach etwa 17 Sekunden. Veröffentlicht als offene LoRA vom Alibaba-TaoLive-AIGC-Team, dem Team hinter den KI-Livestream-Tools von Taobao, setzt es auf dem Open-Weight-Modell MiniMax H3 auf und läuft so lange weiter, wie du es mit Prompts fütterst. Damit passt es ideal zu sprechenden Moderatoren, Produktdemos und Geschichten in Episoden. Hier erfährst du, was es kann, wo es glänzt, wie man es promptet und was man zum Ausführen braucht.
- 3-Schritt-LoRA
- Spielt schon beim Rendern
- 480p · 768p · 1080p
- Offene Gewichte
TaoMate-H3 vs. MiniMax H3: von drei Minuten auf siebzehn Sekunden
Die Schlagzeile ist das Tempo. MiniMax H3 ist ein starkes offenes Audio-Video-Modell, doch wie die meisten Videogeneratoren stellt es den gesamten Clip fertig, bevor du auch nur ein Bild sehen kannst. TaoMate-H3 ergänzt eine LoRA, die darauf trainiert ist, jeden Abschnitt in nur drei Schritten zu entrauschen, und streamt die Abschnitte dann der Reihe nach aus. Im eigenen Test des Teams auf acht NVIDIA-H20-Karten war ein zehnsekündiger 480×864-Clip nach 17.3 statt 183.3 Sekunden ansehbar, und die eigentliche Diffusionsarbeit sank von fast 170 Sekunden auf unter 15.
Der Speicherbedarf hat sich kaum verändert, die Beschleunigung kommt also nicht von einer größeren Maschine. Was das Team nicht veröffentlicht hat, ist ein direkter Vergleich von Bildqualität oder Bewegungsumfang. Die Bildqualität solltest du daher mit eigenen Augen beurteilen, statt sie als bewiesenen Vorteil zu betrachten.
| Test des Teams (8×H20, 480×864, 10 s) | MiniMax H3 | Mit der LoRA | Gewinn |
|---|---|---|---|
| Erstes abspielbares Video | 183.3 s | 17.3 s | 10.6× schneller |
| Erster fertiger Abschnitt | 170.1 s | 6.1 s | 27.7× schneller |
| Diffusionszeit (DiT) | 169.6 s | 14.8 s | 11.45× schneller |
| DiT-Spitzenspeicher | 32.03 GiB | 31.37 GiB | Etwa gleich |
Drei Schritte pro Abschnitt: Audio-Video-Generierung im Stream einfach erklärt
Stell dir einen Drucker vor, der dir jede Seite reicht, sobald sie fertig ist, statt auf den ganzen Bericht zu warten. Das Modell zerlegt das Video und seinen Soundtrack in kurze Scheiben und erzeugt jede Scheibe in drei Entrauschungsdurchläufen. Jede fertige Scheibe wird in einen Speicher-Cache geschrieben, und die nächste baut darauf auf, sodass die Geschichte ohne festes Ende weitergehen kann. Für einen Zehn-Sekunden-Clip nennen die offiziellen Hinweise 24 Generierungsdurchläufe und 8 Cache-Updates.
Gesicht und Stimme über eine lange Einstellung stabil zu halten, ist der schwierige Teil. Das Forschungspaper hinter dem Projekt führt ankergeführten Speicher ein: einen Referenzzustand, der festhält, wie die Figur aussieht und klingt, was Farbdrift und schwankende Identität im Lauf der Minuten verringert. Bild und Ton entstehen gemeinsam, sodass Lippen, Sprache und Raumklang synchron bleiben, statt nachträglich zusammengeklebt zu werden.
Die Benchmarks des Papers sind beeindruckend: 35 Bilder pro Sekunde auf drei GPUs gegenüber 23 für LiveAvatar auf fünf und 16 für LongLive-2.0 auf vier, dazu der beste Lip-Sync-Wert. Bedenke aber, dass diese Zahlen an einem Generator mit 22 Milliarden Parametern gemessen wurden, der aus LTX-2.3 initialisiert wurde, nicht am H3-Release. Sie zeigen also das Potenzial der Methode, nicht die Ergebnisse genau dieses Modells. Unter den Open-Source-Optionen für KI-Video in Echtzeit gehört es zu den wenigen, die Ton und Bild gemeinsam streamen.
Digitale Moderatoren, Produktdemos im Live-Stil und Kurzdramen
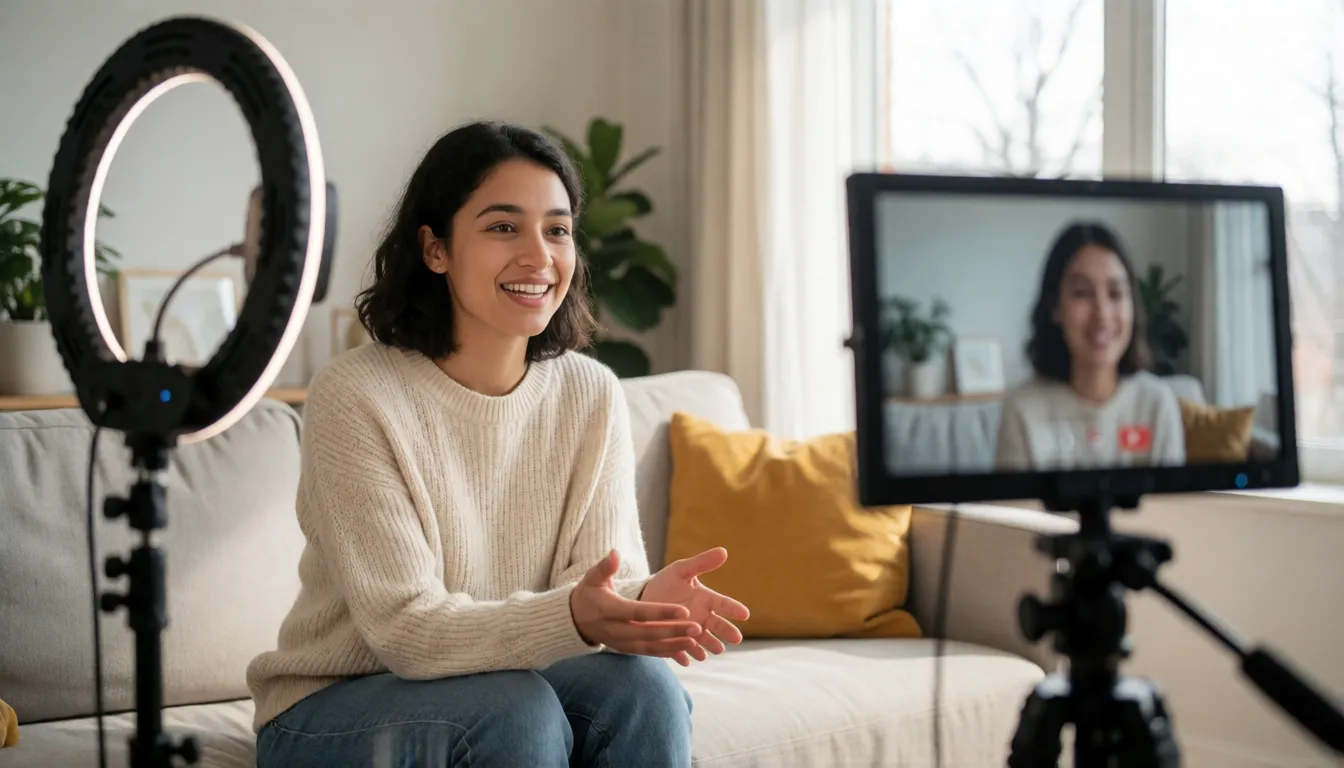
Da es vom Livestream-Team von Taobao stammt, ist die naheliegende Bühne der sprechende Präsentator. Die offizielle Demo mit erstem und letztem Frame ist ein 30-Sekunden-Clip einer Moderatorin, die in einem Familienwohnzimmer sitzt und erklärt, wie man Stauraum organisiert – genau die Art Segment, die Shopping-Streams den ganzen Tag senden. Das Projekt verspricht nie ein vollständiges Live-Commerce-Produkt, aber die Zutaten sind da: ein stabiles Gesicht, eine natürliche Stimme und Ergebnisse, die schnell genug kommen, um einen Produktionsplan in Bewegung zu halten.
Sprechende Moderatoren und Erklärvideos
Ein Präsentator, ein Raum, ein Skript in kurze Abschnitte geteilt. Ideal für Anleitungen, Haushaltstipps und Kanal-Intros, die ein freundliches Gesicht vor der Kamera brauchen.
Produktdemos und Werbeentwürfe
Entwirf mehrere Versionen eines 15-Sekunden-Pitches, tausche den Satz oder den Produktblickwinkel und vergleiche sie nebeneinander, bevor du einen echten Dreh buchst.
Kurzdramen in Episoden
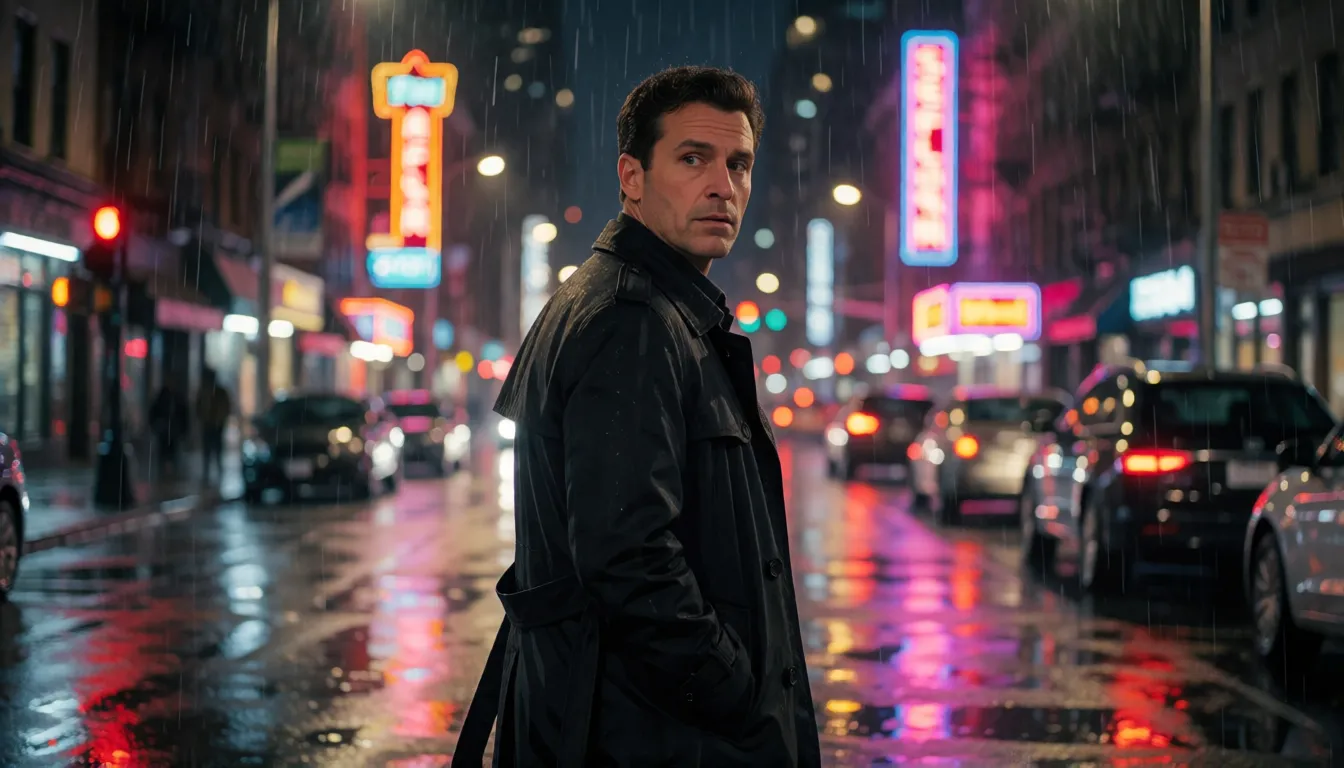
Verkette Fünf-Sekunden-Abschnitte zu einer durchgehenden Szene. Regen, Neon, ein geflüsterter Satz und eine Enthüllung – und derselbe Darsteller von Abschnitt zu Abschnitt.
Social Video im Hochformat
Native Hochformate mit 768×1376 und 1088×1920 passen ohne Zuschneiden direkt in Kurzvideo-Feeds. Das Paper testete außerdem Sprache auf Mandarin und Englisch.
Ein einminütiges KI-Video bauen, fünf Sekunden nach der anderen
Bei langen KI-Videos zahlt sich Streaming wirklich aus. Die Länge wird in Fünf-Sekunden-Blöcken festgelegt, und du kannst entweder einen einzigen Prompt für den ganzen Lauf verwenden oder eine JSON-Liste mit einem Prompt und optional einem Seed pro Fünf-Sekunden-Block übergeben. Sieh es als Storyboard: Block eins stellt die Moderatorin vor, Block zwei zeigt das Produkt, Block drei ist die Nahaufnahme, und das Modell trägt dieselbe Person und denselben Raum durch jeden Wechsel. Die offiziellen Beispiele laufen 30 Sekunden, und das Paper testet eine volle Minute mit 1,441 Frames.
Die Ausgabe gibt es in drei Größen: 480p für schnelle Entwürfe, 768p als Standard und 1080p für die Auslieferung, jeweils im Quer- oder Hochformat. Die Variante mit erstem und letztem Frame läuft fest mit 24 fps im Hochformat 768×1376 – praktisch, wenn jede Einstellung in einer exakten Pose beginnen und enden muss.
Prompt-Vorlagen für sprechende Moderatoren und Serienszenen
Der Trick für konsistente lange Einstellungen ist Wiederholung. Beschreibe Aussehen, Outfit und Umgebung der Person in jedem Block erneut, gib jedem Block nur eine Hauptaktion, setze gesprochene Sätze in Anführungszeichen und beschreibe den Ton separat. Diese Vorlagen folgen diesem Muster und taugen als erster Entwurf für deine eigenen Skripte.
Sprechende Moderatorin · Block 1
Halbnahe Einstellung, eine junge Frau in einem cremefarbenen Pullover sitzt auf einem Sofa in einem hellen Wohnzimmer, spricht in die Kamera und erklärt, wie man Handtücher in eine Aufbewahrungsbox faltet, natürliche Gesten, warmes Tageslicht, ruhige Kamera. Audio: klare Frauenstimme, sanfter Raumklang.
Sprechende Moderatorin · Block 2 (Fortsetzung)
Dieselbe Frau, derselbe cremefarbene Pullover, dasselbe Wohnzimmer. Sie hebt die Box zur Kamera und lächelt: "In diese passen drei Handtücher." Die Kamera fährt langsam heran. Audio: dieselbe Stimme, leises Rascheln von Stoff.
Kurzdrama-Abschnitt
Nächtliche Straße im Regen, ein Mann in einem schwarzen Trenchcoat dreht sich um, Nahaufnahme, er sagt mit leiser Stimme: "Du bist also doch gekommen." Neonspiegelungen auf nassem Asphalt. Audio: gleichmäßiger Regen, fernes Donnergrollen.
Bademoden-Spot für Erwachsene (18+, fiktives Model)
Ein erwachsenes Fashion-Model Ende zwanzig in einem roten Bikini spaziert an einem sonnigen Strand entlang und spricht in die Kamera über die Bademode dieses Sommers, entspanntes Lächeln, Kamerafahrt. Audio: ihre Stimme, Wellen, sanfte Brise.
TaoMate-H3-FL2VA und TaoMate-HD: die wachsende Familie
Das Projekt entwickelt sich schnell. Das erste Release im September 2026 brachte Text-zu-Audio-Video-Streaming auf H3. Am 15. Oktober 2026 ergänzte das Team TaoMate-H3-FL2VA, das einen ersten und einen letzten Frame entgegennimmt und den Clip dazwischen streamt – laut Team nach ihrem Wissen das erste Echtzeit-Audio-Video-Modell mit erstem und letztem Frame. Zu dieser Version greifst du, wenn ein Storyboard festlegt, wie jede Einstellung beginnt und endet.
Am 3. November 2026 folgte TaoMate-HD, das auf der H3-Laufzeit aufbaut und mit progressiver Generierung schärfere Ergebnisse anstrebt; Details stehen auf der Projektseite. Referenzbasierte Generierung (Ref2AV) ist als späteres Feature gelistet, noch ohne Termin.
TaoMate-H3 über Hugging Face und GitHub ausführen
Die LoRA selbst ist klein: nur eine Config, eine Adapter-Config und eine safetensors-Datei (Rank 128), veröffentlicht auf Hugging Face mit einem ModelScope-Mirror. Die Einrichtung ist im GitHub-Repository beschrieben. Der Haken ist die Hardware: Das einzige verifizierte Setup sind acht NVIDIA-H20-Karten mit 96 GB, und die Skripte akzeptieren vier oder acht GPUs der Hopper-Klasse.
- 1Linux mit Python 3.10 oder 3.11, CUDA 12.8, PyTorch 2.8, vLLM 0.11.1, FlashAttention für Hopper und FFmpeg vorbereiten.
- 2Das Basismodell MiniMax H3 (model_index.json samt Ordnern) und die TaoMate-LoRA von Hugging Face herunterladen.
- 3Eine Größe wählen (480p, 768p oder 1080p) und --duration auf ein Vielfaches von 5 Sekunden setzen.
- 4Einen --prompt für den ganzen Clip übergeben oder --prompt-json mit einem Prompt und optionalem Seed pro Fünf-Sekunden-Block.
- 5Mit --gpus 4 oder 8 starten und zusehen, wie die ersten Abschnitte abspielen, während der Rest noch generiert wird.
- GPU-Anforderungen: Es ist kein Mindest-VRAM veröffentlicht, und es gibt keinen offiziellen Weg für RTX-4090- oder 5090-Karten.
- ComfyUI: Offizielle Nodes gibt es noch nicht, die Kommandozeile ist daher der unterstützte Weg.
- Online-Demo: Zwei Community-Spaces auf Hugging Face lassen dich das 3-Schritt-Modell im Browser testen, und die Modellseite listet einen gehosteten Inferenz-Anbieter.
Warum Creator dieses Release genau beobachten
Offene Audio-Video-Generierung in Echtzeit ist selten, und genau das weckt Aufmerksamkeit. Innerhalb von rund zwei Monaten überschritt das GitHub-Repository 800 Sterne, die Hugging-Face-Seite sammelte mehr als 130 Likes, und die Community startete zwei öffentliche Demo-Spaces. Die Begeisterung dreht sich darum, dass ein Clip fast sofort beginnt, und um lange Einstellungen, die dasselbe Gesicht behalten. Was die meisten zurückhält, steht klar in den Anforderungen: ein Multi-GPU-Setup auf Rechenzentrumsniveau, bisher ohne offiziellen Weg für Consumer-Karten oder ComfyUI.
Unzensiert TaoMate-H3: was offene Gewichte für Creator von Erwachseneninhalten bedeuten
Es gibt keine separate unzensierte Edition von TaoMate-H3, und im üblichen Sinn braucht es auch keine: Sowohl die LoRA als auch die H3-Basis sind offene Gewichte, die offiziellen Seiten beschreiben keinen Inhaltsfilter oder Sicherheitsklassifikator, und ein lokaler Lauf geht nie durch einen Cloud-Moderationsdienst. Für Creator von Erwachseneninhalten heißt das: Die Regeln bestimmen die Lizenz des Modells und dein eigenes Setup. Wenn dir ein Rig mit acht GPUs fehlt, bietet Spicy AI online ein ähnliches Bild-zu-Video-Tool mit gelockerten Filtern für erwachsene, fiktive Figuren.
Lade ein Standbild deiner eigenen erwachsenen Figur hoch und erwecke sie mit Ton zum Leben – ganz ohne GPU.
Bild zu Video öffnenUnzensierter alternativer Videogenerator
Starte mit einem Foto einer eigenen erwachsenen Figur, beschreibe die Bewegung und den Satz, den sie sagen soll, und erhalte einen kurzen sprechenden Clip direkt im Browser.
Jetzt generierenTaoMate-H3 selbst hosten vs. online auf Spicy AI generieren
Selbst ausführen bringt dir Echtzeit-Streaming und volle Kontrolle; der Online-Weg tauscht das gegen null Einrichtungsaufwand.
| Lokale Bereitstellung (offizielle Gewichte) | Spicy AI online | |
|---|---|---|
| Inhaltsfilter | Du konfigurierst dein eigenes Setup | Gelockerte Filter für Erwachseneninhalte (18+) |
| Offene Gewichte | Ja (LoRA + H3-Basis) | Nicht nötig, läuft im Browser |
| Tatsächlich genutztes Modell | TaoMate-LoRA auf MiniMax H3 | Ein gehostetes Bild-zu-Video-Modell |
| Einstiegskosten | Vier bis acht Hopper-GPUs | Kostenlose Stufe verfügbar |
FAQ
Was ist TaoMate-H3?
Eine 3-Schritt-LoRA samt Streaming-Laufzeit auf Basis von MiniMax H3, entwickelt vom TaoLive-AIGC-Team von Alibaba. Sie erzeugt Audio und Video gemeinsam in Abschnitten, sodass die Wiedergabe beginnt, während der Rest noch rendert.
Wie viel schneller ist es als MiniMax H3?
Im offiziellen Test auf acht H20-GPUs mit 480×864 und 10 Sekunden kam das erste abspielbare Video nach 17.3 statt 183.3 Sekunden, und die Diffusionszeit war 11.45-mal kürzer.
Läuft es auf einer RTX 4090 oder 5090?
Offiziell nicht. Unterstützt werden nur Hopper-GPUs, das verifizierte Setup sind acht H20-Karten mit 96 GB, vier oder acht GPUs sind möglich, und ein Mindest-VRAM wurde nicht veröffentlicht.
Unterstützt es Videos mit erstem und letztem Frame?
Das Haupt-Release ist Text zu Audio-Video. Streaming mit erstem und letztem Frame kommt von TaoMate-H3-FL2VA, veröffentlicht am 15. Oktober 2026. Referenzbasierte Generierung ist noch nicht erschienen.
Wie lang können die Videos sein?
Die Länge wächst in Fünf-Sekunden-Schritten und kann weiterlaufen. Offizielle Beispiele dauern 30 Sekunden, und das Paper evaluiert einminütige Clips mit 1,441 Frames.
Gibt es einen ComfyUI-Node?
Vom Team bisher nicht. Der unterstützte Weg sind die Kommandozeilen-Skripte im GitHub-Repository.
Gibt es eine unzensierte Version?
Eine eigene gibt es nicht. Die Gewichte sind offen und die offiziellen Seiten beschreiben keinen eingebauten Filter, daher unterliegt ein lokaler Lauf der H3-Community-Lizenz statt einer Cloud-Moderation.