Uncensored KI-Video · Community-Merge von MiniMax H3
Uncensored MiniMax H3 FL2VA Ref2VA Hybrid: Scharfe Videos, die sich deine Figuren merken
MiniMax veröffentlicht sein Videomodell H3 als zwei getrennte Checkpoints. FL2VA liefert das sauberere Bild und den besseren Ton, hört aber nur auf ein erstes und letztes Frame; Ref2VA folgt einem ganzen Stapel aus Referenzfotos, Clips und Stimmen, wirkt aber weicher. Der Community-Hybrid MiniMax H3 FL2VA Ref2VA vereint beides in einer Datei – so bleibt eine Kurzserie, ein Fashion-Reel oder eine Anime-Figur von Einstellung zu Einstellung wiedererkennbar, ohne an Glanz zu verlieren. Hier erfährst du, was er kann, welche Datei du brauchst und wie du ihn promptest.
- Konsistente Figuren
- Nativer Ton
- Offene Gewichte
Uncensored Video-Generator als Alternative
Bild zu VideoLade ein Foto deiner Figur als erstes Frame hoch, beschreibe Bewegung, Kamera und Ton und mach daraus ein kurzes Video.
FL2VA vs. Ref2VA: ein Videomodell, zwei Charaktere
H3 ist das Audio-Video-Modell von MiniMax mit 33 Milliarden Parametern: Ein einziges Netz erzeugt Bild und Tonspur gemeinsam, sodass Schritte, Wellen und Dialoge schon synchron ankommen. Statt einer Alleskönner-Datei hat MiniMax zwei Checkpoints veröffentlicht. FL2VA nimmt einen Text-Prompt plus null, ein oder zwei Bilder – das deckt reines Text-zu-Video, Animation ab dem ersten Frame, Enden auf einem letzten Frame und Übergänge zwischen erstem und letztem Frame ab. Ref2VA nimmt einen Prompt plus ein Referenzpaket aus bis zu neun Bildern, drei Videoclips und drei Audioclips, insgesamt höchstens zwölf Dateien.
Beide erzeugen Clips von 4 bis 15 Sekunden mit 24 Bildern pro Sekunde, 32-kHz-Stereoton und standardmäßig 768 Pixeln an der kurzen Seite. Der Haken laut den Community-Autoren, die beide direkt verglichen haben: FL2VA liefert spürbar bessere Bild- und Tonqualität, während Ref2VA dasjenige ist, das sich wirklich merkt, wer deine Figur ist. Genau diesen Kompromiss will der Hybrid aufheben.
| FL2VA | Ref2VA | |
|---|---|---|
| Eingaben | Text + bis zu 2 Frames (erstes, letztes oder beide) | Text + bis zu 9 Bilder, 3 Videos, 3 Audioclips |
| Stärke | Sauberes Bild und Ton, Bewegungen vom ersten zum letzten Frame | Gesichter, Outfits, Orte und Stimmen konsistent halten |
| Schwachstelle | Kann keinem Character Sheet folgen | Weichere Bildqualität, laut Community-Tests |
| Typischer Einsatz | Standbild animieren, zwei Keyframes verbinden | Serienfolgen, Outfit-Showcases, wiederkehrende Sets |
Warum die Community beide zu einem Hybridmodell verschmolzen hat
Die Erkenntnis kam aus dem Vergleich beider Dateien, Gewicht für Gewicht. Der Uploader smhfacct stellte fest, dass sie fast identisch sind – Kosinus-Ähnlichkeit von mindestens 0.9997 – und dass die eigentlichen Unterschiede in einer kleinen Schicht jedes Transformer-Blocks stecken, den adaln_proj-Modulationsgewichten. Überträgt man diese Schichten von Ref2VA in FL2VA, übernimmt das Modell die Referenzfähigkeit und behält dabei den Großteil von FL2VAs Bild und Ton.
Mehr ist der MiniMax H3 FL2VA Ref2VA Hybrid nicht: FL2VA als Basis, mit den Modulationsschichten von Ref2VA in einem gewählten Blockbereich. Kein Nachtraining, kein Mitteln von Gewichten, sondern eine gezielte Transplantation. Es ist ein Community-Experiment, kein MiniMax-Release, und beide Autoren bezeichnen ihre Urteile als subjektiv. Wer aber Ref2VAs Gedächtnis ohne dessen Unschärfe wollte, findet hier aktuell die direkteste Lösung.
Wofür er sich eignet: Serien, Fashion-Reels und wiederkehrende Sets
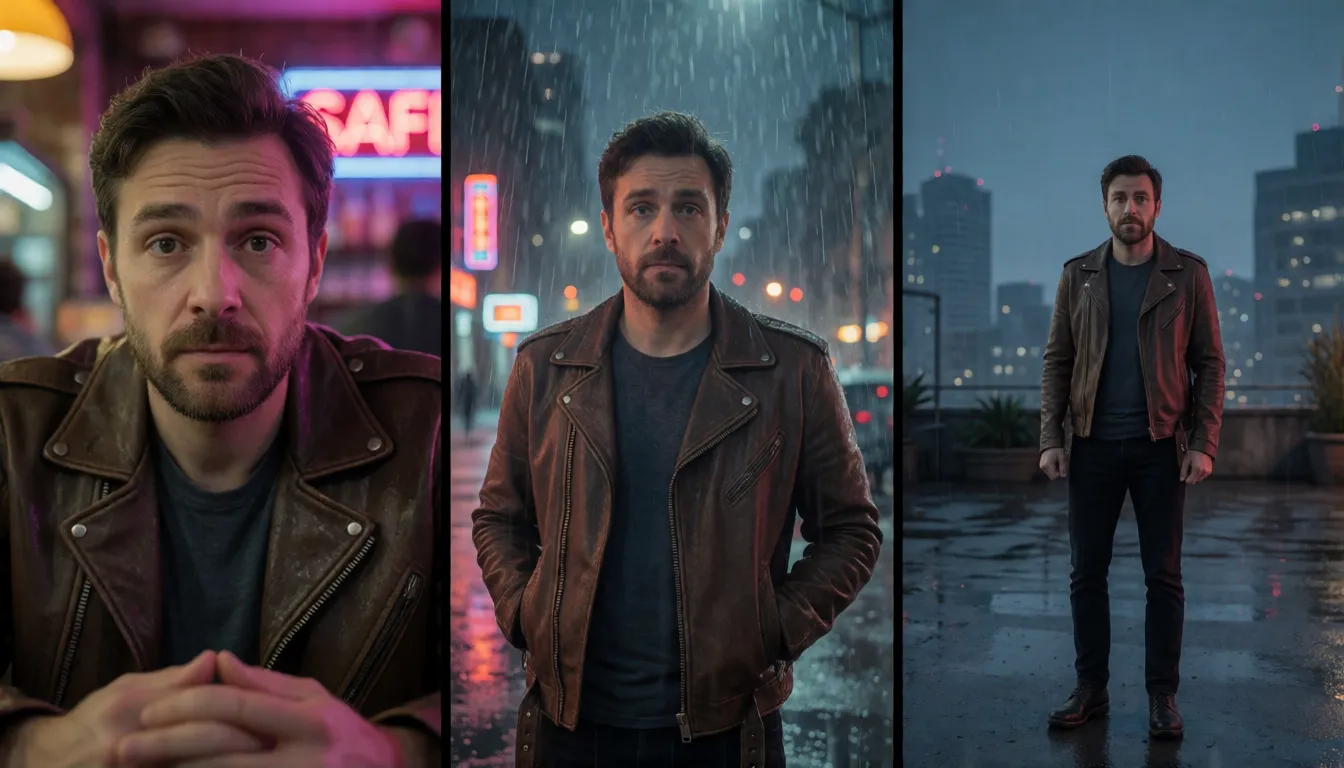
Konsistente Figuren sind der Grund, warum Leute nach dem Merge MiniMax H3 FL2VA Ref2VA suchen. Macher von Kurzserien geben ein Porträt und ein Kostümfoto vor und drehen dann eine Konfrontation im Café, einen Gang durch die verregnete Straße und einen Abschied auf dem Dach – alles mit demselben Gesicht. Weil die Basis FL2VA ist, behalten diese Folgen das schärfere Bild und den nativen Ton, durch die vertikale Serien fertig wirken.
- Episodische Geschichten und KI-Serien: Ein Referenzporträt trägt die Hauptfigur durch jede Szene, jeden Winkel und jeden Lichtwechsel.
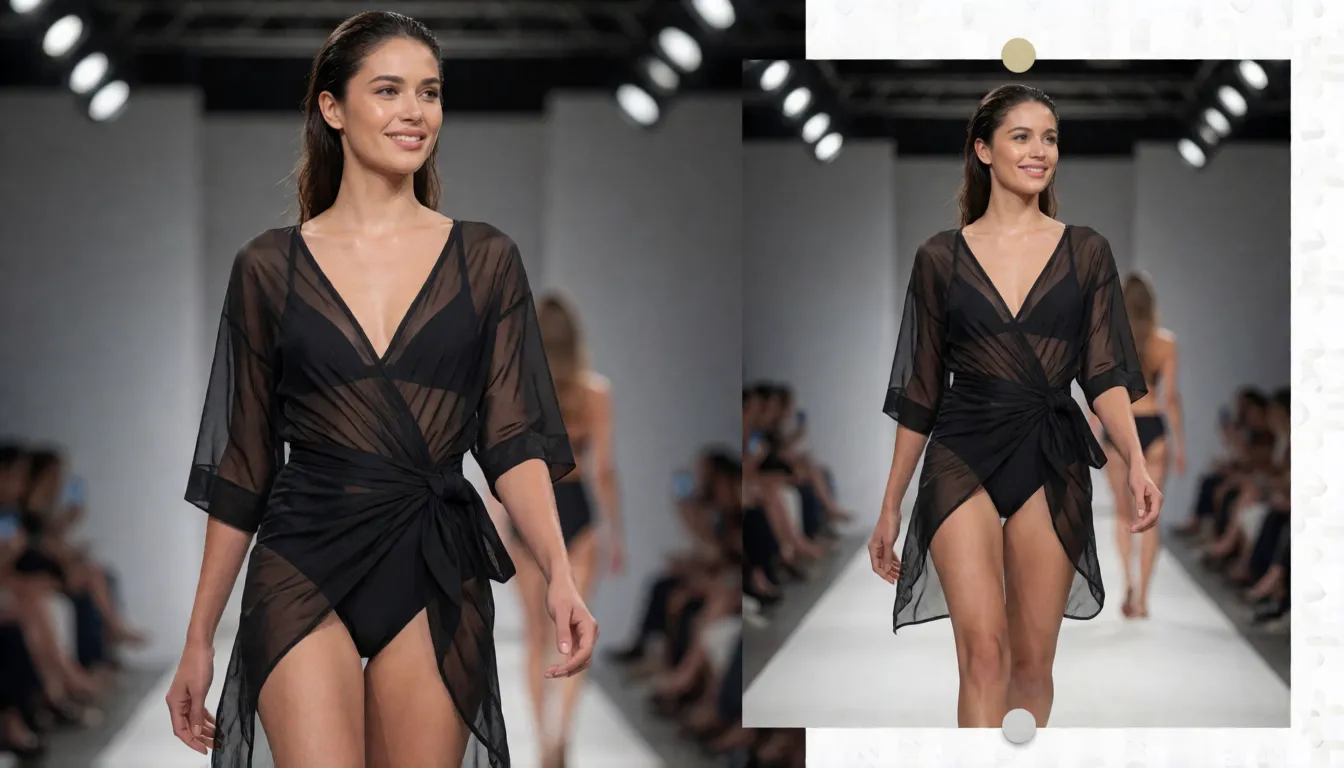
- Outfit- und Styling-Showcases: Gib das Outfit als eine Referenz und das Model als eine andere vor und beschreibe dann eine Laufsteg-Drehung oder eine langsame Drehung. Eine Datei mit leichter Referenz lässt die Kleidung das Ergebnis lenken, ohne die Kamera einzufrieren.
- Wiederkehrende Orte: Nutze ein Foto einer Wohnung, Bar oder eines Strands erneut und erzeuge neue Einstellungen von 4 bis 15 Sekunden aus anderen Positionen.
- Kontinuität bei Stimme und Musik: Ref2VA akzeptiert Audioclips von 2 bis 15 Sekunden, sodass die Stimme einer Figur oder die Stimmung eines Themas über mehrere Clips wiederkehren kann. Der Hybrid behält diese Eingabe bei, wie gut sie funktioniert, hat allerdings noch niemand gemessen.
- Styling für Erwachsene (18+): fiktive erwachsene Figuren in Badeanzug, Dessous oder Bikini für Strand-, Pool- und Boudoir-Reels – alles auf deinem eigenen Rechner.
b15 bis b49: die richtige Hybrid-Datei wählen
Jeder Dateiname verrät, welche Blöcke die Schichten von Ref2VA erhalten haben. Ein größerer Bereich bedeutet stärkere Referenztreue und ein Bild, das sich Ref2VAs weicherem Look annähert; ein kleinerer Bereich bewahrt mehr FL2VA-Schliff. smhfacct veröffentlicht vier int8-Dateien auf einer geprunten int8-Basis, diobrando0 zwei ungeprunte bf16-Dateien von je etwa 66.28 GB, die nur die letzten Blöcke verändern.
| Datei | Präzision | Referenzstärke | Für wen |
|---|---|---|---|
| b15-49 | int8 | Am stärksten | Viele Referenzen, etwas Weichheit ist okay |
| b20-49 | int8 | Stark | Projekte, bei denen Referenzen Vorrang haben |
| b25-49 | int8 | Ausgewogen | Empfohlener Einstieg des Autors |
| b30-49 | int8 | Mittel | Bildqualität zuerst |
| b40-49 | bf16, ~66.28 GB | Leicht (etwa 7.9% der Gewichte aus Ref2VA) | Dezente Führung in voller Präzision |
| b45-49 | bf16, ~66.28 GB | Am leichtesten | diobrando0s Tipp für den ersten Versuch |
b25-49 oder b30-49 ist die häufigste Streitfrage. Starte mit b25-49; wenn Gesichter und Kostüme schon passen und du schärfere Frames willst, geh auf b30-49 zurück. Die Regel gilt in beide Richtungen: Werden Referenzen ignoriert, nimm einen größeren Bereich; wird das Bild matschig oder der Ton dünn, einen kleineren.
Zur Hardware nennt keiner der Autoren eine Zahl. Sie sagen, der Speicherbedarf entspreche der passenden FL2VA-Datei – die int8-Dateien von MiniMax H3 FL2VA Ref2VA liegen also in derselben Klasse wie int8-FL2VA, und die 66-GB-bf16-Dateien sind realistisch eher etwas für Workstations als für eine einzelne Consumer-Grafikkarte.
Eigene Mischung mit dem AdaLN-Merge-Skript
diobrando0 liefert h3_adaln_merge.py zusammen mit den bf16-Dateien. Das Skript kopiert Ref2VAs adaln_proj-Gewichte Byte für Byte in eine FL2VA-Datei, und zwar über den Blockbereich, den du mit --lo und --hi festlegst, ganz ohne Interpolation. Es patcht die Datei direkt auf der CPU in wenigen Minuten, kann mit --backup eine Sicherung anlegen, mit --restore rückgängig machen und prüft das Ergebnis mit BLAKE2b-Hashes.
Praktisch, wenn b40-49 zu leicht und b25-49 zu schwer wirkt: Probier b35-49, beurteile ein paar Clips und stell den Ursprung wieder her, falls es dir nicht gefällt. Bewahre die originalen bf16-Dateien von FL2VA und Ref2VA von Comfy-Org auf, denn das Skript braucht beide als Quelle.
Prompt-Vorlagen, mit denen Referenzen sitzen
Referenz-Prompts funktionieren am besten in fester Reihenfolge: erst sagen, welche Referenz was ist, dann die Handlung, dann die Kamera, dann der Ton. Je mehr Referenzen du stapelst, desto mehr lohnt sich eine Datei mit größerem Bereich wie b20-49 oder b25-49. Diese Vorlagen sind für den MiniMax H3 FL2VA Ref2VA Hybrid geschrieben, und alle Figuren sind erwachsen.
Outfitwechsel am Strand
Die Frau aus Referenzbild 1 trägt den roten Bikini aus Referenzbild 2 und geht zur goldenen Stunde am Strand entlang. Halbnahe Einstellung, die Kamera fährt langsam heran, sie blickt zurück und lächelt. Wellenrauschen und sanfte Akustikgitarre.
Gleiche Figur, neue Szene
Derselbe Mann aus Referenzbild 1 sitzt in einem ruhigen Café, Nahaufnahme im Seitenprofil. Er sagt leise: "Du bist spät dran." Natürliches Fensterlicht, 35-mm-Filmlook, leises Stimmengewirr im Café.
Drehung auf dem Laufsteg
Das erwachsene Model aus Referenzbild 1 läuft im schwarzen Badeanzug mit transparentem Wickeltuch aus Referenzbild 2 über einen weißen Laufsteg, bleibt stehen und dreht sich langsam. Ganzkörper-Kamerafahrt, blitzende Kameras, tiefer elektronischer Beat.
Wiederkehrendes Set
Im Loft aus Referenzbild 1 tanzt das Paar aus den Referenzbildern 2 und 3 nachts langsam am Fenster. Totale, die in eine Zweier-Einstellung übergeht, Lichter der Stadt, sanfter Jazz.
- Benenne Referenzen mit Nummern in der Reihenfolge, in der du sie angehängt hast.
- Beschreibe pro Clip eine Haupthandlung; 4 bis 15 Sekunden vergehen schnell.
- Schreib den gewünschten Ton dazu, gesprochene Sätze in Anführungszeichen.
- Wird eine Referenz immer wieder ignoriert, wechsle zuerst die Datei, bevor du den Prompt umschreibst.
Urteil der Community und ehrliche Grenzen
Unter den Uploads zu MiniMax H3 FL2VA Ref2VA ist smhfaccts int8-Set dasjenige, über das gesprochen wird: zum Zeitpunkt der Recherche rund 384 Likes, 14 Diskussionsthreads und vier darauf aufbauende Hugging Face Spaces. diobrando0s bf16-Paar ist neuer und ruhiger, mit 7 Likes, datiert auf den 1. September 2026. Beide Autoren betonen, dass ihre Vergleiche nach Augenmaß und ohne formale Benchmarks entstanden sind – sieh die Versionstabelle also als Orientierung, nicht als Gesetz.
Die Grenzen sind klar: Ohne Referenzen schlägt der Hybrid FL2VA nicht, die Blockgrenzen wurden experimentell gewählt, der Speicherbedarf sinkt nicht, und MiniMaxs 2K-Verfeinerungsstufe ist nicht Open Source, sodass lokale Ausgaben bei der Basisauflösung bleiben.
Uncensored H3-Hybrid: was anders ist und was nicht
Der Merge entfernt oder ergänzt kein Sicherheitstraining; es wandern nur Modulationsschichten zwischen zwei offiziellen Checkpoints. Was das Erlebnis verändert, ist der Ort, an dem er läuft. Die gehostete API von MiniMax filtert sexuelle, illegale und rechtsverletzende Inhalte, während offene Gewichte auf deinem eigenen Rechner keine solche Filterschicht hinzufügen – deshalb bevorzugen Erwachsenen-Creator lokales H3. Ohne große GPU liefert dir das Bild-zu-Video-Tool hier ähnlich filterfreie Bewegung aus einem einzigen Foto für Szenen mit Erwachsenen (18+).
Animiere ein Figurenfoto direkt im Browser zu einem 18+-Videoclip.
Bild zu Video öffnenOnline generieren: die Alternative ohne Einrichtung auf Spicy AI
Nicht jeder hat eine 66-GB-Workstation oder Lust, mit Checkpoints zu jonglieren. Spicy AI bietet einen Online-Generator als Alternative für genau diese Art Clip: Lade ein Charakterfoto hoch, beschreibe Bewegung, Kamera und Ton und erhalte ein kurzes Video direkt im Browser, ohne Downloads, ohne Treiber und ohne Inhaltsfilter für Szenen mit Erwachsenen (18+).
Das passt für schnelle Tests vor einem langen lokalen Render, für Creator, die nur am Handy arbeiten, und für alle, die einfach das Ergebnis wollen. Starte mit einem klaren Foto deiner erwachsenen Figur, plane eine Hauptaktion pro Clip und nutze dasselbe Foto für jede Folge, damit Gesicht und Outfit wiedererkennbar bleiben.
Online-Generator für Bild zu Video öffnen →FAQ
Was ist der Unterschied zwischen FL2VA und Ref2VA?
FL2VA macht aus Text plus bis zu zwei ersten oder letzten Frames ein Video mit Ton. Ref2VA nutzt Text plus ein Referenzpaket aus bis zu neun Bildern, drei Clips und drei Audiodateien. Laut Community-Testern hat FL2VA das bessere Bild und den besseren Ton.
Stammt der MiniMax H3 FL2VA Ref2VA Hybrid von MiniMax?
Nein. Es ist ein Community-Merge, veröffentlicht auf Hugging Face von smhfacct (int8) und diobrando0 (bf16). Beide nennen ihn experimentell und nach Augenmaß bewertet.
Welche Hybrid-Datei sollte ich zuerst herunterladen?
Starte mit b25-49 beim int8-Set oder b45-49 beim bf16-Set. Nimm einen größeren Bereich, wenn Referenzen ignoriert werden, oder einen kleineren, wenn die Qualität nachlässt.
Wie viel VRAM braucht der Hybrid?
Die Autoren sagen nur, dass eine Datei von MiniMax H3 FL2VA Ref2VA der entsprechenden FL2VA-Datei entspricht. Die bf16-Dateien haben etwa 66.28 GB, die int8-Dateien sind kleiner, eine offizielle Speicherangabe gibt es nicht.
Kann ich ihn beschleunigen?
Ja. Die ref2v-Turbo-LoRA mit 4 Schritten funktioniert damit für schnelle Entwürfe, und für finale Renderings kannst du jederzeit ohne LoRA mit allen Schritten arbeiten.
Quellen
Weitere uncensored KI-Videomodelle
- Uncensored MiniMax H3
- Uncensored MiniMax H3 Max
- Uncensored Kling
- Uncensored Kling 2.6
- Uncensored Kling O1
- Uncensored Sora
- Uncensored Veo
- Uncensored Hailuo AI
- Uncensored Wan
- Uncensored Wan 3.0
- Uncensored Seedance
- Uncensored Seedance 2.5
- Uncensored Seedance 2.0
- Uncensored Seedance 2.0 Mini
- Uncensored HunyuanVideo
- Uncensored LTX Video
- Uncensored Runway
- Uncensored Pika
- Uncensored Luma Dream Machine
- Uncensored Vidu
- Uncensored PixVerse
- Uncensored EdenLive
- Uncensored Grok Imagine
- Uncensored AI Avatars
- Uncensored HappyHorse 1.0
- Uncensored Kling 4.0
- Uncensored Kling 3.0
- Uncensored MiniMax H3 RefMods
- Uncensored Kandinsky 6.0
MiniMax und H3 sind Marken ihres jeweiligen Inhabers. Die Hybrid-Dateien sind Community-Arbeit. Alle Inhalte müssen Erwachsene (18+) zeigen.