Imagem com IA sem censura · SupraLabs
Supra2-IMG sem censura: um modelo de imagem de bolso que roda quase em qualquer lugar
Um modelo com apenas cerca de 100 milhões de parâmetros consegue mesmo desenhar? O Supra2-IMG diz que sim. Lançado pela SupraLabs no Hugging Face no outono de 2026, esse modelo minúsculo de texto para imagem transforma uma frase curta em inglês em uma imagem de 256×256, e é pequeno o bastante para rodar em um notebook comum, em um Mac, dentro de uma aba do navegador ou até em um celular. Os pesos abertos rodam localmente sem nenhum filtro online, e é por isso que as pessoas procuram o Supra2-IMG sem censura.
- Comece grátis
- Sem filtros
- Roda no navegador
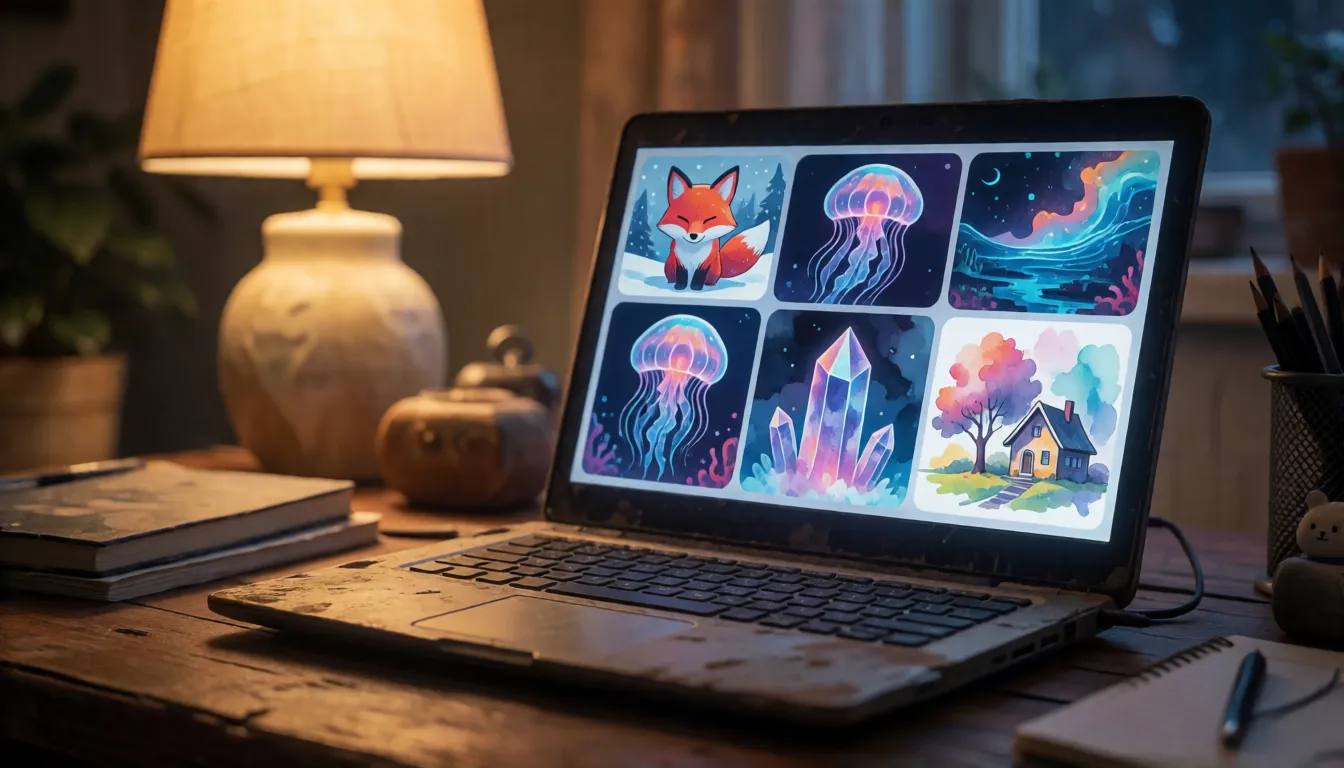
Gerador de imagens alternativo sem censura
Texto para imagemDescreva a imagem que você quer. Adicione uma foto de referência para editá-la ou deixe vazio para texto para imagem.
100 milhões de parâmetros que ainda pintam um quadro
A maioria dos geradores de imagem conhecidos tem bilhões de parâmetros e exige uma placa de vídeo séria. Este vai na direção oposta. O núcleo de desenho é um transformer de difusão com apenas 104,1 milhões de parâmetros, cerca de um oitavo da UNet de 860 milhões de parâmetros do Stable Diffusion 1.5, e o arquivo de pesos tem só uns 417MB. Ele lê o seu prompt com o compacto codificador de texto Flan-T5-base do Google e decodifica as imagens com o conhecido VAE da Stability AI. Mais surpreendente ainda é o quão barato foi criá-lo: a SupraLabs o treinou do zero com 5,6 milhões de imagens sintéticas do conjunto de dados FLUX-Reason-6M por dez épocas, usando uma única GPU H100 por cerca de nove horas, incluindo a preparação dos dados. A equipe informa um FID de 27,9 e um CLIP score de 29,4 sem dizer qual foi o conjunto de teste, então trate esses números como autodeclarados. A ideia não é superar os grandes modelos em detalhes; é mostrar que uma imagem reconhecível e agradável pode sair de algo que cabe em quase qualquer dispositivo.
Onde um modelo de imagem minúsculo brilha
Ser pequeno e rápido muda aquilo para que um modelo de imagem serve. Em vez de um pôster perfeito, você ganha um bloco de rascunhos que funciona offline, inicia na hora e nunca pede uma conta. As pessoas o usam para miniaturas rápidas de conceito antes de uma renderização maior, ícones simples e arte provisória para apps e jogos, painéis de inspiração para histórias e demonstrações em sala de aula que mostram como a difusão funciona sem alugar uma GPU na nuvem. Como cada imagem custa tão pouco, ele também combina com brincadeiras em lote: gere uma dúzia de variações da mesma ideia e fique com a que mais gostar.
| Cenário | O que você cria | Por que um modelo minúsculo serve |
|---|---|---|
| Rascunhos offline | Miniaturas de conceito no trem ou no avião | Não precisa de internet nem de GPU potente |
| Apps e jogos indie | Ícones, blocos e arte provisória | O tamanho pequeno da saída combina com recursos pequenos |
| Histórias e painéis de inspiração | Cenas e atmosferas para a escrita | Muitas variações rápidas para escolher |
| Ensino e aprendizado | Um modelo de difusão funcional para estudar | Pequeno o bastante para ler, rodar e retreinar |
| Batalhas de modelos | Testes lado a lado de modelos minúsculos | Rápido o bastante para comparar dezenas de prompts |
Modelos de prompt que funcionam em 256 pixels
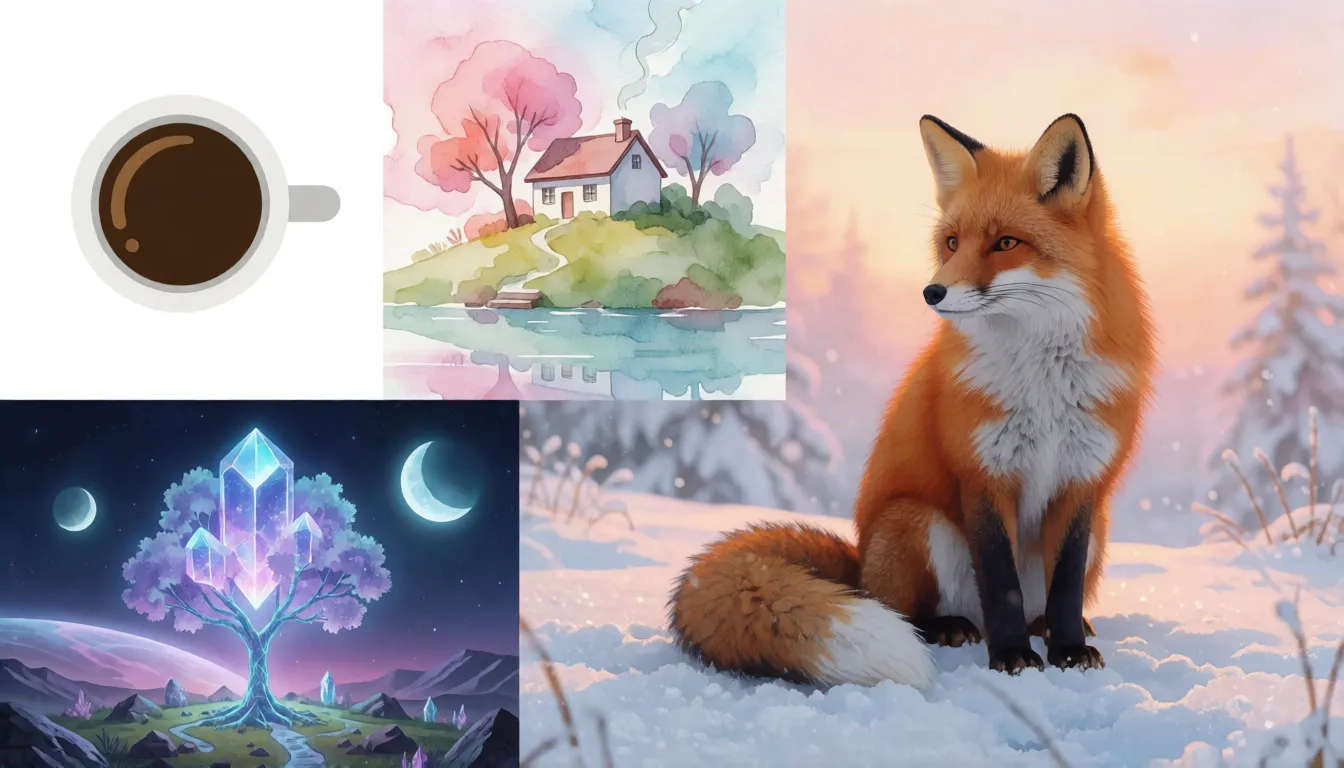
As legendas de treinamento seguem uma ordem simples: primeiro a composição, depois o tema, depois o estilo e a imaginação. Copie essa ordem, mantenha os prompts curtos e em inglês e fique abaixo do limite de 128 tokens do codificador de texto. Um tema claro por frase funciona melhor do que cenas lotadas de pessoas. Experimente estes modelos e mude uma palavra por vez com uma seed fixa:
- Composição e tema: "a close-up of a red fox sitting in fresh snow, centered, soft morning light"
- Clima e cenário (o exemplo do model card): "a sea jellyfish floating in the pitch-black ocean depths"
- Estilo artístico: "a tiny cottage on a hill, watercolor painting, pastel colors"
- Ícones e recursos: "a flat minimal icon of a coffee cup, white background"
- Imaginação: "a glowing crystal tree on an alien planet, two moons in the sky, fantasy art"
- Retrato: "portrait of an adult woman with curly hair, studio lighting, neutral background"
Evite textos longos dentro da imagem e interações complexas entre várias pessoas; o modelo é pequeno demais para lidar bem com isso.
Como rodar o Supra2-IMG em três passos
A instalação é agradavelmente simples. Baixe os pesos model_final_ema.pt e o script inference.py do repositório da SupraLabs no Hugging Face, instale o PyTorch e rode um único comando. O script escolhe o hardware automaticamente: primeiro uma GPU NVIDIA em bf16, depois Apple Silicon via MPS e, como alternativa, a CPU. Se você só quer ver resultados, o Space de demonstração da SupraLabs e o Space Supra-IMG Studio permitem testar online no navegador sem instalar nada.
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/model_final_ema.pt
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
  --seed 0 --cfg 3.0 --steps 50 --n 1 --out out.png
Os padrões do script são CFG 3.0, 50 passos e seed 0; --n gera várias imagens em uma só execução.
Rodando em CPU, Mac ou placa de vídeo antiga
É aqui que o tamanho pequeno realmente compensa. O conjunto completo de modelo de desenho, codificador de texto e VAE é minúsculo para os padrões atuais, então notebooks comuns, Macs com chips da série M e placas gamer mais antigas são alvos realistas. A SupraLabs não publicou números de velocidade nem de memória, e o próprio script avisa que execuções na CPU serão lentas, então espere de segundos a minutos por imagem, dependendo da sua máquina. Algumas configurações ajudam a trocar qualidade por velocidade:
- Mantenha o CFG em torno de 3.0; vale testar valores entre 2 e 5 para seguir o prompt com mais ou menos força.
- Na CPU, tente de 20 a 30 passos em vez de 50 para rascunhos mais rápidos e depois rode de novo a sua seed favorita com todos os passos.
- Use --n para gerar várias imagens em lote e escolher a melhor, em vez de lapidar uma só.
- Mantenha a seed fixa enquanto edita o prompt para ver o que cada palavra muda.
No navegador e no celular: ONNX, WebGPU e safetensors
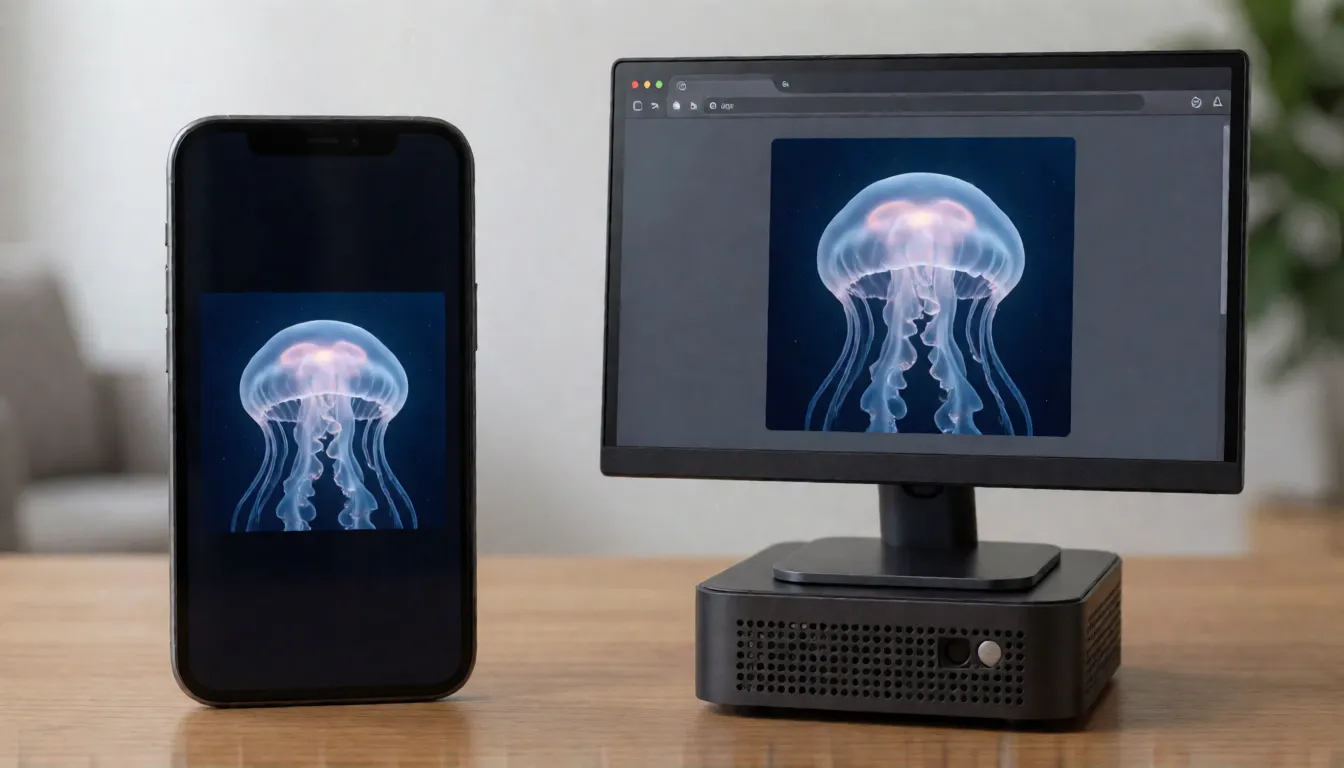
Poucas semanas após o lançamento, a comunidade começou a levar o modelo para novos lugares. Bartholomheow/Supra2-IMG-ONNX e sm079/supra2-img-web o empacotam para WebGPU, para que ele desenhe direto em uma aba do navegador sem nenhum Python. mikhsol/Supra2-IMG-mobile-onnx oferece uma versão int8 voltada para celulares. Se você prefere o formato safetensors, mais seguro, ao arquivo .pt original, malcolmrey/Supra2-IMG e mondk/Supra2-Safetensors oferecem pesos convertidos. São projetos comunitários iniciais e ainda com poucos downloads, então espere arestas e confira as notas de cada repositório.
Sliders LoRA, fine-tunes e treinar o seu do zero
Um modelo tão pequeno é um parquinho para quem gosta de mexer. ntc-ai/supra-particle-sliders adiciona sliders de conceito que você aumenta ou diminui para mudar um visual, e NZUONG/supra2-img-face-grpo é um fine-tune experimental que usa aprendizado por reforço para melhorar retratos. FlameF0X/Tiny-T2I-Arena coloca vários modelos minúsculos de texto para imagem lado a lado para você votar nos resultados. O maior atrativo para quem está aprendendo é a própria receita de treinamento: uma H100 alugada por cerca de nove horas basta para treinar um transformer de difusão do zero, o que transforma um projeto de laboratório de pesquisa em um experimento de fim de semana. A SupraLabs cita o HobbyLM-Image, de rootxhacker, como inspiração para esse espírito faça-você-mesmo.
- Sliders: ajuste um único conceito sem reescrever o prompt.
- Fine-tunes: especialize o modelo em rostos, ícones ou um estilo artístico.
- Do zero: siga o mesmo conjunto de dados e o orçamento de uma única GPU para treinar o seu.
Os menores modelos de texto para imagem comparados: Stable Diffusion e SANA
Este modelo não tenta vencer em qualidade de imagem; o seu trunfo é estar entre os menores e mais baratos modelos de imagem que você pode rodar e retreinar. Veja como ele se compara a nomes conhecidos:
| Supra2-IMG | Stable Diffusion 1.5 | SANA | HobbyLM-Image | |
|---|---|---|---|---|
| Tamanho do modelo de desenho | 104M | Cerca de 860M (UNet) | 0,6B a 1,6B | Modelo pequeno de hobby |
| Resolução | 256×256 | 512×512 | Até 4096×4096 | Baixa resolução |
| Ecossistema da comunidade | Novo e pequeno | Enorme | Em crescimento | Pequeno |
| Ideal para | Dispositivos minúsculos, aprendizado | Ferramentas e complementos maduros | Imagens rápidas em alta resolução | Treinamento por hobby |
Tamanhos e resoluções vêm do model card público ou do artigo de cada projeto.
O que esperar dos resultados
Expectativas honestas deixam tudo mais divertido. Toda imagem tem 256×256, então detalhes finos como mãos, rostos em uma multidão e objetos pequenos ficam suaves, e letras dentro das imagens saem fracas. Ele entende apenas prompts em inglês. Como todas as imagens de treinamento foram geradas pelo FLUX, os resultados puxam para aquele visual FLUX brilhante e bem iluminado. Quando precisar de uma imagem maior, passe o resultado por um upscaler como o Real-ESRGAN; quando precisar de detalhes nítidos, um modelo maior é a ferramenta certa.
- Ótimo em: temas únicos, paisagens, climas, ícones simples e estilos artísticos.
- Fraco em: texto nas imagens, multidões, mãos e detalhes minúsculos.
- Dica: amplie o seu resultado favorito em vez de pedir mais detalhes ao modelo pequeno.
Ele é sem censura? NSFW e arte adulta
Rodando na sua própria máquina, os pesos abertos não têm filtro online, e o script de inferência não contém verificador de segurança nem filtro NSFW, então nada inspeciona o seu prompt ou a imagem final. Isso não quer dizer que ele seja bom em conteúdo adulto: ele aprendeu com imagens geradas pelo FLUX, sua capacidade de desenhar cenas explícitas é desconhecida e nenhum fine-tune NSFW ou sem censura da comunidade existia no momento em que este texto foi escrito. Se você quer arte adulta sem filtros, com qualidade total e sem instalação, um gerador de imagens sem censura online é o caminho prático.
Arte pin-up e glamour
Pin-ups retrô e retratos glamour de modelos adultas com luz suave de estúdio.
Moda praia e fotos na praia
Cenas ensolaradas de adultos de biquíni e maiô na praia e à beira da piscina.
Personagens de fantasia
Feiticeiras, guerreiras e heróis adultos com figurinos ousados para histórias.
- Descreva o tema, a roupa, o cenário e a luz em uma única frase clara.
- Fixe a seed e mude um detalhe por execução.
- Deixe claro que todas as pessoas mostradas são adultas (18+) e nunca retrate pessoas reais sem consentimento.
Crie imagens adultas sem filtros, sem download e sem GPU.
Abrir o gerador de imagens →O que vem a seguir: Supra2.5-IMG
O model card da SupraLabs menciona uma possível sequência chamada Supra2.5-IMG, mas ela ainda não foi lançada e não há informação se vai aumentar a resolução ou o tamanho. A SupraLabs é especializada em modelos muito pequenos, dos modelos de linguagem Supra-50M e Supra2-100M-Instruct ao SupraTTS, então outro lançamento compacto seguiria o padrão. Acompanhar a página da SupraLabs no Hugging Face é a forma mais fácil de saber quando ele chegar.
Hospedar o Supra2-IMG você mesmo vs gerar online no Spicy AI
| Implantação local (pesos da SupraLabs) | Spicy AI online | |
|---|---|---|
| Filtros de conteúdo | Nenhum ao rodar localmente | Sem filtros de conteúdo |
| Pesos abertos | Sim | Não são necessários — roda no navegador |
| Modelo | Checkpoint de 104M parâmetros, 256×256 | Modelo de imagem sem censura semelhante, hospedado online |
| Custo para começar | O seu próprio computador | Plano gratuito disponível |
Perguntas frequentes
Quem criou e quando foi lançado?
A SupraLabs o publicou no Hugging Face. O repositório foi criado em 21 de setembro de 2026 e atualizado pela última vez em 10 de outubro de 2026.
Ele roda em CPU?
Sim. O script da SupraLabs suporta GPUs NVIDIA, Apple MPS e CPU. Execuções na CPU são mais lentas, e nenhum tempo de referência foi publicado.
Qual resolução ele gera?
Apenas 256×256. Para imagens maiores, amplie o resultado com uma ferramenta como o Real-ESRGAN.
Ele entende prompts em outros idiomas?
É melhor usá-lo em inglês. O codificador de texto Flan-T5-base e as legendas de treinamento estão em inglês, e os prompts devem ficar abaixo de 128 tokens.
Posso usá-lo no navegador ou no celular?
Sim, por meio de versões da comunidade: builds ONNX e WebGPU para navegadores e uma build ONNX int8 para celulares. São projetos ainda iniciais.
Existe uma versão em safetensors?
O arquivo original é um checkpoint PyTorch .pt, mas repositórios da comunidade como mondk/Supra2-Safetensors oferecem pesos convertidos para safetensors.
O Spicy AI tem relação com a SupraLabs?
Não. O Spicy AI é uma plataforma independente e não é afiliado nem endossado pela SupraLabs. O nome do modelo pertence ao seu respectivo proprietário.
Fontes
- Model card da SupraLabs (Hugging Face)
- Configuração do modelo (config.json)
- Script de inferência (inference.py)
- Demo online da SupraLabs (Hugging Face Space)
- Conjunto de dados de treinamento FLUX-Reason-6M
- Codificador de texto Flan-T5-base
- Model card do Stable Diffusion v1.5
- Artigo do SANA (arXiv 2410.10629)
- Tiny-T2I-Arena (Space da comunidade)
- Versão WebGPU ONNX de Bartholomheow (comunidade)