Imagem IA sem censura · OpenMOSS
MOSS-Image-SFT sem censura: rascunhos em 8 passos, gradientes limpos e tags de anime
MOSS-Image-SFT é a versão pronta para uso do MOSS-Image, modelo de pesos abertos com 5B parâmetros da equipe OpenMOSS, lançado em 16 de outubro de 2026. No primeiro mês, a comunidade o transformou em uma ferramenta bem mais amigável: uma versão destilada de 8 passos para rascunhos rápidos, um LoRA que remove faixas verticais de cor, pesos FP16 para placas de vídeo mais antigas e o hábito crescente de escrever prompts de anime como tags simples. Este guia reúne esses truques, além de templates de prompt para colar direto.
- Comece grátis
- Sem filtros
- Roda no navegador
Gerador de imagens alternativo sem censura
Texto para imagemDescreva a imagem que deseja, com as palavras entre aspas. Adicione uma foto de referência para editá-la ou deixe vazio para texto para imagem.
Do Base ao SFT: o checkpoint feito para criar imagens
A OpenMOSS lançou dois checkpoints do mesmo modelo single-stream de 5B. O Base não tem pós-treinamento e serve como ponto de partida limpo para treinar LoRAs. O MOSS-Image-SFT é o Base ajustado com dados selecionados, então entrega boas imagens logo de cara e entende três tipos de prompt: frases comuns, listas de tags no estilo anime e layouts JSON com coordenadas. As amostras oficiais de quadro branco mostram textos mais bem agrupados e layouts mais organizados no lado SFT, embora a OpenMOSS não tenha publicado um número para essa diferença. Se você só quer imagens, este é o checkpoint a carregar; se quer treinar seu próprio estilo, comece pelo Base. Um mês após o lançamento, a página do SFT no Hugging Face mostrava 913 curtidas, cerca de 19.500 downloads no último mês e 68 Spaces construídos sobre ele.
8 passos em vez de 50: destilação DMD e Spectrum
A receita oficial pede 50 passos de amostragem com guidance, o que é cuidadoso, mas lento. A comunidade do MOSS-Image-SFT resolveu isso rápido. lodestones publicou o MOSS-Image-SFT-8-steps-dmd, uma versão destilada que gera uma imagem em 8 passos e vem com um adaptador LoRA para ComfyUI. Além disso, o nó ComfyUI-Spectrum-MOSS acelera ainda mais a amostragem pulando trabalho entre passos parecidos. A OpenMOSS diz que sua própria versão DMD ainda está em desenvolvimento. Ninguém publicou ainda um benchmark justo de velocidade ou qualidade, então teste na sua placa, mas a divisão que a maioria adota é simples:
| Uso | Escolha | Por quê |
|---|---|---|
| Encontrar uma composição, ideias em lote | DMD de 8 passos | Muitos rascunhos no tempo de uma renderização completa |
| Pôsteres com muito texto | 50 passos oficiais | Texto e pequenos detalhes ficam melhores |
| Foto final de produto ou capa | 50 passos, opcionalmente com Spectrum | Mantém a qualidade e reduz a espera |
Corrija faixas de cor, placas FP16 e ajustes de SLG
Duas reclamações surgiram cedo. Alguns usuários do MOSS-Image-SFT viram listras verticais sutis, ou banding, em céus e gradientes suaves. MATLOWAI respondeu com o MOSS-Image-SFT-DeBand, um pequeno LoRA mais um preset de ComfyUI que suaviza essas listras. O segundo problema era hardware: os pesos oficiais estão em BF16, que muitas GPUs antigas não suportam. KBlueLeaf lançou o MOSS-Image-FP16-fixed, pesos ajustados para rodar sem problemas em FP16. O último ajuste é o skip-layer guidance (SLG). O model card define que o ramo negativo pula a camada 22, e testes da comunidade mostraram que as camadas 24 ou 26 também funcionam.
- Listras em céus ou paredes: carregue o LoRA DeBand com seu preset.
- Imagens pretas ou quebradas em placa antiga: troque para os pesos FP16-fixed.
- Quer um visual mais fotográfico: experimente desligar o SLG, mas fique de olho em mãos e pequenos detalhes.
- Prompts curtos ficam sem graça: aumente o CFG de 3 para perto de 6, como sugere o model card.
Três jeitos de escrever um prompt para o MOSS-Image-SFT
A maioria dos modelos de imagem só lê frases. O MOSS-Image-SFT lê três formatos e aceita prompts de até 4K tokens, em inglês (recomendado) ou chinês. Frases comuns são melhores para fotos e pôsteres com texto: coloque as palavras exatas entre aspas e use \n dentro do texto citado quando precisar de quebra de linha. Listas de tags separadas por vírgulas soam naturais para fãs de anime. JSON é para layouts rígidos, em que cada título, produto ou selo ganha sua própria caixa. No formato JSON, as caixas usam a ordem yxyx medida a partir do centro da tela, então numa imagem de 1024 por 1024 cada eixo vai de -512 a 512. A skill oficial Prompt Enhancer no repositório do GitHub pode converter um esboço em pixels nessas coordenadas centralizadas para você.
{
  "summary": { "caption": "Clean perfume ad, black stone, soft rim light" },
  "items": [
    { "label": "product", "caption": "glass perfume bottle", "bbox": [-200, -160, 360, 160] },
    { "label": "title", "caption": "thin gold serif", "bbox": [-460, -300, -320, 300], "text": "NOIR 07" }
  ],
  "bbox_format": "yxyx"
}
Templates de prompt para copiar e remixar
Estes templates do MOSS-Image-SFT seguem o conselho oficial: descreva a cena, coloque o texto entre aspas e diga onde ele fica. Use cerca de 1 a 2 megapixels, qualquer proporção em múltiplos de 16, mantenha a seed fixa e mude um detalhe por vez. A amostra oficial do bilhete na geladeira é um bom aquecimento: um post-it na porta da geladeira, escrito à mão em chinês, lembrando alguém de comprar leite e ovos.
- Pôster de viagem: "Minimalist travel poster, bold title text \"EXPLORE KYOTO\" at top, red torii gate at sunset, small subtitle \"Autumn 2026\" at bottom, flat illustration, high contrast"
- Foto de produto: "Product photo of a glass perfume bottle on wet black stone, label text \"NOIR 07\", soft rim light, studio"
- Bilhete escrito à mão: "A wide view of a refrigerator beside a kitchen counter, a sticky note on the door handwritten: \"Buy milk and eggs!\""
- Capa vertical: "Vertical web novel cover, adult couple in the rain under one umbrella, title \"Midnight Contract\" in silver letters, cinematic"
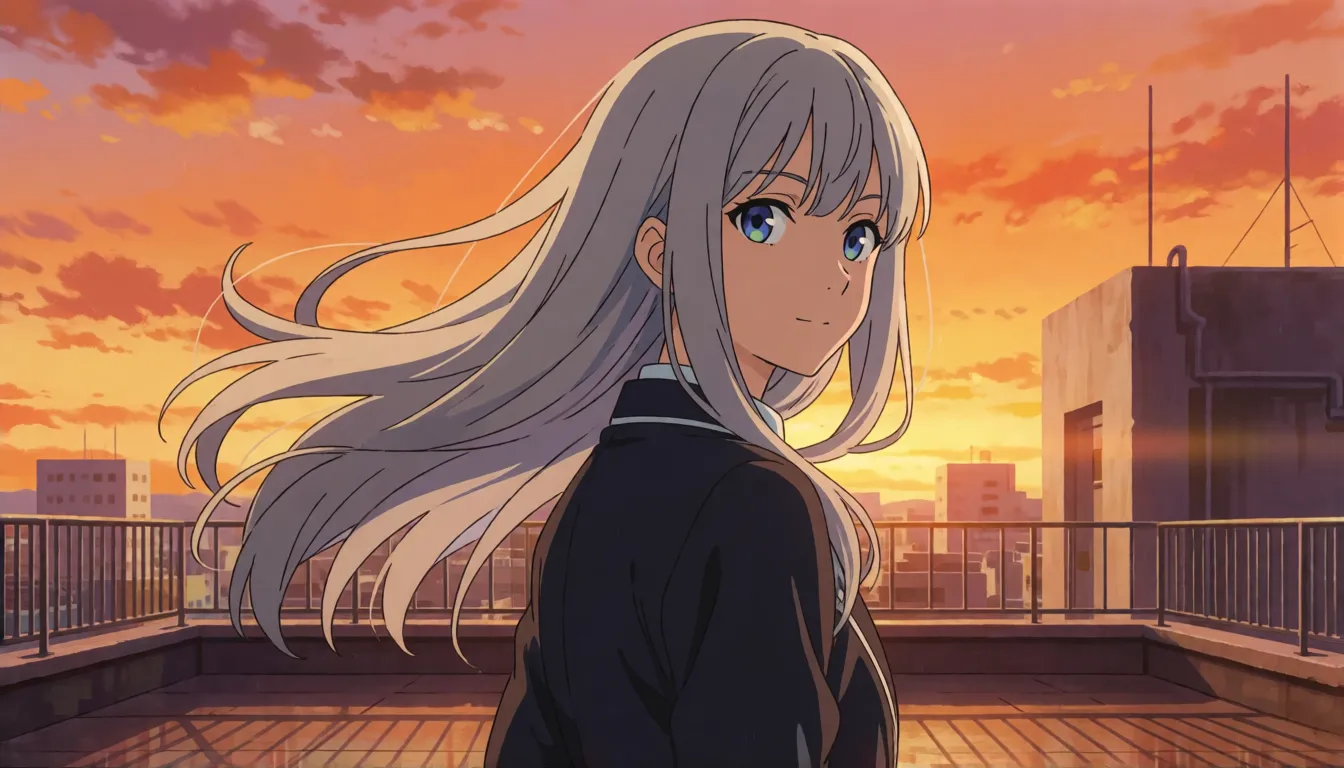
- Tags de anime: "best quality, highres, newest, 1girl, adult, silver hair, school rooftop, sunset, wind, looking back"
Arte de anime com tags no estilo Danbooru
Criadores de anime têm uma boa surpresa com o MOSS-Image-SFT: dá para abandonar as frases longas e escrever tags curtas, como num site booru. O guia oficial do usuário até sugere uma ordem: tags de qualidade primeiro, depois score, meta e ano, em seguida o personagem, a série, o artista e por fim as tags gerais de pose, roupa e cenário. Seguir essa ordem mantém as partes importantes na frente. Notas iniciais da comunidade dizem que tags com nomes de artistas têm efeito mais fraco do que em modelos dedicados a anime, então descreva o estilo em palavras quando isso importar e acrescente uma frase completa depois das tags para iluminação ou clima.
- Qualidade → Score → Meta → Ano → Personagem → Série → Artista → Gerais
- Comece com: best quality, highres, newest
- Adicione pose e cenário por último: looking back, rooftop, sunset, wind
Pôsteres e designs em que as palavras importam
Letras legíveis são o motivo pelo qual muita gente experimenta o MOSS-Image-SFT. O relatório técnico indica cobertura média de texto de 96,3% no benchmark de texto longo LLTB, a melhor entre os modelos de pesos abertos, e as amostras oficiais estão cheias de quadros brancos, placas e bilhetes escritos à mão em chinês e inglês. Isso torna o MOSS-Image-SFT ideal para pôsteres bilíngues de eventos, banners de loja com preço, quadrinhos com balões de fala, infográficos e capas verticais para minisséries e web novels. Como qualquer proporção funciona, um mesmo prompt serve para um post quadrado, um banner largo e um story alto de celular.
Treine seu próprio LoRA de personagem ou estilo
Pesos abertos significam que você pode ensinar ao modelo seu próprio personagem ou estilo de arte. O KohakuMossTrainer, lançado em 18 de outubro, treina adaptadores LoRA e LyCORIS com apenas 6GB de VRAM, e o DiffSynth-Studio suporta tanto fine-tuning completo quanto LoRA. O conselho habitual é treinar no Base e depois carregar o resultado com o MOSS-Image-SFT. O ecossistema ainda é pequeno, mas cresce rápido: a árvore de modelos do SFT no Hugging Face lista 55 adaptadores, 23 fine-tunes e 2 merges. Escreva as legendas no mesmo estilo que pretende usar nos prompts: tags para personagens de anime e frases para estilos fotográficos.
Online, API, arquivos quantizados e servidores
Você não precisa de instalação local para experimentar o MOSS-Image-SFT. O Space oficial no Hugging Face roda no navegador, e a plataforma de API MOSI oferece acesso hospedado desde 20 de outubro (confira o site para preços atuais). Para equipes que rodam seu próprio serviço, SGLang e vLLM-Omni suportam o modelo desde o primeiro dia e ambos publicam receitas de implantação. Quem tem pouca VRAM pode explorar as 48 versões quantizadas na árvore de modelos, incluindo arquivos GGUF; confira em cada card o loader necessário. No Mac, Draw Things e DiffusionBee são os apps mais procurados para geração local.
MOSS-Image-SFT vs FLUX e Qwen-Image
Não existe uma pontuação oficial comparando os modelos diretamente, então esta é uma comparação prática. O MOSS-Image-SFT é pequeno, com cerca de 5B parâmetros, o que facilita rodar e treinar em placas comuns. Seus pontos fortes são textos longos em chinês e inglês e o controle de layout via JSON. FLUX e Qwen-Image são maiores e têm bibliotecas muito maiores de LoRAs e fine-tunes da comunidade, além de modelos de edição separados, então ainda vencem quando você precisa de um estilo específico que alguém já treinou.
| MOSS-Image-SFT | Família FLUX | Qwen-Image | |
|---|---|---|---|
| Tamanho | Cerca de 5B | Maior | Maior |
| Prompts de layout com coordenadas | Sim, caixas JSON | Não | Não |
| Texto bilíngue longo | Principal ponto forte | Principalmente inglês | Forte |
| LoRAs da comunidade | Jovem, em crescimento | Muito grande | Grande |
MOSS-Image-SFT sem censura e arte adulta
A OpenMOSS não lançou uma versão sem censura. Os pesos do MOSS-Image-SFT são abertos e nada os filtra quando rodam localmente, mas o próprio prompt negativo recomendado contém a palavra nsfw, o que mostra que a configuração padrão tende a imagens seguras. Existem LoRAs de temática adulta na comunidade, mas a qualidade e a origem variam, então verifique com cuidado. Direções adultas populares são editoriais de moda praia, pôsteres pin-up e capas de fantasia com personagens claramente adultos. Se preferir pular a configuração, o Spicy AI oferece geração de imagens sem censura semelhante no navegador.
Editoriais de moda praia
Ensaios ensolarados na praia e na piscina com modelos adultos e título de revista no topo.
Pôsteres pin-up
Pin-ups retrô de personagens adultos com slogan bem posicionado.
Capas de fantasia
Heróis e feiticeiras adultos para capas de livros ou jogos com títulos legíveis.
- Use a versão de 8 passos para explorar e renderize a escolhida com todos os passos.
- Coloque entre aspas cada palavra que quer impressa e diga onde ela fica.
- Deixe claro que todas as pessoas retratadas são adultas (18+) e nunca retrate pessoas reais sem consentimento.
Crie imagens de temática adulta no navegador, sem GPU nem download.
Abrir o gerador de imagens →O que a comunidade está criando após um mês
Os números contam a história: logo após o lançamento a página do SFT tinha cerca de 130 curtidas e, um mês depois, a página do SFT passou de 900 curtidas, com 48 arquivos quantizados e dezenas de adaptadores na árvore de modelos e cerca de 2,6 mil estrelas no GitHub. A maioria das imagens do MOSS-Image-SFT compartilhadas se encaixa em poucos grupos: pôsteres de viagem retrô, capas de revista bilíngues, bilhetes escritos à mão e memes de quadro branco, personagens de anime feitos com prompts em tags e fotos de produto com clima marcante para lojas online.
- Pôsteres retrô com títulos grandes e legíveis
- Capas bilíngues e flyers de eventos
- Bilhetes à mão, recibos e piadas de quadro branco
- Personagens de anime a partir de tags estilo booru
- Fotos de produto com rótulos no estilo de marca
MOSS-Image-SFT auto-hospedado vs geração online no Spicy AI
| Implantação local (pesos oficiais) | Spicy AI online | |
|---|---|---|
| Filtros de conteúdo | Nenhum ao rodar localmente | Sem filtros de conteúdo |
| Pesos abertos | Sim | Não é necessário — roda no navegador |
| Modelo | Checkpoint SFT mais complementos da comunidade | Modelo de imagem sem censura semelhante, hospedado online |
| Custo para começar | Sua própria GPU | Plano gratuito disponível |
Perguntas frequentes
Qual é a diferença entre MOSS-Image-SFT e Base?
O SFT é o Base ajustado com dados selecionados, então gera imagens melhores logo de início e entende frases, tags e JSON. O Base não tem pós-treinamento e é melhor para treinar LoRAs. A OpenMOSS não publicou uma comparação numérica.
Preciso usar 50 passos?
50 passos é a recomendação oficial. A versão DMD de 8 passos da comunidade, feita por lodestones, reduz isso bastante; uma versão DMD oficial ainda está em desenvolvimento.
Como corrijo listras verticais ou banding?
Experimente o LoRA comunitário MOSS-Image-SFT-DeBand com seu preset de ComfyUI ou teste os ajustes de skip-layer guidance.
Minha GPU não suporta BF16. Ainda consigo rodar?
Sim. Os pesos comunitários MOSS-Image-FP16-fixed, de KBlueLeaf, foram feitos para placas que só suportam FP16.
Ele consegue escrever texto em chinês?
Sim. Ele renderiza textos longos em chinês e inglês, com cobertura média de 96,3% no benchmark LLTB segundo o relatório técnico. Adicione \n dentro do texto citado para quebras de linha exatas.
Posso usar tags de anime?
Sim. A ordem oficial é Quality, Score, Meta, Year, Character, Series, Artist e, por fim, tags General.
O Spicy AI é afiliado à OpenMOSS?
Não. O Spicy AI é uma plataforma independente e não é afiliado nem endossado pela OpenMOSS. O nome do modelo é marca registrada de seu respectivo proprietário.
Fontes
- Model card do MOSS-Image-SFT (Hugging Face)
- Model card do MOSS-Image-Base (Hugging Face)
- Repositório OpenMOSS (GitHub)
- Guia do usuário: prompts e configurações (GitHub)
- Relatório técnico (arXiv 2610.23374)
- Versão destilada DMD de 8 passos (lodestones)
- LoRA DeBand (MATLOWAI)
- Pesos FP16-fixed (KBlueLeaf)
- Nó ComfyUI-Spectrum-MOSS
- KohakuMossTrainer
- Demo online oficial (Hugging Face Space)
- Receita de implantação SGLang
- Receita vLLM-Omni