빠른 AI 이미지 생성 · 속도 애드온
P-Q-Image-2.1: 단 6스텝으로 이미지 생성과 편집
이미지 한 장마다 40스텝 샘플링을 기다리다 보면 이것저것 시험해 보는 재미가 사라집니다. P-Q-Image-2.1이 그 문제를 해결합니다. 오픈소스 pruna 툴킷을 만든 속도 최적화 전문 팀 PrunaAI가 공개한 이 도구는 Alibaba의 오픈 웨이트 모델 Qwen-Image-2.1에 붙이는 작은 애드온으로, 단 6스텝 만에 새 이미지를 그리고 기존 이미지를 편집하며 네거티브 프롬프트를 조정할 필요도 없습니다. PrunaAI에 따르면 일반적인 40스텝 베이스보다 최대 약 6.3배 빠르게 생성합니다.
- 무료로 시작
- 빠른 초안
- 브라우저에서 실행
- 제작사
- PrunaAI
- 호환 모델
- Qwen-Image-2.1 (베이스 웨이트 필요)
- 최신 버전
- v0.2: 6-steps와 6-steps-upsampled
- 기능
- 텍스트로 이미지 생성 및 최대 3장의 참조 이미지를 활용한 편집
- 속도
- 40스텝 베이스 대비 최대 약 6.3배
- 오픈 웨이트
- 예, Hugging Face에 공개
무검열 대체 이미지 생성기
텍스트→이미지원하는 이미지를 설명하거나, 사진을 업로드하고 편집 내용을 설명하세요.
Qwen-Image-2.1을 위한 터보 버튼
P-Q-Image-2.1은 새로운 엔진이라기보다 성능을 끌어올리는 칩에 가깝습니다. 이것은 LoRA, 즉 Qwen-Image-2.1 위에 얹히는 가벼운 파일로, 훨씬 적은 스텝 만에 완성된 이미지에 도달하도록 모델을 학습시킵니다. 베이스 모델과 텍스트 인코더, VAE는 그대로이므로 원본 웨이트는 여전히 필요하지만, 베이스가 사랑받는 이유인 이미지 속 선명한 글자, 투명 배경 출력, 지시 기반 편집은 모두 그대로 누릴 수 있습니다. 달라지는 것은 기다리는 시간입니다. CFG를 1로 두고 네거티브 프롬프트를 생략하면 어댑터에 따라 5, 6, 8스텝 만에 결과를 얻습니다. PrunaAI는 최대 약 6.3배라는 수치를 H100 1장, BF16, 배치 크기 1 조건에서 일반적인 40스텝 실행과 비교해 측정했습니다. 이 프로젝트는 2026년 9월 Pruna-Qage-2.1이라는 이름으로 시작했다가 지금의 이름으로 바뀌었습니다.
v0.1에서 v0.2로: 스텝 수는 하나로, 어댑터는 더 똑똑하게 두 가지로
첫 릴리스인 v0.1은 2026년 9월 23일 무렵 공개되었으며, 권장 기본값인 8스텝 어댑터와 더 빠르지만 눈에 띄게 흐릿한 5스텝 어댑터 중에서 고르는 방식이었습니다. 0.2 버전은 이 절충을 없애고 증류를 한층 더 밀어붙인 단일 6스텝 스케줄로 통일한 뒤, 이를 두 가지 유형으로 나눴습니다. 기본 6-steps 어댑터는 편집할 때 원본 사진을 더 잘 유지하므로 얼굴, 로고, 제품 디테일이 살아남습니다. 6-steps-upsampled 어댑터에는 Qwen 기본 프롬프트 확장기가 내장되어 있어, 다섯 단어짜리 아이디어도 별도의 언어 모델 호출 없이 풍부하게 묘사된 장면으로 돌아옵니다. 같은 릴리스에서 PrunaAI가 직접 만든 첫 ComfyUI 내보내기 파일과 바로 쓸 수 있는 워크플로 6개도 함께 나왔습니다. v0.1 시절에는 커뮤니티 사용자들이 파일을 직접 변환해야 했습니다.
| 어댑터 | 스텝 | 강점 | 추천 용도 |
|---|---|---|---|
| v0.1 8-steps | 8 | 첫 릴리스 중 최고 품질 | 구형 환경에서 무난한 기본값 |
| v0.1 5-steps | 5 | 가장 빠른 옵션 | 품질이 떨어져도 되는 러프 초안 |
| v0.2 6-steps | 6 | 편집 시 원본 이미지를 충실하게 유지 | 의상 교체, 제품 편집, 인물 사진 |
| v0.2 6-steps-upsampled | 6 | 프롬프트 확장 내장 | 짧은 프롬프트로도 풍성한 결과를 원할 때 |
Upsampled와 6-steps: 알맞은 어댑터 고르기
v0.2의 두 파일은 크기, 강도, 샘플러가 같으므로 선택은 전적으로 프롬프트를 쓰는 취향에 달려 있습니다. 길고 정확한 프롬프트를 쓰거나, 사진을 편집하면서 인물이나 제품을 알아볼 수 있게 유지해야 한다면 6-steps 어댑터를 불러오세요. "비 내리는 네온 골목의 사이버펑크 여주인공, 시네마틱"처럼 짧은 아이디어만 입력하고 조명, 렌즈, 세트 연출은 모델에 맡기고 싶다면 upsampled 어댑터가 재미있는 선택입니다. PrunaAI에 따르면 이 어댑터는 Qwen 기본 확장기를 꽤 충실하게 흉내 내지만 완벽하지는 않으므로, 실제 프롬프트 확장 모델을 먼저 거친 결과와는 다를 수 있습니다.
- 얼굴, 제품, 브랜드 디테일 편집: 6-steps.
- 짧고 재치 있는 프롬프트와 무드보드: 6-steps-upsampled.
- 속도가 최우선이고 품질은 부차적일 때: v0.1 5-steps.
- 기존 v0.1 워크플로에서 가장 보수적인 선택: v0.1 8-steps.
- 어댑터는 한 번에 하나만 불러오고, 그 어댑터에 맞는 시그마 스케줄을 사용하세요.
학습은 1K 이미지와 최대 3장의 참조 이미지를 대상으로 했습니다. 1024×1024에서 시작하세요. 2K 출력이나 더 많은 참조 이미지도 작동할 수는 있지만 어댑터의 학습 범위를 벗어납니다.
6스텝 렌더링이 진가를 발휘하는 곳
속도는 한 장이 아니라 많은 이미지가 필요할 때 가장 중요합니다. 그래서 이 애드온은 대량으로 반복 작업하는 크리에이터들 사이에서 인기를 얻었습니다. 40스텝에서 6스텝으로 줄이면 밤새 돌리던 느린 배치 작업을 눈앞에서 지켜볼 수 있게 되고, ComfyUI에서의 실시간 조정도 거의 인터랙티브하게 느껴집니다.
성인 콘텐츠 쪽에서 인기 있는 세트는 쉽게 떠올릴 수 있습니다. 해변 휴가 화보, 수영장 파티 룩, 레트로 핀업 수영복 포스터 등을 기존 사진을 편집해 옷만 바꾸는 방식으로 만듭니다. 베이스 모델이 글자를 잘 렌더링하기 때문에 셀러와 포스터 제작자들은 헤드라인 텍스트에도 이를 활용하며, 빠른 속도 덕분에 예전에 40스텝 렌더링 한 번에 걸리던 시간에 여러 레이아웃을 시험해 볼 수 있습니다.
| 누가 | 무엇을 만드나 | 스텝 감소가 도움이 되는 이유 |
|---|---|---|
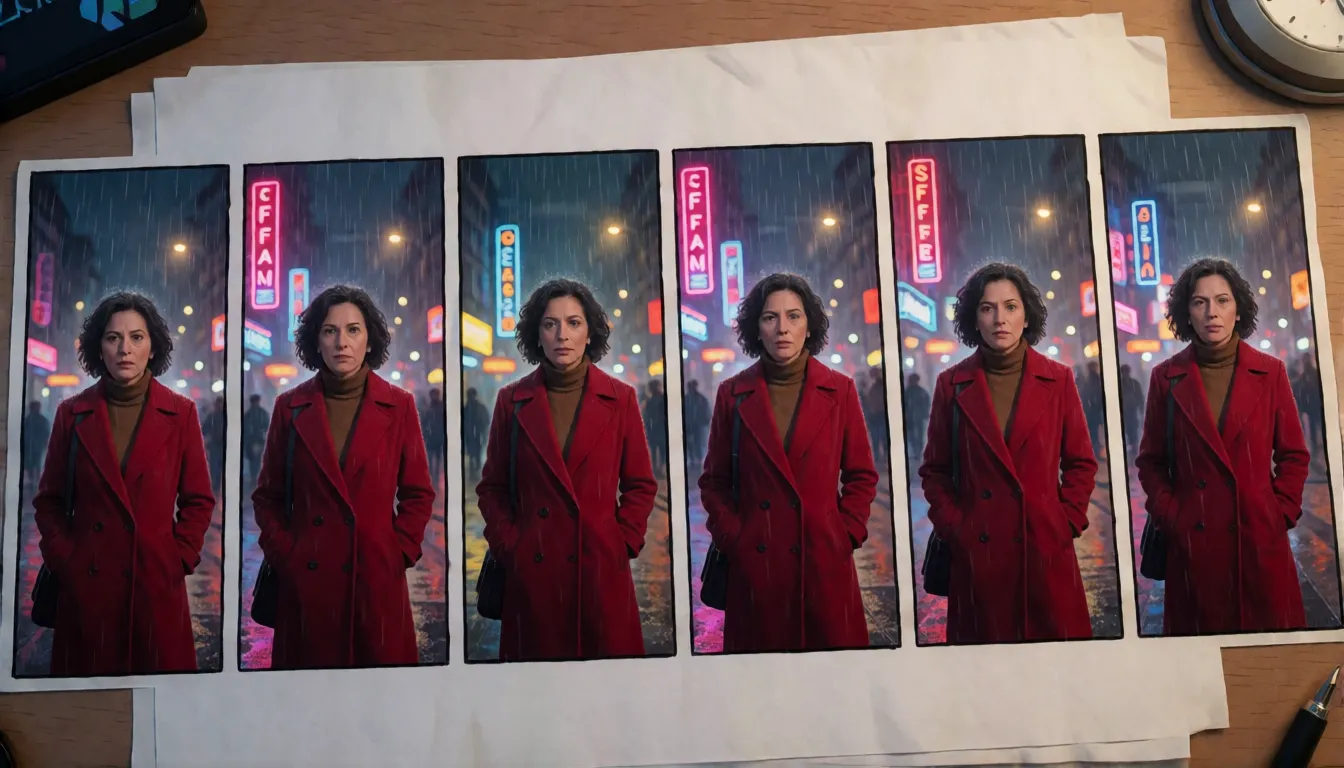
| 숏드라마·AI 웹툰 팀 | 한 캐릭터가 반복 등장하는 세로형 스토리보드 컷 수십 장 | 다양한 앵글과 분위기를 시험한 뒤 가장 좋은 것을 다듬을 수 있음 |
| 온라인 셀러 | 흰 배경 제품 사진, 배경 교체, 색상 바리에이션, 세일 포스터 | 카탈로그 전체의 바리에이션을 한 번에 만들 수 있음 |
| 패션·가상 피팅 크리에이터 | 최대 3장의 참조 이미지로 인물 + 의상 + 장소를 합성 | 얼굴 일관성을 유지하며 룩을 빠르게 교체 |
| ComfyUI 실험파 | 프롬프트 입력과 미리보기를 반복하는 세션 | 타이핑하는 속도만큼 빠르게 변경 결과를 확인 |
| 성인(18세 이상) 크리에이터 | 가상 인물 또는 동의한 성인의 비키니, 수영복, 란제리 의상 교체 | 6-steps 어댑터는 의상만 바꾸면서 얼굴과 체형을 유지 |
복사해서 바로 쓰는 프롬프트 템플릿
이 템플릿들은 베이스 모델에서 가장 잘 통하는 방식을 따릅니다. 먼저 피사체를 묘사하고, 이어서 배경, 조명, 렌즈를 쓰며, 이미지에 넣을 글자는 따옴표로 감쌉니다. 6-steps 어댑터에서는 전체 템플릿을, upsampled 어댑터에서는 짧은 한 줄이면 충분합니다. 상황에 맞게 고쳐 쓰기 위한 출발점일 뿐, 제작사가 제공한 샘플은 아닙니다.
- 전체 텍스트→이미지 (6-steps): "[피사체], [포즈나 동작], [의상 디테일], [장소와 시간대], [조명: 부드러운 창가 빛 / 골든아워 역광], [렌즈: 35mm 상반신 / 로우 앵글], [스타일: 광고 사진 / 애니메이션], 상단에 포스터 제목 "YOUR TITLE""
- 짧은 프롬프트 (upsampled): "비 내리는 네온 거리의 사이버펑크 여주인공, 시네마틱"
- 의상 교체 (18세 이상, 가상 인물 또는 동의한 성인): "얼굴, 헤어스타일, 포즈, 배경은 그대로 두고 상의를 빨간 스트링 비키니로 교체, 사실적인 원단 질감, 조명은 원본과 일치"
- 배경 교체: "피사체와 그 윤곽은 유지하고 배경을 몰디브 해변으로 교체, 자연스러운 그림자 추가"
- 참조 이미지 3장 합성: "이미지 1의 인물이 이미지 2의 의상을 입고 이미지 3의 장소에 서 있음, 전신, 자연광"
- 스토리보드 컷: "세로 9:16, [이미지 1의 캐릭터], 몸을 돌려 어깨 너머로 뒤돌아봄, 긴장된 분위기, 시네마틱 조명, 얕은 피사계 심도"
- 제품 포스터: "이미지 1의 제품을 대리석 카운터 위에, 왼쪽에 큰 제목 "SUMMER DROP", 그 아래 작은 문구 "이번 주 20% 할인", 고급스럽고 부드러운 조명"
작성 팁: 짧고 모호한 프롬프트는 기본 어댑터에서 밋밋해 보이기 쉬우니, 디테일을 더하거나 upsampled 파일로 바꾸세요.
P-Q-Image-2.1 ComfyUI 워크플로와 설정
PrunaAI는 ComfyUI에서 바로 쓸 수 있는 저장소 PrunaAI/P-Q-Image-2.1-Comfy를 공개하고 있으며, 여기에는 BF16 단일 파일 LoRA와 버전별 텍스트→이미지 및 편집용 워크플로 파일 6개가 들어 있습니다. 사용 중인 ComfyUI 빌드가 Qwen-Image-2.1을 기본 지원한다면 커스텀 노드는 필요 없으며, 어댑터는 내장된 LoraLoaderModelOnly 노드로 강도 1.0에서 불러옵니다.
메모리: PrunaAI는 일반 소비자용 GPU 기준 수치를 공개하지 않았습니다. 실질적인 방법은 int8 베이스와 int8 텍스트 인코더를 함께 쓰는 것으로, 메모리 사용량을 줄여 줍니다. 양자화와 속도 어댑터는 서로 다른 문제를 다루므로 함께 사용할 수 있습니다.
- ComfyUI를 업데이트한 뒤, 베이스 디퓨전 모델(BF16, 또는 메모리를 아끼려면 int8 convrot 빌드), qwen3vl_8b int8 텍스트 인코더, VAE, LoRA를 각각 평소 쓰는 폴더에 넣으세요.
- 해당하는 배포 워크플로를 캔버스로 드래그하세요.
- 샘플러 euler, CFG 1, 네거티브 프롬프트는 비움, LoRA 강도 1.0.
- v0.2 ManualSigmas: 1.0, 0.961054, 0.918949, 0.769302, 0.545554, 0.222292, 0.
- 1024×1024에서 시작한 다음에 더 큰 크기를 시험하세요.
| 흔한 실수 | 대신 이렇게 하세요 |
|---|---|
| Turbo 베이스를 불러옴 | Comfy-Org/Qwen-Image-2.1의 일반 베이스를 사용하세요. PrunaAI는 Turbo와 함께 쓰지 말라고 밝혔습니다 |
| v0.1과 v0.2 시그마를 섞음 | 어댑터마다 고유한 스케줄이 있으니 해당 버전의 워크플로에서 복사하세요 |
| Pruna 어댑터 두 개를 겹쳐 씀 | 한 번에 하나만 불러오세요 |
| 바로 2K로 건너뜀 | 어댑터가 학습된 크기인 1K에서 시작하세요 |
Diffusers로 실행하기
Python 사용자를 위해 모델 카드에는 Diffusers 사용 방법이 나와 있습니다. Qwen/Qwen-Image-2.1에서 QwenImage21Pipeline을 불러오고, PrunaAI/P-Q-Image-2.1 저장소와 원하는 어댑터 파일을 지정해 load_lora_weights를 호출한 뒤, dynamic shifting을 적용한 FlowMatch Euler 스케줄러를 사용합니다. num_inference_steps를 6, true_cfg_scale을 1로 설정하고 KV 캐시를 활성화하세요. 편집할 때는 image 인자로 이미지를 전달합니다. Diffusers 버전은 시프트하지 않은 시그마 [1.0, 0.925, 0.85, 0.625, 0.375, 0.125]에 dynamic shift를 더해 사용합니다. 카드에는 특정 Diffusers 커밋과 transformers 5.17 이상이 지정되어 있으니, 예기치 않은 문제를 피하려면 버전을 맞추세요.
P-Q-Image-2.1 vs Lightning, Turbo, int8
Qwen-Image-2.1을 빠르게 만들려는 사람들은 보통 세 가지 방법을 비교합니다. 커뮤니티의 Lightning LoRA는 4스텝까지 더 낮춥니다. PrunaAI의 어댑터는 6스텝에 내장 프롬프트 확장기와 제작사가 제공하는 편집 워크플로로 맞섭니다. Turbo 베이스는 별개의 고속 체크포인트이며, PrunaAI는 이 애드온과 함께 쓰지 말라고 분명히 밝혔습니다. int8이나 GGUF 양자화는 스텝이 아니라 메모리를 절약하므로 어느 LoRA와도 함께 쓸 수 있습니다. 동일 조건에서 나란히 비교한 신뢰할 만한 테스트는 없으므로, 가장 공정한 조언은 자신의 프롬프트로 둘 다 돌려 보라는 것입니다.
| 방법 | 스텝 | 얻는 것 | 주의할 점 |
|---|---|---|---|
| PrunaAI v0.2 LoRA | 6 | 프롬프트 확장 옵션, 충실한 편집, 제작사 제공 ComfyUI 워크플로 | 1K로 학습됨, Turbo 베이스에는 사용 불가 |
| Lightning LoRA | 4 | 가장 적은 스텝 | 프롬프트 확장 기능 없음 |
| Turbo 베이스 | 소수 | LoRA 없이 속도 향상 | Pruna 어댑터와 호환되지 않음 |
| Int8 / GGUF | 변동 없음 | 메모리 사용량 감소 | 그것만으로는 속도가 빨라지지 않음 |
커뮤니티 반응
업스트림 저장소는 지난 한 달간 48만 회 이상의 다운로드, 좋아요 177개, 토론 스레드 9개를 기록했고 여러 Hugging Face Spaces에서 사용되고 있으며, ComfyUI 저장소도 며칠 만에 첫 좋아요들을 모았습니다. ComfyUI Wiki가 v0.1 출시를 다뤘고, 독일 사이트 Mind-Verse도 Qwen-Image-2.1을 빠르게 만드는 방법으로 이번 릴리스를 소개했습니다. 제작사가 직접 만든 ComfyUI 내보내기 파일이 나오기 전부터 사용자들은 비공식 변환본을 공유하고 있었는데, 이는 로컬 크리에이터들이 얼마나 기다려 왔는지를 보여 줍니다. PrunaAI는 한계에 대해 솔직합니다. v0.1 이미지는 40스텝 풀 베이스에 미치지 못하고, 짧거나 모호한 프롬프트에서 가장 손해를 보며, 출력이 베이스와 정확히 일치하지 않을 수 있고, 웨이트도 최종본이 아닙니다. 그런 솔직함 덕분에 v0.2가 주목받는 것이기도 합니다. v0.2는 바로 그 약점들을 겨냥했기 때문입니다.
무검열 P-Q-Image-2.1이 있나요?
없습니다. 이 애드온은 속도만 바꿀 뿐 NSFW 버전이 없으며, 베이스 모델이 그릴 수 있는 범위를 넓히지도 않습니다. 그 범위는 베이스 웨이트와 함께 불러오는 다른 LoRA에 따라 결정됩니다. "uncensored"라는 이름이 붙은 커뮤니티 업로드 Qwen-Image-2.1은 원본 웨이트 그대로이거나 텍스트 인코더만 바꿔 눈에 띄는 변화가 없는 것으로 보고되었고, Turbo 기반 버전은 애초에 이 어댑터와 함께 쓸 수 없습니다. 브라우저에서 수영복이나 란제리 룩 같은 성인용 편집을 제한 없이 빠르게 하고 싶다면, Spicy AI가 비슷한 무검열 이미지 편집기를 제공합니다.
수영복·비키니 교체
얼굴과 포즈는 그대로 두고 성인의 의상을 비키니나 원피스 수영복으로 바꿉니다.
해변·수영장 세트
인물 사진을 햇살 좋은 해변이나 루프톱 수영장 파티로 옮깁니다.
레트로 핀업 포스터
물방울무늬 수영복, 필름 그레인, 굵은 헤드라인 텍스트.
- 바꿀 부분보다 그대로 둘 부분을 먼저 말하세요.
- 조명과 렌즈를 지정하세요: 골든아워 역광, 85mm 인물 사진.
- 등장하는 모든 사람이 성인(18세 이상)임을 명시하세요.
성인의 사진을 업로드하거나 장면을 묘사해 비키니, 해변, 핀업 룩을 온라인으로 시도해 보세요.
이미지 편집기 열기 →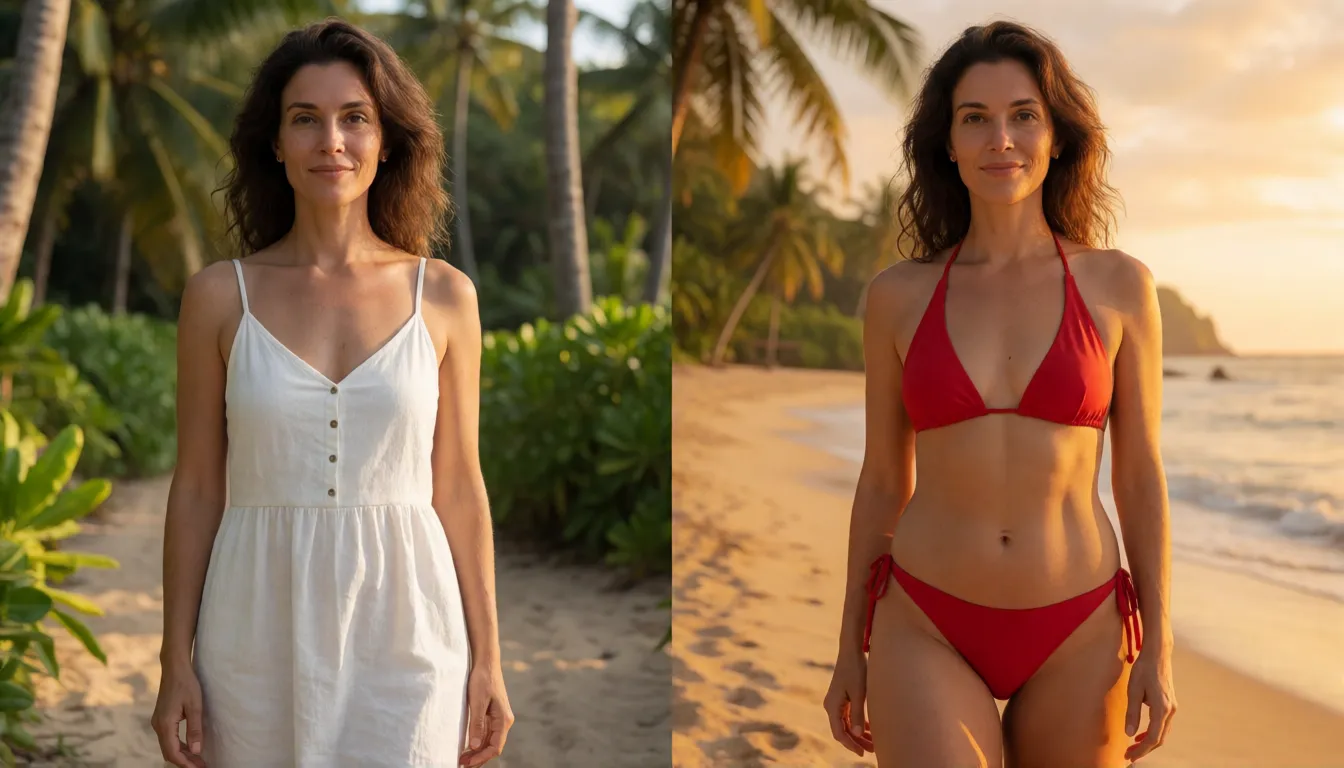
P-Q-Image-2.1 직접 호스팅 vs Spicy AI 온라인 생성
| 로컬 배포 (배포 웨이트) | Spicy AI 온라인 | |
|---|---|---|
| 콘텐츠 필터 | 불러온 베이스 모델과 동일 | 콘텐츠 필터 없음 |
| 오픈 웨이트 | 예 | 필요 없음 — 브라우저에서 실행 |
| 모델 | Qwen-Image-2.1 + 속도 어댑터 | 비슷한 무검열 이미지 편집기, 온라인 호스팅 |
| 시작 비용 | 본인 소유 GPU | 무료 요금제 제공 |
자주 묻는 질문
P-Q-Image-2.1은 독립된 모델인가요?
아니요. PrunaAI가 만든 적은 스텝용 LoRA로, Qwen-Image-2.1 위에 불러와 사용합니다. 베이스 모델, 텍스트 인코더, VAE는 그대로이므로 베이스 웨이트가 필요합니다.
v0.1과 v0.2는 무엇이 달라졌나요?
v0.1은 5스텝과 8스텝 어댑터를 제공했습니다. v0.2는 6스텝으로 통일하고, 편집 결과를 더 잘 유지하는 6-steps 어댑터와 프롬프트 확장이 내장된 6-steps-upsampled 어댑터로 나뉘었으며, 제작사가 제공하는 ComfyUI 파일과 워크플로도 함께 나왔습니다.
얼마나 빨라지나요?
PrunaAI는 40스텝 베이스 대비 최대 약 6.3배라고 밝혔으며, H100 1장, BF16, 배치 크기 1에서 측정한 수치입니다. 일반 소비자용 그래픽카드 기준 수치는 공개하지 않았습니다.
ComfyUI에서는 어떤 설정을 써야 하나요?
Qwen-Image-2.1을 기본 지원하는 ComfyUI 빌드에서 LoraLoaderModelOnly 강도 1.0, euler, CFG 1, 네거티브 프롬프트 없음, 그리고 사용하는 어댑터에 맞는 ManualSigmas를 쓰세요. 베이스는 Turbo가 아닌 일반 버전을 사용하세요.
여러 장의 참조 이미지로 편집할 수 있나요?
네. 학습에는 최대 3장의 참조 이미지를 사용한 편집이 포함되었습니다. 더 많은 참조 이미지나 2K 출력도 작동할 수는 있지만 학습 범위를 벗어납니다.
예전에는 Pruna-Qage-2.1이라는 이름이었나요?
네. v0.1 릴리스는 PrunaAI/Pruna-Qage-2.1로 공개되었습니다. 지금은 PrunaAI의 Hugging Face 계정에서 새 이름으로 제공되며, ComfyUI 파일은 별도 저장소에 있습니다.
이것과 Lightning 4스텝 LoRA 중 무엇을 골라야 하나요?
Lightning이 스텝 수는 더 적습니다. PrunaAI의 v0.2는 프롬프트 확장 옵션과 제작사가 제공하는 편집 워크플로를 갖췄습니다. 동일 조건에서 한 신뢰할 만한 비교는 없으니, 자신의 프롬프트로 둘 다 시험해 보세요.
Spicy AI는 PrunaAI나 Qwen 팀과 제휴되어 있나요?
아니요. Spicy AI는 독립 플랫폼이며 두 곳 어디와도 제휴하거나 보증을 받지 않았습니다. 모든 상표는 각 소유자에게 귀속됩니다.
무료인가요?
매일 제공되는 생성 횟수로 무료로 시작할 수 있고, 더 필요하면 크레딧을 구매하면 됩니다.