음성→영상 · 오픈 웨이트
무검열 Kandinsky S2V 1.0 Pro: 어떤 사진이든 말하고, 몸짓하고, 노래하게
Kandinsky S2V 1.0 Pro에 필요한 것은 사진 한 장, 누군가 말하는 녹음, 짧은 장면 설명 세 가지뿐입니다. 결과물은 그 인물이 입 모양을 맞춰 말하고, 손과 어깨를 움직이며, 처음부터 끝까지 같은 인물로 유지되는 영상입니다. Kandinsky 5.0과 6.0을 만든 Kandinsky Lab이 개발했으며, 웨이트는 무료로 다운로드할 수 있습니다. 이 가이드에서는 크리에이터들이 어디에 활용하는지, 결과가 자연스러워 보이는 이유, 내 GPU에 맞는 버전, 바로 복사해 쓰는 프롬프트, 그리고 다른 오픈 토킹 아바타 모델과의 비교를 다룹니다.
- 사진 + 음성 → 영상
- 얼굴만이 아닌 전신
- 25 fps, 길이 제한 없음
- 16스텝 고속 버전
무검열 대안 영상 생성기
이미지→영상Kandinsky S2V 1.0 Pro처럼 인물 사진 한 장에서 시작합니다. 사진을 업로드하고 인물의 움직임과 장면을 설명하면, 모든 항목이 채워진 상태로 이미지→영상 스튜디오가 열립니다. 등장인물이 모두 18세 이상이라면 성인 테마도 환영합니다.
사진 한 장, 음성 하나로 완성되는 퍼포먼스
대부분의 '사진 말하게 하기' 도구는 얼굴만 움직입니다. 입만 열렸다 닫히고 나머지는 그대로 멈춰 있죠. Kandinsky S2V 1.0 Pro는 다릅니다. 참조 이미지, 깨끗한 음성 녹음(16 kHz 모노), 텍스트 프롬프트를 넣으면 인물 전체가 살아 움직이는 25 fps 영상을 생성합니다. 입술은 모든 음절을 따라가고, 손은 무언가를 설명할 때 사람들이 쓰는 몸짓을 하며, 배경은 프롬프트에 묘사한 대로 움직입니다. 출력은 사진의 화면 비율을 유지하고 원본 오디오 트랙을 그대로 담고 있어 바로 게시할 수 있습니다.
길이도 고정되어 있지 않습니다. Kandinsky S2V 1.0 Pro는 125프레임짜리 5초 블록 단위로 작동하며, 새 블록은 이전 블록이 끝난 지점에서 이어지므로 2분짜리 내레이션은 같은 인물의 2분짜리 영상이 됩니다. 사람들이 가장 먼저 알아차리는 것은 립싱크입니다. 각 프레임은 자신에 해당하는 오디오 구간만 듣기 때문에 입 모양이 뒤처지지 않고 정확한 소리에 맞춰집니다.
사진 한 장으로 만드는 토킹 영상이 뜨는 분야
음성 기반 아바타는 기술 데모를 넘어 일상적인 콘텐츠 제작으로 옮겨 왔고, Kandinsky S2V 1.0 Pro는 여기에 딱 맞습니다. 아래는 연구 자료와 크리에이터 커뮤니티에서 가장 자주 언급하는 작업들로, 모두 하나의 요구를 공유합니다. 스튜디오나 진행자를 섭외하지 않고도 오디오 그대로 말하는 그럴듯한 인물을 화면에 등장시키는 것입니다.
- 숏드라마와 애니메이션 코믹: 캐릭터 초상마다 대사 트랙을 넣으면 스티커가 아닌 실제 장면 같은 전신 대화 샷을 얻을 수 있습니다.
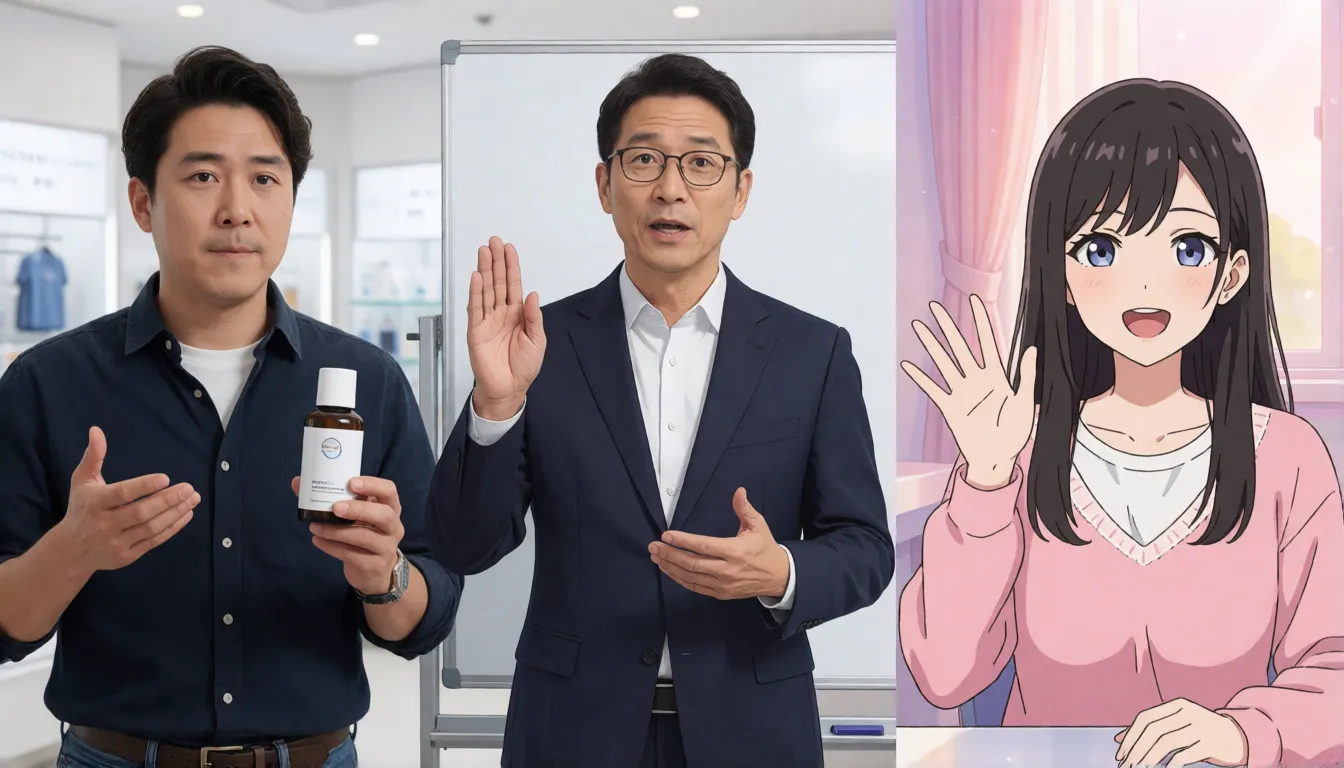
- 제품 및 라이브 커머스 클립: 모델 사진과 제품 소개 녹음만으로 몇 분 만에 진행자 스타일의 설명 영상이 완성됩니다.
- 강의, 뉴스 요약, 교육: 내레이션 원고를 몇 분 동안 계속 제스처를 취하는 가상 강사의 긴 강의로 바꿀 수 있습니다.
- 버추얼 스트리머와 AI 컴패니언: 캐릭터 이미지와 TTS 음성을 결합하면 캐릭터가 카메라 앞에서 대답합니다.
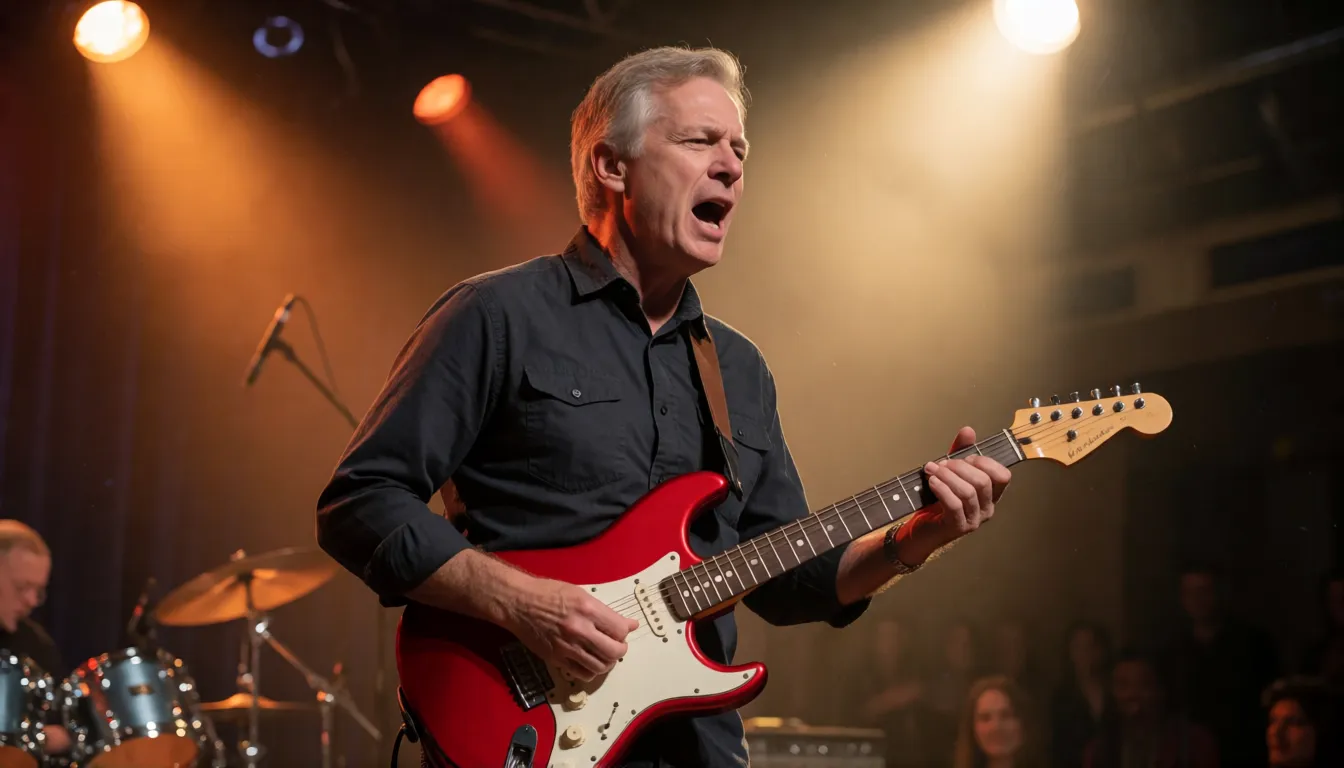
- 음악과 팟캐스트: 공식 Diffusers 예제는 빨간 일렉트릭 기타를 연주하는 백발 남성으로, 공연 영상도 가능하다는 힌트입니다(노래 품질은 팀이 벤치마크하지 않았습니다).
- 다국어 더빙: 사진 한 장은 그대로 두고 다른 언어의 음성 트랙으로 바꿔 넣을 수 있습니다. 학습 캡션은 영어와 러시아어였으므로 큰 프로젝트 전에 다른 언어로 테스트해 보세요.
숏드라마 대화
캐릭터 초상마다 대사를 넣으면 Kandinsky S2V 1.0 Pro가 정확한 립싱크가 적용된 전신 장면을 만들어 줍니다.
제품 설명 영상
모델 사진과 녹음한 제품 소개가 쇼핑몰과 라이브 커머스용 진행자 스타일 클립이 됩니다.
버추얼 호스트
캐릭터 이미지와 TTS 음성을 결합해 스트리머, 강사, 대답하는 AI 컴패니언을 만드세요.
결과가 자연스러워 보이는 이유
Kandinsky S2V 1.0 Pro를 이전의 수많은 립싱크 도구와 구분 짓는 것은 세 가지 설계 선택입니다. 첫째, 전신 애니메이션입니다. 모델이 Kandinsky 5.0 Video에서 출발해 몸, 옷, 장면이 어떻게 움직이는지 이미 알고 있으며, 프롬프트로 제스처와 배경을 조정할 수 있습니다. 둘째, 말과 목소리를 모두 이해합니다. Qwen2.5-Omni가 텍스트 프롬프트를 읽고 음성을 초당 25토큰으로 들어서 움직임이 말투의 에너지와 맞아떨어집니다. 셋째, 3단계 메모리가 참조 사진의 모습을 블록에서 블록으로 이어 주어 긴 테이크에서도 얼굴과 의상이 일관되게 유지됩니다.
Kandinsky S2V 1.0 Pro에는 증류 버전도 있습니다. Pro distill은 50스텝이 아닌 16스텝 만에 결과를 내고 가이던스를 웨이트에 내장했으며, 팀은 약 5배 빠르다고(구성에 따라 4.5~5.6배) 보고하면서도 거의 모든 지표에서 기본 모델과 대등합니다. 가장 강력한 오픈 베이스라인 및 상용 서비스 두 곳과 비교한 논문의 사용자 평가에서 Kandinsky S2V 1.0 Pro는 평균적으로 동등하거나 더 낫다는 평가를 받았고, 가장 선호된 항목은 립싱크였습니다.
- 텍스트 프롬프트로 전신 움직임과 장면 제어
- 프레임별 오디오 어텐션으로 프레임 단위까지 정확한 립싱크
- 블록 단위 이어 생성으로 길이 제한 없음
- MIT 라이선스 오픈 웨이트, 로컬 실행 가능
- Pro 모델은 48 GB GPU 필요(HD는 80 GB)
- 소리는 생성하지 않으므로 직접 녹음한 음성이나 TTS 필요
- 24 GB 카드용 공식 양자화 빌드는 아직 없음
- HD 모드는 해당 해상도로 학습·평가되지 않음
Lite냐 Pro냐, 기본이냐 증류냐: 버전 고르기
Kandinsky S2V 1.0 Pro는 네 개의 체크포인트로 이루어진 제품군에 속합니다. 2B Lite 모델은 빠르고 가벼운 선택지이고, 21B Pro 모델은 얼굴, 손, 움직임 품질이 가장 뛰어납니다. 각 크기 안에서는 증류 버전이 일상용이고, 50스텝 기본 모델은 마지막 디테일까지 추구하는 사람을 위한 것입니다. 두 Pro 체크포인트 모두 1280×768 HD 구성으로도 실행할 수 있습니다.
| 버전 | 크기와 스텝 수 | 적합한 용도 | H100 한 장 기준 속도(영상 1초당) |
|---|---|---|---|
| Lite 2B distill | 2B, 증류 | 빠른 초안, 작은 GPU | 약 8.7초 |
| Lite 2B | 2B, 기본 | 증류 없는 Lite 품질 | Lite distill보다 느림 |
| Pro 21B distill | 21B, 16스텝 | 일상 사용에 최적의 균형 | 약 41.5초(컴파일 시 33.6초) |
| Pro 21B | 21B, 50스텝 | 최고 충실도, 네거티브 프롬프트 지원 | 약 189초 |
| Pro distill HD | 21B, 1280×768 | 더 큰 화면(품질 미검증) | 약 137초 |
GPU 메모리와 속도: 예상치
Kandinsky S2V 1.0 Pro는 큰 모델이므로 약 65 GB의 파일을 내려받기 전에 하드웨어를 계획하세요. 공식 요구 사항은 메모리 48 GB 이상(HD는 80 GB)의 GPU 한 장과 580 이상 버전의 드라이버입니다. H100 한 장에서 표준 해상도 Pro distill의 최대 사용량은 약 46 GiB, HD는 약 55 GiB입니다. 따라서 10초 클립은 카드 한 장에서 대략 6~7분이 걸리고, 공식 8 GPU 구성에서는 영상 1초당 약 11초로 줄어듭니다.
메모리가 부족하다면 VAE 타일링을 켜서 희미한 이음매를 감수하는 대신 최대 사용량을 약 28 GB로 낮출 수 있고, CPU 오프로드를 쓰는 Diffusers 경로는 최대 50 GiB 안팎이며, 작은 카드에서 실험하기엔 Lite 2B distill 모델이 가장 쉽습니다. 공식 양자화 파일이 아직 없기 때문에 일반 소비자용 24 GB 카드라면 클라우드 GPU를 반나절 빌리는 것이 흔한 대안입니다.
체험하는 세 가지 방법: 온라인 데모, ComfyUI, Diffusers
Kandinsky S2V 1.0 Pro의 실력을 보려고 무언가를 설치할 필요는 없습니다. 팀이 Hugging Face에 무료 데모 Space를 운영하고 있고, 좀 더 세밀하게 제어하고 싶은 사람을 위한 Colab과 Kaggle 노트북도 있습니다. 직접 실행할 준비가 되었다면 평소 작업 방식에 맞는 경로를 고르세요.
- 1온라인: Hugging Face에서 Kandinsky-S2V-1.0-Demo Space를 열고, 인물 사진과 짧은 WAV 파일을 업로드한 뒤 프롬프트를 추가해 생성합니다.
- 2커맨드 라인: kandinsky-s2v GitHub 저장소를 클론하고 uv sync를 실행한 다음, s2v_pro_distill.yaml 설정과 --audio, --image, --out 경로로 uv run kandy-s2v generate를 실행합니다. --prompt와 --seed를 추가하면 결과를 조정하고 재현할 수 있습니다.
- 3ComfyUI: 저장소의 dev/comfyui 브랜치로 전환하면 Lite distill과 Pro distill용 노드가 제공되며, 이미지, 오디오, 프롬프트를 샘플러에 연결합니다.
- 4Diffusers: main 브랜치에서 diffusers를 설치하고, ModularPipeline으로 kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers를 불러온 뒤 오디오를 16 kHz로 읽어 들입니다.
어떤 경로를 선택하든 Kandinsky S2V 1.0 Pro는 어떤 설정보다도 좋은 입력 파일에 더 크게 보답합니다. 다음 사항을 기억하세요:
- 인물이 화면의 많은 부분을 차지하는 선명한 정면 사진을 사용하세요. 사진의 화면 비율이 영상의 비율이 됩니다.
- 배경 음악 없이 깨끗한 음성을 녹음하고 16 kHz 모노 오디오로 저장하세요.
- 마음에 드는 결과가 나오면 --seed를 고정한 뒤 프롬프트만 바꿔 변형을 탐색하세요.
토킹 영상용 프롬프트 템플릿
Kandinsky S2V 1.0 Pro에서 대본을 담는 것은 텍스트 프롬프트가 아니라 오디오입니다. 프롬프트로는 인물, 움직임, 배경, 카메라를 묘사하고, 외모가 흐트러지지 않도록 옷과 배경은 참조 사진과 비슷하게 유지하세요. 아래 템플릿은 가장 인기 있는 형식을 다룹니다. 세부 내용만 바꾸고 구조는 그대로 두세요.
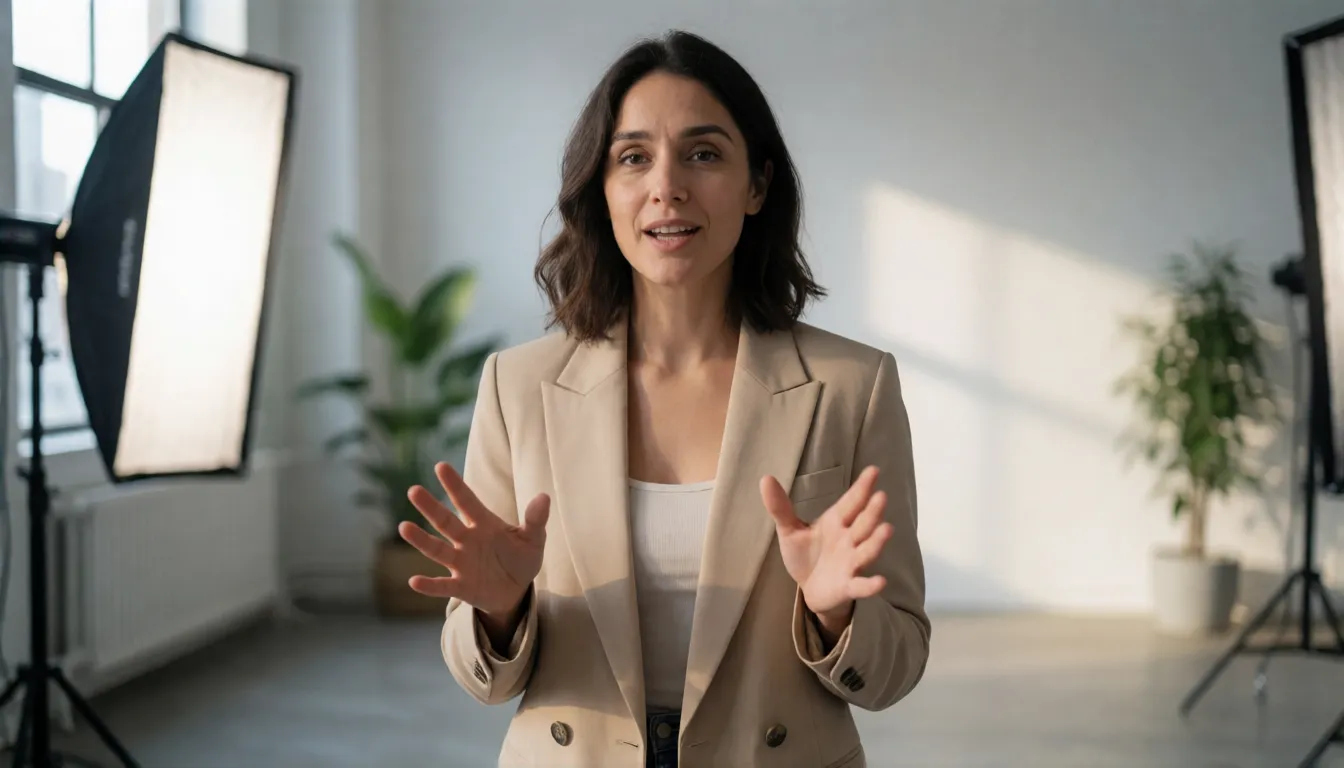
- 진행자: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
- 제품 소개: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- 드라마 대화: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- 뮤지션: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- 강사: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- 버추얼 스트리머: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- 비치 토크(18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- 네거티브 프롬프트(50스텝 모델 전용): blurry face, distorted mouth, extra fingers, flickering, static body.
Wan 2.2 S2V, InfiniteTalk 등 다른 오픈 아바타와의 비교
오픈 토킹 아바타 모델이 많아졌고, Kandinsky S2V 1.0 Pro와 비교해 각각 다른 강점이 있습니다. Alibaba의 Wan2.2-S2V-14B는 이미 커뮤니티 GGUF 파일이 있어 작은 GPU에서도 다루기 쉽습니다. InfiniteTalk와 MultiTalk는 매우 긴 영상과 여러 명의 대화에 집중합니다. LongCat-Video-Avatar 1.5도 ComfyUI용 GGUF 빌드가 있습니다. Kandinsky S2V 1.0 Pro는 관대한 MIT 라이선스, 텍스트로 조종하는 전신 움직임, 16스텝 증류 버전 공개로 돋보이며, 현재 약점은 높은 메모리 요구치와 아직 초기 단계인 커뮤니티 생태계입니다. 논문은 비교 대상 모델의 이름을 밝히지 않으므로 일대일 비교 주장은 검증되지 않은 것으로 보고 직접 클립으로 테스트해 보세요.
| 모델 | 강점 | 작은 GPU에서 쉬운가? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | 전신 움직임, 텍스트로 제어하는 장면, 16스텝 증류 | Lite만 가능, Pro는 48 GB 필요 |
| Wan2.2-S2V-14B | 성숙한 생태계, 영화 같은 움직임 | 예, 커뮤니티 GGUF |
| InfiniteTalk / MultiTalk | 매우 긴 클립, 다인원 대화 | 구성에 따라 다름 |
| LongCat-Video-Avatar 1.5 | ComfyUI를 지원하는 아바타 영상 | 예, 커뮤니티 GGUF |
무검열 토킹 아바타: 지금 할 수 있는 것
Kandinsky S2V 1.0 Pro의 공식 또는 커뮤니티 무검열 파인튜닝은 아직 없습니다. 오픈 웨이트는 온라인 검열 계층 없이 로컬에서 실행되지만, 학습 데이터가 한 사람이 말하는 영상이라 성인 장면을 위해 만들어진 모델은 아니며, 모델 카드는 동의한 사람만 애니메이션화하도록 요청합니다. 아무것도 설치하지 않고 18세 이상 가상 캐릭터의 사진이 말하고, 유혹하고, 수영복이나 란제리 차림으로 포즈를 취하게 하고 싶다면, 저희 이미지→영상 스튜디오에서 인물 사진을 업로드하고 움직임을 설명해 브라우저에서 바로 생성할 수 있습니다.
GPU 없이 브라우저에서 18세 이상 캐릭터 초상을 애니메이션으로 만들어 보세요.
이미지→영상 시작하기 →Kandinsky S2V 1.0 Pro 직접 호스팅 vs Spicy AI 온라인 생성
| 로컬 배포(공식 웨이트) | Spicy AI 온라인 | |
|---|---|---|
| 콘텐츠 필터링 | 직접 실행 시 온라인 필터 없음 | 성인(18+) 콘텐츠 허용 |
| 오픈 웨이트 | 예, Hugging Face에서 MIT 라이선스 | 해당 없음, 온라인 실행 |
| 실제 사용 모델 | Kandinsky S2V Lite 또는 Pro | Spicy AI 자체 영상 모델 |
| 가격 | 웨이트는 무료, GPU 비용은 본인 부담 | 무료로 시작, 추가 사용은 크레딧 |
- 로컬: 내 오디오로 음성 기반 립싱크, 길이 무제한, 완전한 제어.
- Spicy AI: 사진 한 장으로 시작해 브라우저에서 애니메이션화, 하드웨어 불필요.
자주 묻는 질문
Kandinsky S2V 1.0 Pro란 무엇인가요?
Kandinsky S2V 1.0 Pro는 Kandinsky Lab이 만든 210억 파라미터 음성→영상 모델입니다. 참조 사진, 음성 녹음, 텍스트 프롬프트를 넣으면 립싱크가 적용된 25 fps 전신 토킹 영상을 생성합니다. 웨이트는 MIT 라이선스로 공개되어 있습니다.
Pro와 Pro distill의 차이는 무엇인가요?
둘 다 21B 파라미터입니다. distill 버전은 pi-Flow 증류를 사용해 50스텝 대신 16스텝 만에 완료하고 가이던스를 웨이트에 내장하여, 거의 모든 지표에서 기본 모델에 근접한 점수를 내면서도 약 5배 빠릅니다.
Kandinsky S2V 1.0 Pro에는 GPU 메모리가 얼마나 필요한가요?
팀은 48 GB 이상(HD는 80 GB)의 GPU 한 장을 요구합니다. Pro distill은 표준 해상도에서 최대 약 46 GiB를 사용하며, VAE 타일링을 쓰면 희미한 이음매가 생기는 대신 약 28 GB로 낮아집니다. 공식 양자화 빌드는 아직 없습니다.
Kandinsky S2V 1.0 Pro 영상은 얼마나 길게 만들 수 있나요?
오디오 길이만큼 가능합니다. 모델은 5초 블록을 생성하고 각 블록을 이전 블록에서 이어 갑니다. H100 한 장에서 Pro distill로 표준 해상도 영상 1초를 만드는 데 약 41.5초가 걸립니다.
Kandinsky S2V 1.0 Pro가 목소리도 생성하나요?
아니요. 실제 녹음이든 TTS든 음성은 직접 제공해야 하며, 완성된 영상에는 그 원본 오디오 트랙이 담깁니다.
온라인 데모나 ComfyUI 지원이 있나요?
네. Kandinsky Lab이 Hugging Face에 데모 Space를 운영하고 있고, GitHub 저장소의 dev/comfyui 브랜치는 Lite distill과 Pro distill용 ComfyUI 노드를 추가하며, Diffusers 지원은 main 브랜치에서 사용할 수 있습니다.
무검열 Kandinsky S2V 1.0 Pro가 있나요?
2026년 11월 현재로서는 없습니다. 공식 또는 커뮤니티 무검열 파인튜닝은 공개되지 않았습니다. 오픈 웨이트를 직접 실행하거나, 18세 이상 가상 콘텐츠를 허용하는 온라인 이미지→영상 생성기를 이용할 수 있습니다.
출처
- Kandinsky-S2V-1.0-Pro-distill 모델 카드(Hugging Face)
- Kandinsky-S2V-1.0-Pro-distill-Diffusers 모델 카드(Hugging Face)
- Kandinsky-S2V-1.0-Pro 기본 모델(Hugging Face)
- Kandinsky S2V 1.0 온라인 데모(Hugging Face Space)
- kandinskylab/kandinsky-s2v 저장소(GitHub)
- Kandinsky S2V 1.0: 오디오 기반 아바타 영상 생성(arXiv)
- Kandinsky Avatar 프로젝트 페이지
- Wan2.2-S2V-14B GGUF(Hugging Face)
더 많은 무검열 영상 모델 가이드
- 무검열 Kandinsky 6.0
- 무검열 Kling
- 무검열 Kling 2.6
- 무검열 Kling O1
- 무검열 Sora
- 무검열 Veo
- 무검열 Hailuo AI
- 무검열 MiniMax H3 Max
- 무검열 Wan
- 무검열 Wan 3.0
- 무검열 Seedance
- 무검열 Seedance 2.5
- 무검열 Seedance 2.0
- 무검열 Seedance 2.0 Mini
- 무검열 HunyuanVideo
- 무검열 LTX Video
- 무검열 Runway
- 무검열 Pika
- 무검열 Luma Dream Machine
- 무검열 Vidu
- 무검열 PixVerse
- 무검열 EdenLive
- 무검열 Grok Imagine
- 무검열 AI Avatars
- 무검열 HappyHorse 1.0
- 무검열 MiniMax H3 FL2VA Ref2VA
- 무검열 Kling 4.0
- 무검열 Kling 3.0
- 무검열 MiniMax H3 RefMods
- 무검열 Looking Ahead
- 무검열 TaoMate-H3
- 무검열 SANA-Video 2.0
- 무검열 MiniMax H3 Remix
- 무검열 Sora 2
- 무검열 Wan 2.6
- 무검열 LTX-2.5 Slow Motion
- 무검열 VDN MiniMax H3
Spicy AI는 독립 사이트이며 Kandinsky Lab 또는 Sber와 제휴 관계가 없습니다. 모든 콘텐츠에는 성인(18세 이상)만 등장해야 하며, 실존 인물을 본인 동의 없이 애니메이션화하지 마세요.