MiniMax H3 · 커뮤니티 레퍼런스 어댑터
MiniMax H3 RefMods: 학습 없이 모든 장면에 같은 주인공을
AI 영상 크리에이터라면 누구나 아는 고충이 있습니다. 첫 번째 샷에서는 완벽했던 여주인공의 얼굴이 세 번째 샷쯤 되면 조금씩 달라지죠. MiniMax H3 RefMods는 LoRA 문화에서 빌려온 방법으로 이 문제를 해결합니다. 사진 몇 장, 짧은 클립 또는 오디오 샘플을 ComfyUI에 한 번만 넣으면, 캐릭터가 누구인지 기억하는 약 1~1.6MB의 작은 파일이 만들어집니다. 이 파일을 MiniMax H3 영상 워크플로에 연결하면 모델 학습 없이도 같은 얼굴, 의상, 아트 스타일을 언제든 다시 불러올 수 있습니다. 아래에서 기능, 크리에이터들의 활용 사례, 단계별 설정 방법, 프롬프트 템플릿, 그리고 아직 부족한 점까지 솔직하게 정리했습니다.
- 학습 불필요
- 약 1–1.6MB 파일
- 최대 8개 슬롯
- ComfyUI + Fizgig
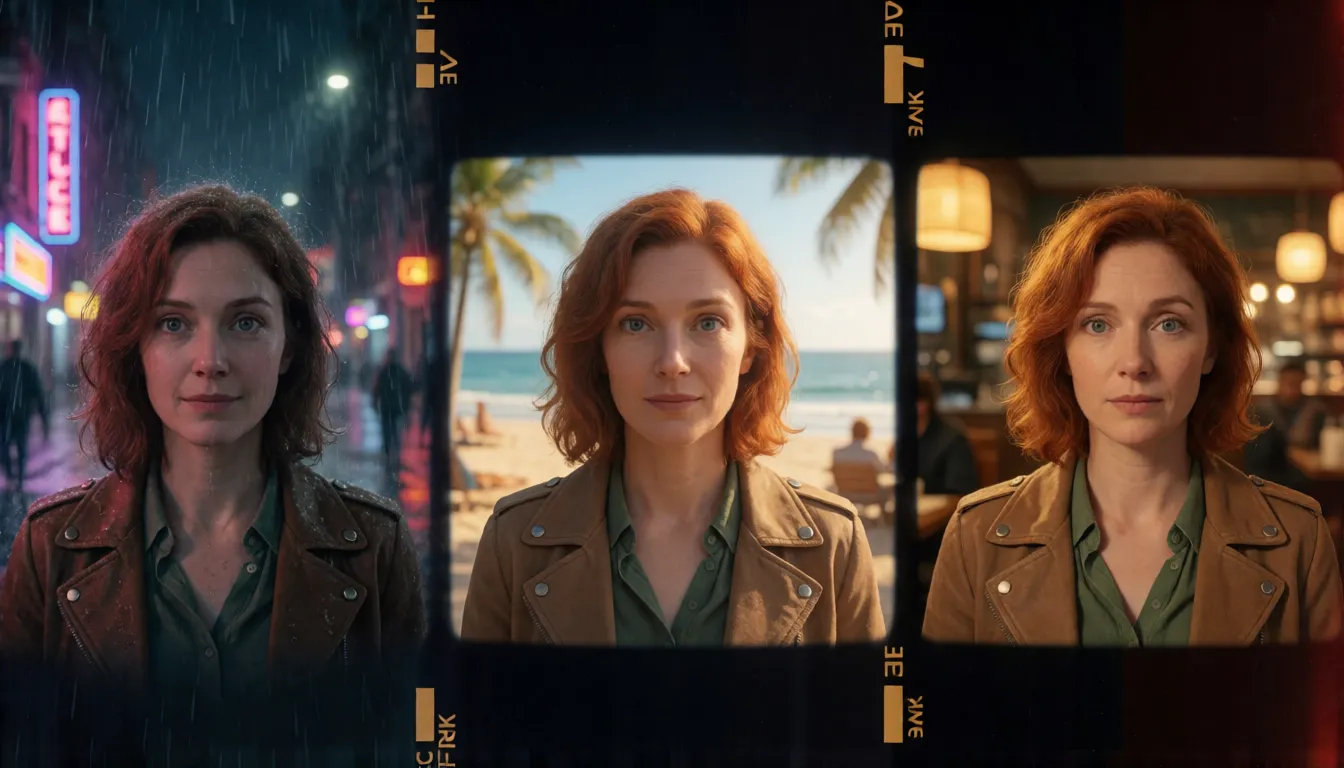
캐릭터 하나를 작은 파일 하나에 통째로
MiniMax H3 RefMods(Reference Latent Adapters의 줄임말)는 오픈 웨이트 H3 오디오·비디오 모델을 위해 만들어진 커뮤니티 포맷입니다. 저장해 둔 캐스팅 기록이라고 생각하면 됩니다. 매번 같은 레퍼런스 사진을 올리고 <Picture 1> 위치 태그를 일일이 맞추는 대신, VAE로 한 번 인코딩해 .safetensors 파일로 저장합니다. 이후 LoRA처럼 불러오면 영상 생성 중 H3의 레퍼런스 컨디셔닝 스트림에 주입됩니다. H3 자체 가중치는 전혀 재학습하지 않으므로 몇 시간이 아니라 몇 분이면 만들 수 있습니다.
이 포맷과 노드는 개발자 @Luisacaotica의 ComfyUI-MiniMaxH3Mod 팩에서 나왔으며 MIT 라이선스로 공개되었습니다. MiniMax 제품이 아닌 커뮤니티 프로젝트이고, README에도 아직 개발 중이라고 표시되어 있어 릴리스마다 노드 이름과 입력이 바뀔 수 있습니다. 그럼에도 인기는 대단해서, 저장소는 공개 몇 주 만에 GitHub 스타 500개를 넘어섰습니다.
| 설정 | 기능 | 추천 용도 |
|---|---|---|
| Full Reference (인코딩) | 인코딩된 디테일을 모두 유지, 토큰을 더 사용 | 선명하게 살리고 싶은 얼굴과 의상 |
| Compressed Reference | 레퍼런스를 풀링해 토큰 절약, 디테일과 모션 일부 손실 | 긴 클립 또는 여러 파일을 겹쳐 쓸 때 |
| identity_encode 프리셋 | 인물이나 캐릭터의 정체성을 포착 | 반복 등장하는 주인공, 진행자, 마스코트 |
| style_experimental 프리셋 | 룩을 8×8 그리드에 압축 | 하나의 색 보정이나 아트 스타일을 쓰는 시리즈 |
| motion_sequence 프리셋 | 짧은 클립의 움직임을 저장 | 춤, 걸음걸이, 제스처 재사용 |
크리에이터들이 레퍼런스 어댑터를 활용하는 곳
MiniMax H3 RefMods의 매력은 간단합니다. 파일 하나로 끝없는 에피소드를 만들 수 있다는 것. 반복 등장하는 얼굴마다 LoRA를 학습하던 크리에이터들이 이제는 캐릭터, 스타일, 동작을 담은 작은 라이브러리를 만들어 샷마다 조합합니다. 커뮤니티 스레드와 공유 워크플로에서 가장 자주 언급되는 활용법은 다음과 같습니다.
숏드라마와 AI 만화
하나의 오리지널 주인공을 수십 개의 샷에서 재사용하세요. 장소, 카메라 무빙, 액션은 바꾸되 얼굴은 에피소드 내내 그대로 유지됩니다.
버추얼 호스트와 오리지널 IP
마스코트나 버추얼 진행자를 파일 하나에 고정해, 룩이 브랜드에서 서서히 벗어나는 일 없이 매주 클립을 발행하세요.
패션과 제품 쇼케이스
프롬프트로 의상을 바꾸는 동안 한 성인 모델을 안정적으로 유지하세요. 레퍼런스의 옷이 섞여 들어올 수 있으니 새 룩을 명확히 묘사하세요.
변신 장면
Axis 로더는 두 캐릭터 사이를 A에서 B로 부드럽게 전환해 모핑, 비포·애프터 공개, 꿈 장면에 제격입니다.
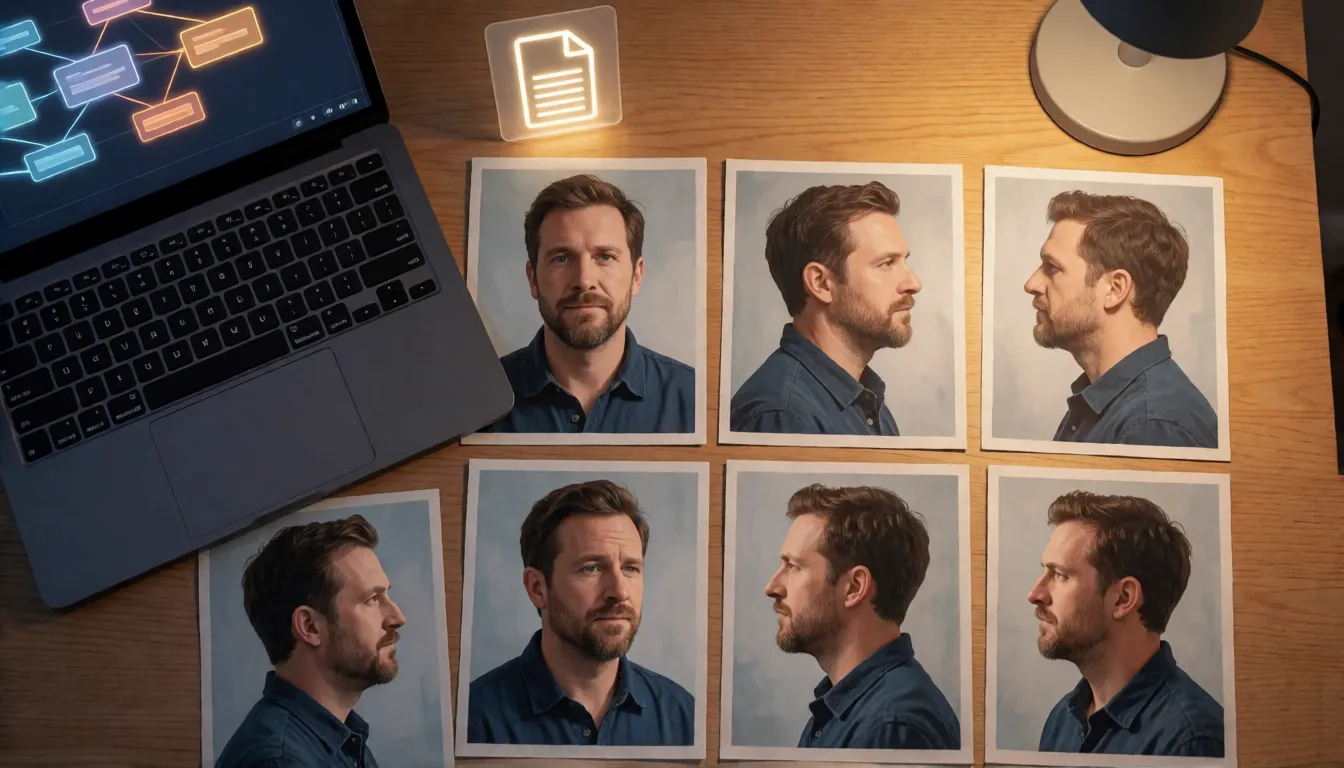
ComfyUI에서 사진 8장으로 재사용 가능한 캐릭터 만들기
ComfyUI에서 MiniMax H3 RefMods를 만드는 과정은 노드 팩의 README를 따릅니다. 좋은 입력에서 시작하세요. 여러 각도에서 찍은 선명한 1인 이미지 5~10장 또는 짧은 클립 하나면 됩니다. 오디오는 깨끗한 소리 5~15초가 일반적입니다. 프레임 안의 모든 것이 얼굴과 함께 파일에 담길 수 있으니 복잡한 배경은 피하세요.
- 1ComfyUI Manager로 ComfyUI-MiniMaxH3Mod를 설치하거나 GitHub 저장소를 custom_nodes에 클론한 뒤 ComfyUI를 재시작합니다.
- 2레퍼런스 이미지를 Extract H3 RefMod 노드에 불러오고, 최대 디테일을 위해 identity_encode 프리셋과 Full Reference를 선택합니다.
- 3로더 노드가 찾을 수 있도록 결과물을 ComfyUI/models/refmods/에 저장합니다.
- 4Load H3 RefMods(최대 8개 슬롯, 슬롯마다 강도와 복사본 수 개별 설정)를 추가하고 시작 강도를 정합니다.
- 5Apply H3 RefMod를 MiniMax H3 ImageToVideo 또는 ReferenceToVideo 노드의 컨디셔닝에 연결한 뒤 평소처럼 샘플링합니다.
- 6같은 시드로 파일 없이 한 번 렌더링해 기준을 만들어 두면, 레퍼런스가 무엇을 더하는지 정확히 확인할 수 있습니다.
- Step Curve 노드: concept_at_start, concept_at_middle, concept_at_ends 중에서 골라 디노이징 중 레퍼런스가 작용하는 시점을 정합니다. 예를 들어 처음엔 닮은 모습, 나중엔 자유로운 움직임.
- Load H3 RefMod Folder: 디렉터리를 지정해 캐릭터 세트 전체를 한 번에 교체합니다.
노드보다 버튼이 편하다면? Fizgig v6로 만드세요
shootthesound가 만든 크리에이터 툴 Fizgig는 2026년 9월 중순 버전 6에서 MiniMax H3 RefMods 제작 기능을 추가했습니다. 추출 과정을 더 친숙한 인터페이스와 바로 쓸 수 있는 레시피로 감쌌습니다. 커뮤니티 레시피는 1메가픽셀 이미지 8장, Fizgig lite는 0.5메가픽셀 이미지 16장을 사용하며, Fizgig 1MP 옵션은 그 중간입니다. 스타일 프리셋, 모션 및 오디오 레퍼런스, 그리고 A/B 비교를 나란히 렌더링해 주는 RefMod Studio도 있어 강도 설정을 추측 없이 판단할 수 있습니다. Fizgig 문서에는 각 레시피를 차근차근 안내하는 how-do-I 가이드도 포함되어 있습니다.
한 장면에 두 캐릭터: 파일 겹쳐 쓰기
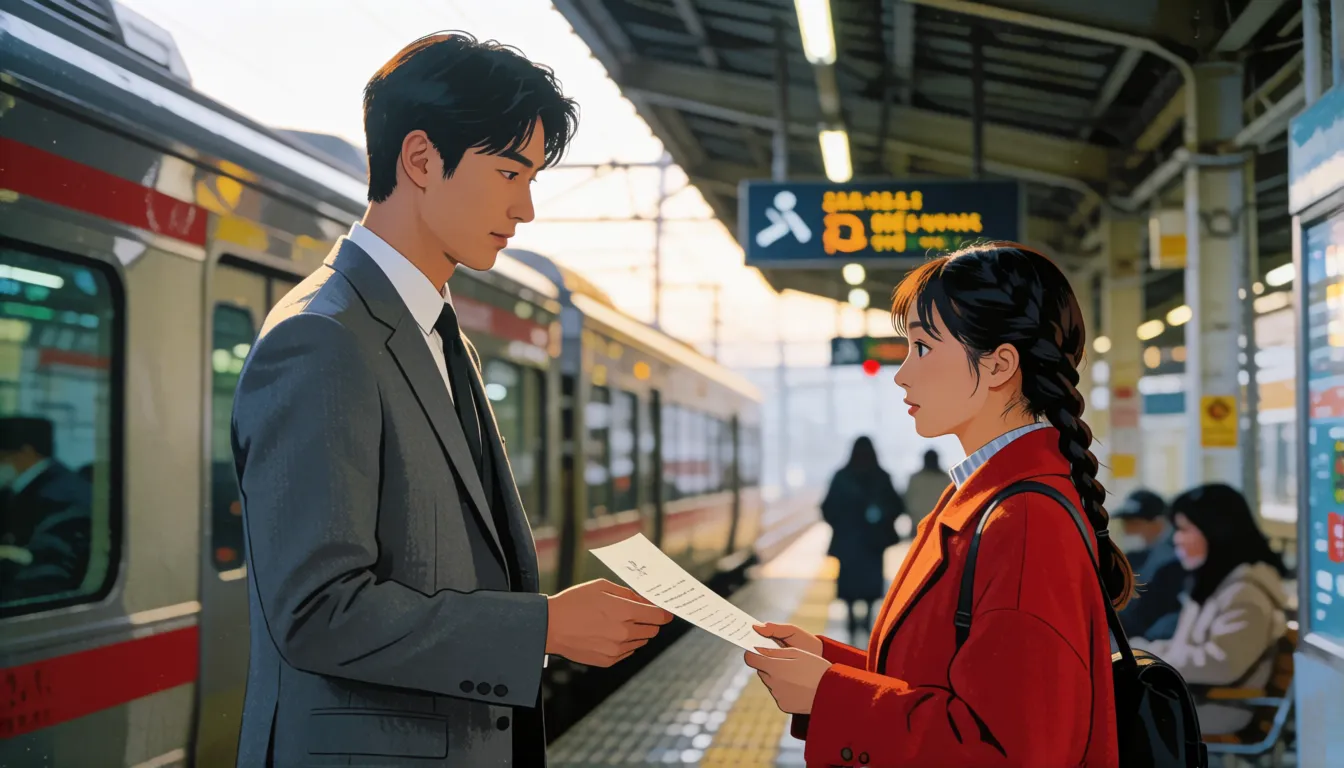
그룹 샷은 MiniMax H3 RefMods가 단일 이미지 레퍼런스를 조용히 앞서는 부분입니다. 캐릭터마다 별도의 파일을 만들어 각기 다른 슬롯에 불러오고, 프롬프트에서 <Subject 1>, <Subject 2> 식으로 지칭하세요. 파일 하나에는 한 사람만 담으세요. 두 얼굴을 섞은 파일은 얼굴이 뒤섞이기 쉽습니다. 주인공의 디테일이 흐려지기 시작하면 조연 캐릭터의 강도부터 낮추고, 모델이 누가 누구인지 알 수 있도록 헤어, 의상, 체형 묘사를 프롬프트에 유지하세요.
얼굴을 넘어: 스타일, 모션, 목소리 레퍼런스
MiniMax H3 RefMods에서 캐릭터는 절반에 불과합니다. style_experimental로 만든 스타일 파일은 여러 프레임을 하나의 룩으로 압축해 시리즈 전체에 적용할 수 있어, 채널 전반에 하나의 색 보정을 유지할 때 유용합니다. motion_sequence로 만든 모션 파일은 짧은 클립을 움직임 템플릿으로 바꿔, 시그니처 걸음걸이나 춤을 다른 캐릭터에게도 재사용할 수 있게 합니다.
오디오 파일도 있으며, 소리 1초당 약 80토큰을 사용합니다. 실험적 기능으로 생각하세요. 현재 테스트에서는 화자 정체성이 안정적으로 전달되지 않고, 오디오는 기본적으로 클립 시작 부분부터 인코딩되며 립싱크 정렬도 없습니다. 허락 없이 실제 인물의 목소리를 흉내 내는 데 절대 사용하지 마세요.
얼굴을 안정적으로 유지하는 프롬프트 템플릿
MiniMax H3 RefMods로 프롬프트를 작성할 때, 레퍼런스 파일은 트리거 단어가 아니며 파일 이름은 프롬프트에서 아무 역할도 하지 않는다는 점을 기억하세요. 효과적인 방법은 파일이 없는 것처럼 캐릭터를 묘사한 뒤 레퍼런스가 디테일을 맞추도록 하는 것입니다. 아래 템플릿은 오리지널 성인 캐릭터용으로 작성되었으니 자신의 디테일로 바꿔 쓰세요.
- 외모와 행동은 항상 글로 고정하세요. 나이, 헤어, 눈, 의상, 그다음 움직임과 카메라 순서로.
- 파일 하나에 캐릭터 하나, 캐릭터 하나에 <Subject N> 태그 하나.
- 중간 정도 강도에서 시작해 얼굴이 흐트러질 때만 높이고, 배경이 레퍼런스 사진을 따라 하기 시작하면 낮추세요.
- 의상을 바꿀 때는 새 옷을 명시적으로 적고 same face를 추가해 레퍼런스의 옷이 우세해지지 않게 하세요.
단일 캐릭터
<Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, wearing a white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting.
두 캐릭터
<Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light.
의상 변경 (18+ 오리지널 캐릭터)
<Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, standing by a sunlit pool, slow dolly-in.
RefMod vs LoRA vs 레퍼런스 이미지 직접 넣기
방법마다 쓰임새가 있습니다. Fizgig 제작자는 학습된 LoRA가 여전히 일반화 능력이 더 좋고 닮은 정도도 더 높지만, 레퍼런스 자료와 비슷한 샷에서는 차이가 작다고 설명합니다. 일반 레퍼런스 이미지는 준비가 필요 없지만 실행할 때마다 다시 인코딩되고, 사진이 여러 장이면 위치 태그 관리가 번거로워집니다.
| RefMod | LoRA | 레퍼런스 이미지 직접 사용 | |
|---|---|---|---|
| 학습 | 없음, 한 번 추출 | 필요, 데이터셋과 학습 실행 | 없음 |
| 첫 사용까지 걸리는 시간 | 몇 분 | 몇 시간 | 즉시 |
| 파일 크기 | 약 1–1.6MB | 보통 훨씬 큼 | 파일 없음 |
| 새로운 각도에서의 닮음 | 레퍼런스와 가까우면 좋음 | 가장 강함 | 실행마다 다름 |
| 캐릭터 겹쳐 쓰기 | 최대 8개 슬롯 | 가능, 충돌할 수 있음 | 이미지마다 위치 태그 |
아직 부족한 점: 솔직한 한계
MiniMax H3 RefMods는 아직 초기 단계이며, 노드 팩의 README도 미흡한 부분을 솔직하게 밝힙니다. 미리 알아 두면 재생성에 드는 시간을 크게 줄일 수 있고, 대부분은 더 깨끗한 레퍼런스나 낮은 강도 같은 간단한 해결책이 있습니다.
- 빠른 움직임은 얼굴을 번지게 할 수 있으니, 느린 카메라 무빙이 정체성을 더 잘 유지합니다.
- Compressed Reference는 얼굴 디테일이 손실되므로 클로즈업에는 Full Reference를 사용하세요.
- 정체성, 의상, 배경, 구도가 함께 전달될 수 있으며, 선택적 전달은 보장되지 않습니다.
- 현재 오디오 파일을 이용한 목소리 복제는 신뢰하기 어렵고, 오디오에는 립싱크가 없습니다.
- 일부 워크플로는 모든 GPU에서 완전히 검증되지 않았으며, 공식 벤치마크도 없습니다.
완성된 파일: 커뮤니티가 공유하는 곳
MiniMax H3 RefMods를 모두 처음부터 만들 필요는 없습니다. 크리에이터 malcolmrey는 Hugging Face에 Apache-2.0으로 수백 개의 완성된 파일로 이루어진 대형 라이브러리를 공개하고 있으며, 가이드, 샘플, 예제 워크플로 데이터셋도 함께 제공합니다. 파일을 내려받아 ComfyUI/models/refmods/에 넣으면 로더에 나타납니다. 소규모 개인 업로드도 있지만 활동이 적은 경우가 많고, 일부는 실존 인물이나 저작권 있는 캐릭터의 모습을 담고 있으니 사용 전에 내용을 확인하고 오리지널 또는 정식 라이선스 캐릭터만 사용하세요.
무검열 사용: 레퍼런스 파일이 바꿀 수 있는 것과 없는 것
무검열 MiniMax H3 RefMods를 찾는 사람들은 대개 필터 없는 버전을 기대합니다. 그런 버전은 없습니다. 레퍼런스 파일은 모델에게 누구 또는 무엇을 보여줄지만 알려줄 뿐, 모델이 생성하려는 범위를 바꾸지는 않습니다. H3는 오픈 웨이트 모델이므로 로컬 사용자는 이미 자신의 설정을 직접 정하며, 성인 크리에이터들은 보통 오리지널 18+ 캐릭터 파일을 비치웨어, 란제리, 부두아 시리즈용 커뮤니티 H3 LoRA와 함께 사용합니다. 로컬 설치를 건너뛰고 싶다면 Spicy AI가 성인, 가상 또는 동의한 캐릭터를 위한 완화된 필터의 온라인 H3 이미지-투-비디오를 제공합니다.
오리지널 성인 캐릭터의 스틸 이미지를 업로드하고 GPU 없이 움직여 보세요.
이미지-투-비디오 열기온라인에서 일관된 캐릭터 프롬프트 사용해 보기
캐릭터 스틸 이미지 한 장에서 시작해 프롬프트를 붙여 넣으면 나머지는 영상 모델이 알아서 합니다. 이 스타터 프롬프트는 오리지널 성인 캐릭터용으로 작성되었으며 그대로 사용할 수 있습니다.
- <Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting
- <Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light
- <Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, stands by a sunlit pool and turns toward the camera, slow dolly-in
- <Subject 1>, adult man with a trimmed beard, open white shirt, laughs on a yacht deck at golden hour, wind in his hair, camera orbits slowly
레퍼런스 파일로 H3 직접 호스팅 vs Spicy AI에서 온라인 생성
로컬 ComfyUI는 노드 툴킷 전체를 제공하고, 온라인 방식은 그 제어권 대신 설정이 전혀 필요 없는 편리함을 제공합니다.
| 로컬 배포 (공식 가중치) | Spicy AI 온라인 | |
|---|---|---|
| 콘텐츠 필터 | 직접 설정 | 성인 콘텐츠(18+)를 위한 완화된 필터 |
| 오픈 웨이트 | 예 | 필요 없음 — 브라우저에서 실행 |
| 캐릭터 일관성 | RefMod 파일, LoRA, 노드 제어 | 캐릭터 스틸 이미지에서 시작 |
| 시작 비용 | 본인 GPU | 무료 요금제 제공 |
자주 묻는 질문
MiniMax H3 RefMods는 MiniMax가 만들었나요?
아니요. @Luisacaotica의 ComfyUI-MiniMaxH3Mod 노드 팩으로 만들어진 MIT 라이선스 커뮤니티 포맷입니다. MiniMax는 이에 대한 입장을 발표하지 않았습니다.
따로 학습해야 하나요?
아니요. 레퍼런스는 VAE를 한 번 거쳐 약 1~1.6MB 파일로 저장됩니다. H3 가중치는 전혀 재학습하지 않습니다.
이미지는 몇 장을 써야 하나요?
README는 선명한 1인 이미지 5~10장 또는 짧은 클립 하나를 권장합니다. Fizgig 레시피는 1메가픽셀 이미지 8장 또는 0.5메가픽셀 16장을 사용합니다.
RefMod가 LoRA보다 나은가요?
더 빠르고 작습니다. 닮은 정도와 특이한 각도에서는 학습된 LoRA가 여전히 앞서지만, 레퍼런스와 비슷한 샷에서는 차이가 작습니다.
한 번에 몇 개까지 불러올 수 있나요?
Load H3 RefMods 노드는 최대 8개 슬롯을 제공하며 슬롯마다 강도를 따로 설정할 수 있습니다. 그룹 장면에서는 캐릭터당 파일 하나를 사용하세요.
파일은 어디에 두나요?
ComfyUI/models/refmods/에 넣은 뒤 로더 노드에서 선택하거나, 폴더 로더로 하위 디렉터리를 지정하세요.
목소리를 복제할 수 있나요?
아직은 안정적이지 않습니다. 현재 테스트에서 화자 정체성 전달이 일관되지 않으며, 본인의 동의 없이 다른 사람의 목소리를 사용해서는 절대 안 됩니다.