Voz a vídeo · Pesos abiertos
Kandinsky S2V 1.0 Pro sin censura: haz que cualquier foto hable, gesticule y cante
Preguntar a la IA ▾
Kandinsky S2V 1.0 Pro recibe tres cosas sencillas, una sola foto, una grabación de alguien hablando y una breve descripción de la escena, y devuelve un vídeo en el que esa persona habla con movimiento de labios sincronizado, mueve las manos y los hombros y se mantiene fiel al personaje del primer al último segundo. Procede de Kandinsky Lab, el equipo detrás de Kandinsky 5.0 y 6.0, y los pesos se pueden descargar gratis. Esta guía muestra dónde lo usan los creadores, qué hace que los resultados se vean naturales, qué versión se adapta a tu GPU, prompts listos para copiar y cómo se compara con otros modelos abiertos de avatares parlantes.
- Foto + voz → vídeo
- Cuerpo entero, no solo la cara
- 25 fps, cualquier duración
- Versión rápida de 16 pasos
Generador de vídeo alternativo sin censura
Imagen a vídeoIgual que Kandinsky S2V 1.0 Pro, parte de un retrato: súbelo, describe cómo debe moverse la persona y cómo es la escena, y abrimos el estudio de imagen a vídeo con todo ya rellenado. Los temas adultos son bienvenidos siempre que todas las personas que aparecen tengan 18+.
Una foto, un clip de voz, una actuación completa
La mayoría de las herramientas de fotos parlantes solo animan la cara: la boca se abre y se cierra mientras el resto de la imagen permanece congelado. Kandinsky S2V 1.0 Pro funciona de otra manera. Le das una imagen de referencia, una grabación de voz limpia (16 kHz mono) y un prompt de texto, y genera un vídeo a 25 fps en el que toda la persona cobra vida. Los labios siguen cada sílaba, las manos hacen los gestos que la gente usa al explicar algo y el fondo se comporta como describe tu prompt. El resultado conserva la relación de aspecto de tu foto e incluye tu pista de audio original, así que el clip está listo para publicar.
La duración tampoco es fija. Kandinsky S2V 1.0 Pro trabaja en bloques de cinco segundos de 125 fotogramas, y cada nuevo bloque continúa donde terminó el anterior, de modo que una locución de dos minutos se convierte en un vídeo de dos minutos de la misma persona. La sincronización labial es lo primero que nota la gente: cada fotograma solo escucha su propio fragmento de audio, por eso las formas de la boca coinciden con el sonido correcto en lugar de quedarse atrás.
Dónde están despegando los vídeos parlantes a partir de una sola foto
Los avatares guiados por voz han pasado de las demos técnicas al trabajo de contenido diario, y Kandinsky S2V 1.0 Pro encaja perfectamente. Los usos siguientes son los que más señalan el paquete de investigación y las comunidades de creadores, y todos comparten una necesidad: una persona creíble en pantalla que dice exactamente lo que dice tu audio, sin reservar un estudio ni contratar a un presentador.
- Microdramas y cómics animados: asigna a cada retrato de personaje su pista de diálogo y obtén planos de diálogo de cuerpo entero que parecen escenas, no stickers.
- Clips de producto y live commerce: la foto de un modelo más una grabación de presentación del producto se convierte en un vídeo explicativo estilo presentador en minutos.
- Cursos, resúmenes de noticias y formación: convierte un guion de narración en una clase larga con un profesor virtual que sigue gesticulando durante minutos.
- Streamers virtuales y compañeros de IA: combina la imagen de un personaje con una voz de texto a voz y el personaje responde ante la cámara.
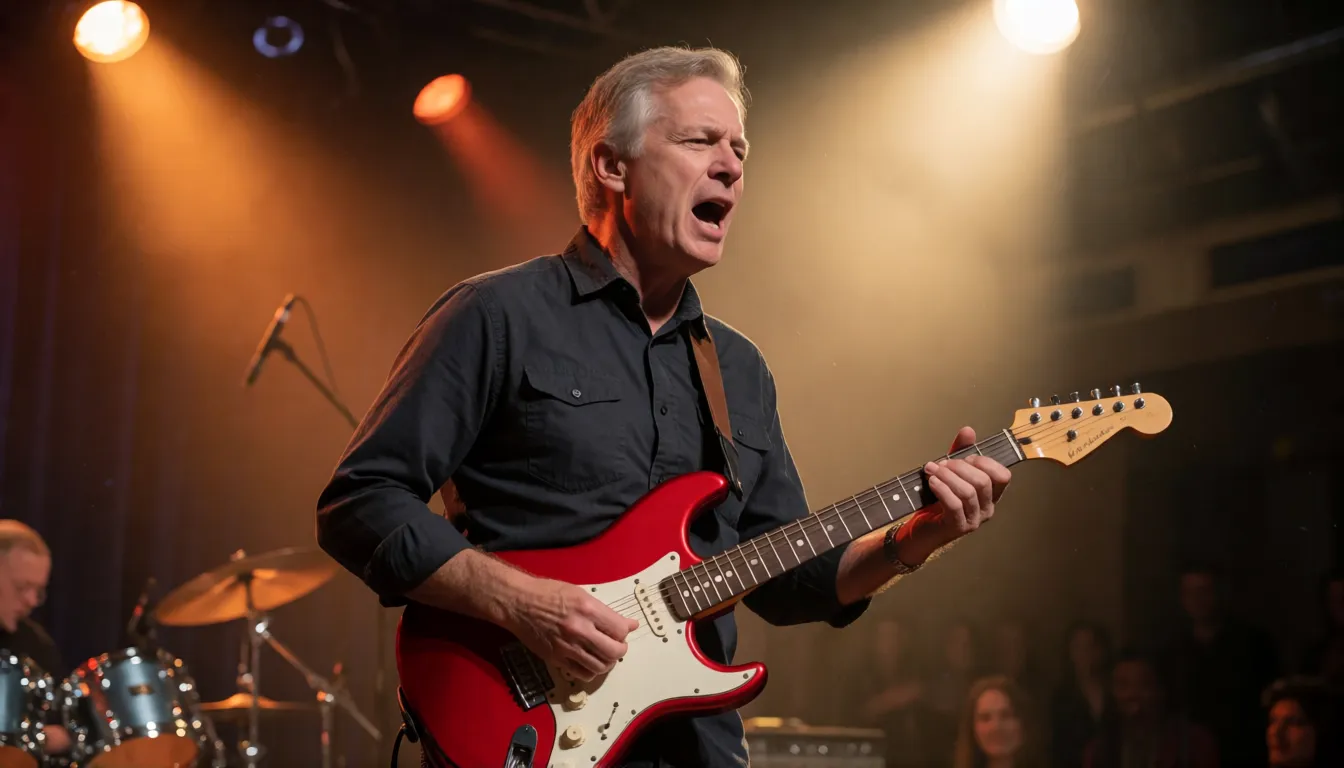
- Música y pódcasts: el ejemplo oficial de Diffusers es un hombre canoso tocando una guitarra eléctrica roja, señal de que los clips de actuación son válidos (el equipo no ha evaluado la calidad del canto).
- Doblaje multilingüe: conserva una foto y cambia las pistas de voz a distintos idiomas; los subtítulos de entrenamiento estaban en inglés y ruso, así que prueba otros idiomas antes de un proyecto grande.
Diálogos de microdramas
Asigna a cada retrato de personaje su línea de diálogo y Kandinsky S2V 1.0 Pro devuelve escenas de cuerpo entero con sincronización labial precisa.
Vídeos explicativos de producto
La foto de un modelo y una presentación grabada se convierten en un clip estilo presentador para tiendas y live commerce.
Presentadores virtuales
Combina la imagen de un personaje con una voz TTS para streamers, profesores y compañeros de IA que responden.
Qué hace que los resultados se vean naturales
Tres decisiones de diseño separan a Kandinsky S2V 1.0 Pro de las muchas herramientas de sincronización labial anteriores. Primero, es animación de cuerpo entero: el modelo parte de Kandinsky 5.0 Video, así que ya sabe cómo se mueven los cuerpos, la ropa y las escenas, y el prompt puede guiar los gestos y el entorno. Segundo, entiende tanto las palabras como la voz: Qwen2.5-Omni lee tu prompt de texto y escucha el habla a 25 tokens por segundo, lo que ayuda a que el movimiento coincida con la energía de la interpretación. Tercero, una memoria de tres niveles lleva el aspecto de la foto de referencia de bloque en bloque, de modo que caras y vestuario se mantienen coherentes en tomas largas.
Kandinsky S2V 1.0 Pro también tiene una edición destilada. Pro distill llega al resultado en 16 pasos en lugar de 50 e integra el guidance en los pesos, lo que según el equipo es unas cinco veces más rápido (entre 4,5× y 5,6× según la configuración) e iguala al modelo base en casi todas las métricas. En el estudio con evaluadores humanos del artículo, frente al baseline abierto más fuerte y dos servicios comerciales, Kandinsky S2V 1.0 Pro fue valorado de media igual o mejor, siendo la sincronización labial el aspecto preferido.
- Movimiento de cuerpo entero y control de la escena desde un prompt de texto
- Sincronización labial precisa por fotograma gracias a la atención de audio por fotograma
- Sin límite estricto de duración gracias a la continuación bloque a bloque
- Pesos abiertos con licencia MIT, se ejecuta en local
- Necesita una GPU de 48 GB para el modelo Pro (80 GB para HD)
- No crea sonido, así que tienes que aportar tu propia voz o TTS
- Aún no hay versión cuantizada oficial para tarjetas de 24 GB
- El modo HD no se entrenó ni se evaluó a esa resolución
Lite o Pro, base o distill: cómo elegir versión
Kandinsky S2V 1.0 Pro pertenece a una familia de cuatro checkpoints. Los modelos Lite de 2B son la opción rápida y ligera; los modelos Pro de 21B ofrecen las mejores caras, manos y movimientos. En cada tamaño, la edición destilada es la elección para el día a día y el modelo base de 50 pasos es para quienes buscan el último detalle. Ambos checkpoints Pro también pueden ejecutar una configuración HD a 1280×768.
| Versión | Tamaño y pasos | Ideal para | Velocidad en una H100 (por segundo de vídeo) |
|---|---|---|---|
| Lite 2B distill | 2B, destilado | Borradores rápidos, GPU más pequeñas | Unos 8,7 s |
| Lite 2B | 2B, base | Calidad Lite sin destilación | Más lento que Lite distill |
| Pro 21B distill | 21B, 16 pasos | El mejor equilibrio para el uso diario | Unos 41,5 s (33,6 s compilado) |
| Pro 21B | 21B, 50 pasos | Máxima fidelidad, admite prompts negativos | Unos 189 s |
| Pro distill HD | 21B, 1280×768 | Fotogramas más grandes (calidad no probada) | Unos 137 s |
Memoria de GPU y velocidad: qué esperar
Kandinsky S2V 1.0 Pro es un modelo grande, así que planifica el hardware antes de descargar unos 65 GB de archivos. El requisito oficial es una sola GPU con al menos 48 GB de memoria (80 GB para HD) y un controlador versión 580 o posterior. En una H100, Pro distill a resolución estándar alcanza un pico de unos 46 GiB; HD llega a unos 55 GiB. Por tanto, un clip de diez segundos tarda unos seis o siete minutos en una sola tarjeta, y la configuración oficial de ocho GPU reduce cada segundo de vídeo a unos 11 segundos.
¿Te falta memoria? Activar VAE tiling baja el pico a unos 28 GB a costa de costuras leves, la vía de Diffusers con descarga a CPU tiene un pico cercano a 50 GiB, y el modelo Lite 2B distill es la forma más fácil de experimentar con una tarjeta más pequeña. Alquilar una GPU en la nube durante una tarde es la solución habitual para tarjetas domésticas de 24 GB, ya que todavía no existen archivos cuantizados oficiales.
Tres formas de probarlo: demo online, ComfyUI y Diffusers
No necesitas instalar nada para ver lo que puede hacer Kandinsky S2V 1.0 Pro. El equipo aloja un Space de demostración gratuito en Hugging Face, y hay notebooks de Colab y Kaggle para quienes quieren algo más de control. Cuando estés listo para ejecutarlo tú mismo, elige la vía que mejor encaje con tu forma de trabajar.
- 1Online: abre el Space Kandinsky-S2V-1.0-Demo en Hugging Face, sube un retrato y un archivo WAV corto, añade un prompt y genera.
- 2Línea de comandos: clona el repositorio kandinsky-s2v de GitHub, ejecuta uv sync y luego uv run kandy-s2v generate con la configuración s2v_pro_distill.yaml y tus rutas --audio, --image y --out; añade --prompt y --seed para guiar y repetir resultados.
- 3ComfyUI: cambia a la rama dev/comfyui del repositorio, que incluye nodos para Lite distill y Pro distill, y conecta imagen, audio y prompt al sampler.
- 4Diffusers: instala diffusers desde la rama main, carga kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers con ModularPipeline y lee tu audio a 16 kHz.
Sea cual sea la vía que elijas, Kandinsky S2V 1.0 Pro premia los buenos archivos de entrada más que cualquier ajuste. Ten esto en cuenta:
- Usa una foto nítida y frontal en la que la persona ocupe buena parte del encuadre; su relación de aspecto será la del vídeo.
- Graba una voz limpia sin música de fondo, guardada como audio mono a 16 kHz.
- Fija el --seed cuando te guste un resultado y luego cambia solo el prompt para explorar variaciones.
Plantillas de prompt para vídeos parlantes
En Kandinsky S2V 1.0 Pro el prompt de texto no contiene el guion; lo contiene tu audio. Usa el prompt para describir a la persona, su movimiento, el entorno y la cámara, y mantén la ropa y el fondo parecidos a la foto de referencia para que el aspecto no se desvíe. Estas plantillas cubren los formatos más populares; cambia los detalles y conserva la estructura.
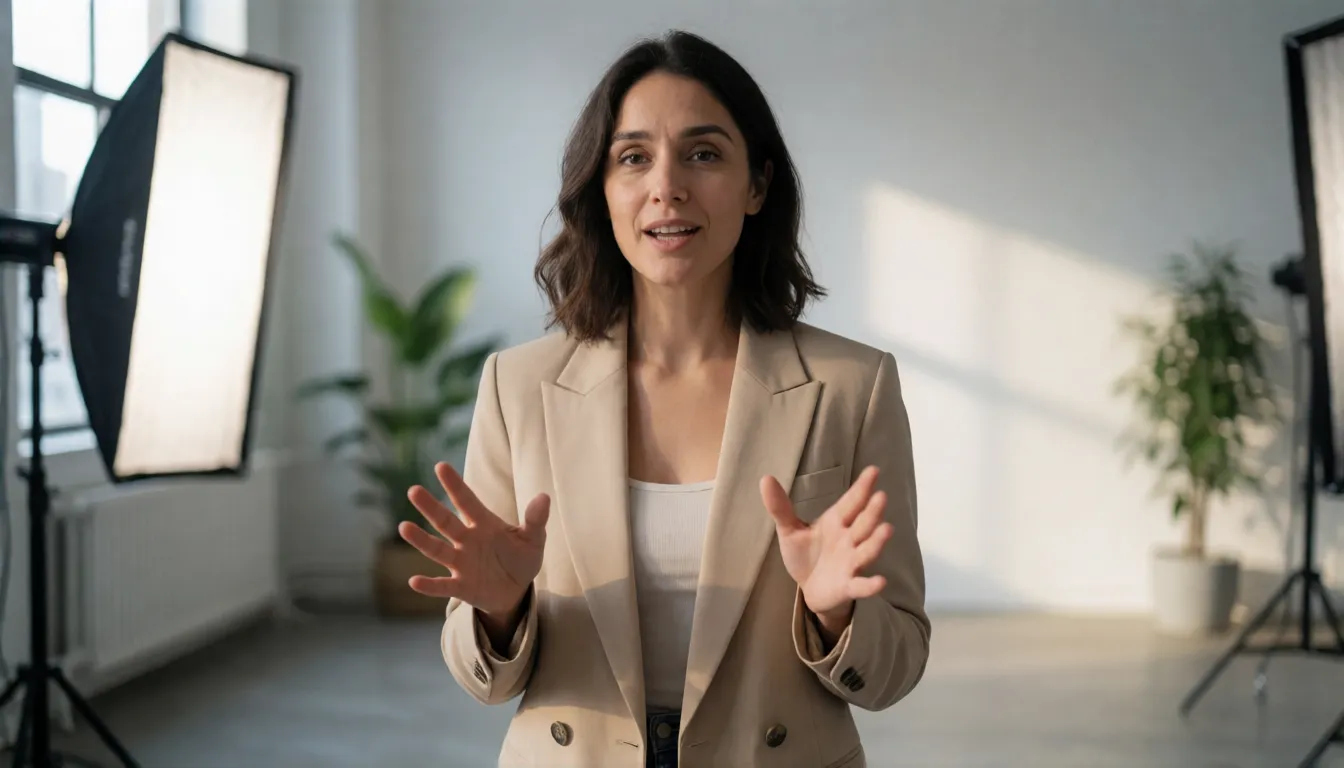
- Presentadora: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
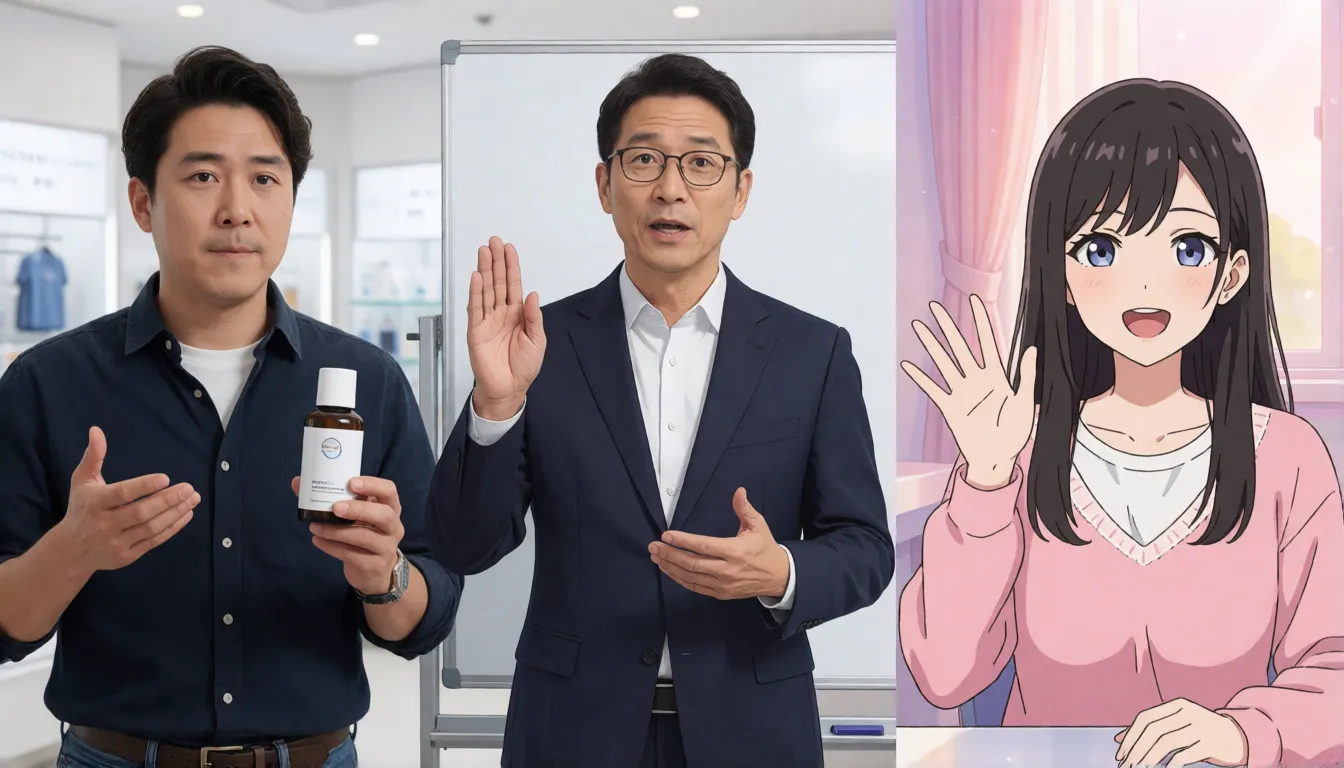
- Presentación de producto: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- Diálogo dramático: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- Músico: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- Profesor: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- Streamer virtual: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- Charla en la playa (18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- Prompt negativo (solo modelo de 50 pasos): blurry face, distorted mouth, extra fingers, flickering, static body.
Comparativa con Wan 2.2 S2V, InfiniteTalk y otros avatares abiertos
Los modelos abiertos de avatares parlantes se han multiplicado, y cada uno tiene un punto fuerte distinto frente a Kandinsky S2V 1.0 Pro. Wan2.2-S2V-14B, de Alibaba, ya cuenta con archivos GGUF de la comunidad, lo que lo hace más accesible para GPU pequeñas. InfiniteTalk y MultiTalk se centran en vídeos muy largos y conversaciones entre varias personas. LongCat-Video-Avatar 1.5 también tiene builds GGUF para ComfyUI. Kandinsky S2V 1.0 Pro destaca por su permisiva licencia MIT, el movimiento de cuerpo entero guiado por texto y la versión destilada de 16 pasos; sus puntos débiles hoy son el alto requisito de memoria y un ecosistema comunitario todavía joven. El artículo no nombra sus baselines, así que considera no verificadas las comparaciones directas y prueba con tus propios clips.
| Modelo | Punto fuerte | ¿Más fácil en GPU pequeñas? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | Movimiento de cuerpo entero, escenas controladas por texto, distill de 16 pasos | Solo Lite; Pro necesita 48 GB |
| Wan2.2-S2V-14B | Ecosistema maduro, movimiento cinematográfico | Sí, GGUF de la comunidad |
| InfiniteTalk / MultiTalk | Clips muy largos, diálogo entre varias personas | Depende de la configuración |
| LongCat-Video-Avatar 1.5 | Vídeo de avatar con soporte para ComfyUI | Sí, GGUF de la comunidad |
Avatares parlantes sin censura: qué puedes hacer hoy
Todavía no existe un fine-tune sin censura, oficial o de la comunidad, de Kandinsky S2V 1.0 Pro. Los pesos abiertos se ejecutan en local sin capa de moderación online, pero los datos de entrenamiento son grabaciones de una sola persona hablando, así que las escenas adultas no son algo para lo que se haya diseñado, y la model card pide a los usuarios que solo animen a personas que hayan dado su consentimiento. Si quieres que una foto hable, coquetee o pose en bañador o lencería con personajes ficticios 18+ sin instalar nada, nuestro estudio de imagen a vídeo te permite subir un retrato, describir el movimiento y generar en el navegador.
Anima el retrato de un personaje 18+ en tu navegador, sin necesidad de GPU.
Empezar imagen a vídeo →Alojar Kandinsky S2V 1.0 Pro por tu cuenta vs generar online en Spicy AI
| Despliegue local (pesos oficiales) | Spicy AI online | |
|---|---|---|
| Filtrado de contenido | Sin filtro online cuando lo ejecutas tú mismo | Contenido adulto (18+) permitido |
| Pesos abiertos | Sí, licencia MIT en Hugging Face | No aplica, funciona online |
| Modelo realmente usado | Kandinsky S2V Lite o Pro | Modelos de vídeo propios de Spicy AI |
| Precio | Pesos gratis, tú pagas la GPU | Gratis para empezar, créditos para más |
- Local: sincronización labial guiada por tu propio audio, duración ilimitada, control total.
- Spicy AI: parte de una foto y anímala en el navegador, sin necesidad de hardware.
Preguntas frecuentes
¿Qué es Kandinsky S2V 1.0 Pro?
Kandinsky S2V 1.0 Pro es un modelo de voz a vídeo de 21.000 millones de parámetros de Kandinsky Lab. Dale una foto de referencia, una grabación de voz y un prompt de texto, y genera un vídeo parlante de cuerpo entero a 25 fps con sincronización labial. Los pesos son abiertos con licencia MIT.
¿Qué diferencia hay entre Pro y Pro distill?
Ambos tienen 21B de parámetros. La versión distill usa la destilación pi-Flow para terminar en 16 pasos en lugar de 50 e integra el guidance en los pesos, por lo que es unas cinco veces más rápida y puntúa cerca del modelo base en casi todas las métricas.
¿Cuánta memoria de GPU necesita Kandinsky S2V 1.0 Pro?
El equipo pide una sola GPU con al menos 48 GB (80 GB para HD). Pro distill alcanza un pico de unos 46 GiB a resolución estándar; VAE tiling lo reduce a unos 28 GB con costuras leves. Aún no hay versión cuantizada oficial.
¿Cuánto pueden durar los vídeos de Kandinsky S2V 1.0 Pro?
Lo mismo que tu audio. El modelo genera bloques de cinco segundos y continúa cada uno a partir del anterior. En una H100, un segundo de vídeo a resolución estándar tarda unos 41,5 segundos con Pro distill.
¿Kandinsky S2V 1.0 Pro también genera la voz?
No. Tú aportas el habla, ya sea una grabación real o texto a voz, y el vídeo final incluye esa pista de audio original.
¿Hay una demo online o soporte para ComfyUI?
Sí. Kandinsky Lab aloja un Space de demostración en Hugging Face, la rama dev/comfyui del repositorio de GitHub añade nodos de ComfyUI para Lite distill y Pro distill, y el soporte para Diffusers está disponible desde la rama main.
¿Existe un Kandinsky S2V 1.0 Pro sin censura?
No a fecha de noviembre de 2026: no se ha publicado ningún fine-tune sin censura, oficial ni de la comunidad. Puedes ejecutar los pesos abiertos tú mismo o usar un generador online de imagen a vídeo que permita contenido ficticio 18+.
Fuentes
- Model card de Kandinsky-S2V-1.0-Pro-distill (Hugging Face)
- Model card de Kandinsky-S2V-1.0-Pro-distill-Diffusers (Hugging Face)
- Modelo base Kandinsky-S2V-1.0-Pro (Hugging Face)
- Demo online de Kandinsky S2V 1.0 (Hugging Face Space)
- Repositorio kandinskylab/kandinsky-s2v (GitHub)
- Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation (arXiv)
- Página del proyecto Kandinsky Avatar
- Wan2.2-S2V-14B GGUF (Hugging Face)
Más guías de modelos de vídeo sin censura
- Kandinsky 6.0 sin censura
- Kling sin censura
- Kling 2.6 sin censura
- Kling O1 sin censura
- Sora sin censura
- Veo sin censura
- Hailuo AI sin censura
- MiniMax H3 Max sin censura
- Wan sin censura
- Wan 3.0 sin censura
- Seedance sin censura
- Seedance 2.5 sin censura
- Seedance 2.0 sin censura
- Seedance 2.0 Mini sin censura
- HunyuanVideo sin censura
- LTX Video sin censura
- Runway sin censura
- Pika sin censura
- Luma Dream Machine sin censura
- Vidu sin censura
- PixVerse sin censura
- EdenLive sin censura
- Grok Imagine sin censura
- AI Avatars sin censura
- HappyHorse 1.0 sin censura
- MiniMax H3 FL2VA Ref2VA sin censura
- Kling 4.0 sin censura
- Kling 3.0 sin censura
- MiniMax H3 RefMods sin censura
- Looking Ahead sin censura
- TaoMate-H3 sin censura
- SANA-Video 2.0 sin censura
- MiniMax H3 Remix sin censura
- Sora 2 sin censura
- Wan 2.6 sin censura
- LTX-2.5 Slow Motion sin censura
- VDN MiniMax H3 sin censura
Spicy AI es un sitio independiente y no está afiliado a Kandinsky Lab ni a Sber. Todo el contenido debe involucrar solo a adultos (18+); no animes a personas reales sin su consentimiento.