Vídeo con IA sin censura · Fusión comunitaria de MiniMax H3
MiniMax H3 FL2VA Ref2VA Híbrido sin censura: vídeo nítido que recuerda a tus personajes
Preguntar a la IA ▾
MiniMax distribuye su modelo de vídeo H3 en dos checkpoints separados. FL2VA logra una imagen y un sonido más limpios, pero solo atiende a un primer y un último fotograma; Ref2VA sigue un conjunto de fotos, clips y voces de referencia, pero se ve más suave. El híbrido comunitario MiniMax H3 FL2VA Ref2VA une ambos en un solo archivo, para que un microdrama, un reel de moda o un personaje de anime sigan siendo reconocibles de un plano a otro sin perder acabado. Aquí verás qué hace, qué archivo descargar y cómo escribirle los prompts.
- Coherencia de personajes
- Audio nativo
- Pesos abiertos
Generador de vídeo alternativo sin censura
Imagen a vídeoSube la foto de un personaje como primer fotograma, describe el movimiento, la cámara y el sonido, y conviértelo en un vídeo corto.
FL2VA vs Ref2VA: un modelo de vídeo, dos personalidades
H3 es el modelo de audio y vídeo de MiniMax con 33 mil millones de parámetros: una sola red crea la imagen y la banda sonora a la vez, así que pasos, olas y diálogos llegan ya sincronizados. En lugar de un archivo que lo haga todo, MiniMax publicó dos checkpoints. FL2VA recibe un prompt de texto más cero, una o dos imágenes, lo que cubre texto a vídeo puro, animación desde el primer fotograma, finales marcados por el último fotograma y transiciones entre primer y último fotograma. Ref2VA recibe un prompt más un paquete de referencias de hasta nueve imágenes, tres clips de vídeo y tres clips de audio, doce archivos como máximo.
Ambos generan clips de 4 a 15 segundos a 24 fotogramas por segundo, con sonido estéreo de 32 kHz y un lado corto de 768 píxeles por defecto. El problema, según los autores de la comunidad que los probaron uno junto al otro, es que FL2VA ofrece una imagen y un audio claramente mejores, mientras que Ref2VA es el que de verdad recuerda quién es tu personaje. Justo ese compromiso es el que el híbrido intenta eliminar.
| FL2VA | Ref2VA | |
|---|---|---|
| Entradas | Texto + hasta 2 fotogramas (primero, último o ambos) | Texto + hasta 9 imágenes, 3 vídeos, 3 clips de audio |
| Lo mejor | Imagen y sonido limpios, movimientos del primer al último fotograma | Mantener rostros, ropa, lugares y voces coherentes |
| Punto débil | No sigue una ficha de personaje | Imagen más suave, según pruebas de la comunidad |
| Uso típico | Animar una foto, enlazar dos fotogramas clave | Episodios de serie, desfiles de looks, escenarios recurrentes |
Por qué la comunidad los fusionó en un modelo híbrido
La idea surgió al comparar los dos archivos peso por peso. El autor smhfacct descubrió que son casi idénticos, con una similitud coseno de al menos 0.9997, y que las diferencias reales están en una pequeña capa dentro de cada bloque transformer: los pesos de modulación adaln_proj. Si pasas esas capas de Ref2VA a FL2VA, el modelo adopta la habilidad con referencias y conserva casi todo el aspecto y el sonido de FL2VA.
Eso es todo lo que es el híbrido MiniMax H3 FL2VA Ref2VA: FL2VA como base, con las capas de modulación de Ref2VA copiadas en un rango de bloques elegido. Sin reentrenar, sin promediar, solo un trasplante preciso. Es un experimento de la comunidad, no un lanzamiento de MiniMax, y ambos autores describen sus valoraciones como subjetivas. Aun así, para quien quería la memoria de Ref2VA sin su desenfoque, es la solución más directa disponible hoy.
Escenas donde destaca: series, reels de moda y escenarios recurrentes
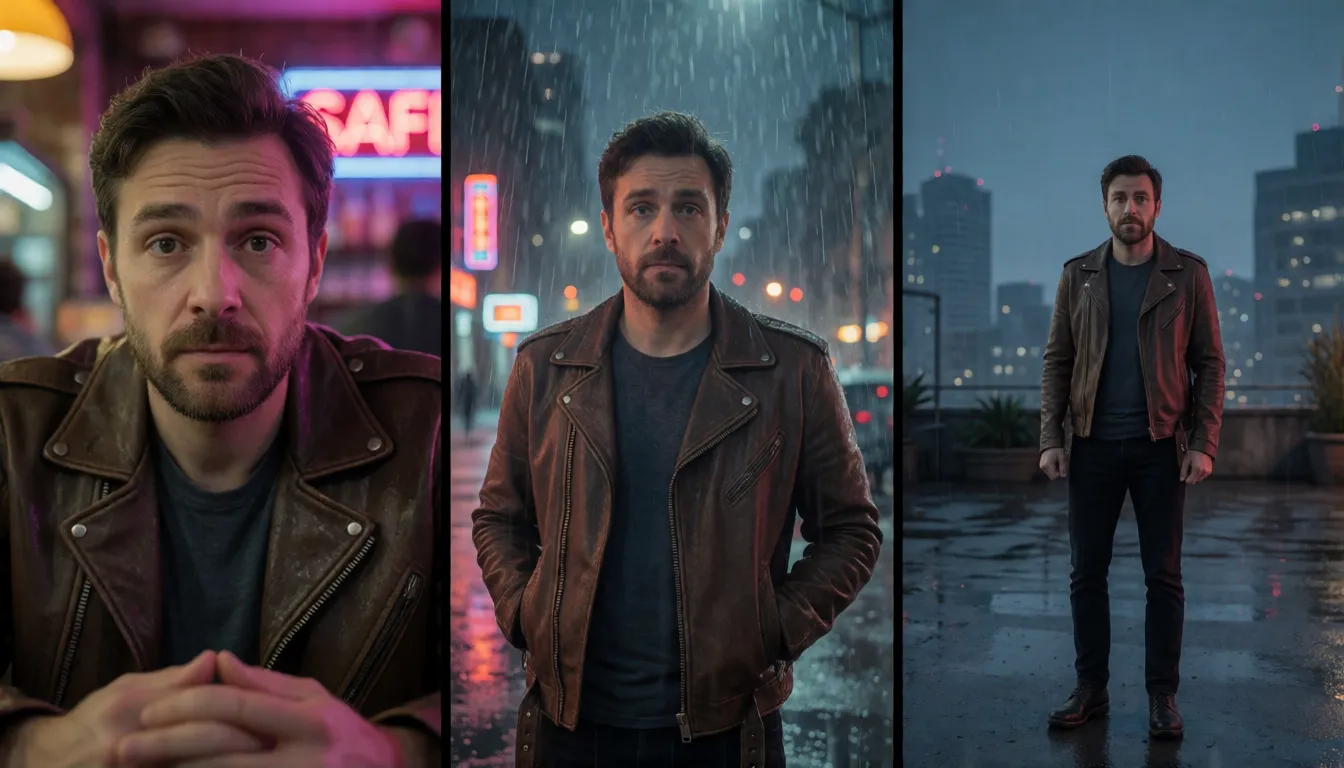
La coherencia de personajes es la razón por la que la gente busca la fusión MiniMax H3 FL2VA Ref2VA. Los creadores de microdramas cargan un retrato y una foto del vestuario, y luego ruedan un enfrentamiento en una cafetería, un paseo por una calle lluviosa y una despedida en una azotea, todos con la misma cara. Como la base es FL2VA, esos episodios conservan la imagen más nítida y el sonido nativo que hacen que los dramas verticales parezcan terminados.
- Historias por episodios y dramas con IA: un solo retrato de referencia lleva al protagonista por cada escena, ángulo y cambio de luz.
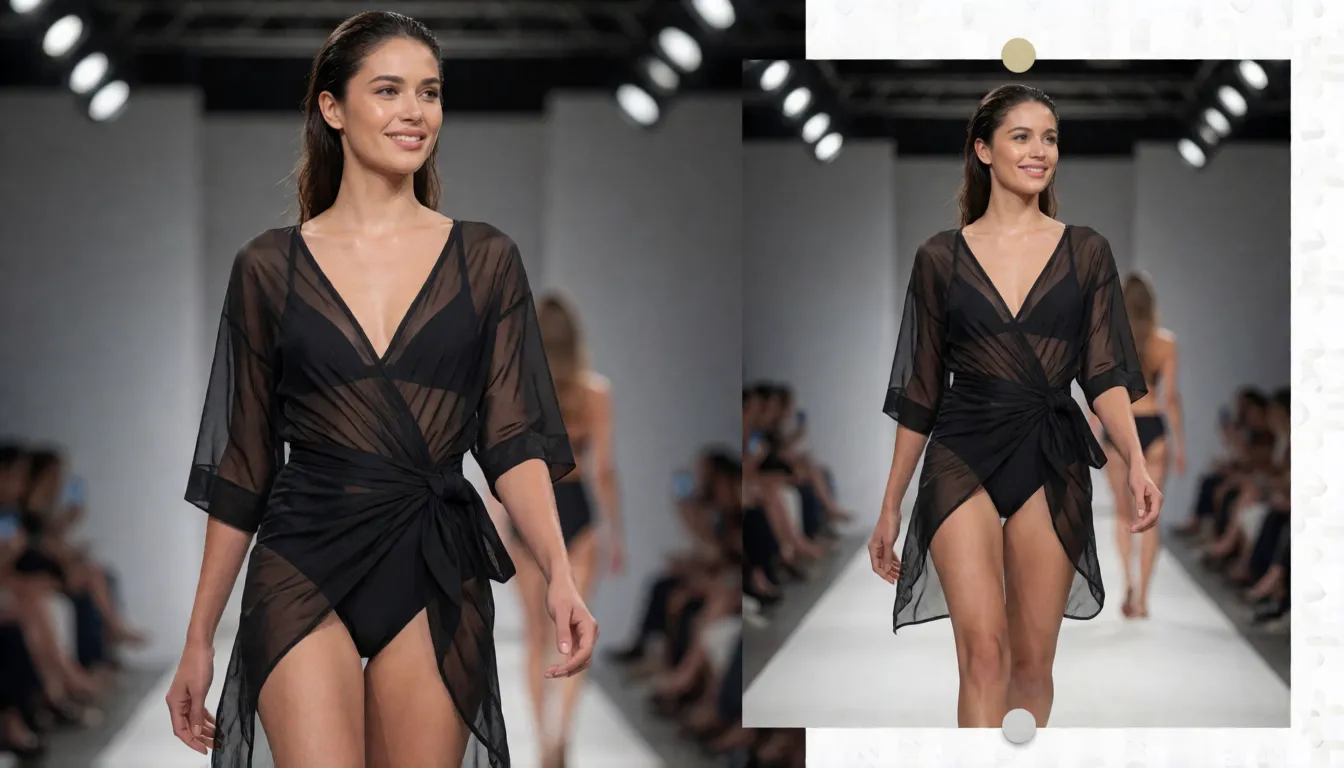
- Desfiles de looks y estilismo: da la ropa como una referencia y a la modelo como otra, y describe un giro en la pasarela o una vuelta lenta. Un archivo de referencia ligera deja que la ropa guíe el resultado sin congelar la cámara.
- Localizaciones recurrentes: reutiliza una foto de un piso, un bar o una playa y genera nuevos planos de 4 a 15 segundos desde distintas posiciones.
- Continuidad de voz y música: Ref2VA acepta clips de audio de 2 a 15 segundos, así que la voz de un personaje o el ambiente de un tema pueden repetirse entre clips. El híbrido mantiene esta entrada, aunque nadie ha medido qué tan bien funciona.
- Estilo adulto (18+): personajes adultos ficticios en bañador, lencería o bikini para reels de playa, piscina y boudoir, todo en tu propio equipo.
De b15 a b49: cómo elegir el archivo híbrido adecuado
El nombre de cada archivo indica qué bloques recibieron las capas de Ref2VA. Un rango más amplio implica seguir mejor las referencias y una imagen que se acerca al aspecto más suave de Ref2VA; un rango más estrecho conserva más acabado de FL2VA. smhfacct publica cuatro archivos int8 sobre una base int8 podada, mientras que diobrando0 publica dos archivos bf16 sin podar, de unos 66.28 GB cada uno, que solo cambian los últimos bloques.
| Archivo | Precisión | Fuerza de la referencia | Para quién |
|---|---|---|---|
| b15-49 | int8 | La más fuerte | Muchas referencias, acepta algo de suavidad |
| b20-49 | int8 | Fuerte | Proyectos donde manda la referencia |
| b25-49 | int8 | Equilibrada | Punto de partida recomendado por el autor |
| b30-49 | int8 | Moderada | La calidad de imagen primero |
| b40-49 | bf16, ~66.28 GB | Ligera (cerca del 7.9% de los pesos vienen de Ref2VA) | Guía sutil a precisión completa |
| b45-49 | bf16, ~66.28 GB | La más ligera | Primera prueba sugerida por diobrando0 |
b25-49 vs b30-49 es el debate más habitual. Empieza con b25-49; si los rostros y el vestuario ya coinciden y quieres fotogramas más nítidos, baja a b30-49. La regla funciona en ambos sentidos: si se ignoran las referencias, pasa a un rango más amplio, y si la imagen se vuelve pastosa o el audio pierde cuerpo, pasa a uno más estrecho.
En cuanto al hardware, ningún autor da una cifra. Dicen que la memoria necesaria es la misma que la del archivo FL2VA equivalente, así que los archivos int8 MiniMax H3 FL2VA Ref2VA están en la misma categoría que FL2VA int8, y los archivos bf16 de 66 GB son, siendo realistas, terreno de estación de trabajo y no de una sola tarjeta gráfica doméstica.
Crea tu propia mezcla con el script de fusión AdaLN
diobrando0 incluye h3_adaln_merge.py junto a los archivos bf16. Copia los pesos adaln_proj de Ref2VA en un archivo FL2VA byte a byte, en el rango de bloques que fijes con --lo y --hi, sin interpolación. Modifica el archivo in situ en la CPU en pocos minutos, puede guardar un --backup, deshacer con --restore y verifica el resultado con hashes BLAKE2b.
Es útil si b40-49 se te queda corto y b25-49 te parece excesivo: prueba un b35-49, valora unos cuantos clips y restaura si no te convence. Guarda los archivos bf16 originales de FL2VA y Ref2VA de Comfy-Org, porque el script necesita ambos como origen.
Plantillas de prompt para que las referencias se mantengan
Los prompts con referencias funcionan mejor en un orden fijo: di qué referencia es cuál, luego la acción, luego la cámara y luego el sonido. Cuantas más referencias acumules, más compensa un archivo de rango amplio como b20-49 o b25-49. Estas plantillas están escritas para el híbrido MiniMax H3 FL2VA Ref2VA y mantienen a todos los personajes adultos.
Cambio de look en la playa
La mujer de la imagen de referencia 1, con el bikini rojo de la imagen de referencia 2, camina por una playa en la hora dorada. Plano medio, la cámara se acerca despacio, ella mira atrás y sonríe. Olas y una guitarra acústica suave.
Mismo personaje, nueva escena
El mismo hombre de la imagen de referencia 1 está sentado en una cafetería tranquila, primer plano de perfil. Dice en voz baja: "Llegas tarde." Luz natural de ventana, estética de película de 35mm, murmullo suave de cafetería.
Giro en la pasarela
La modelo adulta de la imagen de referencia 1 desfila por una pasarela blanca con el bañador negro y el pareo transparente de la imagen de referencia 2, se detiene y gira despacio. Travelling de cuerpo entero, flashes de cámaras, ritmo electrónico profundo.
Escenario recurrente
En el loft de la imagen de referencia 1, la pareja de las imágenes de referencia 2 y 3 baila lento junto a la ventana de noche. Plano general que se desliza a un plano de dos, luces de la ciudad, jazz suave.
- Nombra las referencias por número, en el orden en que las adjuntaste.
- Describe una acción principal por clip; de 4 a 15 segundos pasan rápido.
- Escribe el sonido que quieres, con los diálogos entre comillas.
- Si una referencia se sigue ignorando, cambia de archivo antes de reescribir el prompt.
Veredicto de la comunidad y límites reales
Entre las subidas MiniMax H3 FL2VA Ref2VA, el conjunto int8 de smhfacct es el que más da que hablar: unos 384 me gusta, 14 hilos de discusión y cuatro Spaces de Hugging Face basados en él en el momento de la investigación. El par bf16 de diobrando0 es más reciente y discreto, con 7 me gusta, fechado el 1 de septiembre de 2026. Ambos autores insisten en que sus comparaciones son a ojo, sin benchmarks formales, así que toma la tabla de versiones como un mapa de partida y no como una ley.
Los límites están claros. El híbrido no supera a FL2VA en prompts sin referencias, los límites entre bloques se eligieron experimentando, la memoria necesaria no baja, y la etapa de refinado 2K de MiniMax no es de código abierto, así que la salida local se queda en la resolución base.
Híbrido H3 sin censura: qué cambia y qué no
Nada en la fusión quita ni añade entrenamiento de seguridad; solo se mueven capas de modulación entre dos checkpoints oficiales. Lo que cambia la experiencia es dónde se ejecuta. La API alojada de MiniMax filtra contenido sexual, ilegal o que infrinja derechos, mientras que los pesos abiertos en tu propio equipo no añaden esa capa de filtro, por eso los creadores de contenido adulto prefieren H3 en local. Sin una GPU potente, la herramienta de imagen a vídeo de aquí te da un movimiento sin filtros parecido a partir de una sola foto para escenas adultas (18+).
Anima la foto de un personaje en un clip de vídeo 18+ desde tu navegador.
Abrir imagen a vídeoGenera online: la alternativa sin instalación en Spicy AI
No todo el mundo tiene una estación de trabajo de 66 GB ni ganas de pelearse con checkpoints. Spicy AI ofrece un generador alternativo online para el mismo tipo de clip: sube una foto del personaje, describe el movimiento, la cámara y el sonido, y recibe un vídeo corto en el navegador, sin descargas, sin drivers y sin filtros de contenido para escenas adultas (18+).
Es útil para pruebas rápidas antes de un render local largo, para creadores que solo usan el móvil y para quien simplemente quiere el resultado. Parte de una foto nítida de tu personaje adulto, una acción principal por clip, y reutiliza la misma foto en cada episodio para que la cara y el vestuario se reconozcan.
Probar el generador online de imagen a vídeo →Preguntas frecuentes
¿Qué diferencia hay entre FL2VA y Ref2VA?
FL2VA convierte texto más hasta dos fotogramas iniciales o finales en vídeo con sonido. Ref2VA usa texto más un paquete de referencias de hasta nueve imágenes, tres clips y tres archivos de audio. Según quienes lo han probado en la comunidad, FL2VA tiene mejor imagen y audio.
¿El híbrido MiniMax H3 FL2VA Ref2VA lo ha hecho MiniMax?
No. Es una fusión comunitaria publicada en Hugging Face por smhfacct (int8) y diobrando0 (bf16). Ambos lo consideran experimental y evaluado a ojo.
¿Qué archivo híbrido debo descargar primero?
Empieza con b25-49 en el conjunto int8 o b45-49 en el conjunto bf16. Pasa a un rango más amplio si se ignoran las referencias, o a uno más estrecho si baja la calidad.
¿Cuánta VRAM necesita el híbrido?
Los autores solo dicen que un archivo MiniMax H3 FL2VA Ref2VA equivale al archivo FL2VA correspondiente. Los archivos bf16 pesan unos 66.28 GB, los int8 son más pequeños y no hay una cifra oficial de memoria.
¿Se puede acelerar?
Sí. La LoRA ref2v turbo de 4 pasos funciona con él para borradores rápidos, y siempre puedes usar todos los pasos sin la LoRA para los renders finales.
Fuentes
Más modelos de vídeo con IA sin censura
- MiniMax H3 sin censura
- MiniMax H3 Max sin censura
- Kling sin censura
- Kling 2.6 sin censura
- Kling O1 sin censura
- Sora sin censura
- Veo sin censura
- Hailuo AI sin censura
- Wan sin censura
- Wan 3.0 sin censura
- Seedance sin censura
- Seedance 2.5 sin censura
- Seedance 2.0 sin censura
- Seedance 2.0 Mini sin censura
- HunyuanVideo sin censura
- LTX Video sin censura
- Runway sin censura
- Pika sin censura
- Luma Dream Machine sin censura
- Vidu sin censura
- PixVerse sin censura
- EdenLive sin censura
- Grok Imagine sin censura
- AI Avatars sin censura
- HappyHorse 1.0 sin censura
- Kling 4.0 sin censura
- Kling 3.0 sin censura
- MiniMax H3 RefMods sin censura
- Kandinsky 6.0 sin censura
MiniMax y H3 son marcas comerciales de sus respectivos propietarios. Los archivos híbridos son trabajo de la comunidad. Todo el contenido debe mostrar a adultos (18+).