LoRA abierta · audio + video en streaming
TaoMate-H3 sin censura: video con IA que empieza a reproducirse mientras aún se está creando
Preguntar a la IA ▾
Esperar tres minutos por un clip de diez segundos mata la diversión del video con IA. TaoMate-H3 cambia el ritmo: en lugar de renderizar el clip completo y luego mostrarlo, construye imagen y sonido en pequeños fragmentos y te entrega la primera parte reproducible tras unos 17 segundos. Publicado como LoRA abierta por el equipo AIGC de Alibaba TaoLive, el mismo que está detrás de las herramientas de IA para directos de Taobao, funciona sobre el modelo de pesos abiertos MiniMax H3 y sigue generando mientras le sigas dando prompts. Eso lo convierte en una opción natural para presentadores que hablan, demos de productos e historias por episodios. Aquí verás qué hace, dónde destaca, cómo escribirle prompts y qué hace falta para ejecutarlo.
- LoRA de 3 pasos
- Se reproduce mientras renderiza
- 480p · 768p · 1080p
- Pesos abiertos
TaoMate-H3 frente a MiniMax H3: de tres minutos a diecisiete segundos
Lo más destacado es la velocidad. MiniMax H3 es un sólido modelo abierto de audio y video, pero como la mayoría de los generadores de video termina el clip entero antes de que puedas ver un solo fotograma. TaoMate-H3 añade una LoRA entrenada para eliminar el ruido de cada fragmento en solo tres pasos y luego transmite los fragmentos en orden. En la prueba del propio equipo con ocho tarjetas NVIDIA H20, un clip de diez segundos a 480×864 pudo verse en 17.3 segundos en lugar de 183.3 segundos, y el trabajo principal de difusión bajó de casi 170 segundos a menos de 15.
El uso de memoria apenas cambió, así que la aceleración no se debe a una máquina más grande. Lo que el equipo no ha publicado es una comparación directa de calidad de imagen o rango de movimiento, así que trata la calidad visual como algo que debes juzgar con tus propios ojos y no como una ventaja demostrada.
| Prueba del equipo (8×H20, 480×864, 10 s) | MiniMax H3 | Con la LoRA | Mejora |
|---|---|---|---|
| Primer video reproducible | 183.3 s | 17.3 s | 10.6× más rápido |
| Primer fragmento terminado | 170.1 s | 6.1 s | 27.7× más rápido |
| Tiempo de difusión (DiT) | 169.6 s | 14.8 s | 11.45× más rápido |
| Memoria DiT máxima | 32.03 GiB | 31.37 GiB | Prácticamente igual |
Tres pasos por fragmento: la generación de audio y video en streaming explicada fácil
Imagina una impresora que te entrega cada página en cuanto está lista en lugar de esperar al informe completo. El modelo corta el video y su banda sonora en porciones cortas y crea cada una en tres pasadas de eliminación de ruido. Cada porción terminada se guarda en una caché de memoria y la siguiente se genera sobre ella, de modo que la historia puede continuar sin un final fijo. Para un clip de diez segundos, las notas del equipo cuentan 24 pasadas de generación y 8 actualizaciones de caché.
Mantener estables un rostro y una voz durante una toma larga es lo difícil. El artículo de investigación detrás del proyecto presenta una memoria guiada por anclas: un estado de referencia que fija cómo se ve y cómo suena el personaje, lo que reduce la deriva de color y los vaivenes de identidad con el paso de los minutos. Imagen y sonido se producen juntos, así que labios, voz y ambiente de la sala se mantienen sincronizados en lugar de pegarse después.
Los benchmarks del artículo impresionan: 35 fotogramas por segundo con tres GPU frente a 23 de LiveAvatar con cinco y 16 de LongLive-2.0 con cuatro, además de la mejor puntuación de sincronía labial. Ten en cuenta que esas cifras se midieron con un generador de 22 mil millones de parámetros inicializado desde LTX-2.3, no con la versión H3, así que muestran el potencial del método más que los resultados de este modelo concreto. Entre las opciones de código abierto para video con IA en tiempo real, es una de las pocas que transmite sonido e imagen juntos.
Presentadores digitales, demos de productos estilo directo y dramas cortos
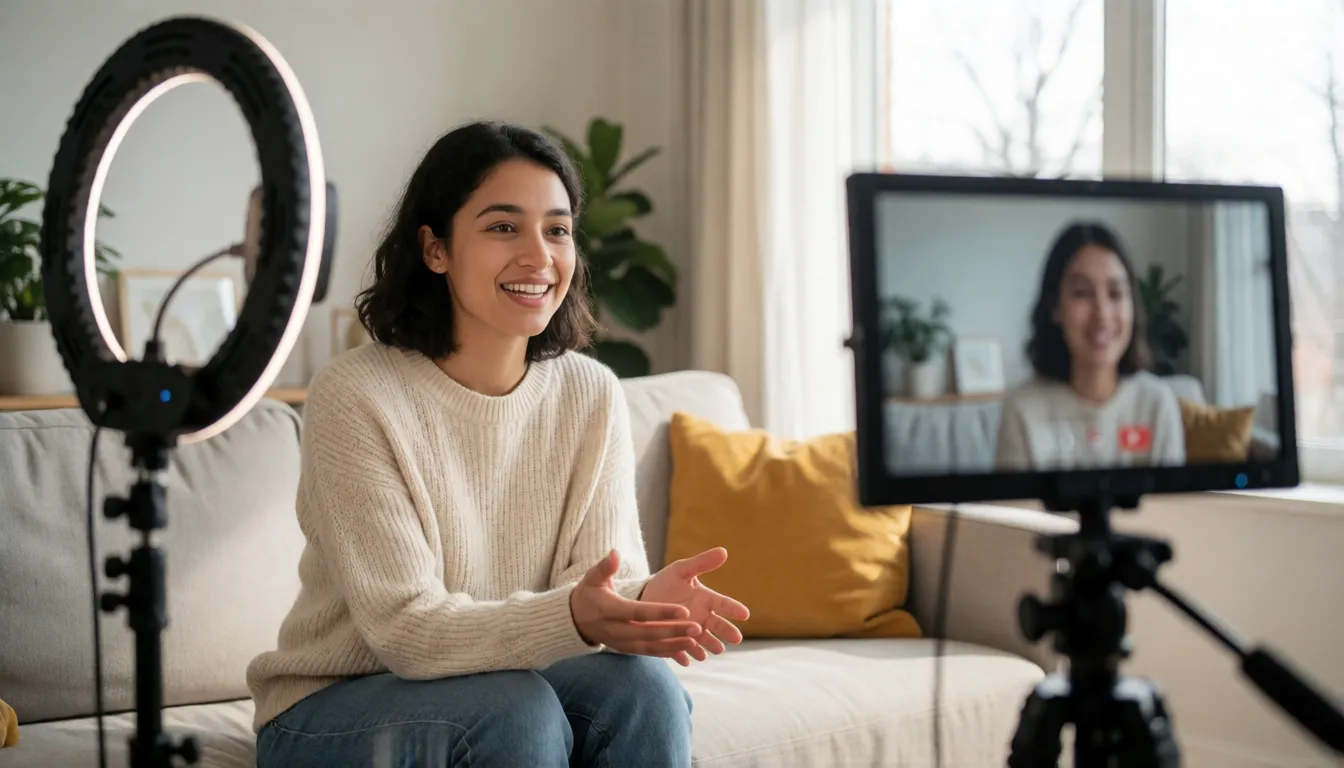
Como viene del equipo de directos de Taobao, el escenario obvio es el presentador que habla. La demo de primer y último fotograma del equipo es un clip de 30 segundos de una presentadora sentada en la sala de una casa explicando cómo organizar el almacenamiento, justo el tipo de segmento que los directos de compras emiten todo el día. El proyecto nunca promete un producto completo de comercio en directo, pero los ingredientes están ahí: un rostro estable, una voz natural y un resultado que llega lo bastante rápido para mantener en marcha un calendario de producción.
Presentadores y vídeos explicativos
Un presentador, una sala y un guion dividido en fragmentos cortos. Ideal para tutoriales, consejos para el hogar e introducciones de canal que necesitan una cara amable a cámara.
Demos de productos y borradores de anuncios
Prepara varias versiones de un pitch de 15 segundos, cambia la frase o el enfoque del producto y compáralas lado a lado antes de reservar un rodaje real.
Dramas cortos por episodios
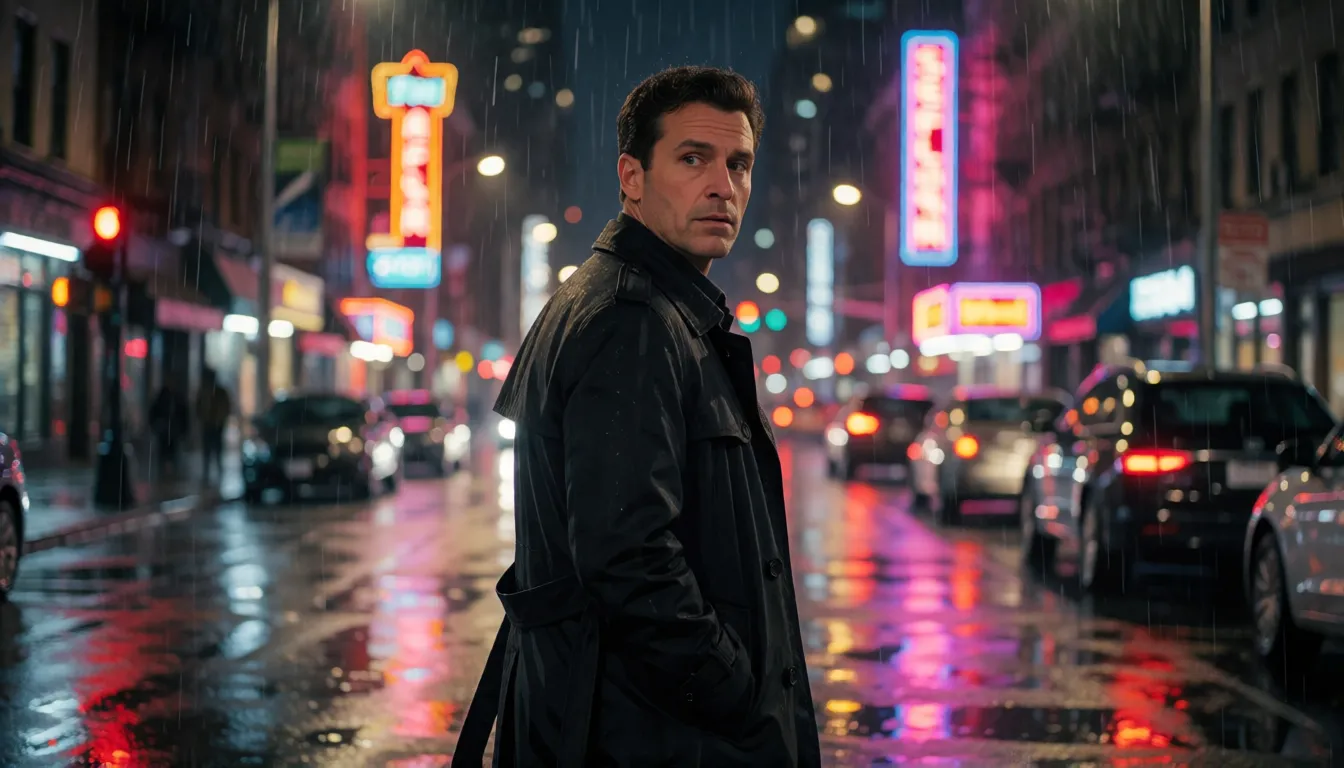
Encadena fragmentos de cinco segundos en una escena continua. Lluvia, neones, una frase susurrada y una revelación, siempre con el mismo actor de un fragmento a otro.
Video social pensado en vertical
Los tamaños verticales nativos de 768×1376 y 1088×1920 encajan directamente en los feeds de video corto sin recortes. El artículo también probó voz en mandarín e inglés.
Cómo construir un video con IA de un minuto, cinco segundos cada vez
El video largo con IA es donde el streaming realmente compensa. La duración se fija en bloques de cinco segundos, y puedes reutilizar un único prompt para todo el recorrido o pasar una lista JSON con un prompt, y opcionalmente una semilla, por cada bloque de cinco segundos. Piénsalo como un storyboard: el bloque uno presenta a la presentadora, el bloque dos muestra el producto, el bloque tres es el primer plano, y el modelo mantiene a la misma persona y la misma sala en cada cambio. Los ejemplos del equipo duran 30 segundos y el artículo prueba un minuto completo de 1,441 fotogramas.
La salida viene en tres tamaños: 480p para borradores rápidos, 768p por defecto y 1080p para la entrega final, cada uno en horizontal o vertical. La variante de primer y último fotograma funciona a 24 fps fijos en vertical de 768×1376, útil cuando cada toma debe empezar y terminar en una pose exacta.
Plantillas de prompts para presentadores y escenas en serie
El truco para lograr tomas largas coherentes es la repetición. Vuelve a describir el aspecto, la ropa y el escenario de la persona en cada bloque, da a cada bloque una sola acción principal, pon los diálogos entre comillas y describe el sonido por separado. Estos ejemplos siguen ese patrón y sirven como primer borrador para tus propios guiones.
Presentadora · bloque 1
Plano medio, una mujer joven con un suéter color crema sentada en un sofá en una sala luminosa, hablando a cámara, explicando cómo doblar toallas dentro de una caja de almacenaje, gestos naturales, luz cálida de día, cámara estable. Audio: voz femenina clara, suave ambiente de sala.
Presentadora · bloque 2 (continuación)
La misma mujer, el mismo suéter crema, la misma sala. Levanta la caja hacia la cámara y sonríe: "En esta caben tres toallas." La cámara se acerca lentamente. Audio: la misma voz, ligero roce de tela.
Fragmento de drama corto
Calle de noche bajo la lluvia, un hombre con gabardina negra se da la vuelta, primer plano, dice en voz baja: "Al final viniste." Reflejos de neón sobre el asfalto mojado. Audio: lluvia constante, truenos lejanos.
Anuncio de bañadores para adultos (18+, modelo ficticia)
Una modelo de moda adulta de casi treinta años con un bikini rojo camina por una playa soleada y habla a cámara sobre los bañadores de este verano, sonrisa relajada, plano de seguimiento. Audio: su voz, olas, brisa suave.
TaoMate-H3-FL2VA y TaoMate-HD: una familia en crecimiento
El proyecto avanza rápido. La primera versión, en septiembre de 2026, llevó el streaming de texto a audio y video a H3. El 15 de octubre de 2026 el equipo añadió TaoMate-H3-FL2VA, que toma un primer y un último fotograma y transmite el clip intermedio; según el equipo, hasta donde sabe, es el primer modelo de audio y video en tiempo real de primer y último fotograma. Es la versión a elegir cuando un storyboard fija cómo empieza y termina cada toma.
El 3 de noviembre de 2026 llegó TaoMate-HD, que se apoya en el runtime de H3 con generación progresiva orientada a resultados más nítidos; su página de proyecto tiene los detalles. La generación basada en referencias (Ref2AV) figura como próxima, aún sin fecha.
Cómo ejecutar TaoMate-H3 desde Hugging Face y GitHub
La LoRA en sí es pequeña: solo un archivo de configuración, una configuración del adaptador y un archivo safetensors (rango 128), publicada en Hugging Face con un espejo en ModelScope. Las instrucciones de instalación están en el repositorio de GitHub. El problema es el hardware: la única configuración verificada son ocho tarjetas NVIDIA H20 de 96 GB, y los scripts aceptan cuatro u ocho GPU de clase Hopper.
- 1Prepara Linux con Python 3.10 o 3.11, CUDA 12.8, PyTorch 2.8, vLLM 0.11.1, FlashAttention para Hopper y FFmpeg.
- 2Descarga el modelo base MiniMax H3 (model_index.json más sus carpetas) y la LoRA de TaoMate desde Hugging Face.
- 3Elige un tamaño (480p, 768p o 1080p) y ajusta --duration a un múltiplo de 5 segundos.
- 4Pasa un --prompt para todo el clip, o --prompt-json con un prompt y una semilla opcional por cada bloque de cinco segundos.
- 5Ejecuta con --gpus 4 u 8 y mira cómo se reproducen los primeros fragmentos mientras el resto aún se genera.
- Requisitos de GPU: no se ha publicado una VRAM mínima y no hay una vía oficial para tarjetas RTX 4090 o 5090.
- ComfyUI: todavía no existen nodos oficiales, así que la línea de comandos es la vía soportada.
- Demo en línea: dos Spaces de la comunidad en Hugging Face permiten probar el modelo de 3 pasos en el navegador, y la página del modelo indica un proveedor de inferencia alojado.
Por qué los creadores siguen de cerca este lanzamiento
La generación abierta de audio y video en tiempo real es poco común, y eso es lo que ha captado la atención. En unos dos meses el repositorio de GitHub superó las 800 estrellas, la página de Hugging Face reunió más de 130 me gusta y la comunidad levantó dos Spaces de demo públicos. El entusiasmo se centra en ver un clip empezar casi al instante y en tomas largas que mantienen el mismo rostro. Lo que frena a la mayoría está claro en los requisitos: una configuración multi-GPU de centro de datos, sin vía oficial todavía para tarjetas de consumo ni para ComfyUI.
TaoMate-H3 sin censura: qué significan los pesos abiertos para los creadores adultos
No existe una edición sin censura aparte de TaoMate-H3, ni hace falta en el sentido habitual: tanto la LoRA como la base H3 son de pesos abiertos, las páginas del proyecto no describen ningún filtro de contenido ni clasificador de seguridad, y una ejecución local nunca pasa por un servicio de moderación en la nube. Para los creadores adultos, eso significa que las reglas las marcan la propia licencia del modelo y tu configuración. Si no tienes un equipo con ocho GPU, Spicy AI ofrece en línea una herramienta similar de imagen a video con filtros relajados para personajes adultos y ficticios.
Sube una imagen fija de tu personaje adulto original y dale vida con sonido, sin necesidad de GPU.
Abrir imagen a videoGenerador de video alternativo sin censura
Empieza con una foto de un personaje adulto original, describe el movimiento y la frase que debe decir, y obtén un clip hablado corto en tu navegador.
Empezar a generarAlojar TaoMate-H3 por tu cuenta frente a generar en línea con Spicy AI
Ejecutarlo tú mismo te da streaming en tiempo real y control total; la opción en línea lo cambia por cero configuración.
| Despliegue local (pesos publicados) | Spicy AI en línea | |
|---|---|---|
| Filtros de contenido | Tú configuras tu propio entorno | Filtros relajados para contenido adulto (18+) |
| Pesos abiertos | Sí (LoRA + base H3) | No hace falta, funciona en el navegador |
| Modelo que se usa realmente | LoRA de TaoMate sobre MiniMax H3 | Un modelo alojado de imagen a video |
| Coste para empezar | De cuatro a ocho GPU Hopper | Plan gratuito disponible |
Preguntas frecuentes
¿Qué es TaoMate-H3?
Una LoRA de 3 pasos y un runtime de streaming construidos sobre MiniMax H3 por el equipo AIGC de TaoLive de Alibaba. Genera audio y video juntos por fragmentos, así que la reproducción empieza mientras el resto aún se renderiza.
¿Cuánto más rápido es que MiniMax H3?
En la prueba del equipo con ocho GPU H20 a 480×864 durante 10 segundos, el primer video reproducible llegó tras 17.3 segundos frente a 183.3 segundos, y el tiempo de difusión fue 11.45 veces menor.
¿Puede ejecutarse en una RTX 4090 o 5090?
No oficialmente. Solo se admiten GPU Hopper, la configuración verificada son ocho tarjetas H20 de 96 GB, se pueden usar cuatro u ocho GPU y no se ha publicado una VRAM mínima.
¿Admite video de primer y último fotograma?
La versión principal es de texto a audio y video. El streaming de primer y último fotograma llega con TaoMate-H3-FL2VA, publicado el 15 de octubre de 2026. La generación basada en referencias aún no se ha lanzado.
¿Cuánto pueden durar los videos?
La duración crece en pasos de cinco segundos y puede seguir avanzando. Las muestras del equipo duran 30 segundos y el artículo evalúa clips de un minuto con 1,441 fotogramas.
¿Hay un nodo de ComfyUI?
Por ahora no, al menos del equipo. La forma soportada de ejecutarlo son los scripts de línea de comandos del repositorio de GitHub.
¿Existe una versión sin censura?
No existe una dedicada. Los pesos son abiertos y las páginas del proyecto no describen ningún filtro integrado, así que una ejecución local se rige por la licencia comunitaria de H3 y no por moderación en la nube.
Fuentes
- Ficha del modelo TaoMate-H3 (Hugging Face)
- Repositorio, benchmarks y novedades de TaoMate-H3 (GitHub)
- Artículo de TaoMate en arXiv (2607.24359)
- Ficha del modelo TaoMate-H3-FL2VA (Hugging Face)
- Página del proyecto TaoMate-HD
- Modelo base MiniMax H3 (Hugging Face)
- Space de demo de 3 pasos de la comunidad (Hugging Face)