Avatar guiado por áudio · Pesos abertos
LongCat-Video-Avatar 1.6 sem censura: uma foto, uma voz, dez minutos de vídeo falado
Envie um retrato e uma gravação, e o LongCat-Video-Avatar 1.6 devolve um vídeo dessa pessoa falando: os lábios acompanham cada sílaba, o rosto reage ao tom de voz e a cabeça e os ombros se movem como as pessoas realmente se movem ao falar. Lançada pela equipe LongCat da Meituan em 15 de novembro de 2026, esta atualização gira em torno de continuar convincente por muito tempo, com a equipe relatando clipes de mais de dez minutos que mantêm o mesmo rosto e uma imagem nítida. Abaixo você encontra o que mudou, onde os criadores estão usando o modelo, truques para diálogos a dois, prompts prontos para copiar e as formas mais rápidas de experimentar.
- Foto + voz → vídeo
- Tomadas de mais de 10 minutos
- Sincronia labial natural
- Diálogo a dois
Gerador de vídeo alternativo sem censura
Imagem para vídeoComece com um retrato, descreva como o personagem fala, sorri e se move, e abrimos o estúdio de imagem para vídeo com tudo preenchido. Temas adultos são bem-vindos quando todas as pessoas mostradas têm 18 anos ou mais e são fictícias ou consentiram.
Vídeos falados de dez minutos que não desandam
Quem já testou cabeças falantes com IA conhece o problema de sempre: os primeiros segundos ficam ótimos, depois o rosto vai derretendo aos poucos, a boca começa a tremular e a pessoa já não se parece com a foto inicial. O LongCat-Video-Avatar 1.6 foi criado justamente para resolver isso. O modelo vai estendendo o vídeo trecho por trecho, e a equipe o treinou em gerações longas para que pequenos erros parem de se acumular. A promessa é simples e ousada: mais de dez minutos de filmagem com a mesma identidade, qualidade de imagem estável e movimento fluido.
Para criadores, isso muda o fluxo de trabalho. Uma aula completa, uma longa demonstração de produto, um episódio de podcast ou um capítulo de audiolivro podem ser uma única tomada contínua, em vez de uma pilha de clipes de quinze segundos colados no editor. Você também pode manter um mesmo personagem ao longo de uma série inteira: envie um áudio novo toda semana e o mesmo rosto continua falando, que é o que apresentadores virtuais e canais de histórias mais precisam.
- Áudio + foto: anime um retrato existente, o modo mais popular.
- Áudio + texto: ainda não tem foto? Descreva a pessoa e deixe o modelo criá-la.
- Continuação: estenda um clipe existente com a próxima parte do áudio, mantendo o visual.
- Várias pessoas: dê a cada falante sua própria faixa de áudio para conversas.
LongCat Avatar 1.6 vs 1.5: lábios mais contidos, rostos mais estáveis
A versão 1.5 chegou em maio de 2026 e já era uma das favoritas dos fãs de código aberto. O novo lançamento mantém a mesma base e o mesmo codificador de áudio Whisper-Large, então as melhorias vêm do treinamento, não de uma nova arquitetura. O que você vai ver de fato na tela: bocas que já não exageram na articulação de cada palavra, lábios sem aquele vermelho artificial, menos tremulação ao redor da boca e expressões faciais que se movem junto com a cabeça e o corpo. No teste cego da própria equipe, com 33.051 votos válidos, a 1.6 ficou em segundo lugar entre seis sistemas, atrás apenas do OmniHuman-2.0, que é fechado, e à frente da 1.5, do HeyGen, do OmniHuman-1.5 e do Kling Avatar 2.0. Esse ranking é uma avaliação do próprio desenvolvedor, não um benchmark independente.
| Versão 1.5 | Versão 1.6 | |
|---|---|---|
| Lançamento | 21 de maio de 2026 | 15 de novembro de 2026 |
| Movimento da boca | Às vezes exagerado, lábios avermelhados | Mais suave, mais natural, menos tremulação |
| Vídeos longos | O desvio se acumula com o tempo | Mais de 10 minutos com identidade estável (segundo a equipe) |
| Velocidade | Amostragem destilada em 8 passos | 8 passos: mistura DMD + OPSD primeiro, depois só OPSD |
| Preferência humana (Elo) | Menor | 1068,1, segundo de seis sistemas |
Um testador da comunidade que converteu o modelo para Mac relatou pontuações de sincronia labial SyncNet de cerca de 6,8–7,4 para a 1.6, contra cerca de 6,5 para a 1.5 (filmagem real: 7,05). Números não oficiais.
De foto a vídeo falado: onde os criadores estão usando
Cabeças falantes guiadas por áudio eram um brinquedo para demonstrações. Com tomadas mais longas e rostos mais naturais, viraram uma ferramenta prática para quem precisa de uma pessoa na tela lendo um roteiro, sem contratar apresentador, alugar estúdio ou se gravar. Combine um retrato com uma voz gravada ou uma faixa de texto para fala e você tem um apresentador, um professor, um narrador ou um personagem fictício em minutos. As cenas abaixo são as que criadores de vídeos curtos, educadores e criadores de personagens estão testando primeiro.
- Minisséries e quadrinhos com IA: cenas de diálogo fala a fala para cada personagem, feitas em lote a partir de roteiros em TTS.
- Vídeos de produtos e lojas: um apresentador simpático explica um produto ou apresenta uma loja em tom natural e descontraído.
- Cursos e vídeos explicativos: um professor de dez minutos que não para de gesticular e acenar, ou versões dubladas em outros idiomas (a qualidade pode variar conforme o idioma).
- Apresentadores virtuais e companheiros de IA: um personagem que responde fãs ou mensagens de chat com um vídeo.
- Fotos antigas e pinturas que falam: dê voz a um retrato de família ou a uma obra de arte para um post marcante.
- Diversão com canto e dublagem: como o modelo segue o áudio, vale testar com clipes de música, embora os resultados não tenham sido testados oficialmente.
Aulas e palestras longas
Transforme uma narração completa em um único vídeo contínuo com apresentador, em vez de dezenas de clipes curtos.
Diálogos dramáticos
Dê a dois personagens suas próprias faixas de voz e obtenha uma cena de vaivém com reações naturais.
Apresentadores virtuais
Mantenha o mesmo rosto ao longo de uma série inteira de episódios, vídeos de produtos ou respostas a fãs.
Conversas a dois, entrevistas e duetos
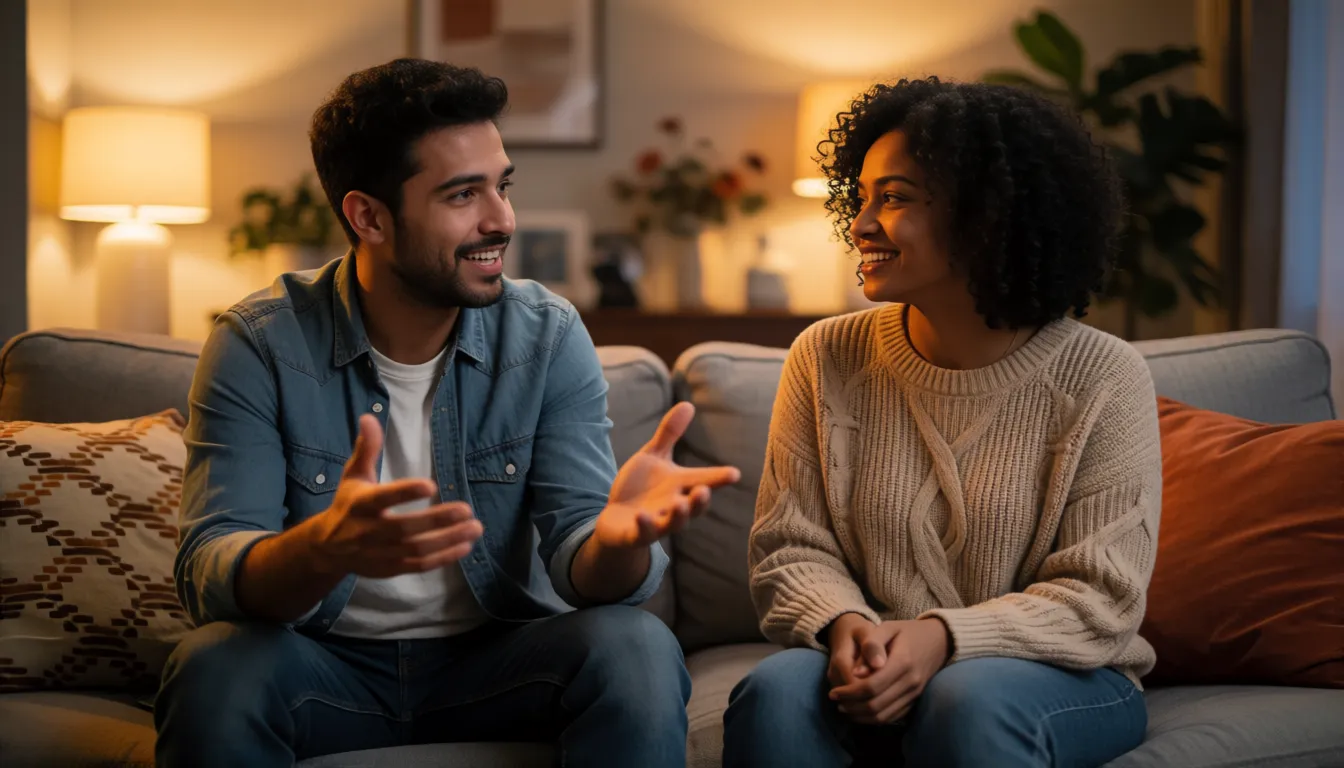
Um dos modos mais divertidos do LongCat-Video-Avatar 1.6 é o vídeo com várias pessoas. Dê ao modelo uma imagem com duas pessoas e uma faixa de áudio separada para cada uma, e ele anima quem estiver falando enquanto a outra escuta e reage. Isso abre formatos que antes exigiam dois atores: uma entrevista no estilo podcast, um casal discutindo em uma minissérie, uma dupla de comédia, uma encenação entre professor e aluno ou um apresentador conversando com um convidado. Como a estabilidade em vídeos longos se mantém, esses diálogos podem durar minutos, e não apenas uma troca de falas.
Um bom truque é manter a cena simples: duas pessoas de frente uma para a outra ou sentadas lado a lado, ambos os rostos bem visíveis, e um prompt que diga quem fala primeiro. Depois grave ou gere as duas vozes separadamente e alinhe-as como um vaivém natural, com pequenas pausas entre as falas.
Modelos de prompt para vídeos falados naturais
O ponto principal ao escrever prompts para o LongCat-Video-Avatar 1.6 é este: o áudio decide o que a pessoa diz, o prompt de texto decide como a cena fica. Descreva distância da câmera, clima, gestos e iluminação, nunca o diálogo em si. Em vídeos longos, mantenha a mesma descrição da pessoa em todos os segmentos para que o personagem não se desvie. Estes modelos cobrem os formatos favoritos; troque os detalhes e mantenha a estrutura.
- Apresentadora: uma jovem em um estúdio iluminado, plano médio, falando com carinho para a câmera, gestos naturais com as mãos, luz do dia suave, câmera estável.
- Fala de produto: um homem segurando uma xícara de café no balcão de uma cafeteria, sorrindo, explicando o produto com expressões animadas, pouca profundidade de campo.
- Aula: um professor diante de um quadro branco, tom calmo, acenos de cabeça ocasionais e gestos apontando, plano fixo em tripé.
- Diálogo: dois amigos sentados em um sofá, de frente um para o outro, a pessoa da esquerda fala primeiro e a da direita responde, iluminação casual de sala de estar.
- Cantora: uma cantora em um pequeno palco, rosto expressivo, balançando suavemente no ritmo, holofote quente.
- Monólogo sedutor (18+): uma mulher adulta fictícia de biquíni em uma praia ao pôr do sol, sorriso sedutor, falando baixinho para a câmera, brisa suave nos cabelos.
Download no Hugging Face, ComfyUI, INT8, GGUF e Mac MLX
Se você gosta de rodar tudo por conta própria, os pesos podem ser baixados gratuitamente no Hugging Face e no ModelScope, e o código fica no repositório LongCat-Video no GitHub. A equipe não publicou um requisito oficial de memória, mas oferece uma opção INT8 só de pesos para configurações mais leves, e a comunidade agiu rápido: há pacotes para ComfyUI (incluindo um da Comfy-Org), uma build de ComfyUI para a 1.6, conversões INT8 e arquivos GGUF da linha 1.5 para placas com pouca VRAM.
Quem tem Mac também conta com uma conversão para Apple MLX. O autor relata que, em um M5 Max com 64 GB de memória, cada segmento de 3,7 segundos em 480p leva cerca de oito minutos e atinge picos perto de 47 GB, então um vídeo de dez minutos é trabalho para a madrugada inteira. É por isso que muitos criadores preferem uma ferramenta no navegador para ideias rápidas e deixam as execuções locais para as tomadas longas finais.
Modelos de avatar falante de código aberto em 2026: uma alternativa ao HeyGen e ao OmniHuman?
Serviços de avatar por assinatura como HeyGen, OmniHuman e Kling Avatar são bem acabados, mas limitam a duração dos clipes, cobram por minuto e moderam o que você envia. O modelo da Meituan é a alternativa aberta que muita gente esperava: pesos gratuitos sob licença MIT, tomadas que passam de dez minutos e uma pontuação de preferência humana que, no teste dos próprios criadores, supera o HeyGen e o Kling Avatar 2.0. Outras opções abertas incluem o Kandinsky S2V, que anima o corpo inteiro a partir de prompts de texto, e o MultiTalk para cenas com várias pessoas. O porém de qualquer modelo aberto é o hardware: vídeos longos exigem uma GPU potente ou muita paciência.
Crie um vídeo de personagem falante 18+ no Spicy AI
O lançamento oficial não tem filtro de conteúdo integrado descrito no seu cartão de modelo, e ainda não existe nenhum ajuste fino sem censura da comunidade; hoje, as pessoas o usam rodando localmente com suas próprias artes de personagens adultos. Para um caminho mais rápido no navegador, o estúdio de imagem para vídeo do Spicy AI anima qualquer retrato de um personagem fictício maior de 18 anos, de um monólogo divertido de biquíni a uma saudação sussurrada no estilo ASMR ou uma resposta de namorada virtual.
- 1Crie ou envie um retrato de um personagem adulto fictício; experimente antes um visual de maiô ou lingerie feito com o editor de imagens.
- 2Descreva como ele fala e se move: um sorriso, uma inclinação para a câmera, uma piscadela, luz suave.
- 3Gere o clipe e depois adicione sua própria narração ou faixa de TTS na edição.
Para resultados mais limpos, tenha em mente estas dicas sobre o material de entrada:
- Use um retrato nítido e frontal, com o rosto bem iluminado e sem mãos ou cabelo cobrindo.
- Use fala limpa, sem música de fundo; o guia oficial da 1.5 sugere um CFG de áudio de 3–5 ao rodar localmente.
- Mantenha a descrição do personagem idêntica entre os segmentos para que os vídeos longos fiquem consistentes.
Dê vida a um retrato de personagem 18+ no seu navegador, sem precisar de GPU.
Começar imagem para vídeo →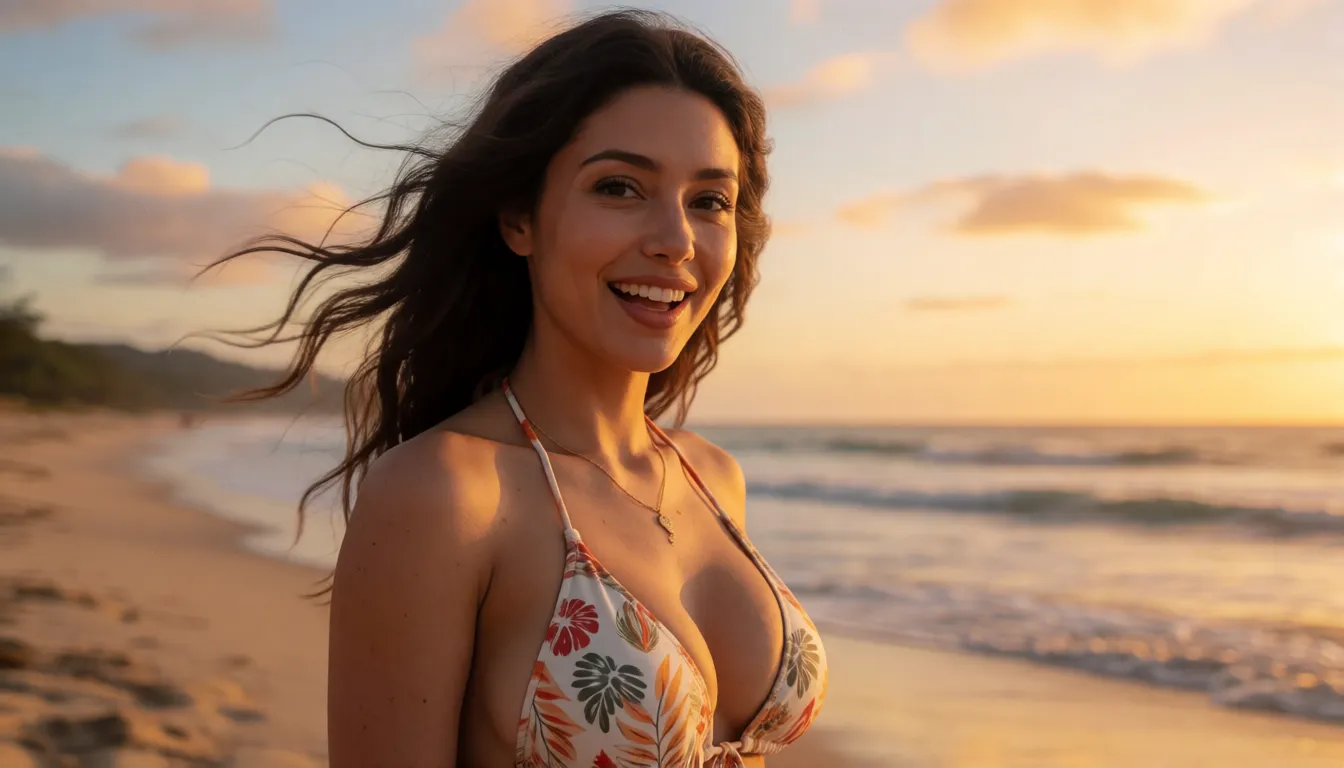
Hospedar o LongCat Avatar 1.6 por conta própria vs gerar online no Spicy AI
| Implantação local (pesos oficiais) | Spicy AI online | |
|---|---|---|
| Filtragem de conteúdo | Sem filtro online quando você roda por conta própria | Conteúdo adulto (18+) permitido |
| Pesos abertos | Sim, licença MIT no Hugging Face | Não se aplica, roda online |
| Modelo usado de fato | LongCat Avatar 1.6 (avatar-v1.6) | Modelos de vídeo próprios do Spicy AI |
| Preço | Pesos gratuitos, você paga pela GPU | Grátis para começar, créditos para mais |
- Local: sincronia labial guiada pelo seu próprio áudio, tomadas de mais de dez minutos, controle total.
- Spicy AI: anime um retrato no navegador, sem hardware nem configuração.
Perguntas frequentes
O que é este modelo?
É um modelo de vídeo de avatar falante com pesos abertos, lançado pela equipe LongCat da Meituan em 15 de novembro de 2026. Ele transforma um retrato (ou uma descrição em texto) mais uma fala em um vídeo falado, e suporta os modos de uma pessoa, várias pessoas e continuação longa.
O que a 1.6 tem de melhor que a 1.5?
A sincronia labial é mais precisa, as expressões e os movimentos da cabeça ou do corpo parecem mais coordenados, formatos de boca exagerados e lábios vermelhos demais foram reduzidos, e os erros se acumulam menos em vídeos longos. A equipe diz que é possível passar de dez minutos, e a inferência ficou mais rápida de ponta a ponta.
Qual pode ser a duração dos vídeos?
A equipe relata mais de dez minutos com qualidade e identidade estáveis. O modelo funciona estendendo o vídeo segmento por segmento; a build da comunidade para Mac, por exemplo, gera segmentos de 93 quadros com cerca de 3,7 segundos cada.
Que hardware preciso para rodar localmente?
Nenhum valor oficial de memória foi publicado. Há uma opção INT8 só de pesos, o FlashAttention 3 é recomendado em GPUs Hopper, e a versão MLX da comunidade atingiu picos de cerca de 47 GB em um M5 Max de 64 GB. A maioria dos usuários casuais vai achar uma ferramenta online mais fácil.
Funciona no ComfyUI?
O repositório no GitHub não lista nós oficiais para ComfyUI, mas o Hugging Face hospeda um pacote da Comfy-Org, uma build de ComfyUI da comunidade para a 1.6 e arquivos GGUF da linha 1.5.
Existe uma versão sem censura?
Até 20 de novembro de 2026 não havia surgido nenhum ajuste fino sem censura da comunidade. Os pesos rodam localmente e o cartão do modelo não descreve um filtro de conteúdo. Criações adultas devem usar apenas personagens maiores de 18 anos, fictícios ou que tenham consentido.
Como ele se compara ao HeyGen ou ao OmniHuman?
Na avaliação humana da própria equipe, ficou em segundo lugar entre seis sistemas, atrás do OmniHuman-2.0 e à frente do HeyGen e do Kling Avatar 2.0. Suas principais vantagens são os pesos abertos e as tomadas muito longas.
Fontes
- Cartão do modelo LongCat-Video-Avatar-1.6 (Hugging Face)
- Repositório meituan-longcat/LongCat-Video (GitHub)
- Página do projeto LongCat-Video-Avatar 1.6
- Relatório técnico do LongCat-Video-Avatar 1.6 (PDF)
- Relatório técnico do LongCat-Video (arXiv 2510.22200)
- Cartão do modelo LongCat-Video-Avatar-1.5 (Hugging Face)
- LongCat-Video-Avatar 1.6 no ModelScope
- Pacote LongCat-Video-Avatar da Comfy-Org (Hugging Face)
- Conversão MLX bf16 da comunidade para Mac (Hugging Face)
Mais guias de modelos de vídeo sem censura
- Kandinsky S2V 1.0 Pro sem censura
- Kling sem censura
- Kling 2.6 sem censura
- Kling O1 sem censura
- Sora sem censura
- Veo sem censura
- Hailuo AI sem censura
- MiniMax H3 Max sem censura
- Wan sem censura
- Wan 3.0 sem censura
- Seedance sem censura
- Seedance 2.5 sem censura
- Seedance 2.0 sem censura
- Seedance 2.0 Mini sem censura
- HunyuanVideo sem censura
- LTX Video sem censura
- Runway sem censura
- Pika sem censura
- Luma Dream Machine sem censura
- Vidu sem censura
- PixVerse sem censura
- EdenLive sem censura
- UniAVC sem censura
- Grok Imagine sem censura
- AI Avatars sem censura
- HappyHorse 1.0 sem censura
- MiniMax H3 FL2VA Ref2VA sem censura
- Kling 4.0 sem censura
- Kling 3.0 sem censura
- MiniMax H3 RefMods sem censura
- Kandinsky 6.0 sem censura
- Looking Ahead sem censura
- TaoMate-H3 sem censura
- SANA-Video 2.0 sem censura
- MiniMax H3 Remix sem censura
- Sora 2 sem censura
- Wan 2.6 sem censura
- LTX-2.5 Slow Motion sem censura
- LTX-2.5 Cinemagraph sem censura
- VDN MiniMax H3 sem censura
- Hy-Nomas sem censura
- Seedance 1.5 Pro sem censura
- Pika H3 Flex sem censura
- Veo 3.1 sem censura
- MiniMax H3 x Z-Image sem censura
- Origami-H3 sem censura
- Wan 2.6 Flash sem censura
O Spicy AI é um site independente e não tem afiliação com a Meituan nem com a equipe LongCat. O conteúdo deve envolver apenas adultos (18+); não anime pessoas reais sem o consentimento delas.