Fala para vídeo · Pesos abertos
Kandinsky S2V 1.0 Pro sem censura: faça qualquer foto falar, gesticular e cantar
O Kandinsky S2V 1.0 Pro recebe três coisas simples, uma única foto, uma gravação de alguém falando e uma breve descrição da cena, e devolve um vídeo em que essa pessoa fala com movimento labial sincronizado, mexe as mãos e os ombros e permanece fiel ao personagem do primeiro ao último segundo. Ele vem do Kandinsky Lab, a equipe por trás do Kandinsky 5.0 e 6.0, e os pesos podem ser baixados gratuitamente. Este guia mostra onde os criadores o utilizam, o que deixa os resultados naturais, qual versão combina com a sua GPU, prompts prontos para copiar e como ele se compara a outros modelos abertos de avatares falantes.
- Foto + voz → vídeo
- Corpo inteiro, não só o rosto
- 25 fps, qualquer duração
- Versão rápida de 16 passos
Gerador de vídeo alternativo sem censura
Imagem para vídeoAssim como o Kandinsky S2V 1.0 Pro, ele parte de um retrato: envie a imagem, descreva como a pessoa deve se mover e como é a cena, e abrimos o estúdio de imagem para vídeo com tudo preenchido. Temas adultos são bem-vindos quando todos os retratados têm 18+.
Uma foto, um áudio de voz, uma performance inteira
A maioria das ferramentas de foto falante anima só o rosto: a boca abre e fecha enquanto o resto da imagem fica congelado. O Kandinsky S2V 1.0 Pro funciona de outro jeito. Você fornece uma imagem de referência, uma gravação de fala limpa (16 kHz mono) e um prompt de texto, e ele gera um vídeo a 25 fps em que a pessoa inteira ganha vida. Os lábios acompanham cada sílaba, as mãos fazem os gestos que as pessoas usam ao explicar algo e o fundo se comporta como o seu prompt descreve. O resultado mantém a proporção da sua foto e traz a sua faixa de áudio original, então o clipe já sai pronto para publicar.
A duração também não é fixa. O Kandinsky S2V 1.0 Pro trabalha em blocos de cinco segundos com 125 quadros, e cada novo bloco continua de onde o anterior parou, então uma narração de dois minutos vira um vídeo de dois minutos da mesma pessoa. A sincronia labial é o que as pessoas notam primeiro: cada quadro do vídeo escuta apenas o seu próprio trecho do áudio, por isso os formatos da boca caem no som certo em vez de ficarem atrasados.
Onde os vídeos falantes a partir de uma única foto estão decolando
Avatares guiados por voz saíram das demonstrações técnicas e entraram no trabalho de conteúdo do dia a dia, e o Kandinsky S2V 1.0 Pro se encaixa perfeitamente nisso. Os usos abaixo são os mais citados pelo pacote de pesquisa e pelas comunidades de criadores, e todos compartilham uma necessidade: uma pessoa convincente na tela que diz exatamente o que o seu áudio diz, sem reservar estúdio nem contratar apresentador.
- Minisséries e quadrinhos animados: dê a cada retrato de personagem a sua faixa de diálogo e obtenha planos de diálogo de corpo inteiro que parecem cenas, não figurinhas.
- Clipes de produto e live commerce: a foto de um modelo mais uma gravação de apresentação do produto vira um vídeo explicativo no estilo apresentador em minutos.
- Cursos, resumos de notícias e treinamentos: transforme um roteiro de narração em uma aula longa com um professor virtual que continua gesticulando por minutos.
- Streamers virtuais e companheiros de IA: combine a imagem de um personagem com uma voz de texto para fala e o personagem responde diante da câmera.
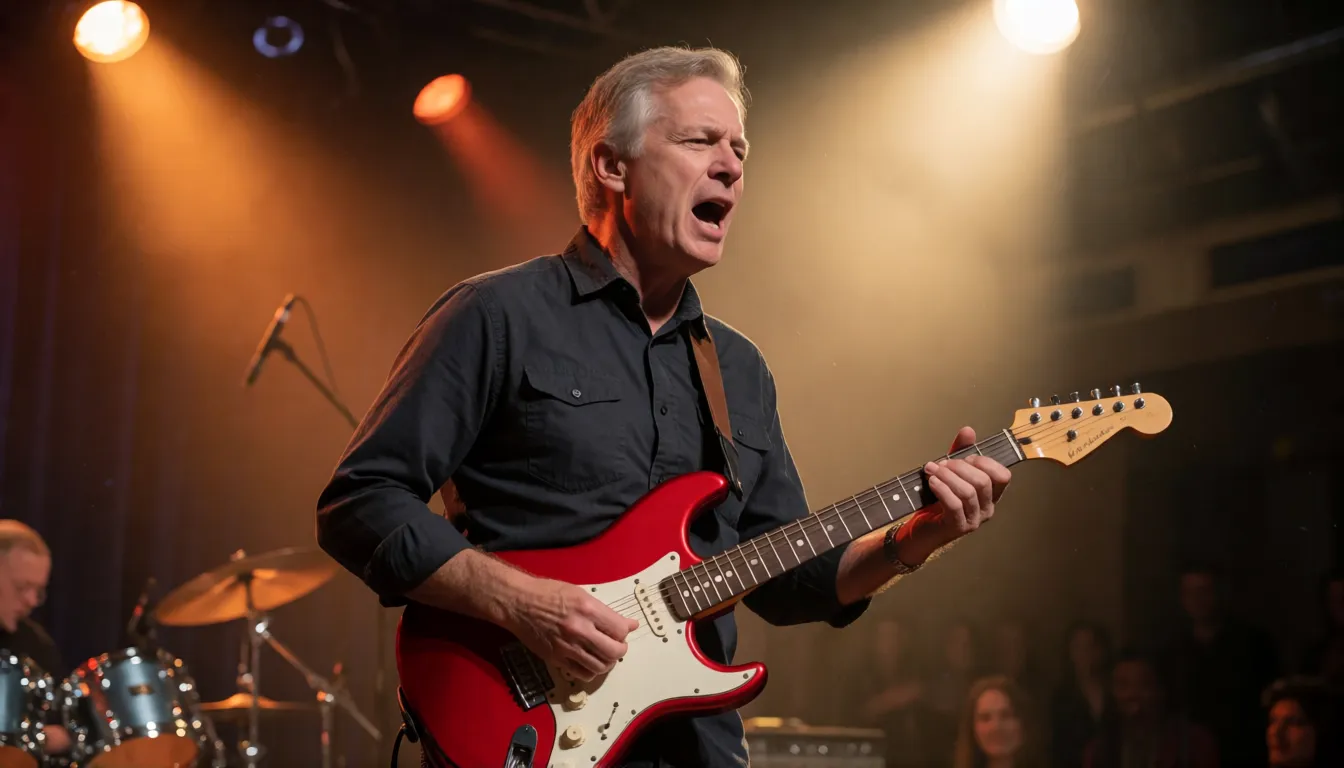
- Música e podcasts: o exemplo oficial do Diffusers é um homem grisalho tocando uma guitarra elétrica vermelha, um sinal de que clipes de performance são válidos (a qualidade do canto não foi avaliada pela equipe).
- Dublagem multilíngue: mantenha uma foto e troque as faixas de voz em diferentes idiomas; as legendas de treinamento eram em inglês e russo, então teste outros idiomas antes de um projeto grande.
Diálogos de minisséries
Dê a cada retrato de personagem a sua fala e o Kandinsky S2V 1.0 Pro devolve cenas de corpo inteiro com sincronia labial precisa.
Vídeos explicativos de produto
A foto de um modelo e uma apresentação gravada viram um clipe no estilo apresentador para lojas e live commerce.
Apresentadores virtuais
Combine a imagem de um personagem com uma voz TTS para streamers, professores e companheiros de IA que respondem.
O que deixa os resultados naturais
Três escolhas de design separam o Kandinsky S2V 1.0 Pro das muitas ferramentas de sincronia labial que vieram antes. Primeiro, é animação de corpo inteiro: o modelo parte do Kandinsky 5.0 Video, então já sabe como corpos, roupas e cenas se movem, e o prompt pode orientar gestos e cenário. Segundo, ele entende tanto as palavras quanto a voz: o Qwen2.5-Omni lê o seu prompt de texto e escuta a fala a 25 tokens por segundo, o que ajuda o movimento a acompanhar a energia da fala. Terceiro, uma memória em três níveis leva a aparência da foto de referência de bloco em bloco, então rostos e roupas permanecem consistentes em tomadas longas.
O Kandinsky S2V 1.0 Pro também tem uma edição destilada. O Pro distill chega ao resultado em 16 passos em vez de 50 e incorpora o guidance nos pesos, o que a equipe relata como cerca de cinco vezes mais rápido (entre 4,5× e 5,6× dependendo da configuração), igualando o modelo base em quase todas as métricas. No estudo com avaliadores humanos do artigo, contra o baseline aberto mais forte e dois serviços comerciais, o Kandinsky S2V 1.0 Pro foi avaliado em média como equivalente ou melhor, com a sincronia labial sendo o aspecto mais preferido.
- Movimento de corpo inteiro e controle da cena a partir de um prompt de texto
- Sincronia labial precisa quadro a quadro graças à atenção de áudio por quadro
- Sem limite rígido de duração graças à continuação bloco a bloco
- Pesos abertos sob licença MIT, roda localmente
- Exige uma GPU de 48 GB para o modelo Pro (80 GB para HD)
- Não cria som, então você traz a sua própria voz ou TTS
- Ainda não há versão quantizada oficial para placas de 24 GB
- O modo HD não foi treinado nem avaliado nessa resolução
Lite ou Pro, base ou distill: escolhendo uma versão
O Kandinsky S2V 1.0 Pro pertence a uma família de quatro checkpoints. Os modelos Lite de 2B são a opção rápida e mais leve; os modelos Pro de 21B oferecem os melhores rostos, mãos e movimentos. Em cada tamanho, a edição destilada é a escolha do dia a dia e o modelo base de 50 passos é para quem busca o último detalhe. Os dois checkpoints Pro também podem rodar uma configuração HD em 1280×768.
| Versão | Tamanho e passos | Indicado para | Velocidade em uma H100 (por segundo de vídeo) |
|---|---|---|---|
| Lite 2B distill | 2B, destilado | Rascunhos rápidos, GPUs menores | Cerca de 8,7 s |
| Lite 2B | 2B, base | Qualidade Lite sem destilação | Mais lento que o Lite distill |
| Pro 21B distill | 21B, 16 passos | Melhor equilíbrio para uso diário | Cerca de 41,5 s (33,6 s compilado) |
| Pro 21B | 21B, 50 passos | Fidelidade máxima, suporta prompts negativos | Cerca de 189 s |
| Pro distill HD | 21B, 1280×768 | Quadros maiores (qualidade não testada) | Cerca de 137 s |
Memória de GPU e velocidade: o que esperar
O Kandinsky S2V 1.0 Pro é um modelo grande, então planeje o hardware antes de baixar cerca de 65 GB de arquivos. O requisito oficial é uma única GPU com pelo menos 48 GB de memória (80 GB para HD) e driver versão 580 ou mais recente. Em uma H100, o Pro distill em resolução padrão atinge pico de cerca de 46 GiB; o HD chega a cerca de 55 GiB. Um clipe de dez segundos leva, portanto, de seis a sete minutos em uma placa, e a configuração oficial com oito GPUs reduz cada segundo de vídeo para cerca de 11 segundos.
Pouca memória? Ativar o VAE tiling reduz o pico para cerca de 28 GB ao custo de emendas sutis, a rota do Diffusers com descarregamento para CPU tem pico perto de 50 GiB, e o modelo Lite 2B distill é o jeito mais fácil de experimentar em uma placa menor. Alugar uma GPU na nuvem por uma tarde é a solução comum para placas domésticas de 24 GB, já que ainda não existem arquivos quantizados oficiais.
Três formas de testar: demo online, ComfyUI e Diffusers
Você não precisa instalar nada para ver o que o Kandinsky S2V 1.0 Pro é capaz de fazer. A equipe hospeda um Space de demonstração gratuito no Hugging Face, e há notebooks no Colab e no Kaggle para quem quer um pouco mais de controle. Quando estiver pronto para rodá-lo por conta própria, escolha a rota que combina com o seu jeito de trabalhar.
- 1Online: abra o Space Kandinsky-S2V-1.0-Demo no Hugging Face, envie um retrato e um arquivo WAV curto, adicione um prompt e gere.
- 2Linha de comando: clone o repositório kandinsky-s2v no GitHub, execute uv sync e depois uv run kandy-s2v generate com a configuração s2v_pro_distill.yaml e os seus caminhos --audio, --image e --out; adicione --prompt e --seed para orientar e repetir resultados.
- 3ComfyUI: mude para o branch dev/comfyui do repositório, que traz nós para Lite distill e Pro distill, e conecte imagem, áudio e prompt ao sampler.
- 4Diffusers: instale o diffusers a partir do branch main, carregue kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers com ModularPipeline e leia o seu áudio em 16 kHz.
Seja qual for a rota escolhida, o Kandinsky S2V 1.0 Pro recompensa bons arquivos de entrada mais do que qualquer configuração. Tenha isto em mente:
- Use uma foto nítida e frontal em que a pessoa ocupe boa parte do quadro; a proporção dela será a do vídeo.
- Grave uma fala limpa, sem música de fundo, salva como áudio mono de 16 kHz.
- Fixe o --seed quando gostar de um resultado e depois mude apenas o prompt para explorar variações.
Modelos de prompt para vídeos falantes
No Kandinsky S2V 1.0 Pro, o prompt de texto não contém o roteiro; o seu áudio contém. Use o prompt para descrever a pessoa, o movimento, o cenário e a câmera, e mantenha roupas e fundo próximos da foto de referência para que a aparência não se desvie. Estes modelos cobrem os formatos mais populares; troque os detalhes e mantenha a estrutura.
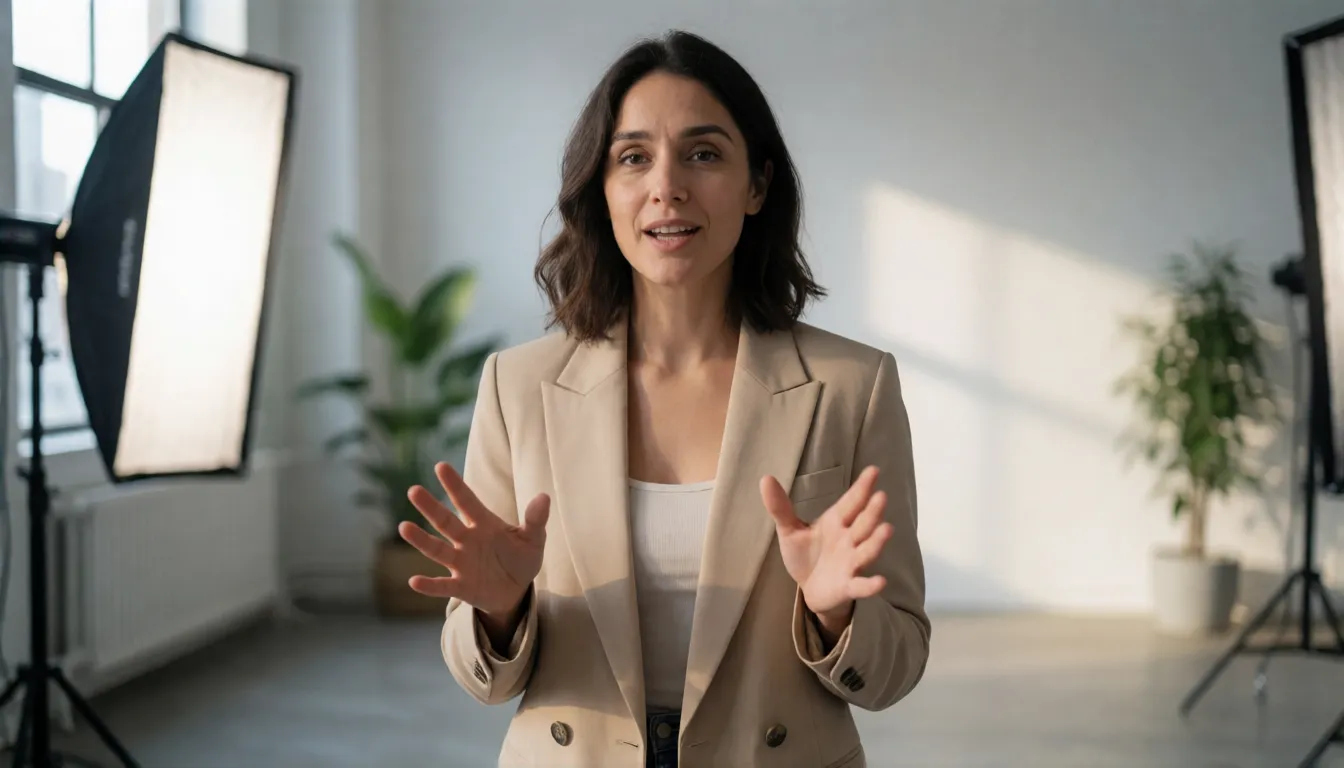
- Apresentadora: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
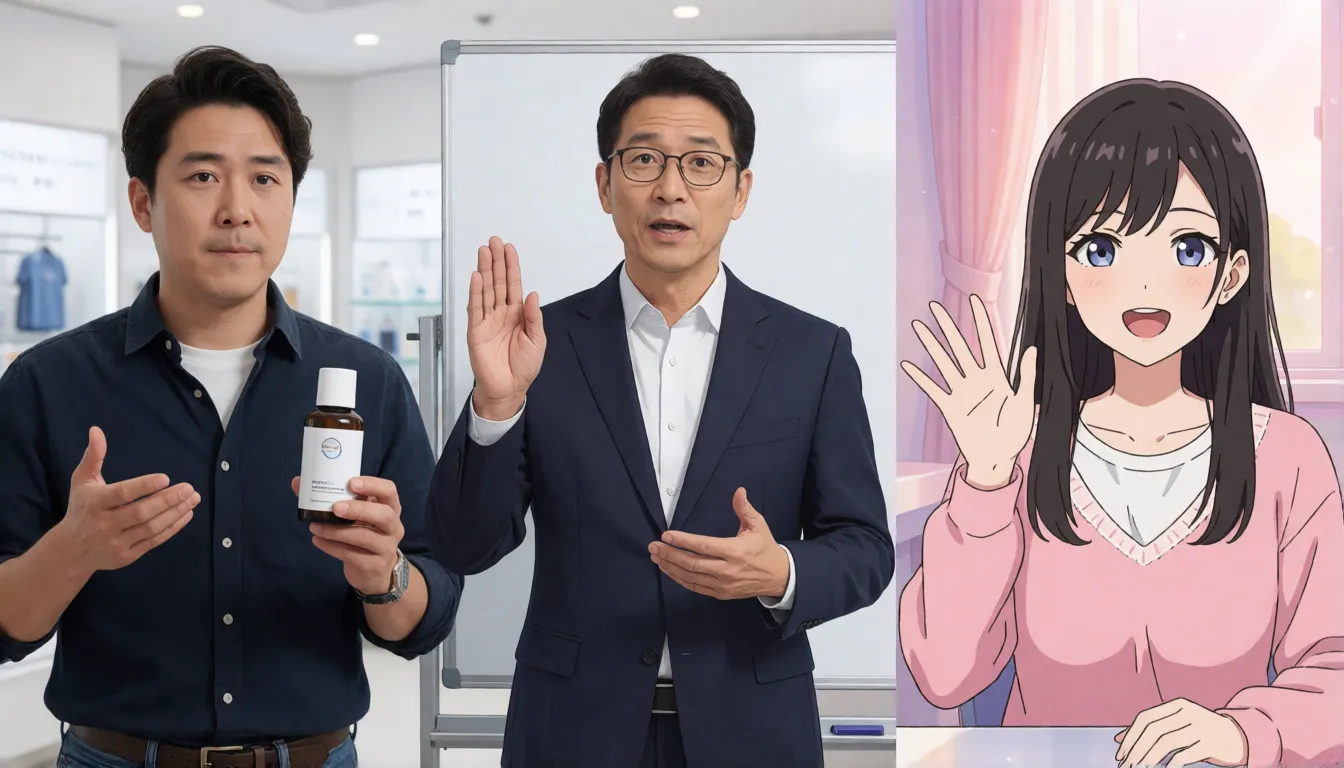
- Apresentação de produto: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- Diálogo dramático: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- Músico: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- Professor: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- Streamer virtual: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- Conversa na praia (18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- Prompt negativo (apenas modelo de 50 passos): blurry face, distorted mouth, extra fingers, flickering, static body.
Comparação com Wan 2.2 S2V, InfiniteTalk e outros avatares abertos
Os modelos abertos de avatares falantes se multiplicaram, e cada um tem um ponto forte diferente em relação ao Kandinsky S2V 1.0 Pro. O Wan2.2-S2V-14B, da Alibaba, já tem arquivos GGUF da comunidade, o que o torna mais amigável para GPUs menores. InfiniteTalk e MultiTalk focam em vídeos muito longos e conversas com várias pessoas. O LongCat-Video-Avatar 1.5 também tem builds GGUF para ComfyUI. O Kandinsky S2V 1.0 Pro se destaca pela licença MIT permissiva, pelo movimento de corpo inteiro guiado por texto e pela versão destilada de 16 passos; seus pontos fracos hoje são a alta exigência de memória e um ecossistema comunitário ainda jovem. O artigo não nomeia seus baselines, então trate comparações diretas como não verificadas e teste com os seus próprios clipes.
| Modelo | Ponto forte | Mais fácil em GPUs menores? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | Movimento de corpo inteiro, cenas controladas por texto, distill de 16 passos | Só o Lite; o Pro precisa de 48 GB |
| Wan2.2-S2V-14B | Ecossistema maduro, movimento cinematográfico | Sim, GGUF da comunidade |
| InfiniteTalk / MultiTalk | Clipes muito longos, diálogo com várias pessoas | Depende da configuração |
| LongCat-Video-Avatar 1.5 | Vídeo de avatar com suporte a ComfyUI | Sim, GGUF da comunidade |
Avatares falantes sem censura: o que dá para fazer hoje
Ainda não existe um fine-tune sem censura, oficial ou da comunidade, do Kandinsky S2V 1.0 Pro. Os pesos abertos rodam localmente sem camada de moderação online, mas os dados de treinamento são gravações de uma única pessoa falando, então cenas adultas não são o foco do modelo, e o model card pede que os usuários animem apenas pessoas que deram consentimento. Se você quer fazer uma foto falar, flertar ou posar de biquíni ou lingerie para personagens fictícios 18+ sem instalar nada, o nosso estúdio de imagem para vídeo permite enviar um retrato, descrever o movimento e gerar no navegador.
Anime o retrato de um personagem 18+ no navegador, sem precisar de GPU.
Começar imagem para vídeo →Hospedar o Kandinsky S2V 1.0 Pro por conta própria vs gerar online no Spicy AI
| Implantação local (pesos oficiais) | Spicy AI online | |
|---|---|---|
| Filtro de conteúdo | Sem filtro online quando você mesmo o executa | Conteúdo adulto (18+) permitido |
| Pesos abertos | Sim, licença MIT no Hugging Face | Não se aplica, roda online |
| Modelo realmente usado | Kandinsky S2V Lite ou Pro | Modelos de vídeo próprios do Spicy AI |
| Preço | Pesos gratuitos, você paga pela GPU | Grátis para começar, créditos para mais |
- Local: sincronia labial guiada pelo seu próprio áudio, duração ilimitada, controle total.
- Spicy AI: comece com uma foto e anime-a no navegador, sem precisar de hardware.
Perguntas frequentes
O que é o Kandinsky S2V 1.0 Pro?
O Kandinsky S2V 1.0 Pro é um modelo de fala para vídeo com 21 bilhões de parâmetros do Kandinsky Lab. Forneça uma foto de referência, uma gravação de voz e um prompt de texto, e ele gera um vídeo falante de corpo inteiro a 25 fps com sincronia labial. Os pesos são abertos sob licença MIT.
Qual é a diferença entre o Pro e o Pro distill?
Ambos têm 21B de parâmetros. A versão distill usa a destilação pi-Flow para terminar em 16 passos em vez de 50 e incorpora o guidance nos pesos, então é cerca de cinco vezes mais rápida e tem pontuação próxima à do modelo base em quase todas as métricas.
Quanta memória de GPU o Kandinsky S2V 1.0 Pro precisa?
A equipe pede uma única GPU com pelo menos 48 GB (80 GB para HD). O Pro distill atinge pico de cerca de 46 GiB em resolução padrão; o VAE tiling reduz isso para cerca de 28 GB com emendas sutis. Ainda não há versão quantizada oficial.
Qual pode ser a duração dos vídeos do Kandinsky S2V 1.0 Pro?
A mesma do seu áudio. O modelo gera blocos de cinco segundos e continua cada um a partir do anterior. Em uma H100, um segundo de vídeo em resolução padrão leva cerca de 41,5 segundos com o Pro distill.
O Kandinsky S2V 1.0 Pro também gera a voz?
Não. Você fornece a fala, seja uma gravação real ou texto para fala, e o vídeo final traz essa faixa de áudio original.
Existe demo online ou suporte a ComfyUI?
Sim. O Kandinsky Lab hospeda um Space de demonstração no Hugging Face, o branch dev/comfyui do repositório no GitHub adiciona nós de ComfyUI para Lite distill e Pro distill, e o suporte ao Diffusers está disponível a partir do branch main.
Existe um Kandinsky S2V 1.0 Pro sem censura?
Não em novembro de 2026: nenhum fine-tune sem censura, oficial ou da comunidade, foi lançado. Você pode rodar os pesos abertos por conta própria ou usar um gerador online de imagem para vídeo que permita conteúdo fictício 18+.
Fontes
- Model card do Kandinsky-S2V-1.0-Pro-distill (Hugging Face)
- Model card do Kandinsky-S2V-1.0-Pro-distill-Diffusers (Hugging Face)
- Modelo base Kandinsky-S2V-1.0-Pro (Hugging Face)
- Demo online do Kandinsky S2V 1.0 (Hugging Face Space)
- Repositório kandinskylab/kandinsky-s2v (GitHub)
- Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation (arXiv)
- Página do projeto Kandinsky Avatar
- Wan2.2-S2V-14B GGUF (Hugging Face)
Mais guias de modelos de vídeo sem censura
- Kandinsky 6.0 sem censura
- Kling sem censura
- Kling 2.6 sem censura
- Kling O1 sem censura
- Sora sem censura
- Veo sem censura
- Hailuo AI sem censura
- MiniMax H3 Max sem censura
- Wan sem censura
- Wan 3.0 sem censura
- Seedance sem censura
- Seedance 2.5 sem censura
- Seedance 2.0 sem censura
- Seedance 2.0 Mini sem censura
- HunyuanVideo sem censura
- LTX Video sem censura
- Runway sem censura
- Pika sem censura
- Luma Dream Machine sem censura
- Vidu sem censura
- PixVerse sem censura
- EdenLive sem censura
- Grok Imagine sem censura
- AI Avatars sem censura
- HappyHorse 1.0 sem censura
- MiniMax H3 FL2VA Ref2VA sem censura
- Kling 4.0 sem censura
- Kling 3.0 sem censura
- MiniMax H3 RefMods sem censura
- Looking Ahead sem censura
- TaoMate-H3 sem censura
- SANA-Video 2.0 sem censura
- MiniMax H3 Remix sem censura
- Sora 2 sem censura
- Wan 2.6 sem censura
- LTX-2.5 Slow Motion sem censura
- VDN MiniMax H3 sem censura
O Spicy AI é um site independente e não tem afiliação com o Kandinsky Lab nem com a Sber. Todo o conteúdo deve envolver apenas adultos (18+); não anime pessoas reais sem o consentimento delas.