LoRA aberto · áudio + vídeo em streaming
TaoMate-H3 sem censura: vídeo com IA que começa a tocar enquanto ainda está sendo feito
Esperar três minutos por um clipe de dez segundos acaba com a graça do vídeo com IA. O TaoMate-H3 muda esse ritmo: em vez de renderizar o clipe inteiro e só depois mostrá-lo, ele constrói imagem e som em pequenos blocos e entrega a primeira parte reproduzível depois de cerca de 17 segundos. Lançado como um LoRA aberto pela equipe Alibaba TaoLive AIGC, a mesma por trás das ferramentas de IA para lives do Taobao, ele roda sobre o modelo de pesos abertos MiniMax H3 e continua gerando enquanto você continuar enviando prompts. Isso o torna ideal para apresentadores falando, demos de produto e histórias em episódios. Veja o que ele faz, onde se destaca, como escrever prompts e o que é preciso para rodá-lo.
- LoRA de 3 passos
- Toca enquanto renderiza
- 480p · 768p · 1080p
- Pesos abertos
TaoMate-H3 vs MiniMax H3: de três minutos para dezessete segundos
O destaque é a velocidade. O MiniMax H3 é um ótimo modelo aberto de áudio e vídeo, mas, como a maioria dos geradores de vídeo, termina o clipe inteiro antes que você possa assistir a um único quadro. O TaoMate-H3 adiciona um LoRA treinado para remover o ruído de cada bloco em apenas três passos e depois transmite os blocos em ordem. No teste da própria equipe com oito placas NVIDIA H20, um clipe de dez segundos em 480×864 ficou assistível em 17,3 segundos em vez de 183,3 segundos, e o trabalho principal de difusão caiu de quase 170 segundos para menos de 15.
O uso de memória quase não mudou, então o ganho de velocidade não vem de uma máquina maior. O que a equipe não publicou é uma comparação lado a lado de qualidade de imagem ou amplitude de movimento, então trate a qualidade da imagem como algo a julgar com seus próprios olhos, e não como uma vitória comprovada.
| Teste da equipe (8×H20, 480×864, 10 s) | MiniMax H3 | Com o LoRA | Ganho |
|---|---|---|---|
| Primeiro vídeo reproduzível | 183,3 s | 17,3 s | 10,6× mais rápido |
| Primeiro bloco concluído | 170,1 s | 6,1 s | 27,7× mais rápido |
| Tempo de difusão (DiT) | 169,6 s | 14,8 s | 11,45× mais rápido |
| Pico de memória do DiT | 32,03 GiB | 31,37 GiB | Praticamente igual |
Três passos por bloco: geração de áudio e vídeo em streaming explicada de forma simples
Imagine uma impressora que entrega cada página assim que fica pronta, em vez de esperar o relatório inteiro. O modelo corta o vídeo e sua trilha sonora em fatias curtas e cria cada fatia em três passagens de remoção de ruído. Cada fatia concluída é gravada em um cache de memória, e a próxima é gerada sobre ela, de modo que a história pode continuar sem um fim fixo. Para um clipe de dez segundos, as notas da equipe contam 24 passagens de geração e 8 atualizações de cache.
Manter um rosto e uma voz estáveis em uma tomada longa é a parte difícil. O artigo científico por trás do projeto introduz a memória guiada por âncora: um estado de referência que fixa a aparência e a voz do personagem, reduzindo a deriva de cor e a oscilação de identidade com o passar dos minutos. Imagem e som são produzidos juntos, então lábios, fala e ambiência ficam sincronizados em vez de serem colados depois.
Os benchmarks do artigo impressionam: 35 quadros por segundo em três GPUs, contra 23 do LiveAvatar em cinco e 16 do LongLive-2.0 em quatro, além da melhor pontuação de sincronia labial. Lembre-se de que esses números foram medidos em um gerador de 22 bilhões de parâmetros inicializado a partir do LTX-2.3, e não na versão H3, então mostram o potencial do método, e não os resultados exatos deste modelo. Entre as opções de código aberto para vídeo com IA em tempo real, é uma das poucas que transmite som e imagem juntos.
Apresentadores humanos digitais, demos de produto estilo live e dramas curtos
Como vem da equipe de lives do Taobao, o palco óbvio é o apresentador falando. A demo oficial de primeiro e último quadro é um clipe de 30 segundos de uma apresentadora sentada em uma sala de estar explicando como organizar objetos, exatamente o tipo de segmento que as lives de compras exibem o dia todo. O projeto nunca promete um produto completo de comércio ao vivo, mas os ingredientes estão lá: um rosto estável, uma voz natural e resultados que chegam rápido o bastante para manter um cronograma de produção andando.
Apresentadores e vídeos explicativos
Um apresentador, um cômodo, um roteiro dividido em trechos curtos. Ideal para tutoriais, dicas para a casa e introduções de canal que precisam de um rosto simpático na câmera.
Demos de produto e rascunhos de anúncio
Crie várias versões de um pitch de 15 segundos, troque a fala ou o ângulo do produto e compare lado a lado antes de agendar uma gravação de verdade.
Dramas curtos em episódios
Encadeie trechos de cinco segundos em uma cena contínua. Chuva, neon, uma fala sussurrada e uma revelação, tudo mantendo o mesmo ator de um trecho para o outro.
Vídeo social pensado para o vertical
Os formatos retrato nativos 768×1376 e 1088×1920 entram direto nos feeds de vídeos curtos sem cortes. O artigo também testou fala em mandarim e em inglês.
Construindo um vídeo com IA de um minuto, cinco segundos por vez
O vídeo longo com IA é onde o streaming realmente compensa. A duração é definida em blocos de cinco segundos, e você pode reutilizar um único prompt durante toda a geração ou passar uma lista JSON com um prompt e, opcionalmente, uma seed por bloco de cinco segundos. Pense nisso como um storyboard: o bloco um apresenta a apresentadora, o bloco dois mostra o produto, o bloco três é o close-up, e o modelo mantém a mesma pessoa e o mesmo cômodo em cada mudança. Os exemplos oficiais duram 30 segundos, e o artigo testa um minuto inteiro de 1.441 quadros.
A saída vem em três tamanhos: 480p para rascunhos rápidos, 768p como padrão e 1080p para entrega, cada um em paisagem ou retrato. A variante de primeiro e último quadro roda a 24 fps fixos em retrato 768×1376, útil quando cada tomada precisa começar e terminar em uma pose exata.
Modelos de prompt para apresentadores e cenas em série
O segredo para tomadas longas consistentes é a repetição. Repita a aparência, a roupa e o cenário da pessoa em cada bloco, dê a cada bloco apenas uma ação principal, coloque as falas entre aspas e descreva o som separadamente. Estes modelos seguem esse padrão e servem como primeiro rascunho para seus próprios roteiros.
Apresentadora · bloco 1
Plano médio, uma jovem de suéter creme sentada em um sofá em uma sala de estar iluminada, falando para a câmera, explicando como dobrar toalhas para guardá-las em uma caixa organizadora, gestos naturais, luz do dia quente, câmera estável. Áudio: voz feminina clara, ambiência suave do cômodo.
Apresentadora · bloco 2 (continuação)
A mesma mulher, o mesmo suéter creme, a mesma sala de estar. Ela levanta a caixa em direção à câmera e sorri: "Nesta cabem três toalhas." A câmera se aproxima lentamente. Áudio: a mesma voz, leve farfalhar de tecido.
Trecho de drama curto
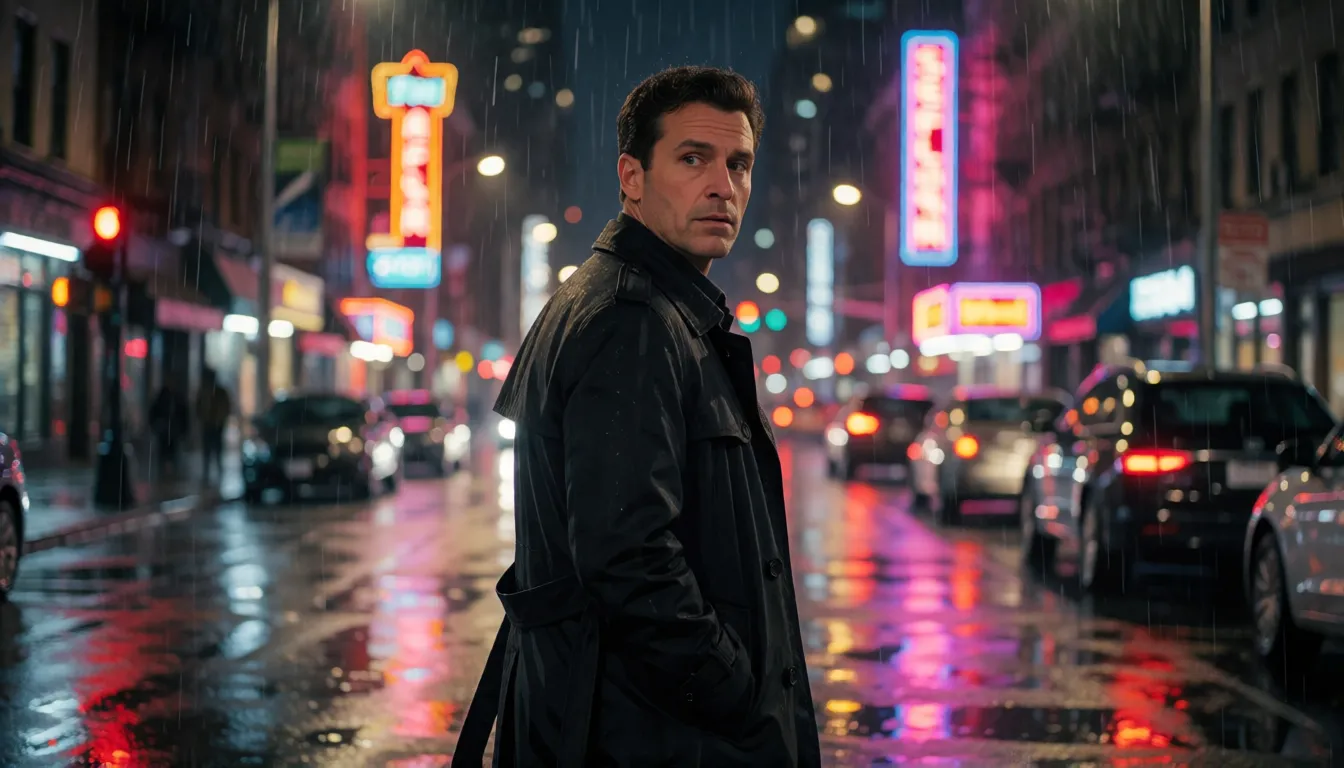
Rua à noite na chuva, um homem de sobretudo preto se vira, close-up, ele diz em voz baixa: "Você veio, afinal." Reflexos de neon no asfalto molhado. Áudio: chuva constante, trovão distante.
Comercial de moda praia adulto (18+, modelo fictícia)
Uma modelo de moda adulta, com quase trinta anos, de biquíni vermelho, caminha por uma praia ensolarada e fala para a câmera sobre a moda praia deste verão, sorriso descontraído, travelling. Áudio: a voz dela, ondas, brisa suave.
TaoMate-H3-FL2VA e TaoMate-HD: a família que cresce
O projeto avança rápido. O primeiro lançamento, em setembro de 2026, trouxe streaming de texto para áudio e vídeo ao H3. Em 15 de outubro de 2026, a equipe adicionou o TaoMate-H3-FL2VA, que recebe um primeiro e um último quadro e transmite o clipe entre eles, descrito pela equipe como, até onde sabem, o primeiro modelo de áudio e vídeo de primeiro e último quadro em tempo real. Essa é a versão indicada quando um storyboard define como cada tomada começa e termina.
Em 3 de novembro de 2026 veio o TaoMate-HD, que se baseia no runtime do H3 com geração progressiva voltada a resultados mais nítidos; a página do projeto traz os detalhes. A geração baseada em referência (Ref2AV) aparece como prevista para depois, ainda sem data.
Rodando o TaoMate-H3 a partir do Hugging Face e do GitHub
O LoRA em si é pequeno, apenas um config, um adapter config e um arquivo safetensors (rank 128), publicado no Hugging Face com um espelho no ModelScope. A configuração está no repositório do GitHub. O problema é o hardware: a única configuração verificada usa oito placas NVIDIA H20 de 96 GB, e os scripts aceitam quatro ou oito GPUs da classe Hopper.
- 1Prepare um Linux com Python 3.10 ou 3.11, CUDA 12.8, PyTorch 2.8, vLLM 0.11.1, FlashAttention para Hopper e FFmpeg.
- 2Baixe o modelo base MiniMax H3 (model_index.json e suas pastas) e o LoRA TaoMate do Hugging Face.
- 3Escolha um tamanho (480p, 768p ou 1080p) e defina --duration como múltiplo de 5 segundos.
- 4Passe um --prompt para o clipe inteiro, ou --prompt-json com um prompt e uma seed opcional por bloco de cinco segundos.
- 5Rode com --gpus 4 ou 8 e veja os primeiros blocos tocarem enquanto o resto ainda está sendo gerado.
- Requisitos de GPU: nenhuma VRAM mínima foi publicada e não há caminho oficial para placas RTX 4090 ou 5090.
- ComfyUI: ainda não existem nós oficiais, então a linha de comando é o caminho suportado.
- Demo online: dois Spaces da comunidade no Hugging Face permitem testar o modelo de 3 passos no navegador, e a página do modelo lista um provedor de inferência hospedado.
Por que os criadores estão de olho neste lançamento
A geração aberta de áudio e vídeo em tempo real é rara, e é isso que tem chamado a atenção. Em cerca de dois meses, o repositório no GitHub passou de 800 estrelas, a página no Hugging Face reuniu mais de 130 curtidas e a comunidade criou dois Spaces públicos de demonstração. O entusiasmo gira em torno de ver um clipe começar quase instantaneamente e de tomadas longas que mantêm o mesmo rosto. O principal obstáculo para a maioria das pessoas está claro nos requisitos: uma configuração multi-GPU de data center, ainda sem caminho oficial para placas de consumo ou ComfyUI.
TaoMate-H3 sem censura: o que pesos abertos significam para criadores adultos
Não existe uma edição sem censura separada do TaoMate-H3, e nenhuma é necessária no sentido usual: tanto o LoRA quanto a base H3 têm pesos abertos, as páginas da equipe não descrevem nenhum filtro de conteúdo ou classificador de segurança, e uma execução local nunca passa por um serviço de moderação na nuvem. Para criadores adultos, isso significa que as regras são definidas pela própria licença do modelo e pela sua configuração. Se você não tem uma máquina com oito GPUs, o Spicy AI oferece online uma ferramenta semelhante de imagem para vídeo com filtros mais flexíveis, para personagens adultos e fictícios.
Envie uma imagem do seu personagem adulto original e dê vida a ele com som, sem precisar de GPU.
Abrir imagem para vídeoGerador de vídeo alternativo sem censura
Comece com uma foto de um personagem adulto original, descreva o movimento e a fala que ele deve dizer e receba um clipe curto falado no seu navegador.
Começar a gerarHospedar o TaoMate-H3 por conta própria vs gerar online no Spicy AI
Rodar por conta própria oferece streaming em tempo real e controle total; o caminho online troca isso por zero configuração.
| Implantação local (pesos da equipe) | Spicy AI online | |
|---|---|---|
| Filtros de conteúdo | Você define sua própria configuração | Filtros flexíveis para conteúdo adulto (18+) |
| Pesos abertos | Sim (LoRA + base H3) | Não é necessário, roda no navegador |
| Modelo realmente usado | LoRA TaoMate sobre o MiniMax H3 | Um modelo hospedado de imagem para vídeo |
| Custo para começar | De quatro a oito GPUs Hopper | Plano gratuito disponível |
Perguntas frequentes
O que é o TaoMate-H3?
Um LoRA de 3 passos e um runtime de streaming construídos sobre o MiniMax H3 pela equipe TaoLive AIGC da Alibaba. Ele gera áudio e vídeo juntos em blocos, então a reprodução começa enquanto o resto ainda está renderizando.
Quanto ele é mais rápido que o MiniMax H3?
No teste da equipe com oito GPUs H20 em 480×864 por 10 segundos, o primeiro vídeo reproduzível chegou após 17,3 segundos contra 183,3 segundos, e o tempo de difusão foi 11,45 vezes menor.
Ele roda em uma RTX 4090 ou 5090?
Não oficialmente. Apenas GPUs Hopper são suportadas, a configuração verificada usa oito placas H20 de 96 GB, é possível usar quatro ou oito GPUs, e nenhuma VRAM mínima foi publicada.
Ele suporta vídeo de primeiro e último quadro?
O lançamento principal é de texto para áudio e vídeo. O streaming de primeiro e último quadro vem do TaoMate-H3-FL2VA, lançado em 15 de outubro de 2026. A geração baseada em referência ainda não foi lançada.
Qual pode ser a duração dos vídeos?
A duração cresce em passos de cinco segundos e pode continuar. As amostras oficiais duram 30 segundos, e o artigo avalia clipes de um minuto com 1.441 quadros.
Existe um nó para ComfyUI?
Por enquanto, não da equipe. A forma suportada de rodá-lo são os scripts de linha de comando no repositório do GitHub.
Existe uma versão sem censura?
Não existe uma versão dedicada. Os pesos são abertos e as páginas da equipe não descrevem nenhum filtro embutido, então uma execução local é regida pela licença comunitária do H3, e não por moderação na nuvem.
Fontes
- Ficha do modelo TaoMate-H3 (Hugging Face)
- Repositório, benchmarks e novidades do TaoMate-H3 (GitHub)
- Artigo do TaoMate no arXiv (2607.24359)
- Ficha do modelo TaoMate-H3-FL2VA (Hugging Face)
- Página do projeto TaoMate-HD
- Modelo base MiniMax H3 (Hugging Face)
- Space de demo de 3 passos da comunidade (Hugging Face)