音声駆動アバター · オープンウェイト
無修正 LongCat-Video-Avatar 1.6:写真1枚と音声ひとつで、10分間しゃべる動画
ポートレートと録音した音声を渡すだけで、LongCat-Video-Avatar 1.6 はその人物が話している動画を返してくれます。唇は一音一音にぴたりと合い、表情は声のトーンに反応し、頭や肩は人が実際に話すときと同じように動きます。2026年11月15日に美団(Meituan)LongCatチームが公開した今回のアップデートの主眼は、長時間でも自然さを保つこと。チームによれば、同じ顔とシャープな画質を保ったまま10分を超えるクリップを生成できたといいます。以下では、変更点、クリエイターの活用シーン、2人の対話のコツ、すぐ使えるプロンプト、そして最も手軽な試し方を紹介します。
- 写真+音声 → 動画
- 10分以上の長回し
- 自然なリップシンク
- 2人の対話
無修正の代替動画ジェネレーター
画像から動画ポートレート1枚から始めて、キャラクターの話し方、笑い方、動き方を記述すると、すべて入力済みの状態で画像から動画スタジオが開きます。登場人物が全員18歳以上で、架空の人物または同意を得た人物であれば、アダルトなテーマも歓迎です。
崩れない10分間のトーキング動画
AIのトーキングヘッドを試したことがある人なら、おなじみの問題を知っているはずです。最初の数秒はきれいでも、やがて顔が徐々に崩れ、口元がちらつき始め、元の写真の人物に見えなくなってしまう。LongCat-Video-Avatar 1.6 はまさにそれを解決するために作られました。モデルは動画を少しずつ延長していき、チームは長いロールアウトで学習させることで小さな誤差が積み重ならないようにしました。その主張はシンプルかつ大胆です。同一人物のまま、安定した画質と滑らかな動きで10分以上の映像を生成できる、というものです。
クリエイターにとっては、これでワークフローが変わります。1回分の講義、長い製品紹介、ポッドキャストの1エピソード、オーディオブックの1章などを、編集ソフトで15秒のクリップをつなぎ合わせる代わりに、ひと続きの長回しにできます。シリーズ全体で同じキャラクターを使い続けることも可能です。毎週新しい音声を入れれば同じ顔が話し続けるので、バーチャルホストやストーリー系チャンネルにとって最も必要な機能といえます。
- 音声+写真:既存のポートレートを動かす、最も人気のモード。
- 音声+テキスト:写真がまだない?人物を記述すれば、モデルが人物像を作り出します。
- 続きの生成:既存のクリップに続きの音声を加えて、見た目を保ったまま延長します。
- 複数人:話者ごとに個別の音声トラックを与えて会話シーンを作ります。
LongCat Avatar 1.6 と 1.5 の比較:落ち着いた口元、安定した顔
バージョン1.5は2026年5月に登場し、すでにオープンソースファンのお気に入りでした。新リリースは同じベースと同じWhisper-Large音声エンコーダーを引き継いでいるため、改善は新しいアーキテクチャではなく学習によるものです。画面上で実際にわかる違いは、一語一語を大げさに発音しなくなった口元、不自然に赤くない唇、口周りのちらつきの減少、そして頭や体と連動して動く表情です。有効票33,051票によるチーム独自のブラインドテストでは、1.6は6つのシステム中2位となり、クローズドなOmniHuman-2.0にのみ及ばず、1.5、HeyGen、OmniHuman-1.5、Kling Avatar 2.0を上回りました。ただしこの順位は開発元自身による評価であり、独立したベンチマークではありません。
| バージョン1.5 | バージョン1.6 | |
|---|---|---|
| リリース日 | 2026年5月21日 | 2026年11月15日 |
| 口の動き | ときに誇張気味、唇が赤みがかる | より柔らかく自然、ちらつきが少ない |
| 長尺動画 | 時間とともにドリフトが蓄積 | 10分超でも人物が安定(チームの主張) |
| 速度 | 8ステップの蒸留サンプリング | 8ステップ:最初はDMD+OPSDの混合、その後はOPSDのみ |
| 人間による選好(Elo) | 低め | 1068.1、6システム中2位 |
モデルをMac向けに変換したコミュニティのテスターによると、SyncNetのリップシンクスコアは1.6が約6.8〜7.4、1.5が約6.5(実写映像:7.05)でした。非公式の数値です。
写真からトーキング動画へ:クリエイターの活用シーン
音声駆動のトーキングヘッドは、かつてはデモ用のおもちゃでした。長回しが可能になり顔も自然になったことで、プレゼンターを雇ったりスタジオを借りたり自分で撮影したりせずに、台本を話す人物を画面に登場させたい人にとって実用的なツールになりました。ポートレートに録音音声や音声合成(TTS)のトラックを組み合わせれば、数分でプレゼンター、講師、ナレーター、架空のキャラクターが完成します。以下は、ショート動画クリエイター、教育者、キャラクター制作者がまず試しているシーンです。
- ショートドラマやAIコミック:TTSの台本から、キャラクターごとのセリフショットを一括生成。
- 商品・ショップ動画:親しみやすいホストが、自然でおしゃべりな口調で商品を説明したりお店を紹介したり。
- 講座や解説動画:身振りやうなずきを続ける10分間の講師、または他言語の吹き替え版(品質は言語により異なる場合があります)。
- バーチャルホストやAIコンパニオン:ファンやチャットのメッセージに動画で返信するキャラクター。
- しゃべる古い写真や絵画:家族写真やアート作品に声を与えて、印象に残る投稿に。
- 歌やリップシンクで遊ぶ:音声に追従するので音楽クリップも試す価値あり。ただし公式にはテストされていません。
長い講義やトーク
ナレーション全体を、数十本の短いクリップではなく、ひと続きのプレゼンター動画にします。
ドラマの対話
2人のキャラクターにそれぞれの音声トラックを与え、自然なリアクションのあるやり取りのシーンを作ります。
バーチャルホスト
シリーズのエピソード、商品動画、ファンへの返信を通して、ひとつの顔を使い続けられます。
2人の会話、インタビュー、デュエット
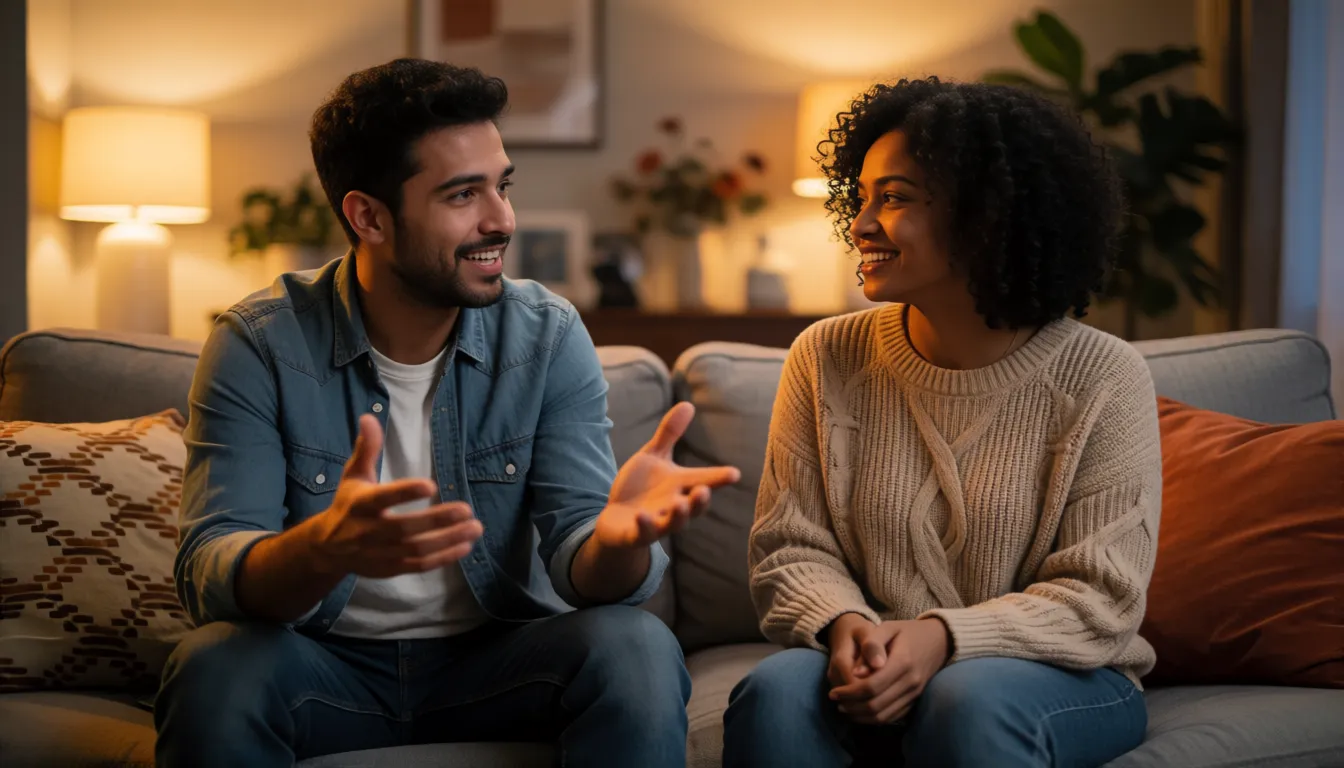
LongCat-Video-Avatar 1.6 で特に楽しいモードのひとつが、複数人動画です。2人が写った画像とそれぞれ別の音声トラックをモデルに与えると、話している人物を動かしつつ、もう一方は聞き手として反応します。これにより、かつては俳優2人が必要だったフォーマットが可能になります。ポッドキャスト風のインタビュー、ショートドラマでのカップルの口論、お笑いコンビ、先生と生徒のロールプレイ、ゲストと談笑するホストなどです。長尺動画の安定性もそのまま活きるので、こうした対話は1往復だけでなく数分間続けられます。
コツはシーンをシンプルにすること。2人が向かい合うか横並びに座り、両方の顔がはっきり見え、どちらが先に話すかをプロンプトで指定します。そのうえで2人の声を別々に録音または生成し、セリフの間に短い間を入れて、自然なやり取りになるように並べましょう。
自然なトーキング動画のためのプロンプトテンプレート
LongCat-Video-Avatar 1.6 でプロンプトを書くときに覚えておくべき重要なポイントはこれです。人物が何を話すかは音声が決め、ショットの見た目はテキストプロンプトが決めます。カメラの距離、雰囲気、身振り、照明を記述し、セリフそのものは決して書かないでください。長尺動画では、キャラクターがぶれないよう、すべてのセグメントで人物の記述を同じにしましょう。以下のテンプレートは人気のフォーマットをカバーしています。細部を入れ替えて、構成はそのまま使ってください。
- プレゼンター:明るいスタジオにいる若い女性、ミディアムショット、カメラに向かって温かく話す、自然な手振り、柔らかな日差し、固定カメラ。
- 商品トーク:カフェのカウンターでコーヒーカップを持つ男性、笑顔、生き生きとした表情で商品を説明、浅い被写界深度。
- 講義:ホワイトボードの前に立つ教授、落ち着いた口調、ときおりうなずいたり指さしたりする、三脚での固定ショット。
- 対話:ソファに向かい合って座る2人の友人、左の人物が先に話し、続いて右の人物が答える、カジュアルなリビングの照明。
- 歌手:小さなステージに立つ歌手、表情豊か、リズムに合わせて軽く揺れる、温かいスポットライト。
- 色っぽいモノローグ(18+):夕暮れのビーチにいるビキニ姿の成人の架空女性、色っぽい笑顔、カメラに向かって優しく語りかける、髪をなびかせるそよ風。
Hugging Faceからのダウンロード、ComfyUI、INT8、GGUF、Mac MLX
自分で動かしたい人のために、ウェイトはHugging FaceとModelScopeから無料でダウンロードでき、コードはLongCat-VideoのGitHubリポジトリにあります。チームは公式の必要メモリ量を公開していませんが、軽量な環境向けにウェイトのみのINT8オプションを提供しています。コミュニティの動きも速く、ComfyUIパッケージ(Comfy-Org製のものを含む)、1.6のComfyUIビルド、INT8変換版、そしてVRAMの少ないGPU向けに1.5系のGGUFファイルが揃っています。
Mac向けにはApple MLX変換版もあります。作者によると、メモリ64 GBのM5 Maxで480pの3.7秒セグメント1つあたり約8分かかり、ピーク時のメモリ使用量は約47 GBに達するため、10分の動画は一晩がかりの作業になります。そのため多くのクリエイターは、ちょっとしたアイデアにはブラウザツールを使い、ローカル実行は最終的な長回しのために取っておいています。
2026年のオープンソース・トーキングアバターモデル:HeyGenやOmniHumanの代替になる?
HeyGen、OmniHuman、Kling Avatarといったサブスクリプション型のアバターサービスは洗練されていますが、クリップの長さに上限があり、分単位で課金され、アップロード内容も審査されます。美団のモデルは、多くの人が待ち望んでいたオープンな代替手段です。MITライセンスの無料ウェイト、10分を超える長回し、そして開発元のテストではHeyGenやKling Avatar 2.0を上回る人間による選好スコア。その他のオープンな選択肢としては、テキストで制御するプロンプトから全身を動かすKandinsky S2Vや、複数人シーン向けのMultiTalkがあります。ただし、どのオープンモデルにも共通する難点はハードウェアです。長尺動画には強力なGPUか、相当な忍耐が必要です。
Spicy AIで18+のトーキングキャラクター動画を作る
公式リリースのモデルカードには組み込みのコンテンツフィルターについての記載がなく、コミュニティによる無修正ファインチューンもまだ存在しません。現在は、自作の成人キャラクターのアートを使ってローカルで実行するのが一般的な使い方です。ブラウザでもっと手軽に試したいなら、Spicy AIの画像から動画スタジオで、18歳以上の架空キャラクターのポートレートを動かせます。遊び心のあるビキニのモノローグから、ささやくようなASMR風のあいさつ、バーチャル彼女の返信まで自由自在です。
- 1成人の架空キャラクターのポートレートを作成またはアップロードします。まずは画像エディターで水着やランジェリーのルックを作ってみましょう。
- 2話し方や動き方を記述します:笑顔、カメラへの身の乗り出し、ウインク、柔らかな照明など。
- 3クリップを生成し、編集時に自分のボイスオーバーやTTSトラックを加えます。
最もきれいな仕上がりにするために、以下の入力のコツを押さえておきましょう:
- 顔が明るく照らされ、手や髪で隠れていない、シャープな正面向きのポートレートを使いましょう。
- BGMのないクリアな音声を使いましょう。公式の1.5ガイドでは、ローカル実行時の音声CFGを3〜5にすることを推奨しています。
- 長尺動画の一貫性を保つため、キャラクターの記述はすべてのセグメントで同一にしましょう。
18+キャラクターのポートレートをブラウザで動かそう。GPUは不要です。
画像から動画を始める →
LongCat Avatar 1.6 のセルフホスト vs Spicy AIでのオンライン生成
| ローカル実行(公式ウェイト) | Spicy AI オンライン | |
|---|---|---|
| コンテンツフィルター | 自分で実行する場合はオンラインフィルターなし | アダルト(18+)コンテンツ可 |
| オープンウェイト | あり、Hugging FaceでMITライセンス | 該当なし、オンラインで実行 |
| 実際に使われるモデル | LongCat Avatar 1.6(avatar-v1.6) | Spicy AI独自の動画モデル |
| 料金 | ウェイトは無料、GPU代は自己負担 | 無料で開始、追加はクレジット制 |
- ローカル:自分の音声によるリップシンク、10分を超える長回し、完全なコントロール。
- Spicy AI:ブラウザでポートレートを動かせる、ハードウェアもセットアップも不要。
よくある質問
このモデルは何ですか?
2026年11月15日に美団(Meituan)LongCatチームが公開した、オープンウェイトのトーキングアバター動画モデルです。ポートレート(またはテキストによる記述)と音声からトーキング動画を生成し、1人、複数人、長尺の続き生成の各モードに対応しています。
1.6は1.5と比べて何が良くなりましたか?
リップシンクがより正確になり、表情と頭や体の動きの連動性が高まり、誇張された口の形や赤すぎる唇が抑えられ、長尺動画での誤差の蓄積も減りました。チームによれば10分を超える生成が可能で、推論もエンドツーエンドで高速化しています。
動画はどれくらいの長さにできますか?
チームは、品質と人物の同一性を保ったまま10分以上生成できたと報告しています。動画をセグメントごとに延長する仕組みで、たとえばコミュニティのMac版では1セグメントあたり93フレーム(約3.7秒)を生成します。
ローカルで実行するにはどんなハードウェアが必要ですか?
公式の必要メモリ量は公開されていません。ウェイトのみのINT8オプションがあり、HopperのGPUではFlashAttention 3が推奨されています。コミュニティのMLX版は64 GBのM5 Maxでピーク時約47 GBを使用しました。一般的なユーザーにはオンラインツールのほうが手軽でしょう。
ComfyUIで使えますか?
GitHubリポジトリには公式のComfyUIノードは記載されていませんが、Hugging FaceにはComfy-Orgのパッケージ、コミュニティによる1.6のComfyUIビルド、1.5系のGGUFファイルが公開されています。
無修正版はありますか?
2026年11月20日時点で、コミュニティによる無修正ファインチューンは登場していません。ウェイトはローカルで実行でき、モデルカードにはコンテンツフィルターの記載がありません。アダルトな作品には、18歳以上の架空の人物または同意を得た人物のみを使用してください。
HeyGenやOmniHumanと比べてどうですか?
チーム独自の人間による評価では6システム中2位となり、OmniHuman-2.0には及ばないものの、HeyGenやKling Avatar 2.0を上回りました。主な強みは、オープンウェイトであることと非常に長い長回しが可能なことです。
出典
- LongCat-Video-Avatar-1.6 モデルカード(Hugging Face)
- meituan-longcat/LongCat-Video リポジトリ(GitHub)
- LongCat-Video-Avatar 1.6 プロジェクトページ
- LongCat-Video-Avatar 1.6 テクニカルレポート(PDF)
- LongCat-Video テクニカルレポート(arXiv 2510.22200)
- LongCat-Video-Avatar-1.5 モデルカード(Hugging Face)
- ModelScope上の LongCat-Video-Avatar 1.6
- Comfy-Org LongCat-Video-Avatar パッケージ(Hugging Face)
- コミュニティによるMac向けMLX bf16変換版(Hugging Face)
その他の無修正動画モデルガイド
- 無修正 Kandinsky S2V 1.0 Pro
- 無修正 Kling
- 無修正 Kling 2.6
- 無修正 Kling O1
- 無修正 Sora
- 無修正 Veo
- 無修正 Hailuo AI
- 無修正 MiniMax H3 Max
- 無修正 Wan
- 無修正 Wan 3.0
- 無修正 Seedance
- 無修正 Seedance 2.5
- 無修正 Seedance 2.0
- 無修正 Seedance 2.0 Mini
- 無修正 HunyuanVideo
- 無修正 LTX Video
- 無修正 Runway
- 無修正 Pika
- 無修正 Luma Dream Machine
- 無修正 Vidu
- 無修正 PixVerse
- 無修正 EdenLive
- 無修正 UniAVC
- 無修正 Grok Imagine
- 無修正 AI Avatars
- 無修正 HappyHorse 1.0
- 無修正 MiniMax H3 FL2VA Ref2VA
- 無修正 Kling 4.0
- 無修正 Kling 3.0
- 無修正 MiniMax H3 RefMods
- 無修正 Kandinsky 6.0
- 無修正 Looking Ahead
- 無修正 TaoMate-H3
- 無修正 SANA-Video 2.0
- 無修正 MiniMax H3 Remix
- 無修正 Sora 2
- 無修正 Wan 2.6
- 無修正 LTX-2.5 Slow Motion
- 無修正 LTX-2.5 Cinemagraph
- 無修正 VDN MiniMax H3
- 無修正 Hy-Nomas
- 無修正 Seedance 1.5 Pro
- 無修正 Pika H3 Flex
- 無修正 Veo 3.1
- 無修正 MiniMax H3 x Z-Image
- 無修正 Origami-H3
- 無修正 Wan 2.6 Flash
Spicy AIは独立したサイトであり、美団(Meituan)およびLongCatチームとは提携していません。すべてのコンテンツは成人(18歳以上)のみを対象とし、本人の同意なく実在の人物を動画化しないでください。