MiniMax H3 · コミュニティ製リファレンスアダプター
MiniMax H3 RefMods:学習不要で、どのショットでも同じ主役を
AI動画クリエイターなら誰もが知る悩みがあります。1ショット目では完璧だったヒロインの顔が、3ショット目にはズレてしまうのです。MiniMax H3 RefMods は、LoRA文化から借りた工夫でこの問題を解決します。数枚の写真、短いクリップ、または音声サンプルをComfyUIに一度読み込ませるだけで、キャラクターを記憶したわずか約1〜1.6 MBの小さなファイルが完成。どのMiniMax H3動画ワークフローに組み込んでも、同じ顔、衣装、画風をいつでも呼び出せます。モデルの学習は一切不要です。以下では、できること、クリエイターの活用例、ステップごとのセットアップ、プロンプトテンプレート、そしてまだ苦手なことの正直なリストを紹介します。
- 学習不要
- 約1〜1.6 MBのファイル
- 最大8スロット
- ComfyUI + Fizgig
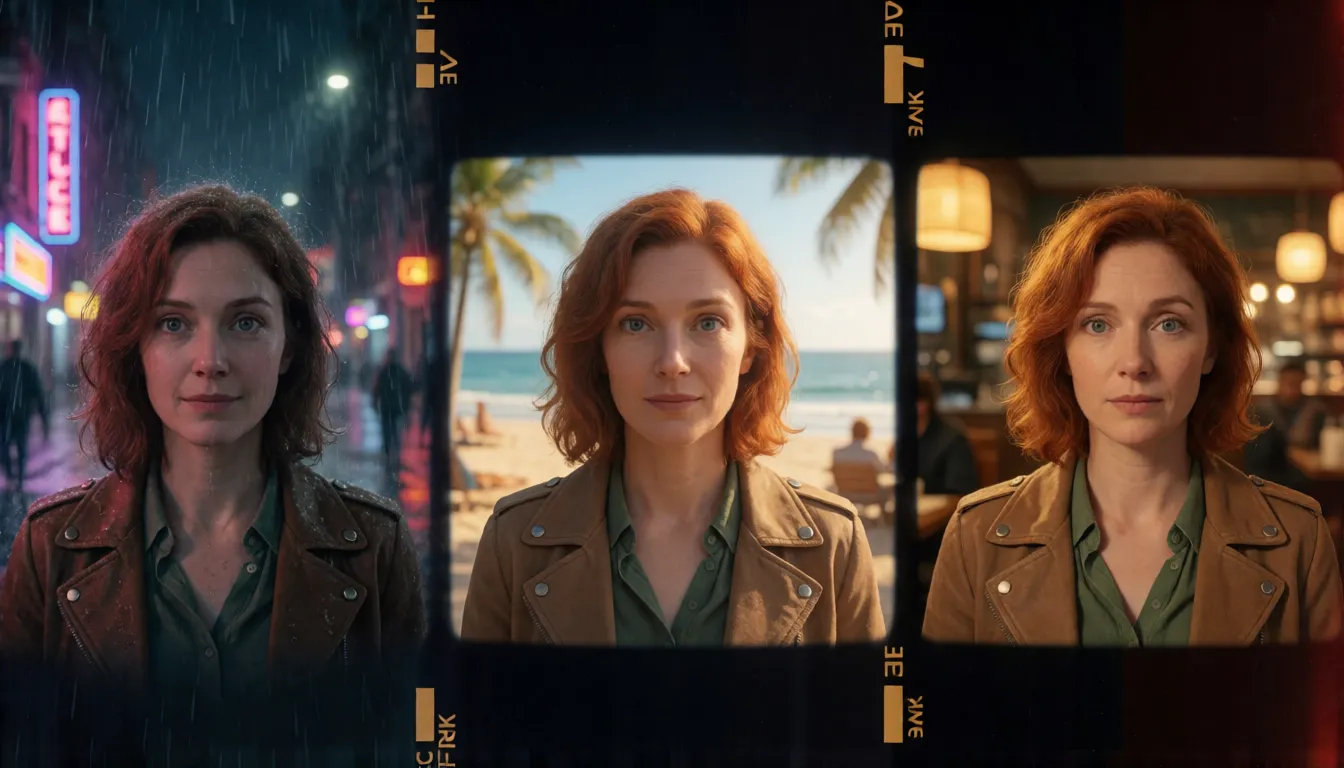
キャラクター丸ごとを1つの小さなファイルに
MiniMax H3 RefMods(Reference Latent Adaptersの略)は、オープンウェイトのH3音声・動画モデル向けに作られたコミュニティ製フォーマットです。保存されたキャスティングのようなものだと考えてください。毎回同じ参照画像をアップロードして<Picture 1>の位置タグをやりくりする代わりに、VAEで一度エンコードし、その結果を.safetensorsファイルとして保存します。あとはLoRAと同じように読み込むだけで、動画生成中にH3のリファレンス条件付けストリームへ注入されます。H3自体の重みは一切再学習しないため、作成は数時間ではなく数分で終わります。
このフォーマットとノードは、開発者@LuisacaoticaによるComfyUI-MiniMaxH3Modパックから生まれたもので、MITライセンスで公開されています。MiniMaxの製品ではなくコミュニティプロジェクトであり、READMEにはまだ開発中と記載されているため、リリース間でノード名や入力が変わる可能性があります。それでも勢いは衰えず、リポジトリは公開から数週間でGitHubスター500を突破しました。
| 設定 | 機能 | おすすめの用途 |
|---|---|---|
| Full Reference(エンコード) | エンコードした細部をすべて保持し、トークンを多く使用 | くっきり再現したい顔や衣装 |
| Compressed Reference | リファレンスをプールしてトークンを節約、細部と動きは一部失われる | 長いクリップや多数のファイルの重ね掛け |
| identity_encode プリセット | 人物やキャラクターの「誰であるか」を捉える | 繰り返し登場する主人公、ホスト、マスコット |
| style_experimental プリセット | ルックを8×8グリッドに凝縮 | 1つのカラーグレードや画風で統一するシリーズ |
| motion_sequence プリセット | 短いクリップの動きを保存 | ダンス、歩き方、ジェスチャーの再利用 |
クリエイターがリファレンスアダプターを活かす場面
MiniMax H3 RefMods の魅力はシンプルです。ファイル1つで、エピソードは無限大。これまで繰り返し登場する顔ごとにLoRAを学習していたクリエイターは、今ではキャラクター、スタイル、動きの小さなライブラリを作り、ショットごとに組み合わせています。以下は、コミュニティのスレッドや共有ワークフローでよく見かける使い方です。
ショートドラマとAIコミック
1人のオリジナル主人公を何十ものショットで再利用。場所、カメラワーク、アクションを変えても、顔はエピソードをまたいで変わりません。
バーチャルホストとオリジナルIP
マスコットやバーチャルプレゼンターを1つのファイルに固定し、見た目がブランドから少しずつずれることなく毎週クリップを公開できます。
ファッションと商品紹介
プロンプトで衣装を入れ替えながら、1人の成人モデルを安定させます。参照画像の服が混ざることがあるので、新しいルックははっきり記述しましょう。
変身ショット
AxisローダーでAからBへ2人のキャラクター間をスライド。モーフィング、ビフォーアフター、夢のシーンに最適です。
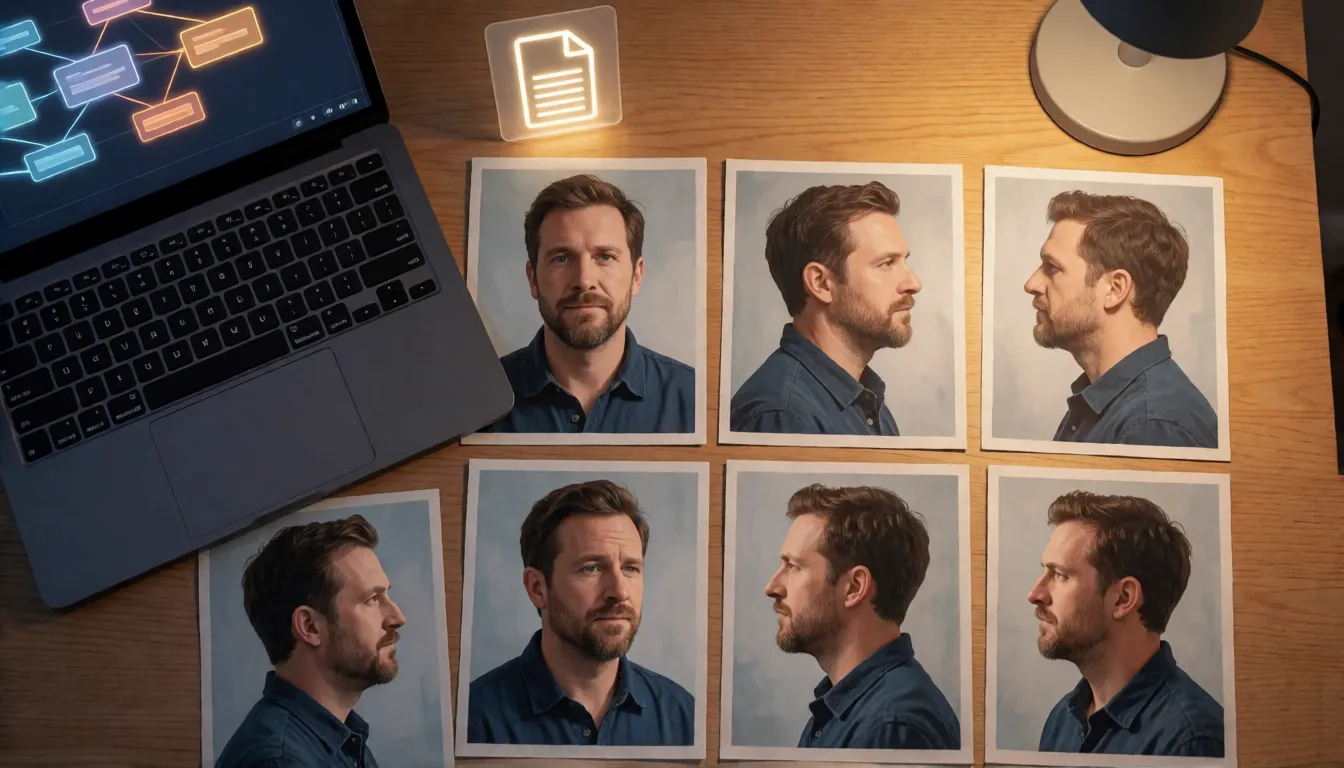
ComfyUIで8枚の写真から再利用可能なキャラクターへ
ComfyUIでの MiniMax H3 RefMods の作成は、ノードパックのREADMEに沿って進めます。まずは良い素材から。異なる角度から撮った、鮮明で1人だけが写った画像を5〜10枚、または短いクリップ1本を用意します。音声なら、クリアな音で5〜15秒が一般的な目安です。背景がごちゃごちゃしたものは避けましょう。フレーム内にあるものは、顔と一緒にファイルへ入り込んでしまう可能性があります。
- 1ComfyUI Managerから、またはGitHubリポジトリをcustom_nodesにクローンしてComfyUI-MiniMaxH3Modをインストールし、ComfyUIを再起動します。
- 2参照画像をExtract H3 RefModノードに読み込み、最大限の細部を得るためにFull Referenceでidentity_encodeプリセットを選びます。
- 3ローダーノードが見つけられるよう、出力をComfyUI/models/refmods/に保存します。
- 4Load H3 RefMods(最大8スロット、それぞれに強度とコピー数を設定可能)を追加し、初期強度を設定します。
- 5Apply H3 RefModをMiniMax H3のImageToVideoまたはReferenceToVideoノードの条件付けに接続し、通常どおりサンプリングします。
- 6同じシードでファイルなしのベースラインを一度レンダリングすれば、リファレンスが何を加えているかを正確に確認できます。
- Step Curveノード:concept_at_start、concept_at_middle、concept_at_endsから選び、ノイズ除去のどの段階でリファレンスを効かせるかを決めます。例えば、最初は見た目を寄せ、後半は動きを自由に。
- Load H3 RefMod Folder:ディレクトリを指定して、キャラクターセット全体を一度に切り替えられます。
ノードよりボタン派?Fizgig v6で作成
shootthesoundによるクリエイターツールFizgigは、2026年9月中旬のバージョン6で MiniMax H3 RefMods の作成機能を追加しました。抽出処理を使いやすいインターフェースで包み、すぐ使えるレシピを用意しています。コミュニティレシピは1メガピクセルの画像8枚、Fizgig liteは0.5メガピクセルの画像16枚を使い、その中間にFizgig 1MPオプションがあります。さらにスタイルプリセット、モーションと音声のリファレンス、そしてA/B比較を並べてレンダリングするRefMod Studioも搭載。強度設定を勘に頼らず判断できます。Fizgig自身のドキュメントには、各レシピを順に解説するハウツーガイドも含まれています。
2人のキャラクター、1つのシーン:ファイルの重ね掛け
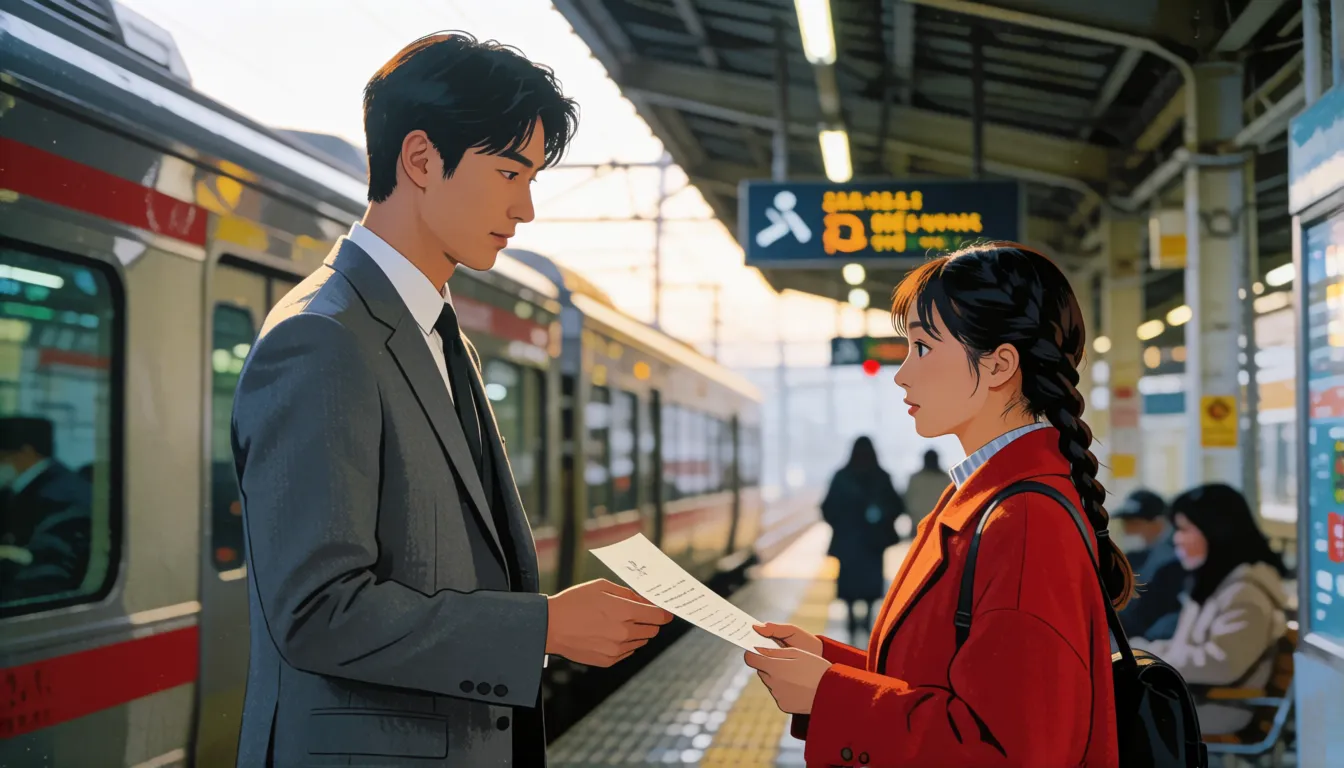
グループショットこそ、MiniMax H3 RefMods が単一画像の参照をさりげなく上回る場面です。キャラクターごとに専用のファイルを用意し、別々のスロットに読み込み、プロンプトでは<Subject 1>、<Subject 2>のように呼び分けます。1ファイルには1人だけにしましょう。2人の顔を混ぜたファイルは、顔同士が溶け合いがちです。主役の細部が失われ始めたら、まず脇役の強度を下げてください。また、髪、服装、体格の描写をプロンプトに残しておけば、モデルが誰が誰かを把握できます。
顔だけじゃない:スタイル、モーション、声のリファレンス
MiniMax H3 RefMods にとって、キャラクターは話の半分にすぎません。style_experimentalで作るスタイルファイルは、一連のフレームを1つのルックに凝縮し、シリーズ全体に適用できます。チャンネル全体で1つのカラーグレードを保つのに便利です。motion_sequenceで作るモーションファイルは、短いクリップを動きのテンプレートに変え、印象的な歩き方やダンスを別のキャラクターで再利用できます。
音声ファイルもあり、音声1秒あたり約80トークンです。ただし実験的なものとして扱ってください。現在のテストでは話者の特徴が安定して転送されず、音声はデフォルトでクリップの冒頭からエンコードされ、リップシンクの調整もありません。本人の許可なく実在の人物の声を真似る目的には絶対に使わないでください。
顔を安定させるプロンプトテンプレート
MiniMax H3 RefMods でプロンプトを書くときは、リファレンスファイルがトリガーワードではなく、ファイル名をプロンプトに書いても何の効果もないことを覚えておきましょう。効果的なのは、ファイルが存在しないかのようにキャラクターを描写し、細部はリファレンスに揃えてもらうことです。以下のテンプレートはオリジナルの成人キャラクター向けに書かれています。ご自身の詳細に置き換えてお使いください。
- 外見と動作は必ず言葉で固定しましょう:年齢、髪、目、服装、そして動きとカメラ。
- 1ファイルにつきキャラクター1人、キャラクター1人につき<Subject N>タグ1つ。
- 強度は中程度から始め、顔がずれたときだけ上げ、背景が参照写真をコピーし始めたら下げます。
- 衣装を替えるときは新しい服を明確に指定し、same faceを加えて参照画像の服が優先されないようにします。
キャラクター1人
<Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, wearing a white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting.
キャラクター2人
<Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light.
衣装チェンジ(18歳以上のオリジナルキャラクター)
<Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, standing by a sunlit pool, slow dolly-in.
RefMod vs LoRA vs 参照画像の直接入力
どの方法にも出番があります。Fizgigの作者によれば、学習済みLoRAのほうが今でも汎化性能が高く、より高い再現度に達しますが、参照素材に近いショットではその差はわずかです。通常の参照画像は準備不要ですが、実行のたびに再エンコードされ、複数の画像を使うと位置タグの扱いが面倒になります。
| RefMod | LoRA | 参照画像を直接入力 | |
|---|---|---|---|
| 学習 | 不要、抽出1回のみ | 必要、データセットと学習の実行 | 不要 |
| 初回利用までの時間 | 数分 | 数時間 | 即時 |
| ファイルサイズ | 約1〜1.6 MB | 通常ははるかに大きい | ファイルなし |
| 新しい角度での再現度 | 参照に近ければ良好 | 最も高い | 実行ごとにばらつく |
| キャラクターの重ね掛け | 最大8スロット | 可能だが干渉することも | 画像ごとの位置タグ |
まだ苦手なこと:正直な制限事項
MiniMax H3 RefMods はまだ新しく、ノードパックのREADMEも粗削りな部分を率直に認めています。事前に知っておけば何時間もの再生成を節約でき、その多くはよりクリーンな参照素材や低めの強度といった簡単な対策で回避できます。
- 速い動きでは顔がにじむことがあります。カメラの動きを遅くするほうがアイデンティティを保ちやすくなります。
- Compressed Referenceは顔の細部が失われるため、クローズアップにはFull Referenceを使いましょう。
- アイデンティティ、服装、背景、構図が一緒に転送されることがあり、選択的な転送は保証されません。
- 音声ファイルからの声のクローンは現状不安定で、音声にはリップシンクもありません。
- 一部のワークフローはすべてのGPUで十分に検証されておらず、公式のベンチマークもありません。
既製ファイル:コミュニティの共有場所
MiniMax H3 RefMods をすべてゼロから作る必要はありません。クリエイターのmalcolmreyは、Hugging FaceでApache-2.0のもと数百もの既製ファイルからなる大規模ライブラリを公開しており、ガイド、サンプル、ワークフロー例のデータセットも併せて提供しています。ファイルをダウンロードしてComfyUI/models/refmods/に置けば、ローダーに表示されます。小規模な個人アップロードもありますが、多くはあまり更新されておらず、実在の人物や著作権のあるキャラクターに似たものも含まれています。使う前に中身を確認し、オリジナルまたは適切にライセンスされたキャラクターだけを使いましょう。
無修正での利用:リファレンスファイルで変わること・変わらないこと
無修正の MiniMax H3 RefMods を探している人は、たいていフィルターなし版を期待しています。しかしそのようなものはありません。リファレンスファイルはモデルに「誰を・何を映すか」を伝えるだけで、モデルが生成できる内容を変えるものではないのです。H3はオープンウェイトモデルなので、ローカルユーザーはもともと自分で環境を決められます。成人向けクリエイターは一般的に、18歳以上のオリジナルキャラクターのファイルを、ビーチウェア、ランジェリー、ブドワールシリーズ向けのコミュニティ製H3 LoRAと組み合わせています。ローカル環境の構築を省きたいなら、Spicy AIが成人・架空・同意済みのキャラクター向けに緩やかなフィルターのオンラインH3画像から動画生成を提供しています。
オリジナルの成人キャラクターの静止画をアップロードして、GPUなしでアニメーション化しましょう。
画像から動画を開く一貫したキャラクターのプロンプトをオンラインで試す
キャラクターの静止画1枚から始めて、プロンプトを貼り付ければ、あとは動画モデルにおまかせ。以下のスターターはオリジナルの成人キャラクター向けに書かれており、そのまま使えます。
- <Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting
- <Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light
- <Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, stands by a sunlit pool and turns toward the camera, slow dolly-in
- <Subject 1>, adult man with a trimmed beard, open white shirt, laughs on a yacht deck at golden hour, wind in his hair, camera orbits slowly
リファレンスファイルでH3をセルフホスト vs Spicy AIでオンライン生成
ローカルのComfyUIならノードツール一式が使えます。オンラインならその自由度と引き換えにセットアップ不要です。
| ローカル環境(公式ウェイト) | Spicy AI オンライン | |
|---|---|---|
| コンテンツフィルター | 自分で環境を設定 | 成人向けコンテンツ(18歳以上)に緩やかなフィルター |
| オープンウェイト | あり | 不要 — ブラウザで動作 |
| キャラクターの一貫性 | RefModファイル、LoRA、ノード制御 | キャラクターの静止画から開始 |
| 始めるための費用 | 自前のGPU | 無料プランあり |
よくある質問
MiniMax H3 RefMods はMiniMaxが作ったものですか?
いいえ。@LuisacaoticaによるComfyUI-MiniMaxH3Modノードパックで作られたコミュニティ製フォーマットで、MITライセンスです。MiniMaxはこれについて見解を公表していません。
何か学習させる必要はありますか?
いいえ。参照素材はVAEを一度通過し、約1〜1.6 MBのファイルとして保存されます。H3の重みが再学習されることはありません。
画像は何枚使えばよいですか?
READMEでは、鮮明で1人だけが写った画像5〜10枚、または短いクリップ1本を推奨しています。Fizgigのレシピでは、1メガピクセルの画像8枚、または0.5メガピクセルの画像16枚を使います。
RefModはLoRAより優れていますか?
より速く、より小さいです。再現度や珍しい角度では学習済みLoRAが今も上回りますが、参照素材に近いショットなら差はわずかです。
一度にいくつ読み込めますか?
Load H3 RefModsノードには最大8スロットがあり、それぞれ個別に強度を設定できます。グループシーンでは、キャラクターごとに1ファイルを使いましょう。
ファイルはどこに置けばよいですか?
ComfyUI/models/refmods/に置き、ローダーノードで選択するか、フォルダーローダーでサブディレクトリを指定します。
声をクローンできますか?
まだ安定してはできません。現在のテストでは話者の特徴の転送が不安定です。また、本人の同意なく他人の声を使うことは絶対に避けてください。