音声から動画へ · オープンウェイト
無修正 Kandinsky S2V 1.0 Pro:どんな写真でも話し、身振りし、歌わせる
Kandinsky S2V 1.0 Pro に必要なのは、写真1枚、誰かが話している録音、短いシーン説明の3つだけ。返ってくるのは、その人物が口の動きを合わせて話し、手や肩を動かし、最初から最後まで同じ人物らしさを保つ動画です。開発は Kandinsky 5.0 と 6.0 を手がけた Kandinsky Lab で、ウェイトは無料でダウンロードできます。このガイドでは、クリエイターがどんな場面で使っているか、自然に見える理由、あなたの GPU に合うバージョン、コピーしてすぐ使えるプロンプト、そして他のオープンなトーキングアバターモデルとの比較を紹介します。
- 写真+音声 → 動画
- 顔だけでなく全身
- 25 fps・長さ無制限
- 16ステップの高速版
無修正の代替動画ジェネレーター
画像から動画Kandinsky S2V 1.0 Pro と同じく、ポートレート1枚から始まります。アップロードして、人物の動きとシーンを説明すれば、すべて入力済みの状態で画像から動画スタジオが開きます。登場人物が全員18歳以上であれば、アダルトなテーマも歓迎です。
写真1枚と音声1本で、まるごとひとつのパフォーマンス
多くの「写真をしゃべらせる」ツールは顔しか動かしません。口が開閉するだけで、画像の残りは止まったままです。Kandinsky S2V 1.0 Pro は違います。参照画像、クリアな音声録音(16 kHz モノラル)、テキストプロンプトを渡すと、人物全体が生き生きと動く 25 fps の動画を生成します。唇はすべての音節に追従し、手は何かを説明するときの自然な身振りをし、背景はプロンプトの通りに振る舞います。出力は写真のアスペクト比を保ち、元の音声トラックも含むので、そのまま投稿できます。
長さも固定ではありません。Kandinsky S2V 1.0 Pro は125フレームの5秒ブロック単位で動作し、各ブロックは前のブロックの終わりから続きを生成するため、2分のナレーションは同じ人物の2分の動画になります。まず目を引くのはリップシンクです。各フレームは対応する音声の区間だけを参照するので、口の形がずれずに正しい音に合います。
写真1枚からのトーキング動画が広がっている分野
音声駆動アバターは技術デモから日常のコンテンツ制作へと移り、Kandinsky S2V 1.0 Pro はそこにぴったり収まります。以下は研究資料やクリエイターコミュニティが特によく挙げる用途で、どれにも共通するのは、スタジオや出演者を手配せずに、音声どおりに話すリアルな人物を画面に出したいというニーズです。
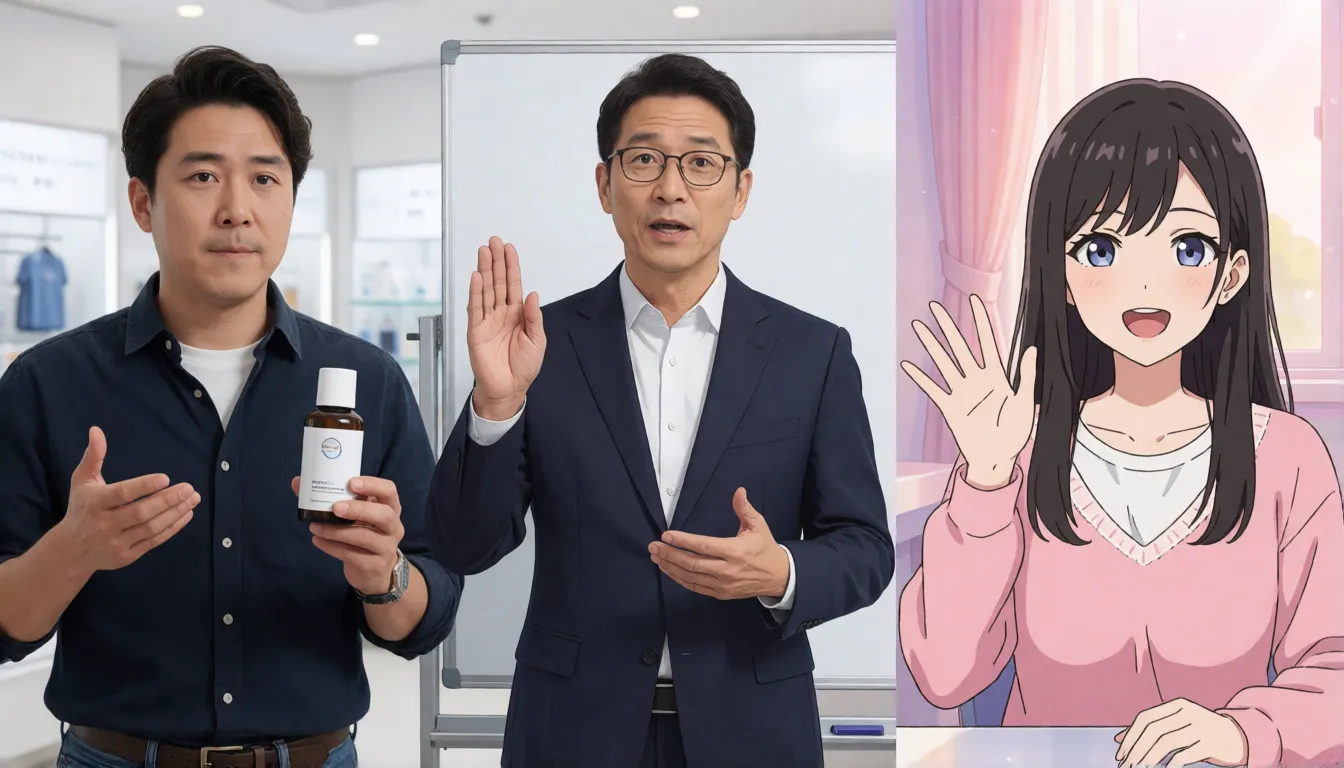
- ショートドラマやアニメコミック:各キャラクターの肖像にセリフ音声を渡せば、スタンプではなくシーンのように感じられる全身の会話ショットが得られます。
- 商品紹介・ライブコマース動画:モデル写真と商品説明の録音から、数分でプレゼンター風の解説動画が完成します。
- 講座、ニュースまとめ、研修:ナレーション原稿を、何分も身振りを続けるバーチャル講師による長い講義に変えられます。
- バーチャル配信者・AIコンパニオン:キャラクター画像と音声合成の声を組み合わせれば、キャラクターがカメラ越しに応答します。
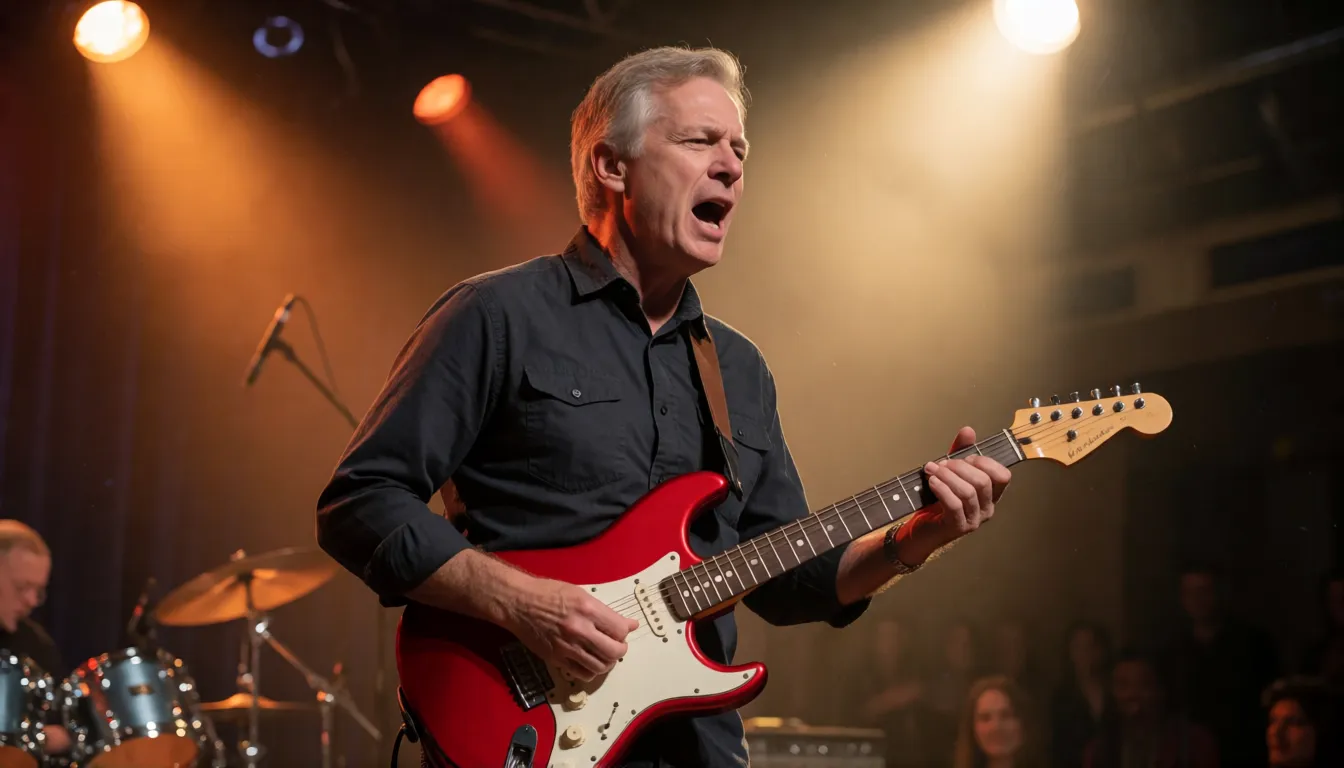
- 音楽とポッドキャスト:公式の Diffusers サンプルは赤いエレキギターを弾く白髪の男性で、パフォーマンス映像にも使えることを示しています(歌唱品質はチームによるベンチマークが行われていません)。
- 多言語吹き替え:写真は1枚のまま、異なる言語の音声トラックに差し替えられます。学習時のキャプションは英語とロシア語なので、大規模な案件の前に他の言語で試してください。
ショートドラマの会話
各キャラクターの肖像にセリフを渡せば、Kandinsky S2V 1.0 Pro が正確なリップシンク付きの全身シーンを返します。
商品解説
モデル写真と録音した商品説明が、ショップやライブコマース向けのプレゼンター風クリップになります。
バーチャルホスト
キャラクター画像と TTS 音声を組み合わせて、配信者、講師、応答する AI コンパニオンを作れます。
自然に見える理由
Kandinsky S2V 1.0 Pro をこれまでの多くのリップシンクツールと分けるのは、3つの設計上の選択です。第一に、全身アニメーションであること。モデルは Kandinsky 5.0 Video をベースにしているため、体や服、シーンの動き方をすでに理解しており、プロンプトで身振りや舞台を操作できます。第二に、言葉と声の両方を理解すること。Qwen2.5-Omni がテキストプロンプトを読み、音声を毎秒25トークンで聴き取るため、動きが話しぶりのエネルギーに合います。第三に、3階層のメモリが参照写真の見た目をブロックからブロックへ引き継ぐため、長いテイクでも顔や服装が一貫します。
Kandinsky S2V 1.0 Pro には蒸留版もあります。Pro distill は50ステップではなく16ステップで結果に到達し、ガイダンスをウェイトに組み込んでいます。チームの報告では約5倍高速(構成により4.5〜5.6倍)で、ほぼすべての指標でベースモデルと同等です。最強のオープンなベースラインと2つの商用サービスを相手にした論文の人間評価では、Kandinsky S2V 1.0 Pro は平均して同等以上と評価され、最も好まれたのはリップシンクでした。
- テキストプロンプトで全身の動きとシーンを制御
- フレームごとの音声アテンションによる正確なリップシンク
- ブロック単位の継続生成により長さの上限なし
- MIT ライセンスのオープンウェイトで、ローカル実行が可能
- Pro モデルには 48 GB の GPU が必要(HD は 80 GB)
- 音声は生成しないため、自分の声か TTS を用意する必要あり
- 24 GB カード向けの公式量子化版はまだない
- HD モードはその解像度で学習・評価されていない
Lite か Pro か、ベースか蒸留か:バージョンの選び方
Kandinsky S2V 1.0 Pro は4つのチェックポイントからなるファミリーの一員です。2B の Lite モデルは高速で軽量な選択肢、21B の Pro モデルは顔・手・動きの品質が最も優れています。各サイズの中では蒸留版が普段使い向けで、50ステップのベースモデルは細部を極めたい人向けです。どちらの Pro チェックポイントも 1280×768 の HD 構成で実行できます。
| バージョン | サイズとステップ数 | 向いている用途 | H100 1枚での速度(動画1秒あたり) |
|---|---|---|---|
| Lite 2B distill | 2B、蒸留版 | 高速な下書き、小さめの GPU | 約 8.7 秒 |
| Lite 2B | 2B、ベース | 蒸留なしの Lite 品質 | Lite distill より遅い |
| Pro 21B distill | 21B、16ステップ | 日常使いに最適なバランス | 約 41.5 秒(コンパイル時 33.6 秒) |
| Pro 21B | 21B、50ステップ | 最高の忠実度、ネガティブプロンプト対応 | 約 189 秒 |
| Pro distill HD | 21B、1280×768 | より大きな画面(品質は未検証) | 約 137 秒 |
GPU メモリと速度の目安
Kandinsky S2V 1.0 Pro は大きなモデルなので、約 65 GB のファイルをダウンロードする前にハードウェアを計画しましょう。公式要件は、メモリ 48 GB 以上(HD は 80 GB)の GPU 1枚と、バージョン 580 以降のドライバーです。H100 1枚では、標準解像度の Pro distill のピークは約 46 GiB、HD は約 55 GiB です。そのため10秒のクリップは1枚のカードで約6〜7分かかり、公式の8 GPU 構成では動画1秒あたり約11秒に短縮されます。
メモリが足りない場合は、VAE タイリングを有効にするとうっすら継ぎ目が出る代わりにピークが約 28 GB まで下がります。CPU オフロードを使う Diffusers ルートのピークは 50 GiB 前後で、小さめのカードで試すなら Lite 2B distill モデルが最も手軽です。公式の量子化ファイルはまだないため、一般向けの 24 GB カードでは、クラウド GPU を半日ほど借りるのが一般的な回避策です。
試す3つの方法:オンラインデモ、ComfyUI、Diffusers
Kandinsky S2V 1.0 Pro の実力を見るのに、何かをインストールする必要はありません。チームは Hugging Face で無料のデモ Space を公開しており、もう少し細かく制御したい人向けに Colab と Kaggle のノートブックもあります。自分で動かす準備ができたら、普段のワークフローに合うルートを選びましょう。
- 1オンライン:Hugging Face の Kandinsky-S2V-1.0-Demo Space を開き、ポートレートと短い WAV ファイルをアップロードし、プロンプトを追加して生成します。
- 2コマンドライン:kandinsky-s2v の GitHub リポジトリをクローンし、uv sync を実行してから、s2v_pro_distill.yaml 設定と --audio、--image、--out のパスを指定して uv run kandy-s2v generate を実行します。--prompt と --seed を追加すると、結果の制御や再現ができます。
- 3ComfyUI:リポジトリの dev/comfyui ブランチに切り替えます。Lite distill と Pro distill 用のノードが含まれているので、画像・音声・プロンプトをサンプラーに接続します。
- 4Diffusers:main ブランチから diffusers をインストールし、ModularPipeline で kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers を読み込み、音声を 16 kHz で読み込みます。
どのルートを選んでも、Kandinsky S2V 1.0 Pro ではどんな設定よりも入力ファイルの質が結果を左右します。次の点を意識しましょう:
- 人物が画面の大部分を占める、鮮明な正面写真を使いましょう。写真のアスペクト比がそのまま動画のアスペクト比になります。
- BGM のないクリアな音声を録音し、16 kHz モノラルで保存しましょう。
- 気に入った結果が出たら --seed を固定し、プロンプトだけを変えてバリエーションを探りましょう。
トーキング動画向けプロンプトテンプレート
Kandinsky S2V 1.0 Pro では、台本を担うのはテキストプロンプトではなく音声です。プロンプトでは人物、動き、舞台、カメラを説明し、見た目がぶれないよう服装と背景は参照写真に近づけましょう。以下のテンプレートは人気のフォーマットをカバーしています。細部を入れ替え、構成はそのまま使ってください。
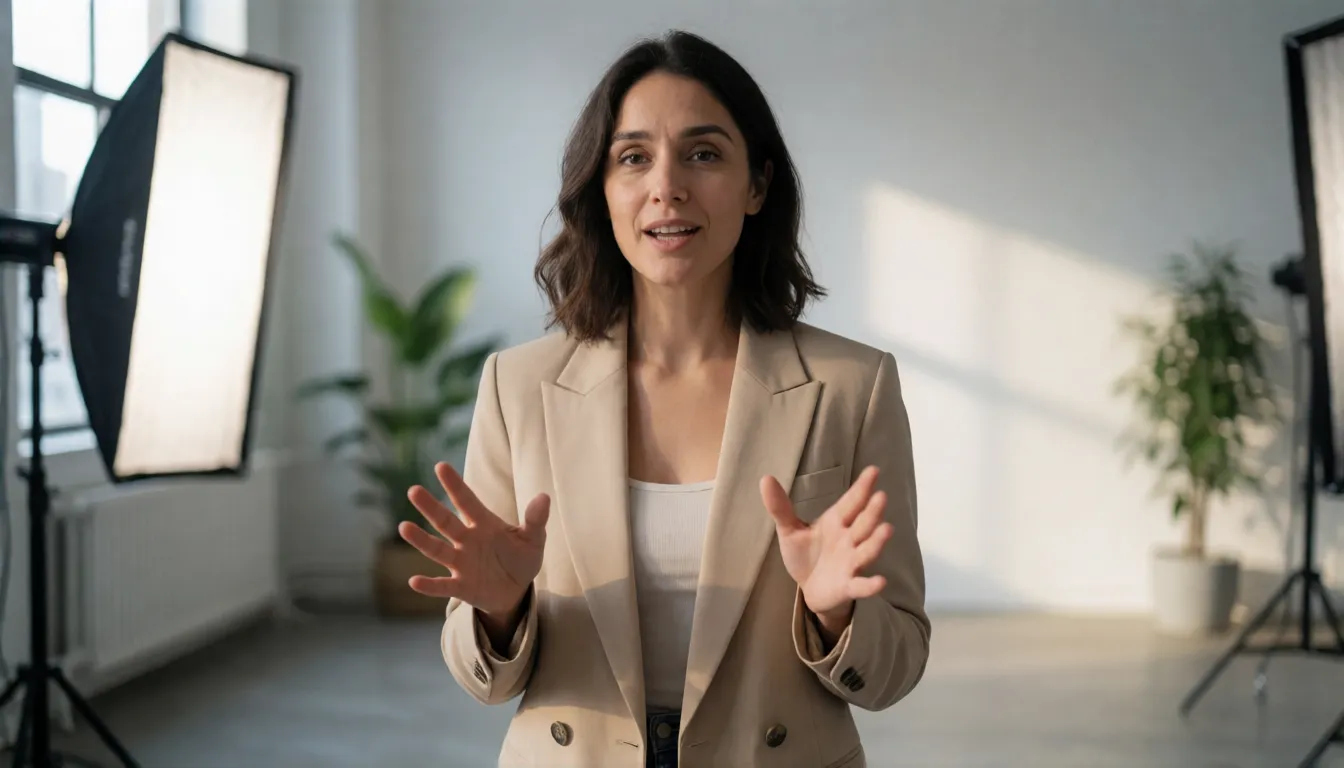
- プレゼンター: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
- 商品紹介: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- ドラマの会話: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- ミュージシャン: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- 講師: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- バーチャル配信者: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- ビーチトーク(18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- ネガティブプロンプト(50ステップモデルのみ): blurry face, distorted mouth, extra fingers, flickering, static body.
Wan 2.2 S2V、InfiniteTalk など他のオープンアバターとの比較
オープンなトーキングアバターモデルは数が増え、Kandinsky S2V 1.0 Pro と比べてそれぞれ異なる強みがあります。Alibaba の Wan2.2-S2V-14B にはすでにコミュニティ製の GGUF ファイルがあり、小さめの GPU でも扱いやすくなっています。InfiniteTalk と MultiTalk は非常に長い動画や複数人の会話に特化しています。LongCat-Video-Avatar 1.5 にも ComfyUI 向けの GGUF ビルドがあります。Kandinsky S2V 1.0 Pro の際立つ点は、寛容な MIT ライセンス、テキストで操作できる全身の動き、16ステップの蒸留版リリースです。現時点の弱点は、高いメモリ要件とまだ若いコミュニティエコシステムです。論文はベースラインの名前を明かしていないため、直接比較の主張は未検証として扱い、自分のクリップで試してください。
| モデル | 強み | 小さめの GPU で扱いやすい? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | 全身の動き、テキストで制御できるシーン、16ステップの蒸留版 | Lite のみ。Pro は 48 GB 必要 |
| Wan2.2-S2V-14B | 成熟したエコシステム、映画的な動き | はい、コミュニティ製 GGUF あり |
| InfiniteTalk / MultiTalk | 非常に長いクリップ、複数人の会話 | 構成による |
| LongCat-Video-Avatar 1.5 | ComfyUI 対応のアバター動画 | はい、コミュニティ製 GGUF あり |
無修正のトーキングアバター:今できること
Kandinsky S2V 1.0 Pro の公式またはコミュニティによる無修正ファインチューンは、まだ存在しません。オープンウェイトはオンラインのモデレーション層なしでローカル実行できますが、学習データは1人が話している映像なので、アダルトシーン向けに作られたものではありません。また、モデルカードでは同意を得た人物だけをアニメーション化するよう求めています。何もインストールせずに、18歳以上の架空キャラクターの写真を話させたり、誘惑するような仕草をさせたり、水着やランジェリー姿でポーズさせたりしたいなら、当サイトの画像から動画スタジオでポートレートをアップロードし、動きを説明して、ブラウザ上で生成できます。
18歳以上のキャラクターのポートレートをブラウザでアニメーション化。GPU は不要です。
画像から動画を始める →Kandinsky S2V 1.0 Pro のセルフホスト vs Spicy AI でのオンライン生成
| ローカル導入(公式ウェイト) | Spicy AI オンライン | |
|---|---|---|
| コンテンツフィルタリング | 自分で実行する場合はオンラインフィルターなし | アダルト(18+)コンテンツ可 |
| オープンウェイト | あり、Hugging Face で MIT ライセンス | 該当なし、オンラインで実行 |
| 実際に使われるモデル | Kandinsky S2V Lite または Pro | Spicy AI 独自の動画モデル |
| 料金 | ウェイトは無料、GPU 代は自己負担 | 無料で開始、追加はクレジット制 |
- ローカル:自分の音声による音声駆動リップシンク、長さ無制限、完全なコントロール。
- Spicy AI:写真から始めてブラウザでアニメーション化、ハードウェア不要。
よくある質問
Kandinsky S2V 1.0 Pro とは何ですか?
Kandinsky S2V 1.0 Pro は Kandinsky Lab が開発した210億パラメータの音声から動画への生成モデルです。参照写真、音声録音、テキストプロンプトを渡すと、リップシンク付きの 25 fps 全身トーキング動画を生成します。ウェイトは MIT ライセンスで公開されています。
Pro と Pro distill の違いは何ですか?
どちらも 21B パラメータです。distill 版は pi-Flow 蒸留により50ステップではなく16ステップで完了し、ガイダンスをウェイトに組み込んでいるため、約5倍高速でありながら、ほぼすべての指標でベースモデルに近いスコアを出します。
Kandinsky S2V 1.0 Pro に必要な GPU メモリはどれくらいですか?
チームは 48 GB 以上(HD は 80 GB)の GPU 1枚を推奨しています。Pro distill の標準解像度でのピークは約 46 GiB で、VAE タイリングを使うとうっすら継ぎ目が出る代わりに約 28 GB まで下がります。公式の量子化版はまだありません。
Kandinsky S2V 1.0 Pro の動画はどれくらいの長さにできますか?
音声の長さまで可能です。モデルは5秒のブロックを生成し、それぞれを前のブロックから継続します。H100 1枚では、Pro distill で標準解像度の動画1秒に約41.5秒かかります。
Kandinsky S2V 1.0 Pro は声も生成しますか?
いいえ。実際の録音でも音声合成でも、音声はユーザーが用意します。完成した動画にはその元の音声トラックが含まれます。
オンラインデモや ComfyUI 対応はありますか?
はい。Kandinsky Lab は Hugging Face でデモ Space を公開しており、GitHub リポジトリの dev/comfyui ブランチでは Lite distill と Pro distill 用の ComfyUI ノードが追加されます。Diffusers 対応は main ブランチから利用できます。
無修正の Kandinsky S2V 1.0 Pro はありますか?
2026年11月時点ではありません。公式・コミュニティともに無修正ファインチューンは公開されていません。オープンウェイトを自分で実行するか、18歳以上の架空コンテンツを許可するオンラインの画像から動画ジェネレーターを利用できます。
出典
- Kandinsky-S2V-1.0-Pro-distill モデルカード(Hugging Face)
- Kandinsky-S2V-1.0-Pro-distill-Diffusers モデルカード(Hugging Face)
- Kandinsky-S2V-1.0-Pro ベースモデル(Hugging Face)
- Kandinsky S2V 1.0 オンラインデモ(Hugging Face Space)
- kandinskylab/kandinsky-s2v リポジトリ(GitHub)
- Kandinsky S2V 1.0:音声駆動アバター動画生成(arXiv)
- Kandinsky Avatar プロジェクトページ
- Wan2.2-S2V-14B GGUF(Hugging Face)
その他の無修正動画モデルガイド
- 無修正 Kandinsky 6.0
- 無修正 Kling
- 無修正 Kling 2.6
- 無修正 Kling O1
- 無修正 Sora
- 無修正 Veo
- 無修正 Hailuo AI
- 無修正 MiniMax H3 Max
- 無修正 Wan
- 無修正 Wan 3.0
- 無修正 Seedance
- 無修正 Seedance 2.5
- 無修正 Seedance 2.0
- 無修正 Seedance 2.0 Mini
- 無修正 HunyuanVideo
- 無修正 LTX Video
- 無修正 Runway
- 無修正 Pika
- 無修正 Luma Dream Machine
- 無修正 Vidu
- 無修正 PixVerse
- 無修正 EdenLive
- 無修正 Grok Imagine
- 無修正 AI Avatars
- 無修正 HappyHorse 1.0
- 無修正 MiniMax H3 FL2VA Ref2VA
- 無修正 Kling 4.0
- 無修正 Kling 3.0
- 無修正 MiniMax H3 RefMods
- 無修正 Looking Ahead
- 無修正 TaoMate-H3
- 無修正 SANA-Video 2.0
- 無修正 MiniMax H3 Remix
- 無修正 Sora 2
- 無修正 Wan 2.6
- 無修正 LTX-2.5 Slow Motion
- 無修正 VDN MiniMax H3
Spicy AI は独立したサイトであり、Kandinsky Lab および Sber とは提携していません。すべてのコンテンツは成人(18歳以上)のみを対象としてください。本人の同意なく実在の人物をアニメーション化しないでください。