無修正AI動画 · MiniMax H3のコミュニティマージ
無修正 MiniMax H3 FL2VA Ref2VA ハイブリッド:キャラクターを覚えている高精細動画
MiniMaxはH3動画モデルを2つの別々のチェックポイントとして公開しています。FL2VAは映像と音声がよりクリーンですが、参照できるのは最初と最後のフレームだけ。Ref2VAは複数の参考写真・動画・音声に従えますが、映像はやや甘くなります。コミュニティ製の MiniMax H3 FL2VA Ref2VA ハイブリッドはこの2つを1ファイルに統合。ショートドラマでも、ファッションリールでも、アニメキャラクターでも、仕上がりの美しさを保ったままショットをまたいで同じ人物に見せられます。ここでは機能、選ぶべきファイル、プロンプトのコツを紹介します。
- キャラクターの一貫性
- ネイティブ音声
- オープンウェイト
無修正の代替動画ジェネレーター
画像から動画キャラクター写真を最初のフレームとしてアップロードし、動き・カメラ・音を書くだけで短い動画になります。
FL2VAとRef2VA:ひとつの動画モデル、2つの個性
H3はMiniMaxの330億パラメータの音声・動画モデルです。ひとつのネットワークが映像とサウンドトラックを同時に生成するため、足音や波の音、セリフが最初から映像と同期しています。MiniMaxは万能ファイル1つではなく、2つのチェックポイントを公開しました。FL2VAはテキストプロンプトと0〜2枚の画像を受け取り、テキストから動画、最初のフレームのアニメーション化、最後のフレームでの締め、最初と最後のフレーム間のトランジションをカバーします。Ref2VAはプロンプトと、最大9枚の画像・3本の動画・3本の音声(合計最大12ファイル)のリファレンスパックを受け取ります。
どちらも4〜15秒、24fps、32kHzステレオ音声、短辺768ピクセル(デフォルト)の動画を出力します。ただし両者を並べて検証したコミュニティの作者によると、FL2VAは映像と音声の品質がはっきり上で、キャラクターをきちんと覚えているのはRef2VAのほう。このトレードオフをなくそうとするのがハイブリッドです。
| FL2VA | Ref2VA | |
|---|---|---|
| 入力 | テキスト+最大2フレーム(最初・最後・両方) | テキスト+最大9画像、3動画、3音声 |
| 得意なこと | クリーンな映像と音、最初から最後のフレームへの動き | 顔・衣装・場所・声の一貫性 |
| 弱点 | キャラクターシートに従えない | コミュニティのテストでは画質がやや甘い |
| 主な用途 | 静止画を動かす、2つのキーフレームをつなぐ | シリーズもの、衣装紹介、繰り返し登場するセット |
コミュニティが2つをハイブリッドモデルに融合した理由
きっかけは、2つのファイルを重みごとに比較したことでした。アップローダーのsmhfacctは、両者がコサイン類似度0.9997以上とほぼ同一で、本当の違いは各Transformerブロック内の小さな層、adaln_projの変調重みにあることを発見しました。その層をRef2VAからFL2VAへ移植すると、FL2VAの見た目と音の大部分を保ちつつ、リファレンス能力を借りられるのです。
MiniMax H3 FL2VA Ref2VA ハイブリッドの正体はそれだけ。FL2VAをベースに、選んだ範囲のブロックへRef2VAの変調層をコピーしたものです。再学習も平均化もなく、狙いを定めた移植のみ。MiniMaxの公式リリースではなくコミュニティの実験で、作者2人とも評価は主観的だと述べています。それでも、Ref2VAの記憶力がほしいけれどボケは困るという人にとって、現時点で最も直接的な解決策です。
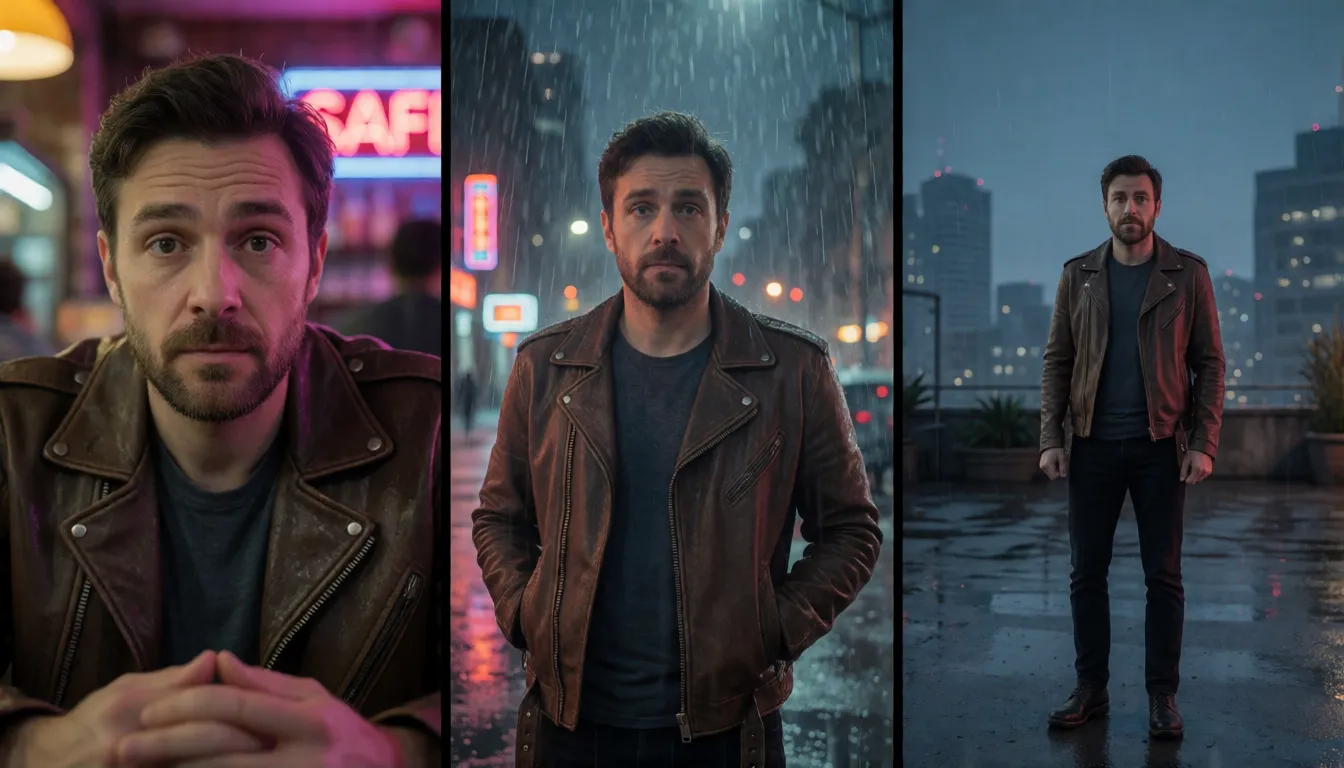
得意なシーン:シリーズもの、ファッションリール、繰り返し登場するセット
MiniMax H3 FL2VA Ref2VA マージが求められる理由は、キャラクターの一貫性です。ショートドラマの制作者は顔写真1枚と衣装写真1枚を入れるだけで、カフェでの対決、雨の街歩き、屋上での別れを、すべて同じ顔で撮れます。ベースがFL2VAなので、縦型ドラマを完成度高く見せるシャープな映像とネイティブ音声もそのままです。
- 連続ストーリーやAIドラマ:1枚の参考ポートレートで、主人公があらゆるシーン・アングル・照明の変化を通して同じ姿を保ちます。
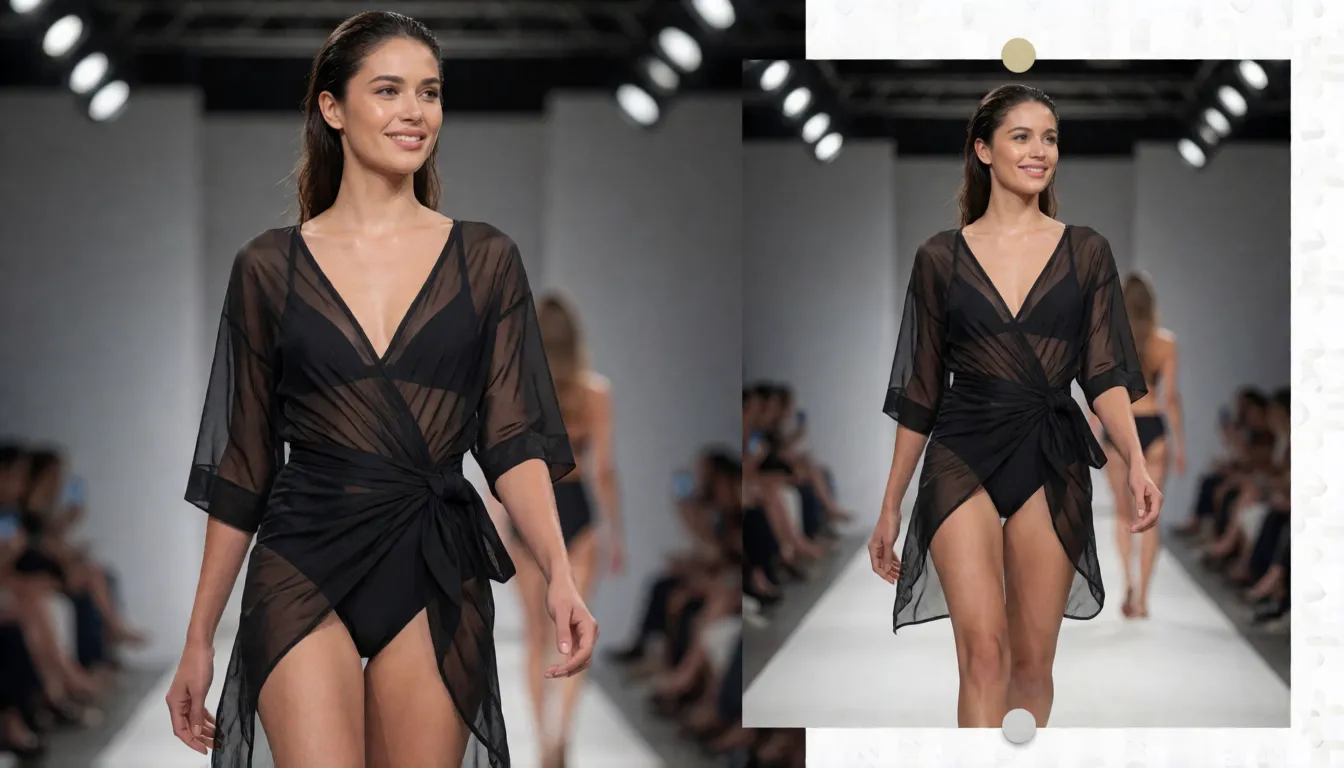
- 衣装・スタイリング紹介:衣装を1つ目、モデルを2つ目のリファレンスにして、ランウェイでのターンやゆっくりした回転を指示。リファレンスが軽めのファイルなら、カメラを固めずに服で結果を導けます。
- 繰り返し登場するロケーション:部屋やバー、ビーチの写真1枚を使い回し、別の位置から新しい4〜15秒のショットを生成できます。
- 声と音楽の連続性:Ref2VAは2〜15秒の音声クリップを受け付けるので、キャラクターの声やテーマの雰囲気を複数のクリップで繰り返せます。ハイブリッドもこの入力を維持していますが、どの程度うまく働くかはまだ誰も検証していません。
- 成人向け(18+)スタイリング:水着、ランジェリー、ビキニ姿の架空の成人キャラクターで、ビーチ・プール・ブドワールのリールを、すべて自分のマシン上で。
b15〜b49:最適なハイブリッドファイルの選び方
ファイル名は、どのブロックにRef2VAの層が入っているかを示します。範囲が広いほどリファレンスへの追従が強くなり、映像はRef2VAの甘めの質感に近づきます。範囲が狭いほどFL2VAの美しさが残ります。smhfacctは枝刈り済みint8ベースの上に4つのint8ファイルを、diobrando0は最後の数ブロックだけを変えた、各約66.28 GBの枝刈りなしbf16ファイル2つを公開しています。
| ファイル | 精度 | リファレンスの強さ | 向いている人 |
|---|---|---|---|
| b15-49 | int8 | 最も強い | リファレンスが多く、多少の甘さは許容できる |
| b20-49 | int8 | 強い | リファレンス重視のプロジェクト |
| b25-49 | int8 | バランス型 | 作者推奨の出発点 |
| b30-49 | int8 | 中程度 | 画質を最優先したい |
| b40-49 | bf16、約66.28 GB | 軽め(重みの約7.9%がRef2VA由来) | フル精度でさりげなく誘導したい |
| b45-49 | bf16、約66.28 GB | 最も軽い | diobrando0が最初に勧めるファイル |
よく議論になるのがb25-49とb30-49の比較です。まずb25-49から始め、顔や衣装がすでに一致していてもっとくっきりした映像がほしければb30-49へ。逆も同じで、リファレンスが無視されるなら範囲の広いファイルへ、映像がぼやけたり音が薄くなったりしたら狭いファイルへ移りましょう。
ハードウェアについては、どちらの作者も具体的な数値を出していません。必要メモリは対応するFL2VAファイルと同じとされており、int8の MiniMax H3 FL2VA Ref2VA ファイルはint8のFL2VAと同クラス、66 GBのbf16ファイルは一般向けグラフィックカード1枚ではなく、現実的にはワークステーション向けです。
AdaLNマージスクリプトで自分だけのブレンドを作る
diobrando0はbf16ファイルと一緒にh3_adaln_merge.pyを公開しています。--loと--hiで指定したブロック範囲について、Ref2VAのadaln_proj重みをFL2VAファイルへバイト単位でコピーし、補間は行いません。CPU上で数分でファイルをその場でパッチし、--backupで保存、--restoreで元に戻せ、結果はBLAKE2bハッシュで検証されます。
b40-49では軽すぎ、b25-49では重すぎと感じたときに便利です。b35-49を試して数本のクリップで判断し、気に入らなければ元に戻せばOK。スクリプトは両方をソースとして使うので、元のComfy-OrgのFL2VAとRef2VAのbf16ファイルは残しておきましょう。
リファレンスがしっかり効くプロンプトテンプレート
リファレンス用プロンプトは決まった順番で書くと効果的です。どのリファレンスが何かを示し、次に動作、カメラ、最後に音。リファレンスを重ねるほど、b20-49やb25-49のような範囲の広いファイルが活きてきます。以下のテンプレートは MiniMax H3 FL2VA Ref2VA ハイブリッド向けに書かれており、登場人物はすべて成人です。
ビーチで衣装チェンジ
参考画像1の女性が、参考画像2の赤いビキニを着て、ゴールデンアワーのビーチを歩く。ミディアムショット、カメラはゆっくり寄っていき、彼女は振り返って微笑む。波の音と柔らかなアコースティックギター。
同じキャラクター、新しいシーン
参考画像1と同じ男性が静かなカフェに座っている、横顔のクローズアップ。彼は小声で「遅かったね」と言う。自然な窓明かり、35mmフィルム調、カフェの低いざわめき。
ランウェイターン
参考画像1の成人モデルが、参考画像2の黒い水着とシアーなラップを身にまとい白いランウェイを歩き、立ち止まってゆっくりターンする。全身のトラッキングショット、光るカメラのフラッシュ、重低音のエレクトロビート。
繰り返し登場するセット
参考画像1のロフトで、参考画像2と3のカップルが夜の窓辺でスローダンスを踊る。ワイドショットから2ショットへゆっくり移動、街の灯り、柔らかなジャズ。
- リファレンスは添付した順番どおりに番号で呼ぶ。
- 1クリップにつき主な動作は1つ。4〜15秒はあっという間です。
- ほしい音を書く。セリフはかぎかっこで。
- あるリファレンスが無視され続けるなら、プロンプトを書き直す前にファイルを変える。
コミュニティの評価と正直な限界
MiniMax H3 FL2VA Ref2VA のアップロードの中で話題になっているのはsmhfacctのint8セットです。調査時点で約384いいね、14のディスカッションスレッド、そしてそれを使ったHugging Face Spacesが4つ。diobrando0のbf16ペアはより新しく控えめで、7いいね、日付は2026年9月1日です。どちらの作者も比較は目視で、正式なベンチマークはないと強調しているので、バージョン表は決まりごとではなく出発点の地図として扱ってください。
限界ははっきりしています。リファレンスなしのプロンプトではFL2VAを超えられず、ブロックの境界は実験で決められたもの、必要メモリも減りません。またMiniMaxの2Kリファイン工程はオープンソース化されていないため、ローカル出力はベース解像度のままです。
無修正H3ハイブリッド:変わること、変わらないこと
マージによって安全性トレーニングが削除・追加されることはありません。2つの公式チェックポイント間で変調層が移るだけです。体験を変えるのは実行場所です。MiniMaxのホスト型APIは性的・違法・権利侵害のコンテンツをフィルタリングしますが、自分のマシン上のオープンウェイトにはそうしたフィルター層が加わりません。だから成人向けクリエイターはローカルのH3を好みます。大きなGPUがなくても、ここの画像から動画ツールなら、写真1枚から成人向け(18+)シーンの同様のフィルターなしモーションを作れます。
キャラクター写真をブラウザで18+動画クリップに。
画像から動画を開くオンラインで生成:Spicy AIのセットアップ不要な代替ツール
66GBのワークステーションを持っている人も、チェックポイントを使い分ける手間をかけたい人も多くはありません。Spicy AIでは同じタイプのクリップを作れるオンラインの代替ジェネレーターを用意しています。キャラクター写真をアップロードし、動き・カメラ・音を書くだけで、ブラウザ上で短い動画が完成します。ダウンロードもドライバーも不要で、成人(18歳以上)向けシーンにもコンテンツフィルターはかかりません。
長いローカルレンダーの前の試し撮り、スマホだけで制作するクリエイター、とにかく結果が欲しい人に向いています。成人キャラクターのはっきりした写真を1枚用意し、1クリップにつきメインの動きは1つに絞り、毎話同じ写真を使えば顔と衣装が見分けやすいまま続きます。
オンラインの画像から動画ジェネレーターを試す →よくある質問
FL2VAとRef2VAの違いは?
FL2VAはテキストと最大2枚の最初・最後のフレームから音声付き動画を作ります。Ref2VAはテキストと、最大9枚の画像・3本の動画・3本の音声のリファレンスパックを使います。コミュニティのテスターによれば、映像と音声はFL2VAのほうが上です。
MiniMax H3 FL2VA Ref2VA ハイブリッドはMiniMaxが作ったもの?
いいえ。smhfacct(int8)とdiobrando0(bf16)がHugging Faceで公開しているコミュニティマージです。どちらも実験的で、目視で評価したものだとしています。
最初にダウンロードすべきハイブリッドファイルは?
int8セットならb25-49、bf16セットならb45-49から始めましょう。リファレンスが無視されるなら範囲の広いものへ、品質が落ちるなら狭いものへ移ってください。
ハイブリッドに必要なVRAMは?
作者は、MiniMax H3 FL2VA Ref2VA ファイルは対応するFL2VAファイルと同等だとしか述べていません。bf16ファイルは約66.28 GB、int8ファイルはそれより小さく、公式のメモリ要件はありません。
高速化できる?
はい。ref2v turbo 4ステップLoRAが使えるので素早く下書きでき、最終レンダリングはLoRAなしのフルステップでいつでも実行できます。
出典
ほかの無修正AI動画モデル
- 無修正 MiniMax H3
- 無修正 MiniMax H3 Max
- 無修正 Kling
- 無修正 Kling 2.6
- 無修正 Kling O1
- 無修正 Sora
- 無修正 Veo
- 無修正 Hailuo AI
- 無修正 Wan
- 無修正 Wan 3.0
- 無修正 Seedance
- 無修正 Seedance 2.5
- 無修正 Seedance 2.0
- 無修正 Seedance 2.0 Mini
- 無修正 HunyuanVideo
- 無修正 LTX Video
- 無修正 Runway
- 無修正 Pika
- 無修正 Luma Dream Machine
- 無修正 Vidu
- 無修正 PixVerse
- 無修正 EdenLive
- 無修正 Grok Imagine
- 無修正 AI Avatars
- 無修正 HappyHorse 1.0
- 無修正 Kling 4.0
- 無修正 Kling 3.0
- 無修正 MiniMax H3 RefMods
- 無修正 Kandinsky 6.0
MiniMaxおよびH3は各権利者の商標です。ハイブリッドファイルはコミュニティによる制作物です。すべてのコンテンツは成人(18+)を描写したものでなければなりません。