Ảnh AI không kiểm duyệt · OpenMOSS
MOSS-Image không kiểm duyệt: trọng số mở đặt chữ đúng nơi bạn muốn
MOSS-Image là mô hình tạo ảnh từ văn bản khoảng 5 tỷ tham số của nhóm OpenMOSS, phát hành kèm trọng số mở vào ngày 16 tháng 10 năm 2026. Điểm mạnh nổi bật của nó là chữ thật sự đọc được: tiêu đề tiếng Trung và tiếng Anh, ghi chú viết tay và nhãn đều hiện ngay trong ảnh, còn chế độ bố cục JSON cho phép bạn ghim từng tiêu đề, sản phẩm hay logo vào đúng tọa độ. Vì trọng số chạy trên GPU của chính bạn mà không có bộ lọc trực tuyến, các checkpoint tải về chính là MOSS-Image không kiểm duyệt mà cộng đồng sáng tạo chạy cục bộ đang bàn tán.
- Bắt đầu miễn phí
- Không bộ lọc
- Chạy trên trình duyệt
Công cụ tạo ảnh không kiểm duyệt thay thế MOSS-Image
Văn bản thành ảnhMô tả bức ảnh bạn muốn, đặt các từ cần hiện trong dấu ngoặc kép. Thêm ảnh tham chiếu để chỉnh sửa, hoặc để trống để tạo ảnh từ văn bản.
Thử một prompt
Các prompt mẫu viết bằng tiếng Anh, cho kết quả ổn định nhất.
Vì sao nhà thiết kế và người bán hàng chú ý
Hãy xem MOSS-Image là một trình tạo ảnh mở cuối cùng cũng coi chữ là một phần của bức ảnh. Gõ tiêu đề, giá tiền hay một mẩu ghi chú trong dấu ngoặc kép, chữ sẽ hiện rõ ràng trong ảnh, bằng tiếng Anh hoặc tiếng Trung, đúng vị trí bố cục yêu cầu. Chỉ một khả năng đó đã biến món đồ chơi thú vị thành công cụ mà cửa hàng, studio và đội mạng xã hội thật sự dùng được cho công việc. Trọng số được tải miễn phí và chạy trên GPU của bạn, nên không tốn phí cho mỗi ảnh và không có bộ lọc trực tuyến nào chen giữa prompt và kết quả.
Chữ tiếng Trung và tiếng Anh dễ đọc ngay trong ảnh
Phần lớn mô hình tạo ảnh mã nguồn mở vẫn làm méo chữ, và chữ Hán chịu thiệt nhiều nhất. MOSS-Image được huấn luyện để hiển thị cả hai ngôn ngữ, và các mẫu chính thức tận dụng điều đó: tờ giấy viết tay bằng tiếng Trung dán trên tủ lạnh với danh sách mua sữa, trứng và bánh mì, bảng trắng kín ghi chú, biển hiệu cửa hàng và tiêu đề poster. Bí quyết rất đơn giản: đặt chính xác những từ bạn muốn trong dấu ngoặc kép và nói rõ chúng nằm ở đâu, trông ra sao, ví dụ "a bold red headline reading \"SUMMER SALE\" across the top". Cụm từ ngắn cho kết quả sạch hơn đoạn văn dài, và trong các so sánh chính thức, checkpoint SFT nhóm và căn chỉnh chữ gọn gàng hơn Base.
- Đặt mọi từ bạn muốn in ra trong dấu ngoặc kép, bằng đúng ngôn ngữ bạn cần.
- Mô tả bề mặt: giấy nhớ, biển neon, bảng phấn, bìa tạp chí.
- Nêu kiểu chữ: viết tay, sans-serif đậm, thư pháp bút lông.
- Giữ mỗi khối chữ thật ngắn; chia nội dung dài thành nhiều mục có nhãn.
Thế mạnh: poster, banner cửa hàng và infographic
Vì chữ và vị trí là thế mạnh, mô hình này hợp với những việc mà chỉ một bức ảnh đẹp là chưa đủ. Người bán hàng online dựng banner sản phẩm có nhãn giá ở góc, người quản lý mạng xã hội phác thảo ảnh bìa với tiêu đề song ngữ, còn người làm phim ngắn và truyện tranh mạng phác họa poster, khung truyện với lời thoại đặt sẵn. Giáo viên và người làm marketing dùng nó cho bảng trắng giải thích và infographic, nhà hàng dùng cho thực đơn và biển hiệu, còn đội ngũ thương hiệu dùng để tạo hàng loạt bố cục đồng bộ chỉ đổi tiêu đề.
| Tình huống | Bạn yêu cầu gì | Vì sao hiệu quả |
|---|---|---|
| Banner cửa hàng | Sản phẩm ở giữa, tiêu đề phía trên, nhãn ở một góc | Khung JSON giữ mọi thành phần đúng chỗ bạn đã định |
| Ảnh bìa mạng xã hội song ngữ | Tiêu đề tiếng Trung kèm phụ đề tiếng Anh | Cả hai hệ chữ đều hiển thị dễ đọc |
| Poster phim hoặc truyện tranh | Nhân vật, khẩu hiệu và bong bóng thoại | Prompt dài chứa được nhiều chi tiết cùng lúc |
| Bảng trắng giải thích | Các bước viết tay và hình vẽ đơn giản | Kiểu chữ viết tay trông tự nhiên |
| Thực đơn hoặc biển hiệu | Tên món và giá theo từng dòng | Dòng chữ ngắn luôn sắc nét |
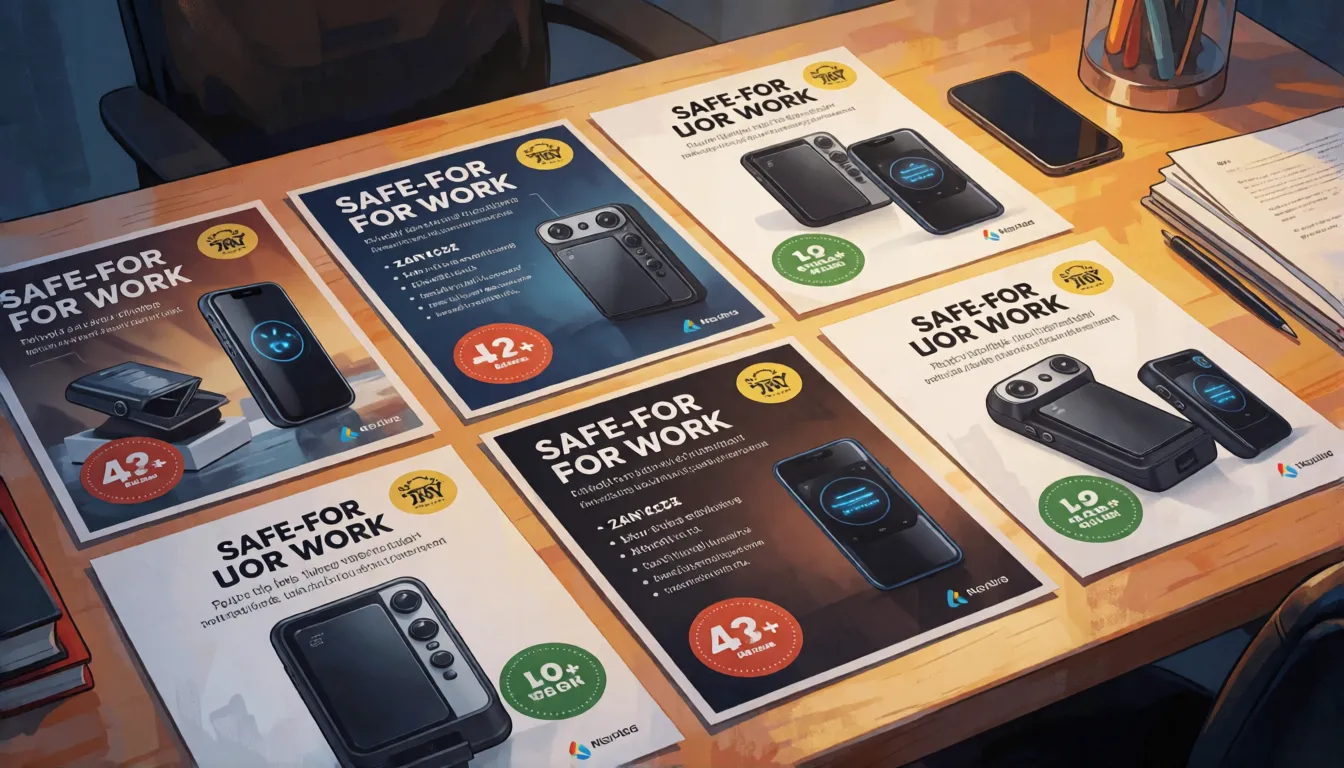
Biến nó thành công việc kinh doanh: banner, thực đơn và thử nghiệm quảng cáo
Người hưởng lợi nhiều nhất là các nhóm nhỏ cần thật nhiều hình có chữ, thật nhanh. Một cửa hàng online có thể phác thảo banner khuyến mãi cho cả tuần chỉ trong một buổi chiều, mỗi tấm có sản phẩm ở giữa, mức giảm giá trong nhãn dán và tiêu đề song ngữ. Các agency dùng cùng một bố cục JSON để tạo hàng chục phiên bản quảng cáo chỉ khác khẩu hiệu, giúp thử nghiệm A/B rẻ hơn hẳn. Quán cà phê và nhà hàng dựng thực đơn, bảng món đặc biệt, tiệm in nhận làm poster theo yêu cầu, còn studio truyện tranh và phim ngắn phác bìa với tiêu đề đã đặt sẵn trước khi nhà thiết kế hoàn thiện.
| Ai | Làm gì | Vì sao có lợi |
|---|---|---|
| Cửa hàng online | Banner khuyến mãi hằng tuần và nhãn giá | Bố cục giữ nguyên, chỉ đổi chữ |
| Agency quảng cáo | Nhiều phiên bản khẩu hiệu để thử A/B | Cùng JSON, chữ mới trong vài giây |
| Nhà hàng hoặc quán cà phê | Thực đơn, bảng món, poster cửa kính | Dòng chữ ngắn luôn sắc nét |
| Studio truyện tranh hoặc phim | Bản phác bìa có tiêu đề và câu slogan | Bớt nhiều vòng dàn trang |
| Nhà thiết kế tự do | Mockup cho khách trước bản cuối | Bản nháp đầu nhanh hơn |
Cộng đồng nói gì và mọi người đang tạo gì
Trên Civitai, nơi nhà sáng tạo chia sẻ ảnh và mô hình, các bình luận đầu tiên phần lớn tích cực. Một người dùng gọi nó là một trong những mô hình mở giàu kiến thức nhất cho ảnh chân thực và khen khả năng xử lý cả phong cách anime lẫn ảnh chụp. Số khác chỉ ra điểm yếu: tay và chân đôi khi bị sai, tag phong cách theo tên họa sĩ gần như không có tác dụng, và thiết lập mặc định chậm; một người kể mất hơn 100 giây mỗi ảnh cho đến khi một LoRA turbo của cộng đồng rút xuống còn khoảng một phần mười, đổi lại da hơi mịn hơn. Mười ngày sau khi ra mắt, kho GitHub có khoảng 1,9 nghìn sao và trang mô hình Base có 556 lượt thích. Mọi người đăng gì? Poster du lịch retro giả, bìa tạp chí song ngữ, ghi chú dán tủ lạnh và bảng trắng viết tay, meme có sẵn chữ, bảng thiết kế nhân vật anime kèm tên và bộ ảnh biển quyến rũ với người mẫu trưởng thành.
- Poster du lịch và phim phong cách retro với tiêu đề lớn dễ đọc
- Bìa tạp chí và mạng xã hội song ngữ Trung-Anh
- Ghi chú, hóa đơn và trò đùa bảng trắng viết tay làm meme
- Bảng nhân vật anime có in tên và chỉ số bên cạnh
- Bộ ảnh đồ bơi và pin-up của người mẫu trưởng thành với chữ kiểu tạp chí
Ví dụ prompt MOSS-Image để sao chép
Mô hình hiểu ba kiểu prompt, mỗi kiểu hợp với một mục đích. Câu văn tự nhiên tốt nhất cho ảnh chụp và poster, danh sách tag quen thuộc với người dùng anime và LoRA cộng đồng, còn JSON dành cho bố cục chặt chẽ. Hãy bắt đầu từ các mẫu này, giữ cố định seed và mỗi lần chỉ đổi một chi tiết:
- Ngôn ngữ tự nhiên: "A cozy kitchen at morning, a handwritten note on the fridge reading \"milk, eggs, bread\", warm sunlight, photorealistic."
- Poster: "Retro travel poster of a seaside town, large title \"VISIT CAPRI\" at the top in cream serif letters, grainy print texture."
- Tag: "adult woman, beach, sunset, bikini, film grain, 35mm, golden hour" (chỉ nhân vật trưởng thành).
- Infographic: "Clean whiteboard with three numbered steps titled \"How to brew coffee\", simple marker drawings, flat lighting."
- Bìa song ngữ: "Magazine cover, Chinese headline in bold brush strokes, English subtitle \"Night Market Guide\" below, neon street at night."
Prompt bố cục JSON: ghim tiêu đề và sản phẩm theo tọa độ
Chế độ JSON là điều làm mô hình này khác biệt. Thay vì cầu mong tiêu đề nằm ở trên cùng, bạn mô tả toàn cảnh trong phần tóm tắt rồi liệt kê các mục, mỗi mục có nhãn, mô tả, khung bao và chữ tùy chọn. Khung dùng thứ tự yxyx (trên, trái, dưới, phải) theo tọa độ pixel tính từ tâm khung hình, nên với ảnh 1024 x 1024 mỗi trục chạy từ -512 đến 512, và các con số phải khớp với kích thước bạn tạo. OpenMOSS vẫn gọi tính năng bố cục là thử nghiệm, nên hãy chuẩn bị chỉnh lại một hai khung. Khung mẫu để bắt đầu:
{
  "summary": { "caption": "Bright summer shop banner, white studio background" },
  "items": [
    { "label": "title", "caption": "bold red headline", "bbox": [-460, -400, -300, 400], "text": "SUMMER SALE" },
    { "label": "product", "caption": "glass bottle of iced lemon tea", "bbox": [-220, -200, 380, 200] },
    { "label": "badge", "caption": "yellow round sticker", "bbox": [260, 260, 460, 460], "text": "-50%" }
  ],
  "bbox_format": "yxyx",
  "bbox_coord_space": "abs_centralized"
}
Tên trường theo hướng dẫn bố cục trong kho GitHub chính thức; skill Prompt Enhancer chính thức cũng có thể mở rộng một câu thành mô tả chi tiết hoặc bố cục.
MOSS-Image có không kiểm duyệt không? LoRA NSFW và ảnh người lớn
Khi chạy cục bộ, trọng số mở không có bộ lọc trực tuyến: không có gì kiểm tra prompt hay ảnh đầu ra, nên bạn quyết định mô hình vẽ gì. OpenMOSS chưa phát hành checkpoint NSFW và không mô tả cách lọc dữ liệu huấn luyện, nên chi tiết khiêu dâm phụ thuộc vào các tiện ích bổ sung của cộng đồng. Một báo cáo gián tiếp từ AlphaSignal cho biết một "Moss-image-nsfw-uncensored-lora" với từ kích hoạt moss_xvstyle đã xuất hiện chỉ sau vài ngày và hoạt động với cả Base và SFT; thông tin này chưa được xác nhận trên trang Hugging Face hay Civitai, nên hãy thận trọng. Các hướng nội dung người lớn phổ biến là bộ ảnh đồ bơi và nội y, poster pin-up và ảnh bìa giả tưởng với nhân vật rõ ràng đã trưởng thành. Nếu không muốn cài đặt GPU, Spicy AI cung cấp khả năng tạo ảnh không kiểm duyệt tương tự ngay trên trình duyệt.
Bộ ảnh bikini và đồ bơi
Buổi chụp bãi biển và hồ bơi ngập nắng với người mẫu trưởng thành, có tiêu đề tạp chí phía trên.
Poster pin-up và boudoir
Ảnh pin-up người lớn phong cách retro và bộ ảnh nội y với dòng khẩu hiệu đặt đúng chỗ.
Ảnh bìa giả tưởng
Anh hùng và nữ phù thủy trưởng thành cho bìa sách hoặc game với tiêu đề dễ đọc.
- Viết những từ bạn muốn trong dấu ngoặc kép và nói rõ chúng đặt ở đâu.
- Dùng tag cho ngoại hình nhân vật và câu hoàn chỉnh cho ánh sáng, không khí.
- Cố định seed và mỗi lần chạy chỉ đổi một chi tiết.
- Nêu rõ mọi người trong ảnh đều là người trưởng thành (18+), và không bao giờ mô tả người thật khi chưa có sự đồng ý.
Tạo ảnh người lớn không bộ lọc, không cần GPU hay tải về.
Mở công cụ tạo ảnh →
SFT hay Base: nên chọn checkpoint nào
Hai checkpoint dùng chung kiến trúc 5B nhưng được tinh chỉnh cho những người dùng khác nhau. SFT được tinh chỉnh có giám sát trên dữ liệu chọn lọc, và ảnh so sánh chính thức cho thấy chữ được nhóm gọn hơn, bố cục trang sạch hơn, nên đây là lựa chọn khi bạn chỉ muốn có ảnh đẹp. Base bỏ qua bước hậu huấn luyện đó và gần với mô hình gốc hơn, nên là điểm khởi đầu tốt hơn cho LoRA và tinh chỉnh toàn phần.
| SFT | Base | |
|---|---|---|
| Phù hợp nhất cho | Tạo ảnh trực tiếp | Tinh chỉnh và huấn luyện LoRA |
| Chữ và bố cục | Nhóm gọn hơn trong mẫu chính thức | Đầu ra lỏng hơn, thô hơn |
| Huấn luyện | Được cả hai công cụ huấn luyện hỗ trợ | Điểm khởi đầu được khuyên dùng |
Cách chạy: Hugging Face, ComfyUI, diffusers và API
Có bốn cách dễ dàng. Thử nhanh nhất là Hugging Face Space miễn phí của OpenMOSS-Team. Để chạy cục bộ, ComfyUI hỗ trợ mô hình sẵn trên các bản nightly hiện tại, dùng các tệp đóng gói lại từ Comfy-Org với các loader tích hợp, còn plugin trong kho chính thức vẫn hữu ích để tải thư mục diffusers. Lập trình viên có thể nạp trọng số trong diffusers 0.38 trở lên với pipeline_moss_image tùy chỉnh và trust_remote_code, trên Python 3.10+ và PyTorch 2.9+ với GPU NVIDIA. Nhóm nào không muốn tự lưu trữ có thể gọi qua nền tảng MOSI API.
- Lấy mẫu mặc định: 50 bước, CFG 3, shift 5, flow-matching Euler.
- Chiều rộng và chiều cao phải là bội số của 16; ví dụ chính thức dùng 1024x1024 và 1456x1456.
- Guidance chạy hai lượt mỗi bước, nên sẽ chậm hơn các mô hình chưng cất.
- Một phiên bản chưng cất DMD 8 bước từ cộng đồng đổi một chút chất lượng lấy bản nháp nhanh hơn nhiều.
VRAM, tốc độ và bản lượng tử hóa
OpenMOSS không công bố mức VRAM tối thiểu. Thay vào đó, bản demo Gradio có ba chế độ bộ nhớ: GPU resident giữ mọi thứ trên card để đạt tốc độ, Component chuyển các phần giữa CPU và GPU, còn Sequential là phương án tiết kiệm bộ nhớ nhưng chạy chậm nhất. Nếu gặp lỗi hết bộ nhớ, hãy chuyển sang Sequential, giảm độ phân giải hoặc thử tệp lượng tử hóa. Hugging Face liệt kê 13 bản lượng tử hóa của mô hình Base do cộng đồng tạo; hãy xem model card của từng bản để biết định dạng, như GGUF hay FP8, và loader cần dùng, vì chất lượng và mức hỗ trợ khác nhau giữa các tệp.
Huấn luyện phong cách riêng với KohakuMossTrainer
Tinh chỉnh là lúc trọng số mở phát huy giá trị. KohakuMossTrainer, ra mắt hai ngày sau khi phát hành, hỗ trợ tinh chỉnh toàn phần và adapter LyCORIS hoặc LoRA cho cả hai checkpoint, và README cho biết adapter có thể huấn luyện chỉ với 6GB VRAM. DiffSynth-Studio cũng hỗ trợ tinh chỉnh toàn phần và LoRA. Chỉ trong mười ngày, Hugging Face đã ghi nhận 41 adapter và 36 bản tinh chỉnh dựa trên mô hình Base, từ phong cách nghệ thuật đến các bản sửa lỗi như một DeBand LoRA cộng đồng giúp làm mượt hiện tượng dải màu. Hãy huấn luyện trên Base, viết caption cùng phong cách với prompt bạn sẽ dùng, và đưa vào phần chữ bạn muốn LoRA học.
So sánh với FLUX.2, Qwen-Image và Z-Image
Chưa có benchmark chính thức nào đặt các mô hình này cạnh nhau, vì vậy hãy xem đây là so sánh thực tế chứ không phải bảng điểm. Khác biệt rõ ràng nằm ở kích thước, khả năng điều khiển bố cục và chỉnh sửa:
| MOSS-Image | FLUX.2 dev | Qwen-Image | Z-Image | |
|---|---|---|---|---|
| Kích thước | Khoảng 5B | 32B | 20B | 6B |
| Prompt bố cục theo tọa độ | Có, khung JSON | Không | Không | Không |
| Chỉnh sửa ảnh / ảnh tham chiếu | Không | Có | Mô hình chỉnh sửa riêng | Mô hình chỉnh sửa riêng |
| Hệ sinh thái hiện tại | Mới, phát triển nhanh | Lớn | Lớn | Lớn |
Kích thước lấy từ ghi chú phát hành công khai của từng mô hình; mô hình này chưa công bố benchmark định lượng nào.
Tự triển khai MOSS-Image so với tạo ảnh trực tuyến trên Spicy AI
| Triển khai cục bộ (trọng số chính thức) | Spicy AI trực tuyến | |
|---|---|---|
| Bộ lọc nội dung | Không có khi chạy cục bộ | Không có bộ lọc nội dung |
| Trọng số mở | Có | Không cần — chạy trên trình duyệt |
| Mô hình | Checkpoint Base hoặc SFT | Mô hình tạo ảnh không kiểm duyệt tương tự, lưu trữ trực tuyến |
| Chi phí ban đầu | GPU của riêng bạn | Có gói miễn phí |
Câu hỏi thường gặp
Mọi người dùng nó để tạo gì nhiều nhất?
Dẫn đầu là poster, banner cửa hàng và ảnh bìa mạng xã hội có tiêu đề dễ đọc, tiếp theo là meme có sẵn chú thích, bảng trắng giải thích và bộ ảnh quyến rũ với người mẫu trưởng thành.
Nó có chỉnh sửa ảnh hoặc dùng ảnh tham chiếu được không?
Chưa. Đây chỉ là mô hình tạo ảnh từ văn bản; chỉnh sửa và ảnh tham chiếu không nằm trong bản phát hành.
Nó có hỗ trợ chữ tiếng Trung không?
Có. Nó hiển thị cả tiếng Trung và tiếng Anh, và đặt chính xác các từ trong dấu ngoặc kép cho chữ đáng tin cậy nhất.
Tôi cần bao nhiêu VRAM?
Không có con số chính thức. Bản demo có chế độ Sequential tiết kiệm bộ nhớ, có các tệp lượng tử hóa từ cộng đồng, và adapter LoRA có thể huấn luyện với khoảng 6GB.
Dùng nó trong ComfyUI như thế nào?
Cập nhật lên bản nightly hiện tại, vốn hỗ trợ sẵn mô hình, rồi tải các tệp đóng gói lại của Comfy-Org bằng loader tích hợp.
Spicy AI có liên kết với OpenMOSS không?
Không. Spicy AI là nền tảng độc lập, không liên kết và không được OpenMOSS bảo trợ. Tên mô hình là nhãn hiệu của chủ sở hữu tương ứng.
Nguồn tham khảo
- Model card mô hình Base (Hugging Face)
- Model card mô hình SFT (Hugging Face)
- Kho OpenMOSS và hướng dẫn bố cục (GitHub)
- Báo cáo kỹ thuật (arXiv 2610.23374)
- Demo trực tuyến chính thức (Hugging Face Space)
- Trọng số định dạng ComfyUI (Comfy-Org)
- Bình luận cộng đồng (lưu trữ Civitai)
- Báo cáo về LoRA NSFW cộng đồng (AlphaSignal, chưa xác minh)