Giọng nói thành video · Trọng số mở
Kandinsky S2V 1.0 Pro không kiểm duyệt: Khiến mọi bức ảnh biết nói, cử chỉ và ca hát
Kandinsky S2V 1.0 Pro chỉ cần ba thứ đơn giản: một bức ảnh, một bản ghi âm người đang nói và một mô tả cảnh ngắn, rồi trả về video trong đó người ấy nói với khẩu hình khớp tiếng, cử động tay và vai, và giữ đúng nhân vật từ giây đầu đến giây cuối. Mô hình đến từ Kandinsky Lab, đội ngũ đứng sau Kandinsky 5.0 và 6.0, và trọng số được tải về miễn phí. Hướng dẫn này cho thấy nhà sáng tạo dùng nó vào việc gì, điều gì khiến kết quả trông tự nhiên, phiên bản nào hợp với GPU của bạn, các prompt sẵn để sao chép và so sánh với các mô hình avatar biết nói mã nguồn mở khác.
- Ảnh + giọng nói → video
- Toàn thân, không chỉ khuôn mặt
- 25 fps, độ dài tùy ý
- Phiên bản nhanh 16 bước
Trình tạo video thay thế không kiểm duyệt
Ảnh thành videoGiống như Kandinsky S2V 1.0 Pro, công cụ này bắt đầu từ một bức chân dung: tải ảnh lên, mô tả người trong ảnh sẽ chuyển động thế nào và khung cảnh trông ra sao, chúng tôi sẽ mở studio chuyển ảnh thành video với mọi thông tin đã điền sẵn. Chủ đề người lớn được chào đón khi tất cả nhân vật xuất hiện đều từ 18 tuổi trở lên.
Một bức ảnh, một đoạn giọng nói, cả một màn trình diễn
Hầu hết công cụ ảnh biết nói chỉ làm chuyển động khuôn mặt: miệng mở ra khép lại trong khi phần còn lại của bức ảnh đứng yên. Kandinsky S2V 1.0 Pro hoạt động khác. Bạn đưa vào một ảnh tham chiếu, một bản ghi giọng nói sạch (16 kHz mono) và một prompt văn bản, mô hình sẽ tạo video 25 fps trong đó cả con người trở nên sống động. Đôi môi theo sát từng âm tiết, đôi tay làm những cử chỉ mà người ta hay dùng khi giải thích, và hậu cảnh chuyển động đúng như prompt mô tả. Kết quả giữ nguyên tỷ lệ khung hình của ảnh và mang theo bản âm thanh gốc của bạn, nên clip có thể đăng ngay.
Độ dài cũng không cố định. Kandinsky S2V 1.0 Pro làm việc theo các khối năm giây gồm 125 khung hình, mỗi khối mới tiếp nối đúng chỗ khối trước dừng lại, vì vậy một đoạn lồng tiếng hai phút sẽ thành video hai phút của cùng một người. Khẩu hình là điều người xem chú ý đầu tiên: mỗi khung hình chỉ lắng nghe đúng lát âm thanh của riêng nó, nên hình miệng rơi đúng vào âm cần phát thay vì trễ dần phía sau.
Nơi video biết nói từ một bức ảnh đang bùng nổ
Avatar điều khiển bằng giọng nói đã đi từ các bản demo công nghệ vào công việc sản xuất nội dung hằng ngày, và Kandinsky S2V 1.0 Pro hòa nhập ngay vào đó. Những công việc dưới đây là những gì gói nghiên cứu và cộng đồng nhà sáng tạo nhắc đến nhiều nhất, và tất cả đều chung một nhu cầu: một người đáng tin trên màn hình nói chính xác những gì âm thanh của bạn nói, mà không cần thuê studio hay người dẫn.
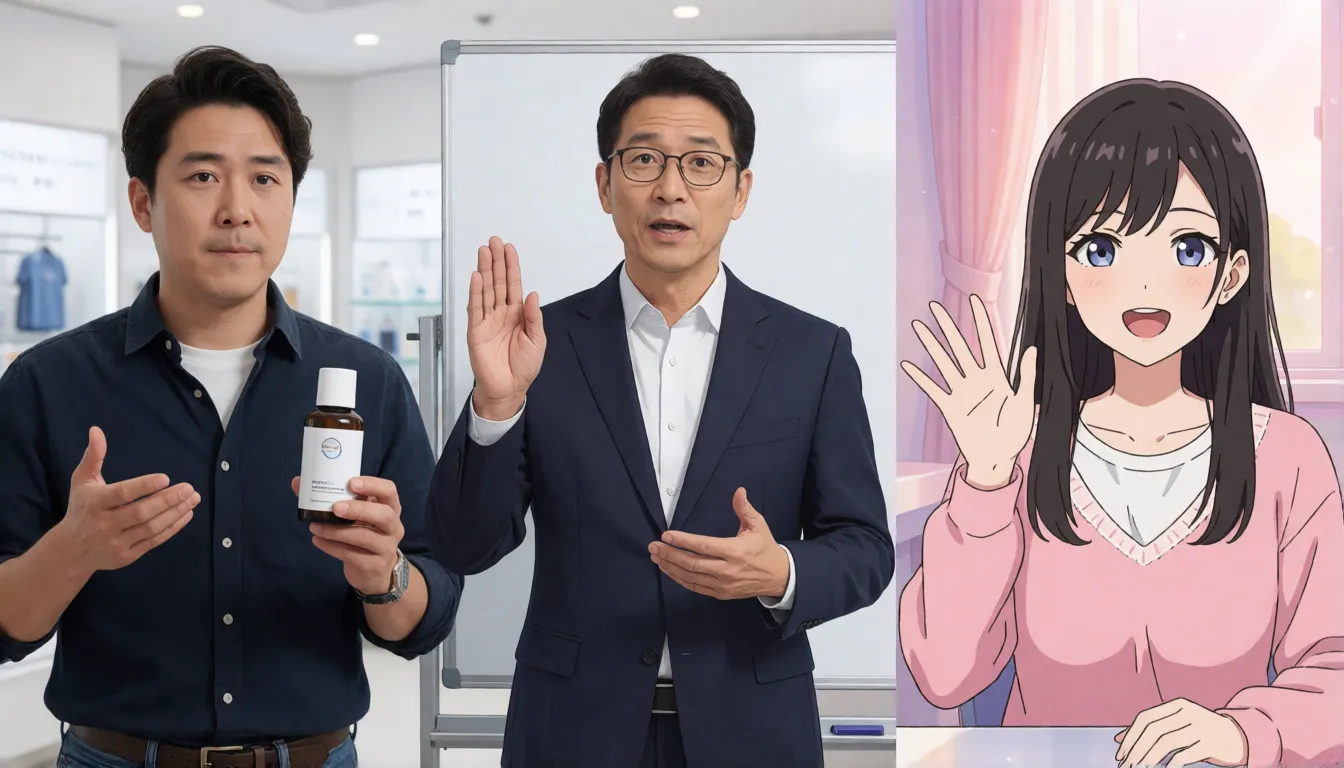
- Phim ngắn và truyện tranh hoạt hình: gán cho mỗi chân dung nhân vật đoạn thoại của nó và nhận các cảnh hội thoại toàn thân có cảm giác như phân cảnh thật, không phải sticker.
- Clip sản phẩm và bán hàng livestream: một ảnh người mẫu cộng với bản ghi âm giới thiệu sản phẩm sẽ thành video giải thích kiểu người dẫn chỉ trong vài phút.
- Khóa học, điểm tin và đào tạo: biến kịch bản thuyết minh thành bài giảng dài với một giáo viên ảo liên tục cử chỉ suốt nhiều phút.
- Streamer ảo và bạn đồng hành AI: ghép ảnh nhân vật với giọng chuyển văn bản thành giọng nói, nhân vật sẽ đáp lời trước ống kính.
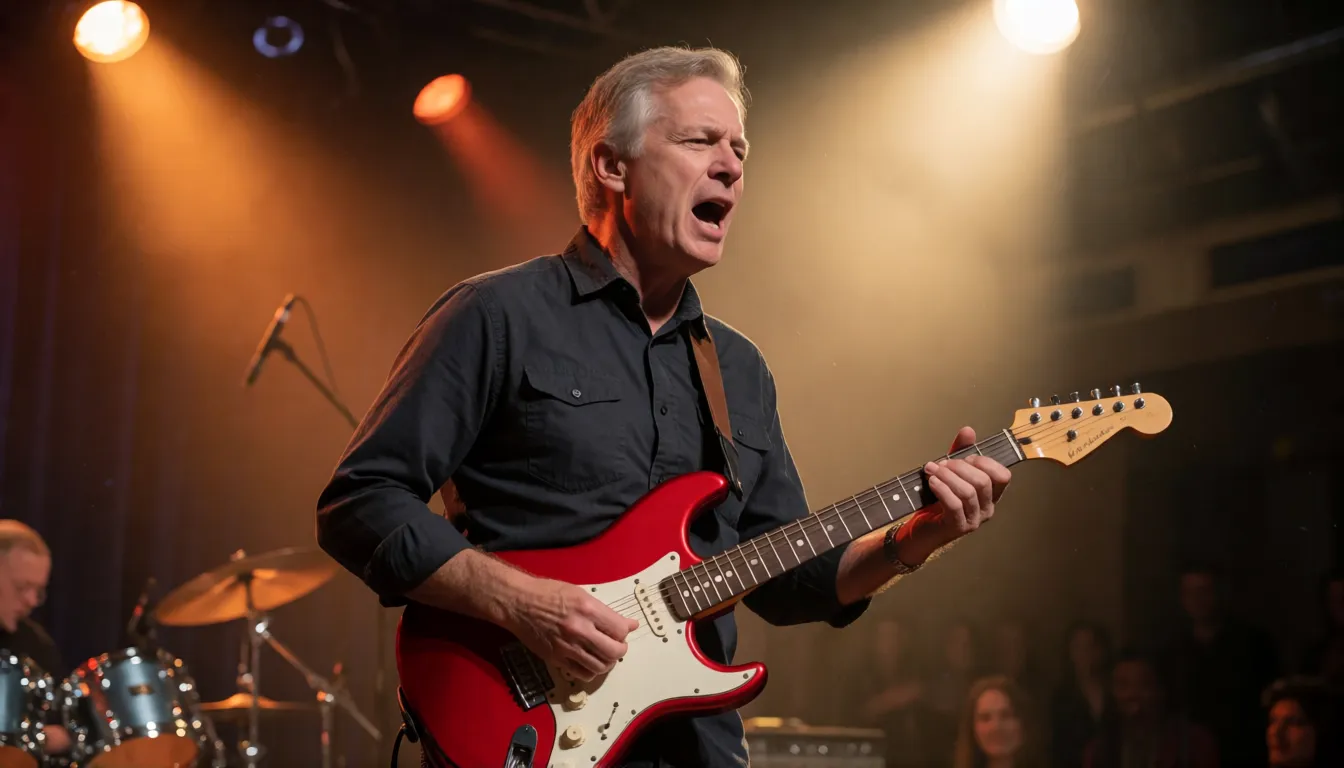
- Âm nhạc và podcast: ví dụ Diffusers chính thức là một người đàn ông tóc bạc chơi guitar điện màu đỏ, gợi ý rằng clip biểu diễn hoàn toàn khả thi (chất lượng giọng hát chưa được đội ngũ đánh giá).
- Lồng tiếng đa ngôn ngữ: giữ một bức ảnh và thay các bản âm thanh bằng nhiều ngôn ngữ khác nhau; chú thích huấn luyện là tiếng Anh và tiếng Nga, nên hãy thử các ngôn ngữ khác trước khi làm dự án lớn.
Hội thoại phim ngắn
Gán cho mỗi chân dung nhân vật câu thoại của nó và Kandinsky S2V 1.0 Pro trả về các cảnh toàn thân với khẩu hình chính xác.
Video giới thiệu sản phẩm
Một ảnh người mẫu và một bản ghi âm giới thiệu trở thành clip kiểu người dẫn cho cửa hàng và bán hàng livestream.
Người dẫn ảo
Ghép ảnh nhân vật với giọng TTS cho streamer, giáo viên và bạn đồng hành AI biết đáp lời.
Điều gì khiến kết quả trông tự nhiên
Ba lựa chọn thiết kế tách biệt Kandinsky S2V 1.0 Pro khỏi vô số công cụ khớp khẩu hình trước đây. Thứ nhất, đây là hoạt ảnh toàn thân: mô hình xuất phát từ Kandinsky 5.0 Video nên đã hiểu cách cơ thể, quần áo và khung cảnh chuyển động, và prompt có thể điều khiển cử chỉ lẫn bối cảnh. Thứ hai, nó hiểu cả lời nói lẫn giọng nói: Qwen2.5-Omni đọc prompt văn bản và nghe giọng nói ở tốc độ 25 token mỗi giây, giúp chuyển động khớp với năng lượng của cách nói. Thứ ba, bộ nhớ ba cấp mang diện mạo của ảnh tham chiếu từ khối này sang khối khác, nên khuôn mặt và trang phục luôn nhất quán trong các cảnh quay dài.
Kandinsky S2V 1.0 Pro còn có phiên bản chưng cất. Pro distill đạt kết quả trong 16 bước thay vì 50 và tích hợp guidance thẳng vào trọng số; theo đội ngũ, tốc độ nhanh hơn khoảng năm lần (từ 4,5× đến 5,6× tùy cấu hình) trong khi ngang bằng mô hình gốc ở hầu hết các chỉ số. Trong nghiên cứu đánh giá của con người trong bài báo, so với baseline mở mạnh nhất và hai dịch vụ thương mại, Kandinsky S2V 1.0 Pro trung bình được đánh giá ngang bằng hoặc tốt hơn, trong đó khẩu hình là khía cạnh được ưa chuộng nhất.
- Chuyển động toàn thân và điều khiển khung cảnh bằng prompt văn bản
- Khẩu hình chính xác từng khung hình nhờ attention âm thanh theo từng khung
- Không giới hạn cứng về độ dài nhờ tiếp nối theo từng khối
- Trọng số mở theo giấy phép MIT, chạy cục bộ
- Cần GPU 48 GB cho mô hình Pro (80 GB cho HD)
- Không tạo âm thanh, bạn phải tự cung cấp giọng nói hoặc TTS
- Chưa có bản lượng tử hóa chính thức cho card 24 GB
- Chế độ HD chưa được huấn luyện hay đánh giá ở độ phân giải đó
Lite hay Pro, Base hay Distill: Chọn phiên bản phù hợp
Kandinsky S2V 1.0 Pro thuộc một họ gồm bốn checkpoint. Các mô hình Lite 2B là lựa chọn nhanh và nhẹ hơn; các mô hình Pro 21B cho khuôn mặt, bàn tay và chuyển động đẹp nhất. Trong mỗi kích thước, phiên bản chưng cất là lựa chọn dùng hằng ngày, còn mô hình gốc 50 bước dành cho người muốn vắt kiệt từng chi tiết. Cả hai checkpoint Pro cũng có thể chạy cấu hình HD ở 1280×768.
| Phiên bản | Kích thước và số bước | Phù hợp cho | Tốc độ trên một H100 (mỗi giây video) |
|---|---|---|---|
| Lite 2B distill | 2B, chưng cất | Bản nháp nhanh, GPU nhỏ hơn | Khoảng 8,7 giây |
| Lite 2B | 2B, gốc | Chất lượng Lite không chưng cất | Chậm hơn Lite distill |
| Pro 21B distill | 21B, 16 bước | Cân bằng tốt nhất để dùng hằng ngày | Khoảng 41,5 giây (33,6 giây khi biên dịch) |
| Pro 21B | 21B, 50 bước | Độ trung thực tối đa, hỗ trợ prompt phủ định | Khoảng 189 giây |
| Pro distill HD | 21B, 1280×768 | Khung hình lớn hơn (chất lượng chưa kiểm chứng) | Khoảng 137 giây |
Bộ nhớ GPU và tốc độ: Những gì cần biết
Kandinsky S2V 1.0 Pro là một mô hình lớn, vì vậy hãy tính toán phần cứng trước khi tải về khoảng 65 GB tệp. Yêu cầu chính thức là một GPU có ít nhất 48 GB bộ nhớ (80 GB cho HD) và driver phiên bản 580 trở lên. Trên một H100, Pro distill ở độ phân giải tiêu chuẩn đạt đỉnh khoảng 46 GiB; HD đạt đỉnh khoảng 55 GiB. Do đó một clip mười giây mất khoảng sáu đến bảy phút trên một card, còn cấu hình tám GPU chính thức rút thời gian cho mỗi giây video xuống khoảng 11 giây.
Thiếu bộ nhớ? Bật VAE tiling sẽ hạ mức đỉnh xuống khoảng 28 GB, đổi lại là những đường nối mờ; cách dùng Diffusers với CPU offload đạt đỉnh gần 50 GiB, và mô hình Lite 2B distill là cách dễ nhất để thử nghiệm trên card nhỏ hơn. Thuê GPU đám mây trong một buổi chiều là giải pháp phổ biến cho card phổ thông 24 GB, vì hiện chưa có tệp lượng tử hóa chính thức.
Ba cách dùng thử: Demo trực tuyến, ComfyUI và Diffusers
Bạn không cần cài đặt gì để xem Kandinsky S2V 1.0 Pro làm được gì. Đội ngũ có một Space demo miễn phí trên Hugging Face, cùng các notebook Colab và Kaggle cho ai muốn kiểm soát nhiều hơn. Khi sẵn sàng tự chạy, hãy chọn cách phù hợp với quy trình làm việc quen thuộc của bạn.
- 1Trực tuyến: mở Space Kandinsky-S2V-1.0-Demo trên Hugging Face, tải lên một bức chân dung và một tệp WAV ngắn, thêm prompt rồi tạo video.
- 2Dòng lệnh: clone repo GitHub kandinsky-s2v, chạy uv sync, sau đó chạy uv run kandy-s2v generate với cấu hình s2v_pro_distill.yaml và các đường dẫn --audio, --image, --out của bạn; thêm --prompt và --seed để điều khiển và lặp lại kết quả.
- 3ComfyUI: chuyển sang nhánh dev/comfyui của repo, nơi có sẵn các node cho Lite distill và Pro distill, rồi nối ảnh, âm thanh và prompt vào sampler.
- 4Diffusers: cài diffusers từ nhánh main, tải kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers bằng ModularPipeline và đọc âm thanh ở 16 kHz.
Dù chọn cách nào, Kandinsky S2V 1.0 Pro luôn đáp lại tệp đầu vào tốt hơn bất kỳ thiết lập nào. Hãy ghi nhớ:
- Dùng ảnh sắc nét, chụp chính diện, trong đó người chiếm phần lớn khung hình; tỷ lệ khung hình của ảnh sẽ là tỷ lệ của video.
- Thu giọng nói sạch, không có nhạc nền, lưu dưới dạng âm thanh mono 16 kHz.
- Cố định --seed khi bạn ưng một kết quả, sau đó chỉ thay đổi prompt để khám phá các biến thể.
Mẫu prompt cho video biết nói
Trong Kandinsky S2V 1.0 Pro, prompt văn bản không chứa kịch bản; âm thanh của bạn mới làm việc đó. Hãy dùng prompt để mô tả con người, chuyển động, bối cảnh và máy quay, đồng thời giữ trang phục và hậu cảnh gần với ảnh tham chiếu để diện mạo không bị trôi. Các mẫu này bao quát những định dạng phổ biến nhất; hãy thay chi tiết và giữ nguyên cấu trúc.
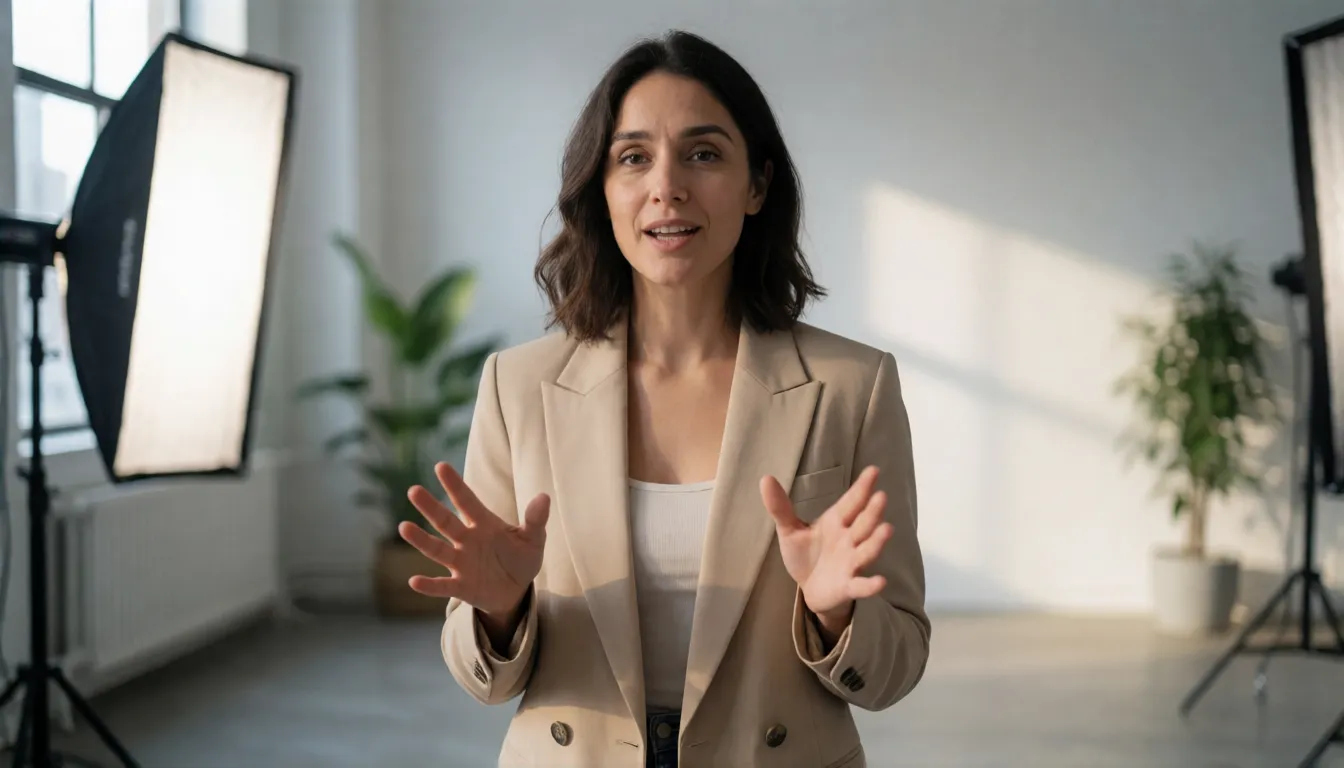
- Người dẫn chương trình: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
- Giới thiệu sản phẩm: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- Hội thoại phim: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- Nhạc sĩ: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- Giáo viên: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- Streamer ảo: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- Trò chuyện trên bãi biển (18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- Prompt phủ định (chỉ mô hình 50 bước): blurry face, distorted mouth, extra fingers, flickering, static body.
So sánh với Wan 2.2 S2V, InfiniteTalk và các avatar mã nguồn mở khác
Các mô hình avatar biết nói mã nguồn mở ngày càng nhiều, và mỗi mô hình có thế mạnh riêng so với Kandinsky S2V 1.0 Pro. Wan2.2-S2V-14B của Alibaba đã có tệp GGUF do cộng đồng làm, nên thân thiện hơn với GPU nhỏ. InfiniteTalk và MultiTalk tập trung vào video rất dài và hội thoại nhiều người. LongCat-Video-Avatar 1.5 cũng có bản GGUF cho ComfyUI. Kandinsky S2V 1.0 Pro nổi bật nhờ giấy phép MIT thoáng, chuyển động toàn thân điều khiển bằng văn bản và bản phát hành chưng cất 16 bước; điểm yếu hiện tại là yêu cầu bộ nhớ cao và hệ sinh thái cộng đồng còn non trẻ. Bài báo không nêu tên các baseline, vì vậy hãy coi các so sánh trực tiếp là chưa được kiểm chứng và tự thử với clip của bạn.
| Mô hình | Thế mạnh | Dễ chạy trên GPU nhỏ? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | Chuyển động toàn thân, cảnh điều khiển bằng văn bản, distill 16 bước | Chỉ Lite; Pro cần 48 GB |
| Wan2.2-S2V-14B | Hệ sinh thái trưởng thành, chuyển động điện ảnh | Có, GGUF cộng đồng |
| InfiniteTalk / MultiTalk | Clip rất dài, hội thoại nhiều người | Tùy cấu hình |
| LongCat-Video-Avatar 1.5 | Video avatar có hỗ trợ ComfyUI | Có, GGUF cộng đồng |
Avatar biết nói không kiểm duyệt: Những gì bạn có thể làm hôm nay
Hiện chưa có bản fine-tune không kiểm duyệt chính thức hay từ cộng đồng nào của Kandinsky S2V 1.0 Pro. Trọng số mở chạy cục bộ mà không có lớp kiểm duyệt trực tuyến, nhưng dữ liệu huấn luyện là cảnh quay một người đang nói, nên mô hình không được xây dựng cho cảnh người lớn, và thẻ mô hình yêu cầu người dùng chỉ tạo chuyển động cho những người đã đồng ý. Nếu bạn muốn khiến một bức ảnh nói chuyện, tán tỉnh hay tạo dáng trong đồ bơi hoặc nội y cho các nhân vật hư cấu 18+ mà không cần cài đặt gì, studio chuyển ảnh thành video của chúng tôi cho phép bạn tải chân dung lên, mô tả chuyển động và tạo ngay trên trình duyệt.
Tạo chuyển động cho chân dung nhân vật 18+ ngay trên trình duyệt, không cần GPU.
Bắt đầu chuyển ảnh thành video →Tự triển khai Kandinsky S2V 1.0 Pro so với tạo trực tuyến trên Spicy AI
| Triển khai cục bộ (trọng số chính thức) | Spicy AI trực tuyến | |
|---|---|---|
| Lọc nội dung | Không có bộ lọc trực tuyến khi bạn tự chạy | Cho phép nội dung người lớn (18+) |
| Trọng số mở | Có, giấy phép MIT trên Hugging Face | Không áp dụng, chạy trực tuyến |
| Mô hình thực sự được dùng | Kandinsky S2V Lite hoặc Pro | Các mô hình video riêng của Spicy AI |
| Giá | Trọng số miễn phí, bạn trả tiền GPU | Bắt đầu miễn phí, dùng credit để tạo thêm |
- Cục bộ: khớp khẩu hình theo âm thanh của chính bạn, độ dài không giới hạn, toàn quyền kiểm soát.
- Spicy AI: bắt đầu từ một bức ảnh và tạo chuyển động ngay trên trình duyệt, không cần phần cứng.
Câu hỏi thường gặp
Kandinsky S2V 1.0 Pro là gì?
Kandinsky S2V 1.0 Pro là mô hình chuyển giọng nói thành video với 21 tỷ tham số của Kandinsky Lab. Đưa vào một ảnh tham chiếu, một bản ghi âm giọng nói và một prompt văn bản, mô hình sẽ tạo video toàn thân biết nói 25 fps với khẩu hình khớp tiếng. Trọng số được mở theo giấy phép MIT.
Pro và Pro distill khác nhau thế nào?
Cả hai đều có 21B tham số. Bản distill dùng kỹ thuật chưng cất pi-Flow để hoàn tất trong 16 bước thay vì 50 và tích hợp guidance vào trọng số, nên nhanh hơn khoảng năm lần trong khi đạt điểm gần với mô hình gốc ở hầu hết các chỉ số.
Kandinsky S2V 1.0 Pro cần bao nhiêu bộ nhớ GPU?
Đội ngũ yêu cầu một GPU có ít nhất 48 GB (80 GB cho HD). Pro distill đạt đỉnh khoảng 46 GiB ở độ phân giải tiêu chuẩn; VAE tiling hạ mức này xuống khoảng 28 GB kèm những đường nối mờ. Hiện chưa có bản lượng tử hóa chính thức.
Video của Kandinsky S2V 1.0 Pro có thể dài bao nhiêu?
Dài bằng âm thanh của bạn. Mô hình tạo các khối năm giây và tiếp nối mỗi khối từ khối trước. Trên một H100, một giây video độ phân giải tiêu chuẩn mất khoảng 41,5 giây với Pro distill.
Kandinsky S2V 1.0 Pro có tạo luôn giọng nói không?
Không. Bạn cung cấp giọng nói, có thể là bản ghi âm thật hoặc chuyển văn bản thành giọng nói, và video hoàn chỉnh sẽ mang bản âm thanh gốc đó.
Có demo trực tuyến hoặc hỗ trợ ComfyUI không?
Có. Kandinsky Lab có một Space demo trên Hugging Face, nhánh dev/comfyui của repo GitHub bổ sung các node ComfyUI cho Lite distill và Pro distill, và Diffusers được hỗ trợ từ nhánh main.
Có Kandinsky S2V 1.0 Pro không kiểm duyệt không?
Tính đến tháng 11 năm 2026 thì chưa: chưa có bản fine-tune không kiểm duyệt chính thức hay từ cộng đồng nào được phát hành. Bạn có thể tự chạy trọng số mở, hoặc dùng trình tạo video từ ảnh trực tuyến cho phép nội dung hư cấu 18+.
Nguồn tham khảo
- Thẻ mô hình Kandinsky-S2V-1.0-Pro-distill (Hugging Face)
- Thẻ mô hình Kandinsky-S2V-1.0-Pro-distill-Diffusers (Hugging Face)
- Mô hình gốc Kandinsky-S2V-1.0-Pro (Hugging Face)
- Demo trực tuyến Kandinsky S2V 1.0 (Hugging Face Space)
- Repo kandinskylab/kandinsky-s2v (GitHub)
- Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation (arXiv)
- Trang dự án Kandinsky Avatar
- Wan2.2-S2V-14B GGUF (Hugging Face)
Thêm hướng dẫn về các mô hình video không kiểm duyệt
- Kandinsky 6.0 không kiểm duyệt
- Kling không kiểm duyệt
- Kling 2.6 không kiểm duyệt
- Kling O1 không kiểm duyệt
- Sora không kiểm duyệt
- Veo không kiểm duyệt
- Hailuo AI không kiểm duyệt
- MiniMax H3 Max không kiểm duyệt
- Wan không kiểm duyệt
- Wan 3.0 không kiểm duyệt
- Seedance không kiểm duyệt
- Seedance 2.5 không kiểm duyệt
- Seedance 2.0 không kiểm duyệt
- Seedance 2.0 Mini không kiểm duyệt
- HunyuanVideo không kiểm duyệt
- LTX Video không kiểm duyệt
- Runway không kiểm duyệt
- Pika không kiểm duyệt
- Luma Dream Machine không kiểm duyệt
- Vidu không kiểm duyệt
- PixVerse không kiểm duyệt
- EdenLive không kiểm duyệt
- Grok Imagine không kiểm duyệt
- AI Avatars không kiểm duyệt
- HappyHorse 1.0 không kiểm duyệt
- MiniMax H3 FL2VA Ref2VA không kiểm duyệt
- Kling 4.0 không kiểm duyệt
- Kling 3.0 không kiểm duyệt
- MiniMax H3 RefMods không kiểm duyệt
- Looking Ahead không kiểm duyệt
- TaoMate-H3 không kiểm duyệt
- SANA-Video 2.0 không kiểm duyệt
- MiniMax H3 Remix không kiểm duyệt
- Sora 2 không kiểm duyệt
- Wan 2.6 không kiểm duyệt
- LTX-2.5 Slow Motion không kiểm duyệt
- VDN MiniMax H3 không kiểm duyệt
Spicy AI là trang web độc lập, không liên kết với Kandinsky Lab hay Sber. Mọi nội dung chỉ được liên quan đến người trưởng thành (18+); không tạo chuyển động cho người thật khi chưa có sự đồng ý của họ.