Video AI Uncensored · Bản merge cộng đồng từ MiniMax H3
Uncensored MiniMax H3 FL2VA Ref2VA Hybrid: Video sắc nét, nhớ đúng nhân vật của bạn
MiniMax phát hành mô hình video H3 dưới dạng hai checkpoint riêng. FL2VA cho hình và tiếng sạch hơn nhưng chỉ nghe theo khung đầu và khung cuối; Ref2VA bám theo cả loạt ảnh, clip và giọng nói tham chiếu nhưng hình mềm hơn. Bản hybrid cộng đồng MiniMax H3 FL2VA Ref2VA gộp cả hai vào một file, giúp phim ngắn, reel thời trang hay nhân vật anime vẫn dễ nhận ra qua từng cảnh mà không mất độ trau chuốt. Dưới đây là những gì nó làm được, nên tải file nào và cách viết prompt.
- Nhân vật nhất quán
- Âm thanh gốc
- Trọng số mở
Trình tạo video Uncensored thay thế
Ảnh thành videoTải ảnh nhân vật lên làm khung đầu, mô tả chuyển động, góc máy và âm thanh, rồi biến nó thành một video ngắn.
FL2VA và Ref2VA: một mô hình video, hai tính cách
H3 là mô hình âm thanh-video 33 tỷ tham số của MiniMax: một mạng duy nhất tạo cả hình lẫn tiếng, nên tiếng bước chân, sóng biển và lời thoại khớp nhau ngay từ đầu. Thay vì một file làm được mọi thứ, MiniMax công bố hai checkpoint. FL2VA nhận prompt văn bản cùng không, một hoặc hai ảnh, bao gồm văn bản thành video, hoạt họa từ khung đầu, kết thúc bằng khung cuối và chuyển cảnh giữa khung đầu và khung cuối. Ref2VA nhận prompt cùng một gói tham chiếu tối đa chín ảnh, ba clip video và ba clip âm thanh, tổng cộng không quá mười hai file.
Cả hai đều tạo clip 4 đến 15 giây ở 24 khung hình/giây, âm thanh stereo 32 kHz và cạnh ngắn mặc định 768 pixel. Điểm mấu chốt, theo các tác giả cộng đồng đã so sánh trực tiếp, là FL2VA cho chất lượng hình và tiếng tốt hơn rõ rệt, còn Ref2VA mới là bản thực sự nhớ nhân vật của bạn là ai. Bản hybrid ra đời chính là để xóa bỏ sự đánh đổi đó.
| FL2VA | Ref2VA | |
|---|---|---|
| Đầu vào | Văn bản + tối đa 2 khung (đầu, cuối hoặc cả hai) | Văn bản + tối đa 9 ảnh, 3 video, 3 clip âm thanh |
| Thế mạnh | Hình và tiếng sạch, chuyển động từ khung đầu đến khung cuối | Giữ nhất quán khuôn mặt, trang phục, địa điểm và giọng nói |
| Điểm yếu | Không bám theo bảng thiết kế nhân vật | Hình mềm hơn, theo thử nghiệm cộng đồng |
| Việc điển hình | Làm ảnh tĩnh chuyển động, nối hai keyframe | Tập phim nhiều kỳ, trình diễn trang phục, bối cảnh lặp lại |
Vì sao cộng đồng hợp nhất chúng thành một mô hình hybrid
Ý tưởng đến từ việc so sánh hai file theo từng trọng số. Người đăng smhfacct phát hiện chúng gần như giống hệt nhau, độ tương đồng cosine ít nhất 0.9997, và khác biệt thực sự nằm ở một lớp nhỏ trong mỗi khối transformer: trọng số điều biến adaln_proj. Chuyển các lớp này từ Ref2VA sang FL2VA, mô hình sẽ mượn được khả năng bám tham chiếu mà vẫn giữ phần lớn hình ảnh và âm thanh của FL2VA.
MiniMax H3 FL2VA Ref2VA hybrid chỉ đơn giản như vậy: FL2VA làm nền, các lớp điều biến của Ref2VA được chép vào một dải khối đã chọn. Không huấn luyện lại, không trộn trung bình, chỉ là một ca cấy ghép có chủ đích. Đây là thử nghiệm của cộng đồng chứ không phải bản phát hành của MiniMax, và cả hai tác giả đều nói đánh giá của mình mang tính chủ quan. Dù vậy, với ai muốn có trí nhớ của Ref2VA mà không bị mờ, đây là cách khắc phục trực tiếp nhất hiện nay.
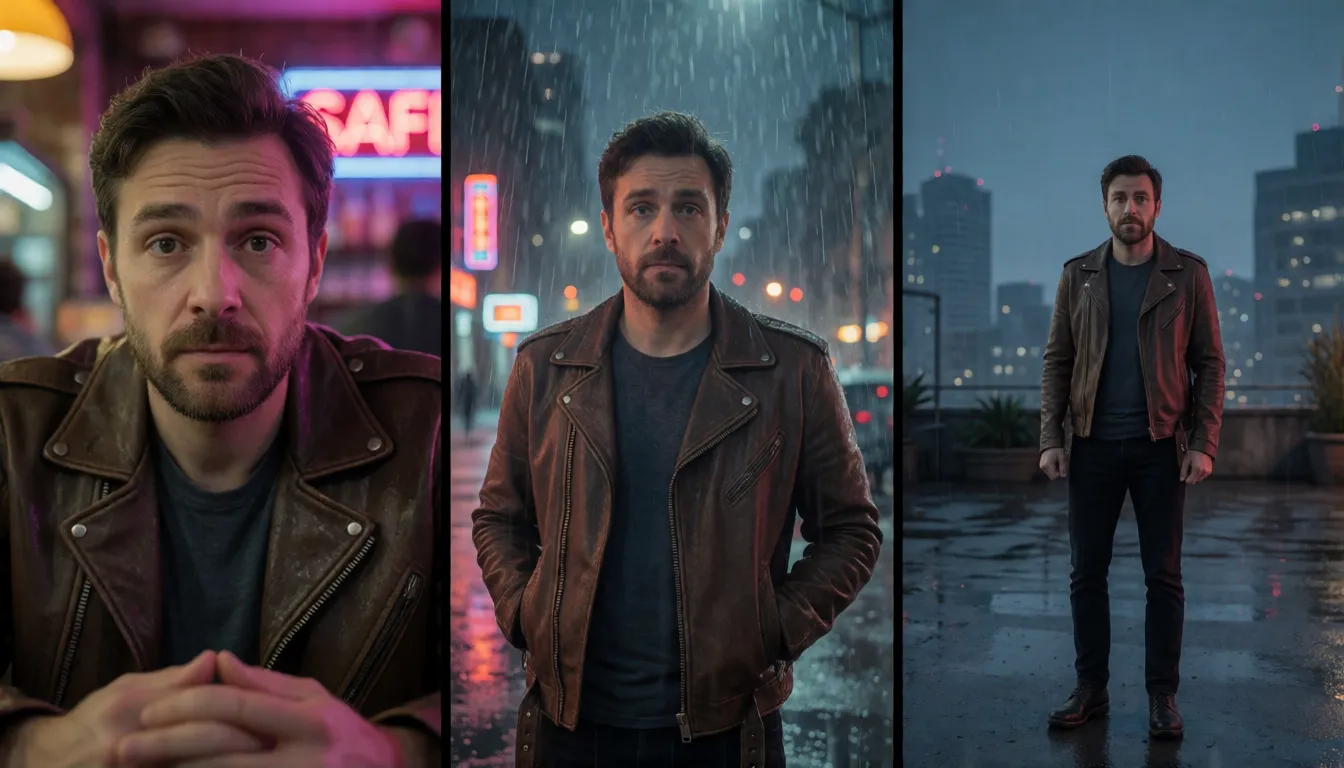
Những cảnh nó làm tốt: phim nhiều tập, reel thời trang và bối cảnh lặp lại
Sự nhất quán nhân vật là lý do mọi người tìm đến bản merge MiniMax H3 FL2VA Ref2VA. Người làm phim ngắn đưa vào một ảnh chân dung và một ảnh trang phục, rồi quay cảnh đối đầu trong quán cà phê, cảnh đi trên phố mưa và cảnh chia tay trên sân thượng, tất cả cùng một gương mặt. Vì nền là FL2VA, các tập phim đó vẫn giữ hình sắc nét hơn và âm thanh gốc, thứ khiến phim dọc trông hoàn chỉnh.
- Truyện nhiều tập và phim AI: một ảnh chân dung tham chiếu đưa nhân vật chính qua mọi cảnh, mọi góc máy và mọi thay đổi ánh sáng.
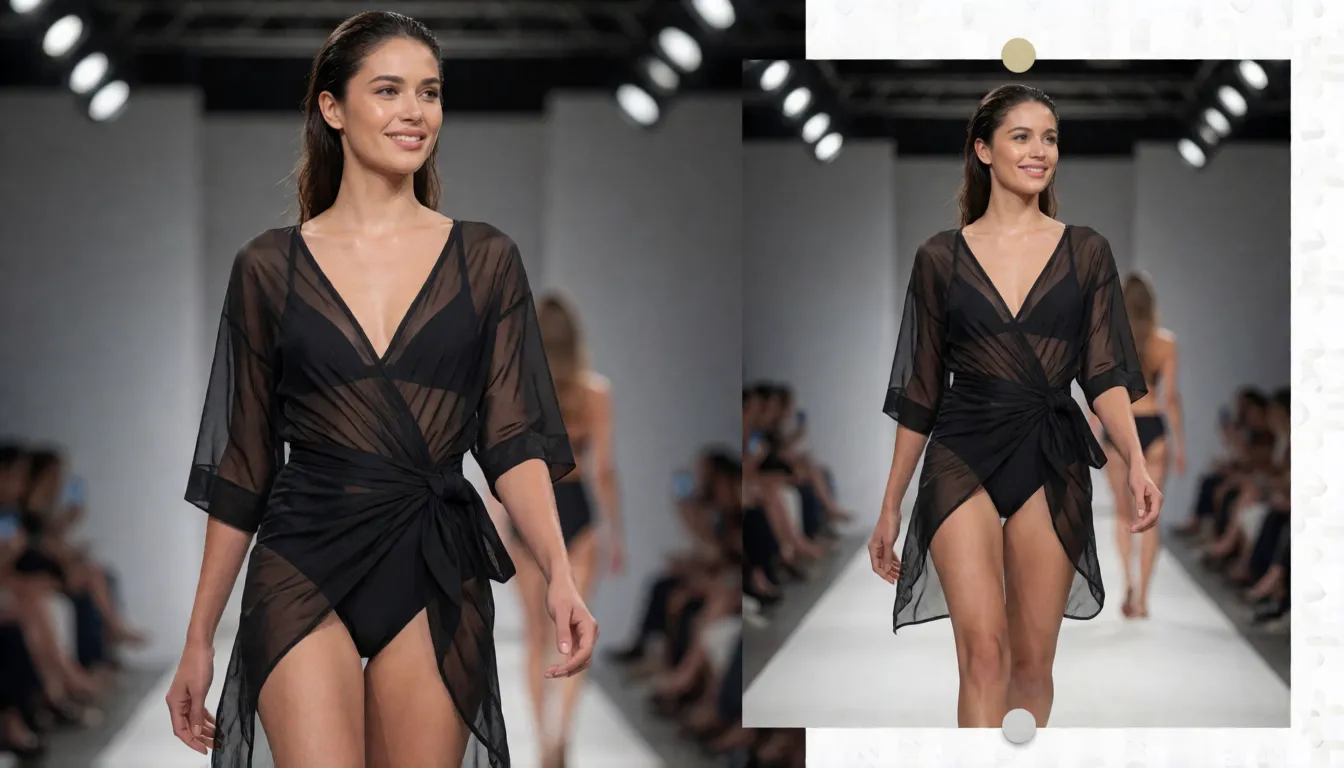
- Trình diễn trang phục và phong cách: đưa bộ đồ làm một tham chiếu và người mẫu làm tham chiếu khác, rồi mô tả cú xoay người trên sàn diễn hoặc một vòng quay chậm. File tham chiếu nhẹ để trang phục dẫn dắt kết quả mà không làm máy quay đứng yên.
- Bối cảnh lặp lại: dùng lại một ảnh căn hộ, quán bar hay bãi biển và tạo các cảnh 4 đến 15 giây mới từ những vị trí khác nhau.
- Liền mạch giọng nói và âm nhạc: Ref2VA nhận clip âm thanh 2 đến 15 giây, nên giọng nhân vật hay không khí của một chủ đề có thể lặp lại qua nhiều clip. Bản hybrid giữ đầu vào này, dù chưa ai đo xem nó hoạt động tốt đến đâu.
- Phong cách người lớn (18+): nhân vật hư cấu trưởng thành trong đồ bơi, nội y hay bikini cho reel bãi biển, hồ bơi và boudoir, tất cả chạy trên máy của chính bạn.
Từ b15 đến b49: chọn đúng file hybrid
Tên mỗi file cho biết những khối nào nhận lớp của Ref2VA. Dải rộng hơn nghĩa là bám tham chiếu mạnh hơn và hình nghiêng về vẻ mềm của Ref2VA; dải hẹp hơn giữ nhiều độ trau chuốt của FL2VA hơn. smhfacct công bố bốn file int8 dựng trên nền int8 đã pruning, còn diobrando0 công bố hai file bf16 không pruning, mỗi file khoảng 66.28 GB, chỉ thay đổi vài khối cuối.
| File | Độ chính xác | Mức bám tham chiếu | Phù hợp với ai |
|---|---|---|---|
| b15-49 | int8 | Mạnh nhất | Nhiều tham chiếu, chấp nhận hình hơi mềm |
| b20-49 | int8 | Mạnh | Dự án ưu tiên tham chiếu |
| b25-49 | int8 | Cân bằng | Điểm khởi đầu tác giả khuyên dùng |
| b30-49 | int8 | Vừa phải | Ưu tiên chất lượng hình |
| b40-49 | bf16, ~66.28 GB | Nhẹ (khoảng 7.9% trọng số từ Ref2VA) | Dẫn dắt tinh tế ở độ chính xác đầy đủ |
| b45-49 | bf16, ~66.28 GB | Nhẹ nhất | Lựa chọn thử đầu tiên diobrando0 gợi ý |
b25-49 hay b30-49 là câu hỏi được bàn nhiều nhất. Hãy bắt đầu với b25-49; nếu khuôn mặt và trang phục đã khớp mà bạn muốn khung hình nét hơn, lùi xuống b30-49. Quy tắc áp dụng cả hai chiều: nếu tham chiếu bị bỏ qua, chuyển sang dải rộng hơn; nếu hình bị nhòe hoặc âm thanh mỏng đi, chuyển sang dải hẹp hơn.
Về phần cứng, không tác giả nào đưa ra con số. Họ nói nhu cầu bộ nhớ tương đương file FL2VA tương ứng, nên các file int8 MiniMax H3 FL2VA Ref2VA nằm cùng hạng với FL2VA int8, còn các file bf16 66 GB thực tế thuộc về máy trạm hơn là một card đồ họa phổ thông.
Tự pha bản riêng với script merge AdaLN
diobrando0 cung cấp h3_adaln_merge.py kèm các file bf16. Script chép trọng số adaln_proj của Ref2VA vào file FL2VA từng byte một trên dải khối bạn đặt bằng --lo và --hi, không nội suy. Nó vá file tại chỗ trên CPU trong vài phút, có thể giữ bản sao lưu bằng --backup, hoàn tác bằng --restore và kiểm tra kết quả bằng hash BLAKE2b.
Rất tiện nếu b40-49 thấy quá nhẹ còn b25-49 quá nặng: thử b35-49, xem vài clip và khôi phục nếu không ưng. Hãy giữ lại các file bf16 FL2VA và Ref2VA gốc của Comfy-Org, vì script cần cả hai làm nguồn.
Mẫu prompt giúp tham chiếu bám chắc
Prompt tham chiếu hiệu quả nhất khi theo thứ tự cố định: nói rõ tham chiếu nào là gì, rồi hành động, rồi máy quay, rồi âm thanh. Càng xếp nhiều tham chiếu, file dải rộng như b20-49 hay b25-49 càng đáng giá. Các mẫu này được viết cho MiniMax H3 FL2VA Ref2VA hybrid và mọi nhân vật đều là người trưởng thành.
Đổi trang phục trên bãi biển
Người phụ nữ trong ảnh tham chiếu 1, mặc bộ bikini đỏ trong ảnh tham chiếu 2, đi dọc bãi biển vào giờ vàng. Cảnh trung, máy quay từ từ tiến lại gần, cô ngoái lại và mỉm cười. Tiếng sóng và tiếng guitar mộc nhẹ nhàng.
Cùng nhân vật, cảnh mới
Vẫn người đàn ông trong ảnh tham chiếu 1 ngồi trong một quán cà phê yên tĩnh, cận cảnh góc nghiêng. Anh khẽ nói: "Em đến muộn." Ánh sáng tự nhiên từ cửa sổ, chất phim 35mm, tiếng trò chuyện khe khẽ trong quán.
Xoay người trên sàn diễn
Người mẫu trưởng thành trong ảnh tham chiếu 1 bước trên sàn diễn trắng trong bộ đồ bơi đen và khăn choàng xuyên thấu từ ảnh tham chiếu 2, dừng lại, chậm rãi xoay người. Cảnh bám theo toàn thân, đèn flash chớp liên tục, nhịp điện tử trầm.
Bối cảnh lặp lại
Trong căn loft ở ảnh tham chiếu 1, cặp đôi trong ảnh tham chiếu 2 và 3 khiêu vũ chậm bên cửa sổ vào ban đêm. Cảnh rộng chuyển dần sang cảnh hai người, ánh đèn thành phố, nhạc jazz êm dịu.
- Gọi tham chiếu theo số thứ tự bạn đã gắn vào.
- Mỗi clip chỉ mô tả một hành động chính; 4 đến 15 giây trôi qua rất nhanh.
- Viết rõ âm thanh bạn muốn, lời thoại đặt trong ngoặc kép.
- Nếu một tham chiếu cứ bị bỏ qua, hãy đổi file trước khi viết lại prompt.
Đánh giá của cộng đồng và giới hạn thực tế
Trong các bản tải lên MiniMax H3 FL2VA Ref2VA, bộ int8 của smhfacct là bộ được nhắc đến nhiều nhất: vào thời điểm tìm hiểu có khoảng 384 lượt thích, 14 chủ đề thảo luận và bốn Hugging Face Spaces xây dựng trên nó. Cặp bf16 của diobrando0 mới hơn và ít ồn ào hơn, với 7 lượt thích, đề ngày 1 tháng 9 năm 2026. Cả hai tác giả nhấn mạnh rằng họ so sánh bằng mắt, không có benchmark chính thức, nên hãy xem bảng phiên bản như bản đồ khởi đầu chứ không phải quy luật.
Giới hạn khá rõ. Bản hybrid không vượt FL2VA với prompt không có tham chiếu, ranh giới khối được chọn qua thử nghiệm, nhu cầu bộ nhớ không giảm, và bước tinh chỉnh 2K của MiniMax không được mã nguồn mở, nên kết quả chạy cục bộ vẫn ở độ phân giải gốc.
H3 hybrid Uncensored: điều gì khác và điều gì không
Việc merge không gỡ bỏ hay thêm huấn luyện an toàn nào; chỉ có các lớp điều biến được chuyển giữa hai checkpoint chính thức. Điều thay đổi trải nghiệm là nơi mô hình chạy. API do MiniMax lưu trữ lọc nội dung tình dục, phạm pháp và vi phạm bản quyền, còn trọng số mở trên máy của bạn không thêm lớp lọc nào như vậy, đó là lý do người sáng tạo nội dung người lớn chuộng H3 chạy cục bộ. Nếu không có GPU mạnh, công cụ ảnh thành video tại đây cho bạn chuyển động tương tự không bộ lọc chỉ từ một ảnh, dành cho cảnh người lớn (18+).
Biến ảnh nhân vật thành clip video 18+ ngay trên trình duyệt.
Mở ảnh thành videoTạo trực tuyến: lựa chọn thay thế không cần cài đặt trên Spicy AI
Không phải ai cũng có máy trạm 66 GB hay đủ kiên nhẫn để xoay xở với các checkpoint. Spicy AI cung cấp một trình tạo thay thế trực tuyến cho đúng kiểu clip này: tải lên ảnh nhân vật, mô tả chuyển động, góc máy và âm thanh, rồi nhận video ngắn ngay trên trình duyệt, không cần tải về, không cần driver và không có bộ lọc nội dung cho cảnh người lớn (18+).
Cách này hợp để thử nhanh trước một lần render cục bộ dài, cho người sáng tạo chỉ dùng điện thoại và cho bất kỳ ai chỉ muốn có kết quả. Hãy bắt đầu từ một ảnh rõ nét của nhân vật trưởng thành, mỗi clip chỉ một hành động chính, và dùng lại cùng ảnh đó cho mọi tập để gương mặt và trang phục luôn dễ nhận ra.
Thử trình tạo video từ ảnh trực tuyến →Câu hỏi thường gặp
FL2VA và Ref2VA khác nhau thế nào?
FL2VA biến văn bản cùng tối đa hai khung đầu hoặc cuối thành video có âm thanh. Ref2VA dùng văn bản cùng gói tham chiếu tối đa chín ảnh, ba clip và ba file âm thanh. Người thử nghiệm trong cộng đồng cho rằng FL2VA có hình và tiếng tốt hơn.
MiniMax H3 FL2VA Ref2VA hybrid có phải do MiniMax làm không?
Không. Đây là bản merge cộng đồng do smhfacct (int8) và diobrando0 (bf16) đăng trên Hugging Face. Cả hai đều gọi nó là thử nghiệm và đánh giá bằng mắt.
Nên tải file hybrid nào trước?
Bắt đầu với b25-49 trong bộ int8 hoặc b45-49 trong bộ bf16. Chuyển sang dải rộng hơn nếu tham chiếu bị bỏ qua, hoặc dải hẹp hơn nếu chất lượng giảm.
Bản hybrid cần bao nhiêu VRAM?
Các tác giả chỉ nói một file MiniMax H3 FL2VA Ref2VA tương đương với file FL2VA tương ứng. File bf16 khoảng 66.28 GB, file int8 nhỏ hơn, và chưa có con số bộ nhớ chính thức.
Có tăng tốc được không?
Có. LoRA turbo ref2v 4 bước dùng được với nó để làm bản nháp nhanh, và bạn luôn có thể chạy đủ bước không cần LoRA cho bản render cuối.
Nguồn tham khảo
Thêm mô hình video AI uncensored
- MiniMax H3 Uncensored
- MiniMax H3 Max Uncensored
- Kling Uncensored
- Kling 2.6 Uncensored
- Kling O1 Uncensored
- Sora Uncensored
- Veo Uncensored
- Hailuo AI Uncensored
- Wan Uncensored
- Wan 3.0 Uncensored
- Seedance Uncensored
- Seedance 2.5 Uncensored
- Seedance 2.0 Uncensored
- Seedance 2.0 Mini Uncensored
- HunyuanVideo Uncensored
- LTX Video Uncensored
- Runway Uncensored
- Pika Uncensored
- Luma Dream Machine Uncensored
- Vidu Uncensored
- PixVerse Uncensored
- EdenLive Uncensored
- Grok Imagine Uncensored
- AI Avatars Uncensored
- HappyHorse 1.0 Uncensored
- Kling 4.0 Uncensored
- Kling 3.0 Uncensored
- MiniMax H3 RefMods Uncensored
- Kandinsky 6.0 Uncensored
MiniMax và H3 là nhãn hiệu của chủ sở hữu tương ứng. Các file hybrid là sản phẩm của cộng đồng. Mọi nội dung phải mô tả người trưởng thành (18+).