Parole vers vidéo · Poids ouverts
Kandinsky S2V 1.0 Pro sans censure : faites parler, gesticuler et chanter n'importe quelle photo
Kandinsky S2V 1.0 Pro prend trois éléments simples, une seule photo, l'enregistrement d'une personne qui parle et une courte description de la scène, et renvoie une vidéo dans laquelle cette personne parle avec des mouvements de lèvres synchronisés, bouge les mains et les épaules et reste fidèle au personnage de la première à la dernière seconde. Il vient de Kandinsky Lab, l'équipe derrière Kandinsky 5.0 et 6.0, et les poids sont téléchargeables gratuitement. Ce guide montre où les créateurs l'utilisent, ce qui rend les résultats naturels, quelle version convient à votre GPU, des prompts prêts à copier et comment il se compare aux autres modèles ouverts d'avatars parlants.
- Photo + voix → vidéo
- Tout le corps, pas seulement le visage
- 25 fps, toute durée
- Version rapide en 16 étapes
Générateur vidéo alternatif sans censure
Image vers vidéoComme Kandinsky S2V 1.0 Pro, il part d'un portrait : importez-le, décrivez comment la personne doit bouger et à quoi ressemble la scène, et nous ouvrons le studio image vers vidéo avec tout déjà rempli. Les thèmes adultes sont les bienvenus lorsque toutes les personnes représentées ont 18 ans ou plus.
Une photo, un extrait vocal, une performance complète
La plupart des outils de photo parlante n'animent que le visage : la bouche s'ouvre et se ferme pendant que le reste de l'image reste figé. Kandinsky S2V 1.0 Pro fonctionne autrement. Vous lui fournissez une image de référence, un enregistrement vocal propre (16 kHz mono) et un prompt texte, et il génère une vidéo à 25 fps dans laquelle toute la personne prend vie. Les lèvres suivent chaque syllabe, les mains font les gestes que l'on fait en expliquant quelque chose et l'arrière-plan se comporte comme le décrit votre prompt. Le résultat conserve le format de votre photo et embarque votre piste audio d'origine, le clip est donc prêt à publier.
La durée n'est pas fixe non plus. Kandinsky S2V 1.0 Pro travaille par blocs de cinq secondes de 125 images, et chaque nouveau bloc reprend là où le précédent s'est arrêté : une voix off de deux minutes devient donc une vidéo de deux minutes de la même personne. La synchronisation labiale est ce que l'on remarque en premier : chaque image n'écoute que sa propre tranche d'audio, c'est pourquoi les formes de la bouche tombent sur le bon son au lieu de traîner derrière.
Là où les vidéos parlantes à partir d'une seule photo décollent
Les avatars pilotés par la voix sont passés des démos techniques au travail de contenu quotidien, et Kandinsky S2V 1.0 Pro s'y intègre parfaitement. Les usages ci-dessous sont ceux que le dossier de recherche et les communautés de créateurs citent le plus souvent, et ils partagent tous un même besoin : une personne crédible à l'écran qui dit exactement ce que dit votre audio, sans réserver de studio ni de présentateur.
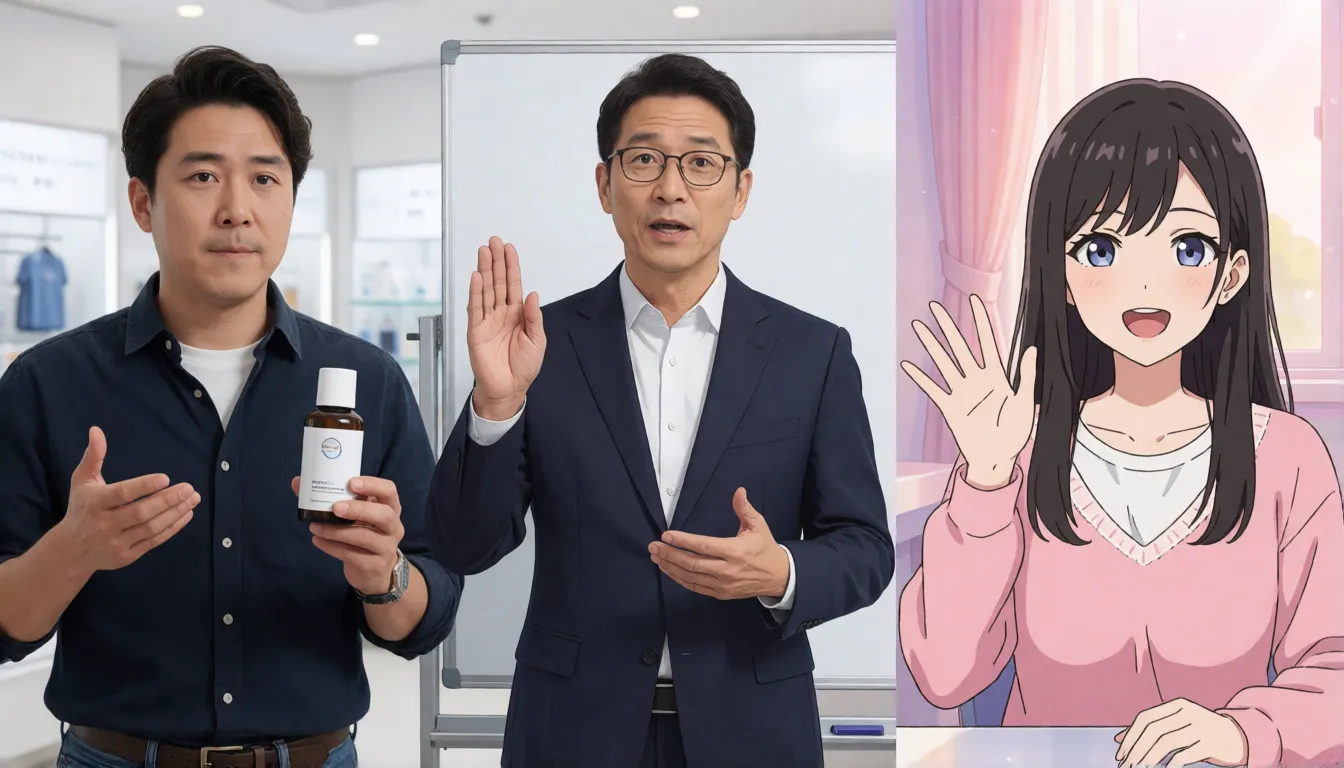
- Séries courtes et BD animées : attribuez à chaque portrait de personnage sa piste de dialogue et obtenez des plans de dialogue en pied qui ressemblent à des scènes, pas à des stickers.
- Clips produit et live shopping : une photo de mannequin et l'enregistrement d'un argumentaire deviennent en quelques minutes une vidéo explicative façon présentateur.
- Cours, résumés d'actualité et formations : transformez un script de narration en long cours avec un professeur virtuel qui continue de gesticuler pendant des minutes.
- Streamers virtuels et compagnons IA : associez l'image d'un personnage à une voix de synthèse vocale et le personnage vous répond à l'écran.
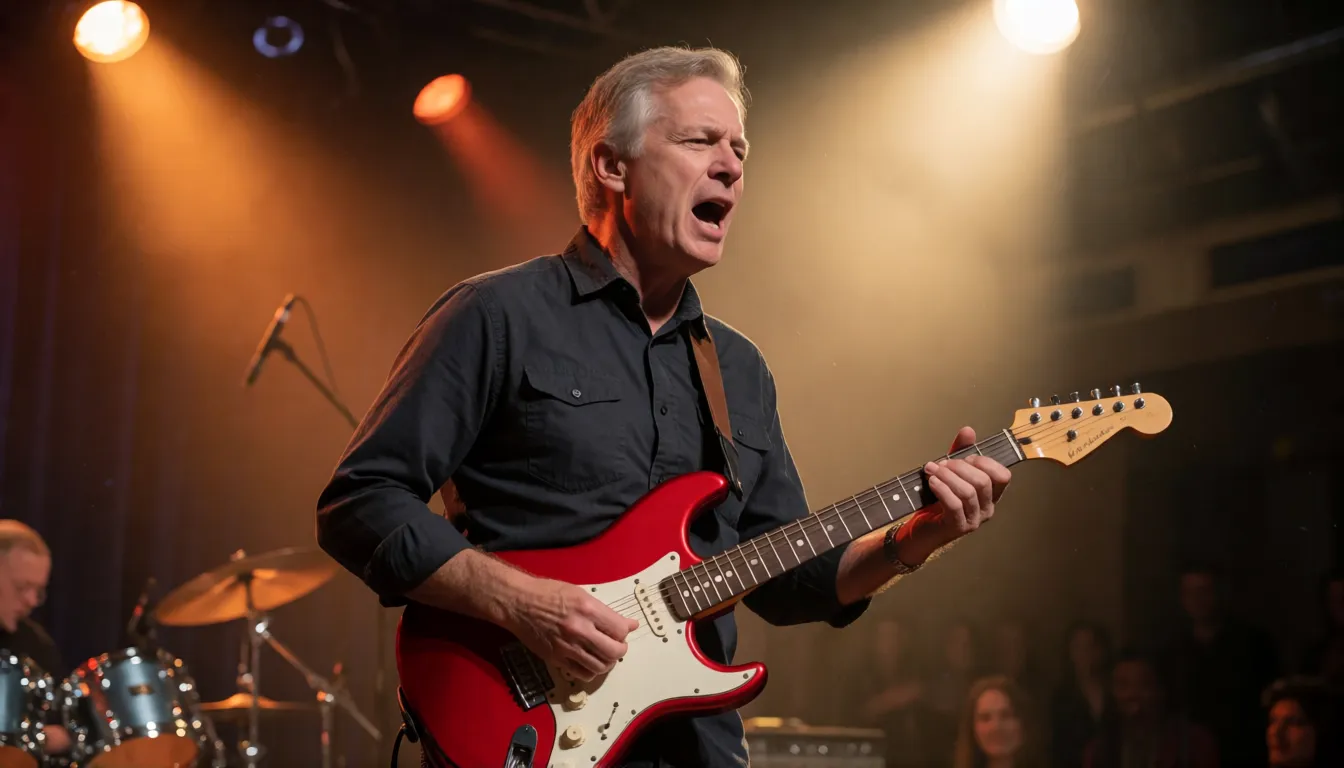
- Musique et podcasts : l'exemple officiel Diffusers montre un homme aux cheveux gris jouant d'une guitare électrique rouge, signe que les clips de performance sont envisageables (la qualité du chant n'a pas été évaluée par l'équipe).
- Doublage multilingue : gardez une photo et changez les pistes vocales dans différentes langues ; les légendes d'entraînement étaient en anglais et en russe, testez donc les autres langues avant un gros projet.
Dialogues de séries courtes
Attribuez à chaque portrait de personnage sa réplique et Kandinsky S2V 1.0 Pro renvoie des scènes en pied avec une synchronisation labiale précise.
Vidéos explicatives produit
Une photo de mannequin et un argumentaire enregistré deviennent un clip façon présentateur pour les boutiques et le live shopping.
Animateurs virtuels
Associez l'image d'un personnage à une voix TTS pour des streamers, des professeurs et des compagnons IA qui répondent.
Ce qui rend les résultats naturels
Trois choix de conception distinguent Kandinsky S2V 1.0 Pro des nombreux outils de synchronisation labiale qui l'ont précédé. D'abord, c'est une animation du corps entier : le modèle part de Kandinsky 5.0 Video, il sait donc déjà comment bougent les corps, les vêtements et les scènes, et le prompt peut orienter les gestes et le décor. Ensuite, il comprend à la fois les mots et la voix : Qwen2.5-Omni lit votre prompt texte et écoute la parole à 25 tokens par seconde, ce qui aide le mouvement à suivre l'énergie du discours. Enfin, une mémoire à trois niveaux transporte l'apparence de la photo de référence d'un bloc à l'autre, de sorte que visages et tenues restent cohérents sur les longues prises.
Kandinsky S2V 1.0 Pro existe aussi en édition distillée. Pro distill atteint son résultat en 16 étapes au lieu de 50 et intègre le guidage dans les poids, ce que l'équipe annonce comme environ cinq fois plus rapide (entre 4,5× et 5,6× selon la configuration) tout en égalant le modèle de base sur presque toutes les métriques. Dans l'étude humaine de l'article, face à la meilleure référence ouverte et à deux services commerciaux, Kandinsky S2V 1.0 Pro a été jugé en moyenne équivalent ou meilleur, la synchronisation labiale étant l'aspect le plus apprécié.
- Mouvement du corps entier et contrôle de la scène à partir d'un prompt texte
- Synchronisation labiale précise à l'image grâce à l'attention audio par image
- Pas de limite de durée stricte grâce à la continuation bloc par bloc
- Poids ouverts sous licence MIT, fonctionne en local
- Nécessite un GPU de 48 Go pour le modèle Pro (80 Go pour la HD)
- Ne crée pas de son, vous devez fournir votre propre voix ou TTS
- Pas encore de version quantifiée officielle pour les cartes de 24 Go
- Le mode HD n'a été ni entraîné ni évalué à cette résolution
Lite ou Pro, base ou distill : choisir une version
Kandinsky S2V 1.0 Pro fait partie d'une famille de quatre checkpoints. Les modèles Lite 2B sont l'option rapide et légère ; les modèles Pro 21B offrent les meilleurs visages, mains et mouvements. Pour chaque taille, l'édition distillée est le choix du quotidien et le modèle de base en 50 étapes s'adresse à ceux qui recherchent le moindre détail. Les deux checkpoints Pro peuvent aussi exécuter une configuration HD en 1280×768.
| Version | Taille et étapes | Idéal pour | Vitesse sur une H100 (par seconde de vidéo) |
|---|---|---|---|
| Lite 2B distill | 2B, distillé | Brouillons rapides, petits GPU | Environ 8,7 s |
| Lite 2B | 2B, base | Qualité Lite sans distillation | Plus lent que Lite distill |
| Pro 21B distill | 21B, 16 étapes | Meilleur équilibre au quotidien | Environ 41,5 s (33,6 s compilé) |
| Pro 21B | 21B, 50 étapes | Fidélité maximale, prend en charge les prompts négatifs | Environ 189 s |
| Pro distill HD | 21B, 1280×768 | Images plus grandes (qualité non testée) | Environ 137 s |
Mémoire GPU et vitesse : à quoi s'attendre
Kandinsky S2V 1.0 Pro est un gros modèle, prévoyez donc votre matériel avant de télécharger environ 65 Go de fichiers. La configuration officielle requise est un seul GPU avec au moins 48 Go de mémoire (80 Go pour la HD) et un pilote en version 580 ou plus récente. Sur une H100, Pro distill en résolution standard culmine à environ 46 Gio ; la HD culmine à environ 55 Gio. Un clip de dix secondes prend donc environ six à sept minutes sur une seule carte, et la configuration officielle à huit GPU ramène chaque seconde de vidéo à environ 11 secondes.
Pas assez de mémoire ? Activer le VAE tiling fait descendre le pic à environ 28 Go au prix de légères coutures, la voie Diffusers avec déchargement sur CPU culmine vers 50 Gio, et le modèle Lite 2B distill est le moyen le plus simple d'expérimenter sur une carte plus modeste. Louer un GPU dans le cloud pour un après-midi est la solution courante pour les cartes grand public de 24 Go, puisqu'il n'existe pas encore de fichiers quantifiés officiels.
Trois façons de l'essayer : démo en ligne, ComfyUI et Diffusers
Vous n'avez rien à installer pour voir ce que Kandinsky S2V 1.0 Pro sait faire. L'équipe héberge un Space de démo gratuit sur Hugging Face, et des notebooks Colab et Kaggle existent pour ceux qui veulent un peu plus de contrôle. Quand vous êtes prêt à l'exécuter vous-même, choisissez la voie qui correspond à votre façon de travailler.
- 1En ligne : ouvrez le Space Kandinsky-S2V-1.0-Demo sur Hugging Face, importez un portrait et un court fichier WAV, ajoutez un prompt et lancez la génération.
- 2Ligne de commande : clonez le dépôt GitHub kandinsky-s2v, lancez uv sync, puis uv run kandy-s2v generate avec la configuration s2v_pro_distill.yaml et vos chemins --audio, --image et --out ; ajoutez --prompt et --seed pour orienter et reproduire les résultats.
- 3ComfyUI : passez sur la branche dev/comfyui du dépôt, qui fournit des nœuds pour Lite distill et Pro distill, et reliez image, audio et prompt au sampler.
- 4Diffusers : installez diffusers depuis la branche main, chargez kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers avec ModularPipeline et lisez votre audio à 16 kHz.
Quelle que soit la voie choisie, Kandinsky S2V 1.0 Pro récompense de bons fichiers d'entrée plus que n'importe quel réglage. Gardez ceci en tête :
- Utilisez une photo nette, de face, où la personne occupe une bonne partie du cadre ; son format deviendra celui de la vidéo.
- Enregistrez une voix propre sans musique de fond, au format audio mono 16 kHz.
- Fixez le --seed dès qu'un résultat vous plaît, puis ne modifiez que le prompt pour explorer des variantes.
Modèles de prompts pour vidéos parlantes
Dans Kandinsky S2V 1.0 Pro, le prompt texte ne contient pas le script ; c'est votre audio qui le porte. Utilisez le prompt pour décrire la personne, ses mouvements, le décor et la caméra, et gardez des vêtements et un arrière-plan proches de la photo de référence pour que l'apparence ne dérive pas. Ces modèles couvrent les formats les plus populaires ; changez les détails et conservez la structure.
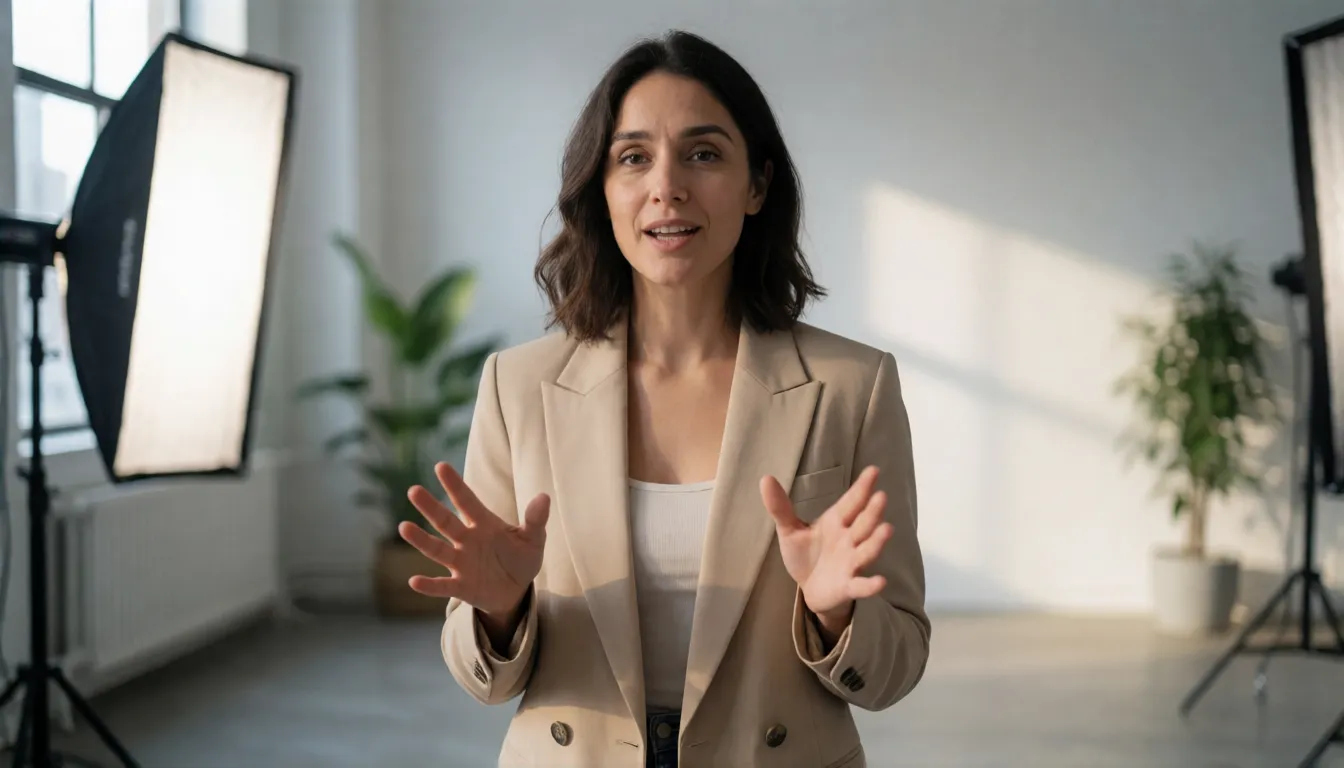
- Présentatrice : A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
- Présentation produit : A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- Dialogue dramatique : A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- Musicien : A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- Professeur : A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- Streameuse virtuelle : An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- Discussion à la plage (18+) : A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- Prompt négatif (modèle 50 étapes uniquement) : blurry face, distorted mouth, extra fingers, flickering, static body.
Comparaison avec Wan 2.2 S2V, InfiniteTalk et les autres avatars ouverts
Les modèles ouverts d'avatars parlants se sont multipliés, et chacun a une force différente face à Kandinsky S2V 1.0 Pro. Wan2.2-S2V-14B d'Alibaba dispose déjà de fichiers GGUF communautaires, ce qui le rend plus accessible aux petits GPU. InfiniteTalk et MultiTalk se concentrent sur les très longues vidéos et les conversations à plusieurs. LongCat-Video-Avatar 1.5 propose aussi des builds GGUF pour ComfyUI. Kandinsky S2V 1.0 Pro se distingue par sa licence MIT permissive, son mouvement du corps entier piloté par le texte et sa version distillée en 16 étapes ; ses points faibles actuels sont l'exigence élevée en mémoire et un écosystème communautaire encore jeune. L'article ne nomme pas ses références, considérez donc les comparaisons directes comme non vérifiées et testez avec vos propres clips.
| Modèle | Point fort | Plus simple sur petits GPU ? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | Mouvement du corps entier, scènes pilotées par le texte, distill en 16 étapes | Lite seulement ; Pro exige 48 Go |
| Wan2.2-S2V-14B | Écosystème mature, mouvement cinématographique | Oui, GGUF communautaire |
| InfiniteTalk / MultiTalk | Clips très longs, dialogue à plusieurs | Selon la configuration |
| LongCat-Video-Avatar 1.5 | Vidéo d'avatar avec prise en charge de ComfyUI | Oui, GGUF communautaire |
Avatars parlants sans censure : ce que vous pouvez faire aujourd'hui
Il n'existe pas encore de fine-tune sans censure, officiel ou communautaire, de Kandinsky S2V 1.0 Pro. Les poids ouverts tournent en local sans couche de modération en ligne, mais les données d'entraînement sont des séquences d'une seule personne qui parle, les scènes adultes ne font donc pas partie de ce pour quoi il a été conçu, et la fiche du modèle demande de n'animer que des personnes ayant donné leur consentement. Si vous voulez faire parler, flirter ou poser en maillot de bain ou en lingerie des personnages fictifs de 18 ans ou plus sans rien installer, notre studio image vers vidéo vous permet d'importer un portrait, de décrire le mouvement et de générer dans le navigateur.
Animez le portrait d'un personnage 18+ dans votre navigateur, sans GPU.
Lancer l'image vers vidéo →Héberger Kandinsky S2V 1.0 Pro soi-même vs générer en ligne sur Spicy AI
| Déploiement local (poids officiels) | Spicy AI en ligne | |
|---|---|---|
| Filtrage du contenu | Aucun filtre en ligne quand vous l'exécutez vous-même | Contenu adulte (18+) autorisé |
| Poids ouverts | Oui, licence MIT sur Hugging Face | Sans objet, fonctionne en ligne |
| Modèle réellement utilisé | Kandinsky S2V Lite ou Pro | Modèles vidéo propres à Spicy AI |
| Prix | Poids gratuits, vous payez le GPU | Gratuit pour commencer, crédits pour aller plus loin |
- Local : synchronisation labiale pilotée par votre propre audio, durée illimitée, contrôle total.
- Spicy AI : partez d'une photo et animez-la dans le navigateur, sans matériel.
Questions fréquentes
Qu'est-ce que Kandinsky S2V 1.0 Pro ?
Kandinsky S2V 1.0 Pro est un modèle parole vers vidéo de 21 milliards de paramètres signé Kandinsky Lab. Fournissez-lui une photo de référence, un enregistrement vocal et un prompt texte, et il génère une vidéo parlante en pied à 25 fps avec synchronisation labiale. Les poids sont ouverts sous licence MIT.
Quelle est la différence entre Pro et Pro distill ?
Les deux ont 21B de paramètres. La version distill utilise la distillation pi-Flow pour terminer en 16 étapes au lieu de 50 et intègre le guidage dans les poids : elle est donc environ cinq fois plus rapide tout en obtenant des scores proches du modèle de base sur presque toutes les métriques.
De combien de mémoire GPU Kandinsky S2V 1.0 Pro a-t-il besoin ?
L'équipe demande un seul GPU d'au moins 48 Go (80 Go pour la HD). Pro distill culmine à environ 46 Gio en résolution standard ; le VAE tiling le ramène à environ 28 Go avec de légères coutures. Il n'existe pas encore de version quantifiée officielle.
Quelle durée peuvent atteindre les vidéos de Kandinsky S2V 1.0 Pro ?
Celle de votre audio. Le modèle génère des blocs de cinq secondes et prolonge chacun à partir du précédent. Sur une H100, une seconde de vidéo en résolution standard prend environ 41,5 secondes avec Pro distill.
Kandinsky S2V 1.0 Pro génère-t-il aussi la voix ?
Non. Vous fournissez la parole, enregistrement réel ou synthèse vocale, et la vidéo finale embarque cette piste audio d'origine.
Existe-t-il une démo en ligne ou une prise en charge de ComfyUI ?
Oui. Kandinsky Lab héberge un Space de démo sur Hugging Face, la branche dev/comfyui du dépôt GitHub ajoute des nœuds ComfyUI pour Lite distill et Pro distill, et la prise en charge de Diffusers est disponible depuis la branche main.
Existe-t-il un Kandinsky S2V 1.0 Pro sans censure ?
Pas en novembre 2026 : aucun fine-tune sans censure, officiel ou communautaire, n'a été publié. Vous pouvez exécuter vous-même les poids ouverts ou utiliser un générateur image vers vidéo en ligne qui autorise le contenu fictif 18+.
Sources
- Fiche du modèle Kandinsky-S2V-1.0-Pro-distill (Hugging Face)
- Fiche du modèle Kandinsky-S2V-1.0-Pro-distill-Diffusers (Hugging Face)
- Modèle de base Kandinsky-S2V-1.0-Pro (Hugging Face)
- Démo en ligne de Kandinsky S2V 1.0 (Hugging Face Space)
- Dépôt kandinskylab/kandinsky-s2v (GitHub)
- Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation (arXiv)
- Page du projet Kandinsky Avatar
- Wan2.2-S2V-14B GGUF (Hugging Face)
Plus de guides de modèles vidéo sans censure
- Kandinsky 6.0 sans censure
- Kling sans censure
- Kling 2.6 sans censure
- Kling O1 sans censure
- Sora sans censure
- Veo sans censure
- Hailuo AI sans censure
- MiniMax H3 Max sans censure
- Wan sans censure
- Wan 3.0 sans censure
- Seedance sans censure
- Seedance 2.5 sans censure
- Seedance 2.0 sans censure
- Seedance 2.0 Mini sans censure
- HunyuanVideo sans censure
- LTX Video sans censure
- Runway sans censure
- Pika sans censure
- Luma Dream Machine sans censure
- Vidu sans censure
- PixVerse sans censure
- EdenLive sans censure
- Grok Imagine sans censure
- AI Avatars sans censure
- HappyHorse 1.0 sans censure
- MiniMax H3 FL2VA Ref2VA sans censure
- Kling 4.0 sans censure
- Kling 3.0 sans censure
- MiniMax H3 RefMods sans censure
- Looking Ahead sans censure
- TaoMate-H3 sans censure
- SANA-Video 2.0 sans censure
- MiniMax H3 Remix sans censure
- Sora 2 sans censure
- Wan 2.6 sans censure
- LTX-2.5 Slow Motion sans censure
- VDN MiniMax H3 sans censure
Spicy AI est un site indépendant, sans affiliation avec Kandinsky Lab ni Sber. Tout le contenu doit impliquer uniquement des adultes (18+) ; n'animez pas de vraies personnes sans leur consentement.