MiniMax H3 · adaptateurs de référence communautaires
MiniMax H3 RefMods : la même star dans chaque plan, sans entraînement
Tous les créateurs de vidéos IA connaissent ce problème : l'héroïne est parfaite dans le premier plan, puis son visage dérive dès le troisième. Les MiniMax H3 RefMods règlent cela grâce à une astuce empruntée à la culture LoRA. Vous fournissez une seule fois à ComfyUI quelques photos, un court extrait ou un échantillon audio, et vous obtenez un minuscule fichier d'environ 1 à 1,6 Mo qui se souvient de votre personnage. Branchez-le dans n'importe quel workflow vidéo MiniMax H3 et le même visage, la même tenue ou le même style artistique reviennent à la demande, sans aucun entraînement de modèle. Vous trouverez ci-dessous ce qu'ils font, comment les créateurs les utilisent, une configuration pas à pas, des modèles de prompts et une liste honnête de ce qui coince encore.
- Sans entraînement
- Fichiers de ~1–1,6 Mo
- Jusqu'à 8 emplacements
- ComfyUI + Fizgig
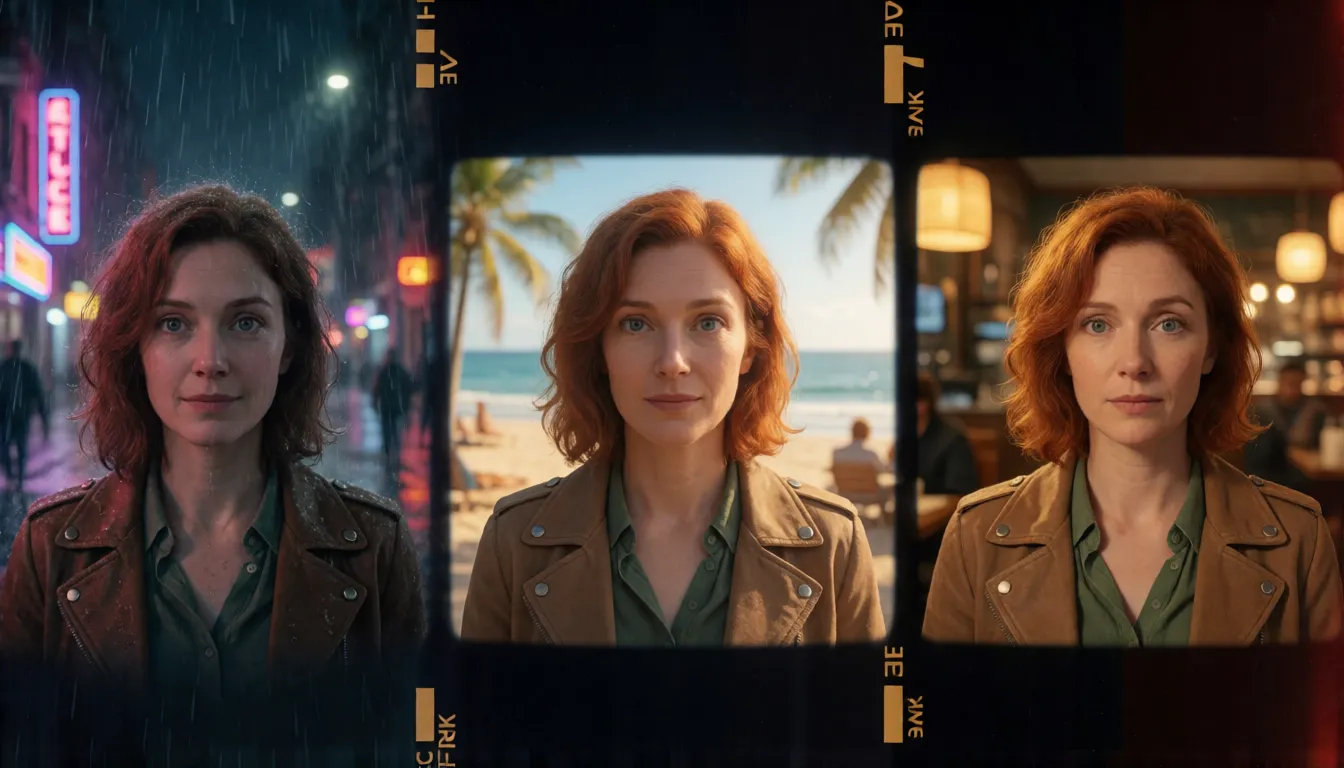
Tout un personnage dans un minuscule fichier
Les MiniMax H3 RefMods, pour Reference Latent Adapters, sont un format communautaire conçu pour le modèle audio-vidéo à poids ouverts H3. Voyez-les comme un casting sauvegardé : au lieu de téléverser à chaque fois les mêmes images de référence et de jongler avec les balises de position <Picture 1>, vous les encodez une fois via le VAE et enregistrez le résultat dans un fichier .safetensors. Ensuite, vous le chargez exactement comme un LoRA, et il est injecté dans le flux de conditionnement de référence de H3 pendant la génération de la vidéo. Aucun poids de H3 n'est réentraîné : en créer un prend quelques minutes, pas des heures.
Le format et ses nœuds proviennent du pack ComfyUI-MiniMaxH3Mod du développeur @Luisacaotica, publié sous licence MIT. C'est un projet communautaire, pas un produit MiniMax, et son README le signale encore comme en construction : les noms et entrées des nœuds peuvent donc changer d'une version à l'autre. Cela n'a freiné personne : le dépôt a dépassé les 500 étoiles GitHub quelques semaines après son lancement.
| Réglage | Ce qu'il fait | Idéal pour |
|---|---|---|
| Full Reference (encodage) | Conserve chaque détail encodé, consomme plus de tokens | Visages et tenues à rendre ultra nets |
| Compressed Reference | Regroupe la référence pour économiser des tokens, perd un peu de détail et de mouvement | Clips longs ou nombreux fichiers empilés |
| Preset identity_encode | Capture qui est une personne ou un personnage | Héros, présentateurs et mascottes récurrents |
| Preset style_experimental | Condense un look dans une grille 8×8 | Séries avec un même étalonnage ou style artistique |
| Preset motion_sequence | Mémorise le mouvement d'un court extrait | Réutiliser une danse, une démarche ou un geste |
Comment les créateurs exploitent les adaptateurs de référence
L'attrait des MiniMax H3 RefMods est simple : un fichier, des épisodes à l'infini. Les créateurs qui entraînaient autrefois un LoRA pour chaque visage récurrent se constituent désormais une petite bibliothèque de personnages, de styles et de mouvements, puis les combinent plan par plan. Voici les usages qui reviennent le plus souvent dans les discussions et workflows partagés par la communauté.
Courts dramas et BD IA
Réutilisez un même personnage principal original sur des dizaines de plans. Changez le lieu, le mouvement de caméra et l'action : le visage reste identique d'un épisode à l'autre.
Présentateurs virtuels et IP originales
Figez une mascotte ou un présentateur virtuel dans un seul fichier et publiez des clips chaque semaine sans que son apparence s'éloigne peu à peu de la marque.
Mode et vitrines produits
Gardez un même modèle adulte stable pendant que le prompt change de tenue. Les vêtements de la référence peuvent s'inviter, alors décrivez clairement le nouveau look.
Plans de transformation
Le loader Axis passe d'un personnage à l'autre de A à B, idéal pour les morphings, les révélations avant-après et les séquences de rêve.
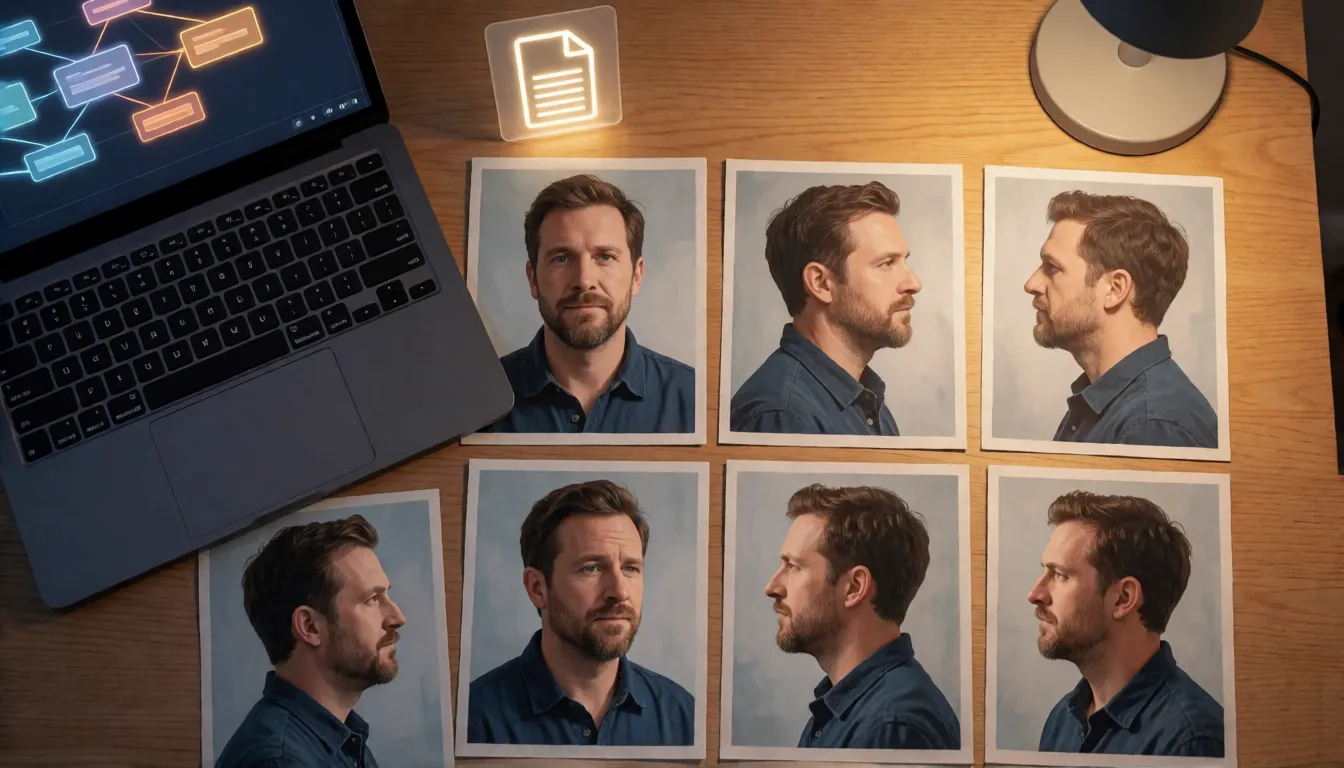
De huit photos à un personnage réutilisable dans ComfyUI
La création des MiniMax H3 RefMods dans ComfyUI suit le README du pack de nœuds. Commencez par de bonnes sources : 5 à 10 images nettes d'une seule personne sous différents angles, ou un court extrait. Pour l'audio, 5 à 15 secondes de son propre constituent la fourchette habituelle. Évitez les arrière-plans chargés, car tout ce qui figure dans le cadre peut se retrouver dans le fichier avec le visage.
- 1Installez ComfyUI-MiniMaxH3Mod via ComfyUI Manager ou en clonant le dépôt GitHub dans custom_nodes, puis redémarrez ComfyUI.
- 2Chargez vos images de référence dans le nœud Extract H3 RefMod et choisissez le preset identity_encode avec Full Reference pour un maximum de détails.
- 3Enregistrez le résultat dans ComfyUI/models/refmods/ afin que les nœuds de chargement le trouvent.
- 4Ajoutez Load H3 RefMods (jusqu'à huit emplacements, chacun avec sa propre intensité et ses copies) et définissez une intensité de départ.
- 5Reliez Apply H3 RefMod au conditionnement de votre nœud MiniMax H3 ImageToVideo ou ReferenceToVideo, puis lancez l'échantillonnage comme d'habitude.
- 6Générez une fois la même seed sans le fichier comme base de comparaison, pour voir exactement ce qu'apporte la référence.
- Nœud Step Curve : choisissez concept_at_start, concept_at_middle ou concept_at_ends pour décider quand la référence agit pendant le débruitage, par exemple la ressemblance d'abord, le mouvement libre ensuite.
- Load H3 RefMod Folder : pointez vers un dossier pour changer d'un coup des ensembles entiers de personnages.
Vous préférez les boutons aux nœuds ? Créez-les dans Fizgig v6
Fizgig, l'outil de création de shootthesound, a ajouté la création de MiniMax H3 RefMods dans sa version 6 à la mi-septembre 2026. Il habille l'extraction d'une interface plus conviviale avec des recettes prêtes à l'emploi : la recette communautaire utilise 8 images à 1 mégapixel, Fizgig lite 16 images à 0,5 mégapixel, et une option Fizgig 1MP se situe entre les deux. On y trouve aussi des presets de style, des références de mouvement et audio, ainsi qu'un RefMod Studio qui affiche des comparaisons A/B côte à côte pour juger les réglages d'intensité sans tâtonner. La documentation de Fizgig comprend un guide pratique qui détaille chaque recette.
Deux personnages, une scène : empiler les fichiers
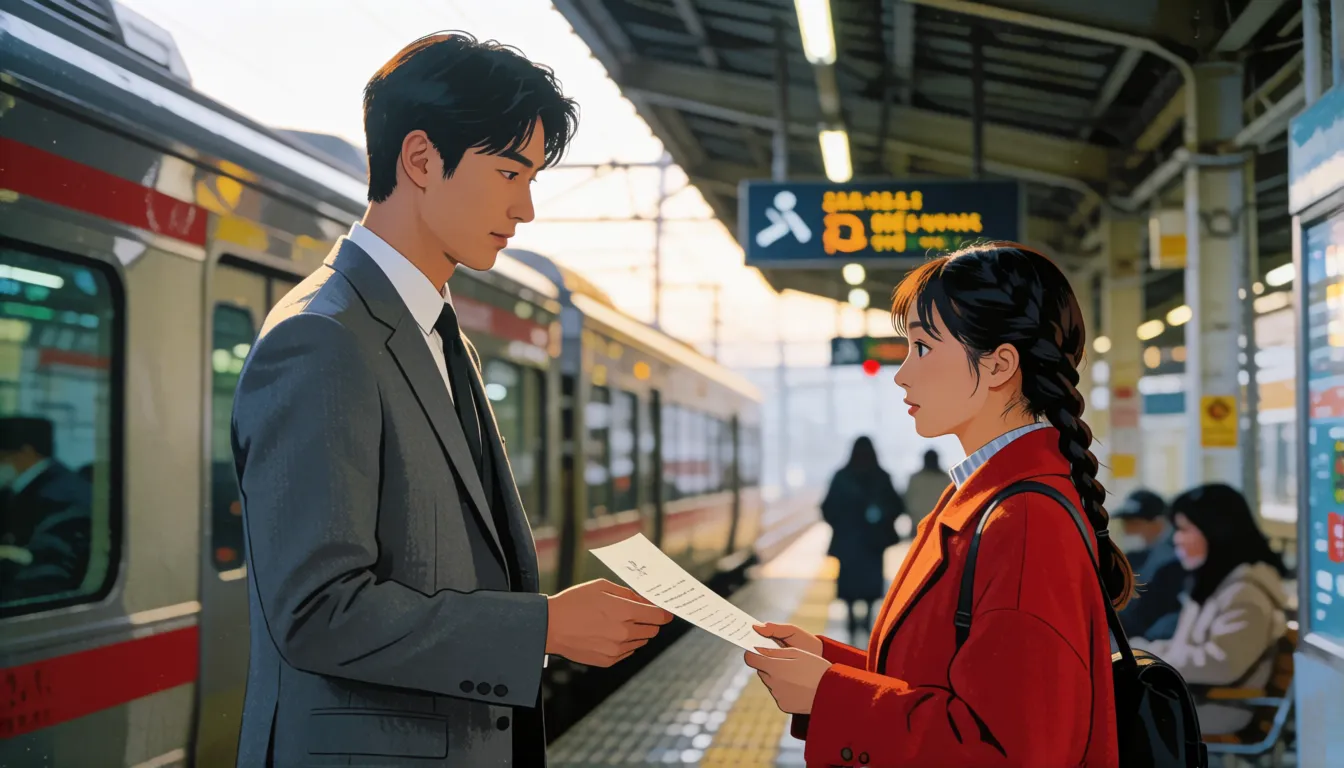
C'est dans les plans de groupe que les MiniMax H3 RefMods surpassent discrètement la référence par image unique. Donnez à chaque personnage son propre fichier, chargez-les dans des emplacements séparés et désignez-les dans le prompt par <Subject 1>, <Subject 2>, etc. Limitez chaque fichier à une seule personne : un fichier qui mélange deux visages a tendance à les fusionner. Baissez d'abord l'intensité du personnage secondaire si le principal perd en détail, et gardez dans le prompt la description des cheveux, des vêtements et de la silhouette pour que le modèle sache qui est qui.
Au-delà des visages : références de style, de mouvement et de voix
Les personnages ne sont que la moitié de l'histoire des MiniMax H3 RefMods. Un fichier de style créé avec style_experimental condense un ensemble d'images en un look applicable à toute une série, pratique pour garder le même étalonnage sur une chaîne. Un fichier de mouvement créé avec motion_sequence transforme un court extrait en modèle de mouvement, pour réutiliser une démarche ou une danse emblématique avec un autre personnage.
Les fichiers audio existent aussi, à environ 80 tokens par seconde de son. Considérez-les comme expérimentaux : dans les tests actuels, l'identité du locuteur ne se transfère pas de façon fiable, l'audio est encodé par défaut depuis le début de l'extrait et il n'y a pas d'alignement de synchronisation labiale. N'imitez jamais la voix d'une personne réelle sans son autorisation.
Modèles de prompts pour un visage stable
Quand vous rédigez un prompt avec les MiniMax H3 RefMods, rappelez-vous qu'un fichier de référence n'est pas un mot déclencheur et que son nom ne sert à rien dans le prompt. Ce qui fonctionne : décrire le personnage comme si le fichier n'existait pas, puis laisser la référence aligner les détails. Ces modèles sont écrits pour des personnages adultes originaux ; remplacez-les par vos propres détails.
- Ancrez toujours l'apparence et l'action dans les mots : âge, cheveux, yeux, vêtements, puis mouvement et caméra.
- Un personnage par fichier, une balise <Subject N> par personnage.
- Commencez autour d'une intensité moyenne, augmentez-la seulement si le visage dérive, et baissez-la si l'arrière-plan se met à copier les photos de référence.
- Pour changer de tenue, nommez explicitement le nouveau vêtement et ajoutez same face pour que les habits de la référence ne l'emportent pas.
Un seul personnage
<Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, wearing a white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting.
Deux personnages
<Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light.
Changement de tenue (personnage original 18+)
<Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, standing by a sunlit pool, slow dolly-in.
RefMod vs LoRA vs image de référence directe
Chaque méthode a sa place. L'auteur de Fizgig note qu'un LoRA entraîné généralise encore mieux et atteint une ressemblance supérieure, mais l'écart est faible pour les plans proches du matériel de référence. Les images de référence simples ne demandent aucune préparation, mais elles sont réencodées à chaque génération et les balises de position deviennent laborieuses quand plusieurs images sont en jeu.
| RefMod | LoRA | Image de référence directe | |
|---|---|---|---|
| Entraînement | Aucun, une seule extraction | Oui, dataset et entraînement | Aucun |
| Délai avant utilisation | Quelques minutes | Plusieurs heures | Immédiat |
| Taille du fichier | Environ 1–1,6 Mo | Généralement bien plus lourd | Aucun fichier |
| Ressemblance sous de nouveaux angles | Bonne près de la référence | La meilleure | Variable selon la génération |
| Empilement de personnages | Jusqu'à 8 emplacements | Possible, risque de conflits | Balises de position par image |
Ce qui coince encore : les limites en toute honnêteté
Les MiniMax H3 RefMods sont jeunes et le README du pack de nœuds reconnaît franchement leurs imperfections. Les connaître d'emblée évite des heures de régénérations, et la plupart ont des solutions simples, comme des références plus propres ou une intensité plus basse.
- Les mouvements rapides peuvent brouiller le visage ; des mouvements de caméra plus lents préservent mieux l'identité.
- Compressed Reference perd des détails du visage : utilisez Full Reference pour les gros plans.
- Identité, vêtements, arrière-plan et composition peuvent être transférés ensemble ; un transfert sélectif n'est pas garanti.
- Le clonage vocal à partir de fichiers audio reste peu fiable aujourd'hui, et l'audio n'apporte aucune synchronisation labiale.
- Certains workflows n'ont pas été entièrement validés sur tous les GPU, et il n'existe aucun benchmark de référence.
Fichiers prêts à l'emploi : où la communauté les partage
Inutile de créer tous vos MiniMax H3 RefMods à partir de zéro. Le créateur malcolmrey publie sur Hugging Face, sous licence Apache-2.0, une vaste bibliothèque de plusieurs centaines de fichiers prêts à l'emploi, accompagnée de datasets de guides, d'exemples et de workflows. Téléchargez un fichier, déposez-le dans ComfyUI/models/refmods/ et il apparaît dans le loader. Il existe aussi de plus petits partages personnels, mais beaucoup sont peu actifs et certains contiennent l'apparence de personnes réelles ou de personnages protégés par le droit d'auteur : vérifiez leur contenu avant usage et tenez-vous-en à des personnages originaux ou correctement licenciés.
Usage sans censure : ce que les fichiers de référence peuvent changer ou non
Ceux qui cherchent des MiniMax H3 RefMods sans censure espèrent généralement une édition non filtrée. Il n'y en a pas : un fichier de référence indique seulement au modèle qui ou quoi montrer, il ne change pas ce que le modèle accepte de produire. H3 étant un modèle à poids ouverts, les utilisateurs locaux choisissent déjà leur propre configuration, et les créateurs adultes associent généralement le fichier d'un personnage original 18+ à des LoRA H3 communautaires pour des séries en tenue de plage, lingerie ou boudoir. Si vous préférez éviter l'installation locale, Spicy AI propose la conversion image-vers-vidéo H3 en ligne avec des filtres assouplis pour les personnages adultes, fictifs ou consentants.
Téléversez une image fixe de votre personnage adulte original et animez-la sans GPU.
Ouvrir l'image vers vidéoEssayez en ligne un prompt de personnage cohérent
Partez d'une image fixe de votre personnage, collez un prompt et laissez le modèle vidéo faire le reste. Ces prompts de départ ont été écrits pour des personnages adultes originaux et fonctionnent tels quels.
- <Subject 1>, a woman in her late 20s with shoulder-length auburn hair and green eyes, white linen shirt, walks along a rainy neon street at night, handheld tracking shot, cinematic lighting
- <Subject 1> (tall man, short black hair, grey suit) hands a letter to <Subject 2> (young woman, red coat, braided hair) in a train station, medium shot, soft morning light
- <Subject 1>, adult woman, same face, now wearing a navy one-piece swimsuit, stands by a sunlit pool and turns toward the camera, slow dolly-in
- <Subject 1>, adult man with a trimmed beard, open white shirt, laughs on a yacht deck at golden hour, wind in his hair, camera orbits slowly
Héberger H3 avec des fichiers de référence vs générer en ligne sur Spicy AI
ComfyUI en local vous donne toute la boîte à outils de nœuds ; la solution en ligne échange ce contrôle contre zéro configuration.
| Déploiement local (poids officiels) | Spicy AI en ligne | |
|---|---|---|
| Filtres de contenu | Vous configurez votre propre installation | Filtres assouplis pour le contenu adulte (18+) |
| Poids ouverts | Oui | Pas nécessaires — fonctionne dans le navigateur |
| Cohérence des personnages | Fichiers RefMod, LoRA et contrôles par nœuds | Partir d'une image fixe de votre personnage |
| Coût de départ | Votre propre GPU | Offre gratuite disponible |
FAQ
Les MiniMax H3 RefMods sont-ils créés par MiniMax ?
Non. Il s'agit d'un format communautaire créé avec le pack de nœuds ComfyUI-MiniMaxH3Mod de @Luisacaotica, sous licence MIT. MiniMax n'a publié aucune position à ce sujet.
Dois-je entraîner quoi que ce soit ?
Non. Vos références passent une fois par le VAE et sont enregistrées dans un fichier d'environ 1 à 1,6 Mo. Les poids de H3 ne sont jamais réentraînés.
Combien d'images dois-je utiliser ?
Le README conseille 5 à 10 images nettes d'une seule personne ou un court extrait. Les recettes Fizgig utilisent 8 images à 1 mégapixel ou 16 à 0,5 mégapixel.
Un RefMod est-il meilleur qu'un LoRA ?
Il est plus rapide et plus léger. Un LoRA entraîné reste supérieur en ressemblance et sur les angles inhabituels, mais pour les plans proches de vos références, la différence est faible.
Combien puis-je en charger à la fois ?
Le nœud Load H3 RefMods dispose de huit emplacements maximum, chacun avec sa propre intensité. Pour les scènes de groupe, utilisez un fichier par personnage.
Où placer les fichiers ?
Placez-les dans ComfyUI/models/refmods/, puis sélectionnez-les dans le nœud de chargement ou pointez le loader de dossier vers un sous-répertoire.
Peuvent-ils cloner une voix ?
Pas encore de façon fiable. Le transfert de l'identité du locuteur est irrégulier dans les tests actuels, et vous ne devez jamais utiliser la voix de quelqu'un sans son consentement.