LoRA ouvert · audio + vidéo en streaming
TaoMate-H3 non censuré : la vidéo IA qui démarre pendant qu'elle se fabrique
Attendre trois minutes pour un clip de dix secondes, ça gâche tout le plaisir de la vidéo IA. TaoMate-H3 change le rythme : au lieu de générer tout le clip avant de l'afficher, il construit l'image et le son par petits morceaux et vous livre la première partie lisible au bout d'environ 17 secondes. Publié sous forme de LoRA ouvert par l'équipe Alibaba TaoLive AIGC, celle qui conçoit les outils IA de livestream de Taobao, il repose sur le modèle à poids ouverts MiniMax H3 et continue tant que vous lui fournissez des prompts. Il convient donc naturellement aux présentateurs parlants, aux démos produit et aux histoires en épisodes. Voici ce qu'il fait, où il excelle, comment le prompter et ce qu'il faut pour le faire tourner.
- LoRA en 3 étapes
- Lecture pendant le rendu
- 480p · 768p · 1080p
- Poids ouverts
TaoMate-H3 vs MiniMax H3 : de trois minutes à dix-sept secondes
Le point fort, c'est la vitesse. MiniMax H3 est un solide modèle audio-vidéo ouvert, mais comme la plupart des générateurs vidéo, il termine tout le clip avant que vous puissiez en voir une seule image. TaoMate-H3 ajoute un LoRA entraîné pour débruiter chaque segment en seulement trois étapes, puis diffuse les segments dans l'ordre. Lors du test de l'équipe sur huit cartes NVIDIA H20, un clip de dix secondes en 480×864 est devenu visionnable en 17,3 secondes au lieu de 183,3 secondes, et le calcul de diffusion principal est passé de près de 170 secondes à moins de 15.
La consommation mémoire a à peine bougé : l'accélération ne vient donc pas d'une machine plus puissante. L'équipe n'a en revanche publié aucune comparaison directe de la qualité d'image ou de l'amplitude des mouvements ; jugez donc la qualité visuelle de vos propres yeux plutôt que de la considérer comme un gain prouvé.
| Test de l'équipe (8×H20, 480×864, 10 s) | MiniMax H3 | Avec le LoRA | Gain |
|---|---|---|---|
| Première vidéo lisible | 183,3 s | 17,3 s | 10,6× plus rapide |
| Premier segment terminé | 170,1 s | 6,1 s | 27,7× plus rapide |
| Temps de diffusion (DiT) | 169,6 s | 14,8 s | 11,45× plus rapide |
| Mémoire DiT maximale | 32,03 Gio | 31,37 Gio | À peu près identique |
Trois étapes par segment : la génération audio-vidéo en streaming expliquée simplement
Imaginez une imprimante qui vous tend chaque page dès qu'elle est prête au lieu d'attendre la fin du rapport. Le modèle découpe la vidéo et sa bande-son en courtes tranches et crée chaque tranche en trois passes de débruitage. Chaque tranche terminée est écrite dans un cache mémoire, et la suivante est générée à partir de celui-ci, si bien que l'histoire peut continuer sans fin fixe. Pour un clip de dix secondes, la documentation du projet compte 24 passes de génération et 8 mises à jour du cache.
Garder un visage et une voix stables sur une longue prise, c'est le plus difficile. L'article de recherche à l'origine du projet introduit une mémoire guidée par ancre : un état de référence qui fixe l'apparence et la voix du personnage, ce qui réduit la dérive des couleurs et les fluctuations d'identité au fil des minutes. L'image et le son sont produits ensemble, de sorte que les lèvres, la parole et l'ambiance de la pièce restent synchronisées au lieu d'être collées après coup.
Les benchmarks de l'article sont impressionnants : 35 images par seconde sur trois GPU, contre 23 pour LiveAvatar sur cinq et 16 pour LongLive-2.0 sur quatre, avec en prime le meilleur score de synchronisation labiale. Gardez à l'esprit que ces chiffres ont été mesurés sur un générateur de 22 milliards de paramètres initialisé à partir de LTX-2.3, et non sur la version H3 : ils montrent le potentiel de la méthode plutôt que les résultats de ce modèle précis. Parmi les options open source de vidéo IA en temps réel, c'est l'une des rares à diffuser le son et l'image ensemble.
Présentateurs humains numériques, démos produit façon live et courts drames
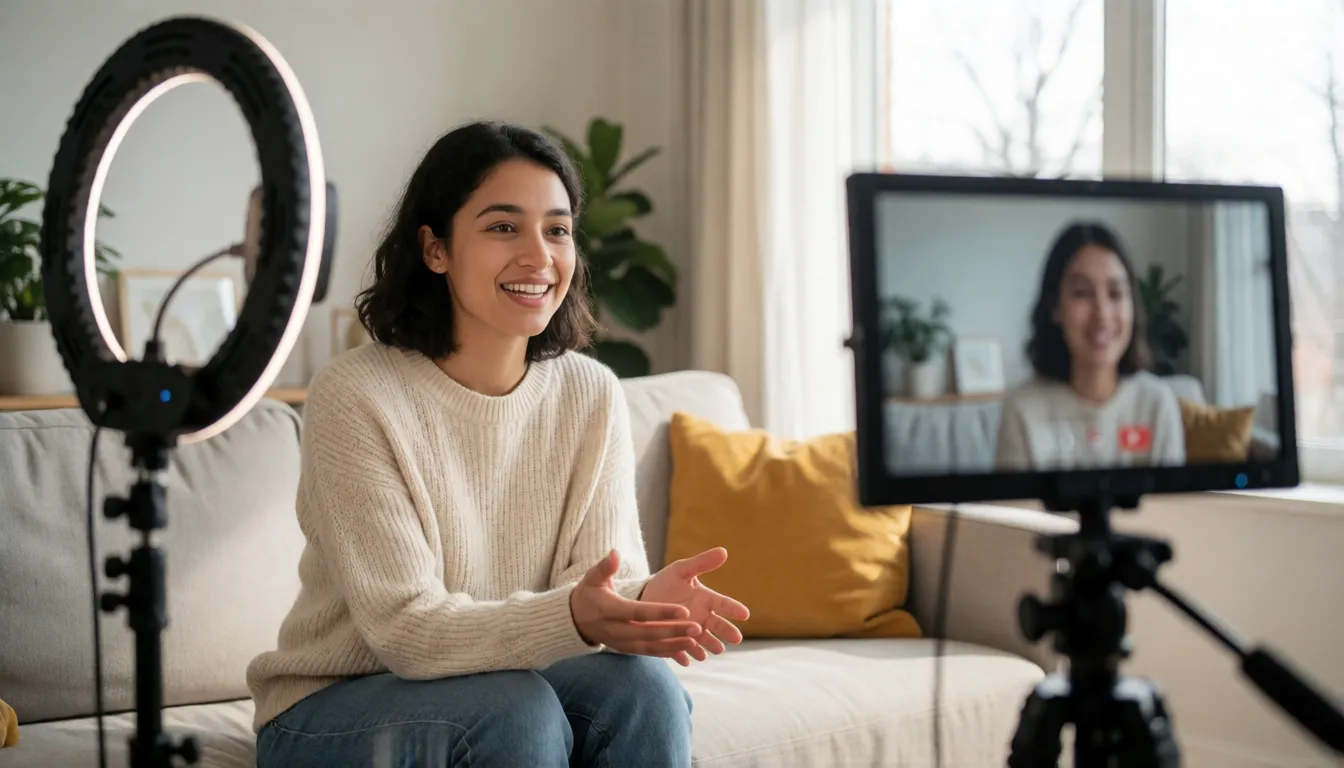
Puisqu'il vient de l'équipe livestream de Taobao, le terrain évident est le présentateur parlant. La démo première et dernière image du projet est un clip de 30 secondes montrant une présentatrice assise dans un salon familial qui explique comment organiser ses rangements, exactement le genre de séquence que les lives shopping diffusent toute la journée. Le projet ne promet jamais un produit complet de live commerce, mais les ingrédients sont là : un visage stable, une voix naturelle et un rendu qui arrive assez vite pour tenir un planning de production.
Présentateurs parlants et vidéos explicatives
Un présentateur, une pièce, un script découpé en courts temps forts. Idéal pour les tutoriels, les astuces maison et les intros de chaîne qui ont besoin d'un visage sympathique à l'écran.
Démos produit et ébauches publicitaires
Préparez plusieurs versions d'un pitch de 15 secondes, changez la réplique ou l'angle produit, et comparez-les côte à côte avant de réserver un vrai tournage.
Courts drames en épisodes
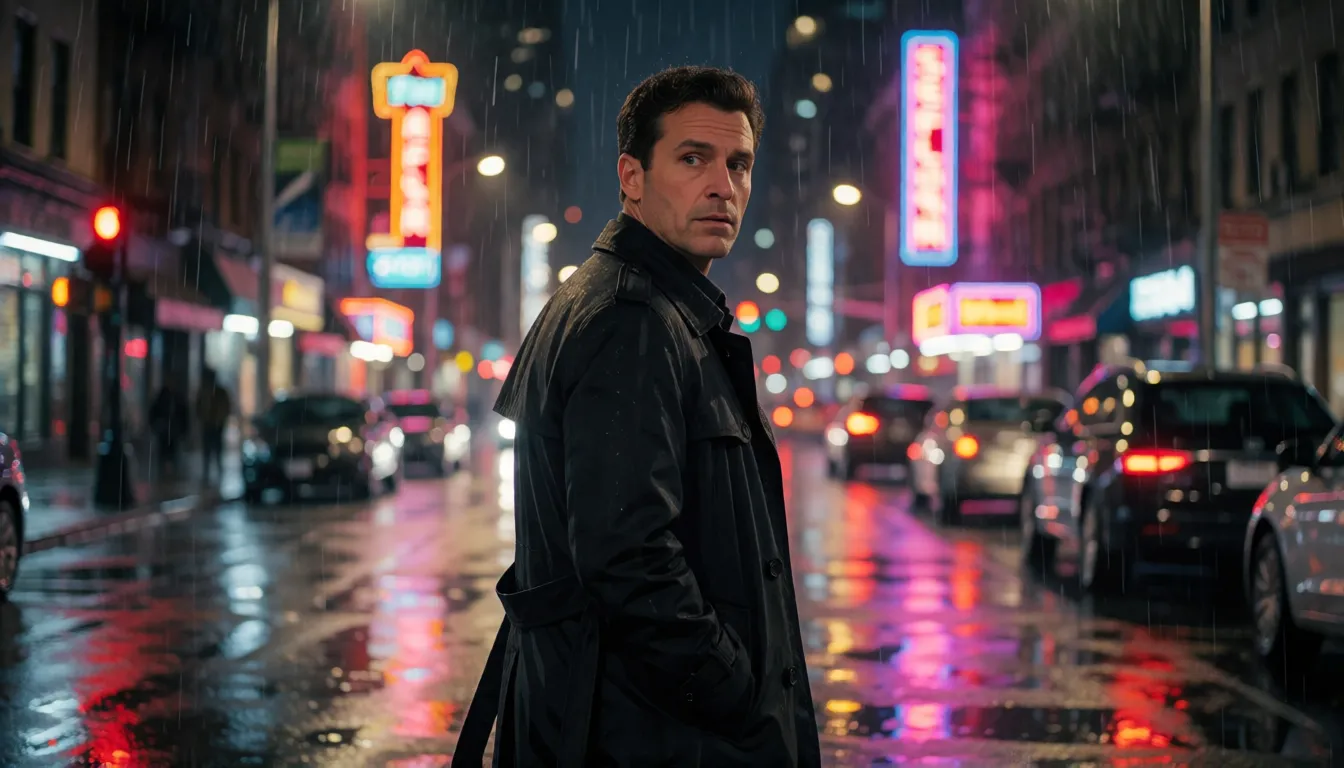
Enchaînez des temps forts de cinq secondes pour former une scène continue. Pluie, néons, une réplique murmurée et une révélation, avec le même acteur d'un plan à l'autre.
Vidéo sociale pensée pour le vertical
Les formats portrait natifs 768×1376 et 1088×1920 s'intègrent directement aux flux de vidéos courtes, sans recadrage. L'article a aussi testé la parole en mandarin et en anglais.
Construire une vidéo IA d'une minute, cinq secondes à la fois
C'est sur la vidéo IA longue que le streaming paie vraiment. La durée se règle par blocs de cinq secondes, et vous pouvez soit réutiliser un seul prompt pour toute la séquence, soit fournir une liste JSON avec un prompt, et éventuellement une seed, par bloc de cinq secondes. Voyez-le comme un storyboard : le bloc un présente l'animatrice, le bloc deux montre le produit, le bloc trois est le gros plan, et le modèle conserve la même personne et la même pièce à chaque changement. Les exemples du projet durent 30 secondes, et l'article teste une minute complète de 1 441 images.
La sortie existe en trois tailles : 480p pour les brouillons rapides, 768p par défaut et 1080p pour la livraison, chacune en paysage ou en portrait. La variante première et dernière image tourne à 24 fps fixes en portrait 768×1376, pratique quand chaque plan doit commencer et finir sur une pose exacte.
Modèles de prompts pour présentateurs parlants et scènes en série
Le secret des longues prises cohérentes, c'est la répétition. Reprenez l'apparence, la tenue et le décor de la personne dans chaque bloc, donnez à chaque bloc une seule action principale, mettez les répliques entre guillemets et décrivez le son à part. Ces modèles suivent ce principe et servent de premier jet pour vos propres scripts.
Présentatrice parlante · bloc 1
Plan moyen, une jeune femme en pull crème assise sur un canapé dans un salon lumineux, parle face caméra et explique comment plier des serviettes dans une boîte de rangement, gestes naturels, lumière du jour chaleureuse, caméra stable. Audio : voix féminine claire, ambiance de pièce douce.
Présentatrice parlante · bloc 2 (suite)
Même femme, même pull crème, même salon. Elle lève la boîte vers la caméra et sourit : « Celle-ci contient trois serviettes. » La caméra avance lentement. Audio : même voix, léger froissement de tissu.
Temps fort de court drame
Rue de nuit sous la pluie, un homme en trench-coat noir se retourne, gros plan, il dit à voix basse : « Tu es finalement venue. » Reflets de néons sur l'asphalte mouillé. Audio : pluie régulière, tonnerre au loin.
Spot maillots de bain adulte (18+, mannequin fictive)
Une mannequin adulte d'une petite trentaine en bikini rouge marche sur une plage ensoleillée et présente face caméra les maillots de bain de cet été, sourire détendu, travelling. Audio : sa voix, les vagues, une brise légère.
TaoMate-H3-FL2VA et TaoMate-HD : une famille qui s'agrandit
Le projet avance vite. La première version, en septembre 2026, a apporté le streaming texte vers audio-vidéo à H3. Le 15 octobre 2026, l'équipe a ajouté TaoMate-H3-FL2VA, qui prend une première et une dernière image et diffuse le clip entre les deux ; l'équipe le décrit comme, à sa connaissance, le premier modèle audio-vidéo première et dernière image en temps réel. C'est la version à choisir quand un storyboard fixe le début et la fin de chaque plan.
Le 3 novembre 2026 est arrivé TaoMate-HD, qui s'appuie sur le runtime H3 avec une génération progressive visant des résultats plus nets ; sa page projet donne les détails. La génération à partir de références (Ref2AV) est annoncée pour plus tard, sans date pour l'instant.
Faire tourner TaoMate-H3 depuis Hugging Face et GitHub
Le LoRA lui-même est léger : un fichier de config, une config d'adaptateur et un fichier safetensors (rang 128), publiés sur Hugging Face avec un miroir ModelScope. L'installation est décrite dans le dépôt GitHub. Le hic, c'est le matériel : la seule configuration vérifiée compte huit cartes NVIDIA H20 de 96 Go, et les scripts acceptent quatre ou huit GPU de classe Hopper.
- 1Préparez un Linux avec Python 3.10 ou 3.11, CUDA 12.8, PyTorch 2.8, vLLM 0.11.1, FlashAttention pour Hopper et FFmpeg.
- 2Téléchargez le modèle de base MiniMax H3 (model_index.json et ses dossiers) ainsi que le LoRA TaoMate depuis Hugging Face.
- 3Choisissez une taille (480p, 768p ou 1080p) et réglez --duration sur un multiple de 5 secondes.
- 4Passez un seul --prompt pour tout le clip, ou --prompt-json avec un prompt et une seed facultative par bloc de cinq secondes.
- 5Lancez avec --gpus 4 ou 8 et regardez les premiers segments se lire pendant que le reste se génère encore.
- Exigences GPU : aucune VRAM minimale n'est publiée et il n'existe aucune voie prise en charge pour les cartes RTX 4090 ou 5090.
- ComfyUI : aucun nœud n'existe encore de la part de l'équipe, la ligne de commande est donc la voie prise en charge.
- Démo en ligne : deux Spaces communautaires sur Hugging Face permettent d'essayer le modèle en 3 étapes dans un navigateur, et la page du modèle mentionne un fournisseur d'inférence hébergé.
Pourquoi les créateurs suivent cette sortie de près
La génération audio-vidéo ouverte et en temps réel est rare, et c'est ce qui attire l'attention. En deux mois environ, le dépôt GitHub a dépassé 800 étoiles, la page Hugging Face a recueilli plus de 130 likes et la communauté a lancé deux Spaces de démo publics. L'enthousiasme porte sur le clip qui démarre presque instantanément et sur les longues prises qui gardent le même visage. Ce qui freine la plupart des gens saute aux yeux dans les prérequis : une configuration multi-GPU de data center, sans voie prise en charge pour les cartes grand public ni pour ComfyUI pour l'instant.
TaoMate-H3 non censuré : ce que les poids ouverts signifient pour les créateurs adultes
Il n'existe pas d'édition non censurée distincte de TaoMate-H3, et il n'en faut pas au sens habituel : le LoRA comme la base H3 sont à poids ouverts, les pages du projet ne décrivent ni filtre de contenu ni classificateur de sécurité, et une exécution locale ne passe jamais par un service de modération cloud. Pour les créateurs adultes, les règles sont donc fixées par la licence du modèle et par votre propre configuration. Si vous n'avez pas de machine à huit GPU, Spicy AI propose en ligne un outil image vers vidéo similaire aux filtres assouplis, pour des personnages adultes et fictifs.
Importez une image fixe de votre personnage adulte original et donnez-lui vie avec du son, sans GPU.
Ouvrir image vers vidéoGénérateur vidéo alternatif non censuré
Partez d'une photo d'un personnage adulte original, décrivez le mouvement et la réplique à prononcer, et obtenez un court clip parlant dans votre navigateur.
Commencer la générationHéberger TaoMate-H3 soi-même ou générer en ligne sur Spicy AI
L'exécuter vous-même vous offre le streaming en temps réel et un contrôle total ; la voie en ligne y renonce en échange d'une installation nulle.
| Déploiement local (poids publiés) | Spicy AI en ligne | |
|---|---|---|
| Filtres de contenu | Vous configurez votre propre installation | Filtres assouplis pour le contenu adulte (18+) |
| Poids ouverts | Oui (LoRA + base H3) | Inutile, tout tourne dans le navigateur |
| Modèle réellement utilisé | LoRA TaoMate sur MiniMax H3 | Un modèle image vers vidéo hébergé |
| Coût de départ | Quatre à huit GPU Hopper | Offre gratuite disponible |
FAQ
Qu'est-ce que TaoMate-H3 ?
Un LoRA en 3 étapes et un runtime de streaming construits sur MiniMax H3 par l'équipe TaoLive AIGC d'Alibaba. Il génère l'audio et la vidéo ensemble par segments, si bien que la lecture commence pendant que le reste est encore en cours de rendu.
De combien est-il plus rapide que MiniMax H3 ?
Lors du test de l'équipe sur huit GPU H20 en 480×864 pendant 10 secondes, la première vidéo lisible est arrivée après 17,3 secondes contre 183,3 secondes, et le temps de diffusion a été 11,45 fois plus court.
Peut-il tourner sur une RTX 4090 ou 5090 ?
Pas de manière prise en charge. Seuls les GPU Hopper sont supportés, la configuration vérifiée compte huit cartes H20 de 96 Go, quatre ou huit GPU peuvent être utilisés, et aucune VRAM minimale n'a été publiée.
Prend-il en charge la vidéo première et dernière image ?
La version principale fait du texte vers audio-vidéo. Le streaming première et dernière image vient de TaoMate-H3-FL2VA, sorti le 15 octobre 2026. La génération à partir de références n'est pas encore disponible.
Quelle durée peuvent atteindre les vidéos ?
La durée augmente par paliers de cinq secondes et peut continuer. Les exemples du projet durent 30 secondes, et l'article évalue des clips d'une minute de 1 441 images.
Existe-t-il un nœud ComfyUI ?
Pas de la part de l'équipe pour l'instant. La manière prise en charge de l'exécuter passe par les scripts en ligne de commande du dépôt GitHub.
Existe-t-il une version non censurée ?
Aucune version dédiée n'existe. Les poids sont ouverts et les pages du projet ne décrivent aucun filtre intégré : une exécution locale est donc régie par la licence communautaire H3 plutôt que par une modération cloud.