Речь в видео · Открытые веса
Kandinsky S2V 1.0 Pro без цензуры: заставьте любое фото говорить, жестикулировать и петь
Kandinsky S2V 1.0 Pro нужны три простые вещи — одна фотография, запись речи и короткое описание сцены, — а на выходе получается видео, в котором человек говорит с точной артикуляцией, двигает руками и плечами и остаётся в образе от первой до последней секунды. Модель создана Kandinsky Lab, командой, стоящей за Kandinsky 5.0 и 6.0, а веса можно скачать бесплатно. В этом руководстве — где авторы контента её применяют, за счёт чего результат выглядит естественно, какая версия подойдёт вашей видеокарте, готовые промпты и сравнение с другими открытыми моделями говорящих аватаров.
- Фото + голос → видео
- Всё тело, а не только лицо
- 25 кадров/с, любая длина
- Быстрая версия на 16 шагов
Альтернативный видеогенератор без цензуры
Изображение в видеоКак и Kandinsky S2V 1.0 Pro, он начинает с одного портрета: загрузите его, опишите, как человек должен двигаться и как выглядит сцена, и мы откроем студию «изображение в видео» со всеми заполненными полями. Темы для взрослых допускаются, если всем изображённым 18+.
Одно фото, одна голосовая запись — целое выступление
Большинство инструментов «говорящих фото» анимируют только лицо: рот открывается и закрывается, а остальная картинка остаётся застывшей. Kandinsky S2V 1.0 Pro работает иначе. Вы даёте ему референсное изображение, чистую запись речи (16 кГц, моно) и текстовый промпт, а он генерирует видео 25 кадров/с, в котором оживает весь человек. Губы следуют за каждым слогом, руки делают те жесты, которыми люди сопровождают объяснения, а фон ведёт себя так, как описано в промпте. Результат сохраняет соотношение сторон вашего фото и вашу исходную звуковую дорожку, так что ролик сразу готов к публикации.
Длина тоже не фиксирована. Kandinsky S2V 1.0 Pro работает пятисекундными блоками по 125 кадров, и каждый новый блок продолжает с того места, где остановился предыдущий, поэтому двухминутная озвучка превращается в двухминутное видео с тем же человеком. Синхронизацию губ замечают первой: каждый кадр «слушает» только свой фрагмент аудио, поэтому форма рта попадает точно в нужный звук, а не отстаёт от него.
Где говорящие видео из одного фото набирают популярность
Аватары, управляемые речью, перешли из технических демо в повседневную работу с контентом, и Kandinsky S2V 1.0 Pro отлично в неё вписывается. Ниже — задачи, которые чаще всего упоминают в исследовательском пакете и в сообществах авторов, и у всех у них одна общая потребность: убедительный человек в кадре, который говорит ровно то, что звучит в вашем аудио, без аренды студии и найма ведущего.
- Короткие дорамы и анимированные комиксы: дайте каждому портрету персонажа его реплики и получите диалоговые сцены в полный рост, которые выглядят как настоящие сцены, а не стикеры.
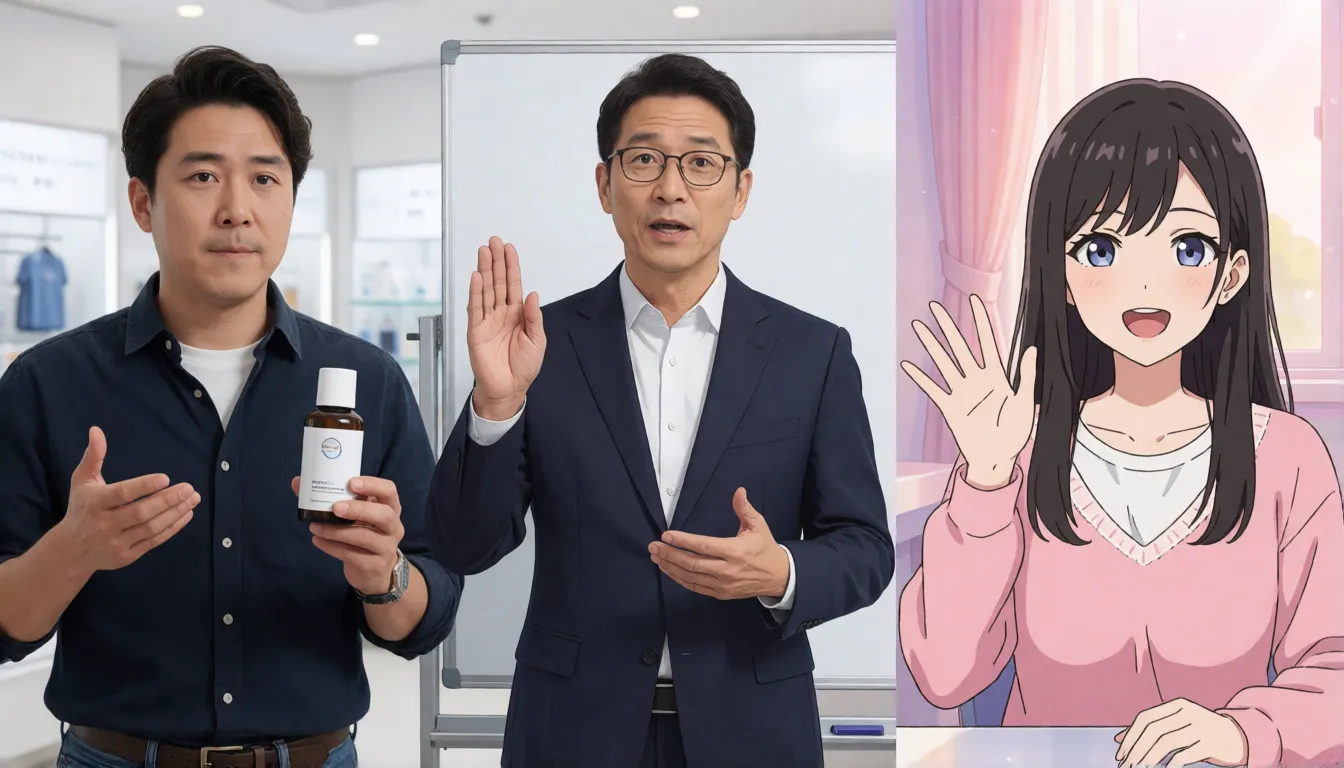
- Ролики о товарах и для live-commerce: фото модели плюс запись презентации товара за минуты становятся объясняющим видео в формате ведущего.
- Курсы, обзоры новостей и обучение: превратите текст диктора в длинную лекцию с виртуальным преподавателем, который жестикулирует минутами.
- Виртуальные стримеры и ИИ-компаньоны: соедините изображение персонажа с синтезированным голосом, и персонаж будет отвечать в кадре.
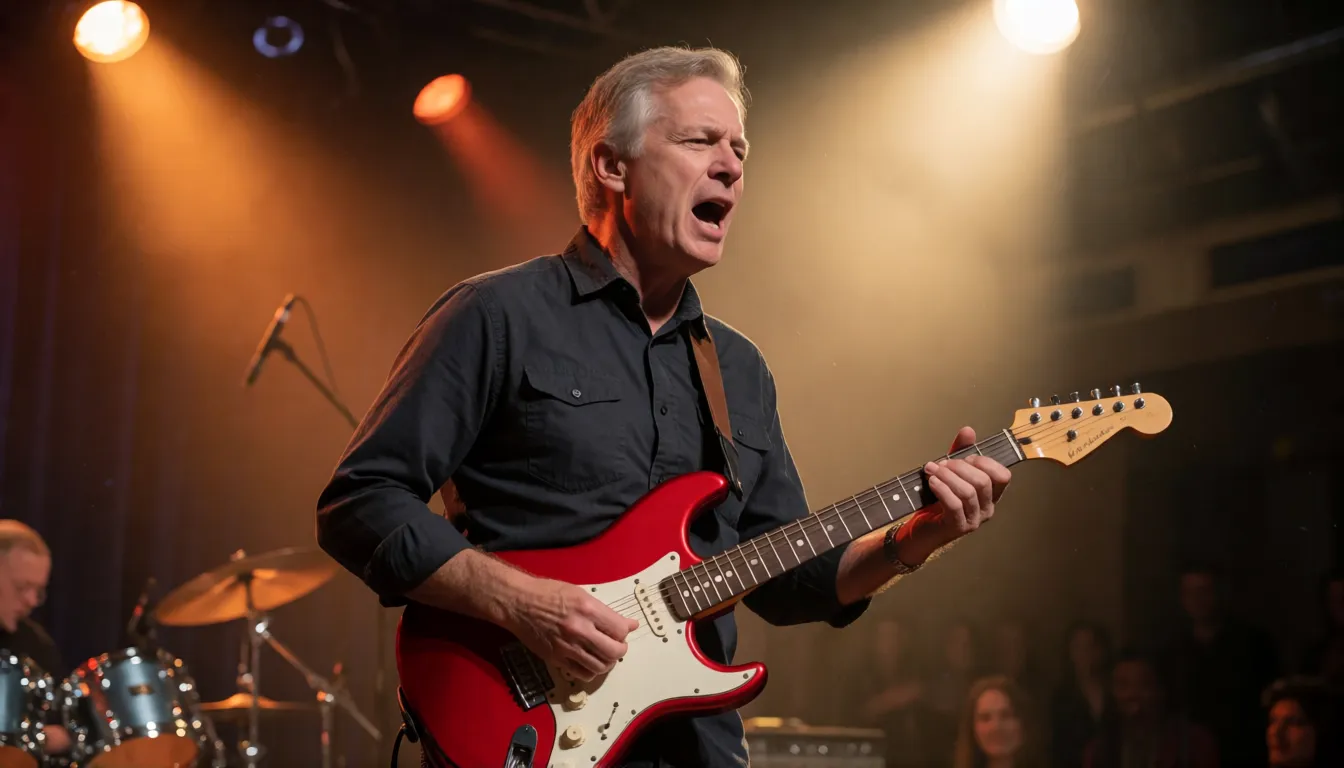
- Музыка и подкасты: официальный пример для Diffusers — седой мужчина с красной электрогитарой, намёк на то, что ролики с выступлениями вполне возможны (качество пения командой не измерялось).
- Многоязычный дубляж: оставьте одно фото и меняйте звуковые дорожки на разных языках; подписи при обучении были на английском и русском, поэтому проверяйте другие языки перед крупным проектом.
Диалоги для коротких дорам
Дайте каждому портрету персонажа его реплику, и Kandinsky S2V 1.0 Pro вернёт сцены в полный рост с точной синхронизацией губ.
Видео о товарах
Фото модели и записанная презентация превращаются в ролик в формате ведущего для магазинов и live-commerce.
Виртуальные ведущие
Соедините изображение персонажа с TTS-голосом для стримеров, преподавателей и ИИ-компаньонов, которые отвечают вам.
Почему результат выглядит естественно
Три архитектурных решения отличают Kandinsky S2V 1.0 Pro от множества предшествующих инструментов синхронизации губ. Во-первых, это анимация всего тела: модель основана на Kandinsky 5.0 Video, поэтому уже знает, как движутся тела, одежда и сцены, а промпт может управлять жестами и обстановкой. Во-вторых, она понимает и слова, и голос: Qwen2.5-Omni читает ваш текстовый промпт и слушает речь с частотой 25 токенов в секунду, что помогает движениям соответствовать энергии подачи. В-третьих, трёхуровневая память переносит внешний вид с референсного фото из блока в блок, так что лица и наряды остаются стабильными даже в длинных дублях.
Kandinsky S2V 1.0 Pro также выпускается в дистиллированной редакции. Pro distill достигает результата за 16 шагов вместо 50 и «запекает» guidance в веса; по данным команды, это примерно в пять раз быстрее (от 4,5× до 5,6× в зависимости от конфигурации) при почти тех же показателях, что у базовой модели, практически по всем метрикам. В исследовании с участием людей из статьи, где сравнивались сильнейший открытый бейзлайн и два коммерческих сервиса, Kandinsky S2V 1.0 Pro в среднем оценили как равный или лучший, а больше всего предпочтений получила синхронизация губ.
- Движение всего тела и управление сценой через текстовый промпт
- Покадрово точная синхронизация губ благодаря аудио-вниманию для каждого кадра
- Нет жёсткого ограничения длины благодаря поблочному продолжению
- Открытые веса под лицензией MIT, работает локально
- Для модели Pro нужна видеокарта на 48 ГБ (80 ГБ для HD)
- Не создаёт звук — нужен свой голос или TTS
- Пока нет официальной квантованной сборки для карт на 24 ГБ
- Режим HD не обучался и не оценивался в этом разрешении
Lite или Pro, base или distill: выбираем версию
Kandinsky S2V 1.0 Pro входит в семейство из четырёх чекпойнтов. Модели Lite 2B — быстрый и лёгкий вариант; модели Pro 21B дают лучшие лица, руки и движения. Внутри каждого размера дистиллированная редакция — выбор на каждый день, а базовая модель на 50 шагов — для тех, кто гонится за последними деталями. Оба чекпойнта Pro также могут работать в HD-конфигурации 1280×768.
| Версия | Размер и шаги | Для чего подходит | Скорость на одной H100 (на секунду видео) |
|---|---|---|---|
| Lite 2B distill | 2B, дистиллированная | Быстрые черновики, небольшие GPU | Около 8,7 с |
| Lite 2B | 2B, базовая | Качество Lite без дистилляции | Медленнее, чем Lite distill |
| Pro 21B distill | 21B, 16 шагов | Лучший баланс для ежедневной работы | Около 41,5 с (33,6 с с компиляцией) |
| Pro 21B | 21B, 50 шагов | Максимальная точность, поддерживает негативные промпты | Около 189 с |
| Pro distill HD | 21B, 1280×768 | Более крупные кадры (качество не проверено) | Около 137 с |
Видеопамять и скорость: чего ожидать
Kandinsky S2V 1.0 Pro — большая модель, поэтому продумайте оборудование, прежде чем скачивать около 65 ГБ файлов. Официальное требование — одна видеокарта минимум с 48 ГБ памяти (80 ГБ для HD) и драйвер версии 580 или новее. На одной H100 пиковое потребление Pro distill в стандартном разрешении — около 46 ГиБ; в HD — около 55 ГиБ. Поэтому десятисекундный ролик на одной карте занимает примерно шесть–семь минут, а официальная конфигурация из восьми GPU сокращает время на секунду видео примерно до 11 секунд.
Не хватает памяти? Включение VAE tiling снижает пик примерно до 28 ГБ ценой слабо заметных швов, путь через Diffusers с выгрузкой на CPU даёт пик около 50 ГиБ, а модель Lite 2B distill — самый простой способ поэкспериментировать на карте поменьше. Для потребительских карт на 24 ГБ обычный выход — арендовать облачный GPU на полдня, поскольку официальных квантованных файлов пока нет.
Три способа попробовать: онлайн-демо, ComfyUI и Diffusers
Чтобы увидеть, на что способен Kandinsky S2V 1.0 Pro, ничего устанавливать не нужно. Команда размещает бесплатный демо-Space на Hugging Face, а для тех, кому нужно больше контроля, есть ноутбуки Colab и Kaggle. Когда будете готовы запускать сами, выберите путь, который подходит под ваш привычный рабочий процесс.
- 1Онлайн: откройте Space Kandinsky-S2V-1.0-Demo на Hugging Face, загрузите портрет и короткий WAV-файл, добавьте промпт и запустите генерацию.
- 2Командная строка: клонируйте GitHub-репозиторий kandinsky-s2v, выполните uv sync, затем uv run kandy-s2v generate с конфигом s2v_pro_distill.yaml и вашими путями --audio, --image и --out; добавьте --prompt и --seed, чтобы управлять результатом и воспроизводить его.
- 3ComfyUI: переключитесь на ветку dev/comfyui репозитория, где есть ноды для Lite distill и Pro distill, и подключите изображение, аудио и промпт к сэмплеру.
- 4Diffusers: установите diffusers из ветки main, загрузите kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers через ModularPipeline и читайте аудио с частотой 16 кГц.
Какой бы путь вы ни выбрали, Kandinsky S2V 1.0 Pro вознаграждает качественные входные файлы больше, чем любые настройки. Помните об этом:
- Используйте чёткое фронтальное фото, где человек занимает большую часть кадра; его соотношение сторон станет соотношением сторон видео.
- Записывайте чистую речь без фоновой музыки и сохраняйте её как моно-аудио 16 кГц.
- Зафиксируйте --seed, когда результат понравится, и затем меняйте только промпт, чтобы исследовать варианты.
Шаблоны промптов для говорящих видео
В Kandinsky S2V 1.0 Pro текстовый промпт не содержит сценарий — его задаёт ваше аудио. Используйте промпт, чтобы описать человека, его движения, обстановку и камеру, и держите одежду и фон близкими к референсному фото, чтобы образ не «уплывал». Эти шаблоны охватывают самые популярные форматы: меняйте детали и сохраняйте структуру.
- Ведущая: A young woman in a beige blazer speaks confidently to the camera in a bright modern studio, natural hand gestures, soft key light, medium shot.
- Презентация товара: A smiling man holds a skincare bottle and explains its features to the camera, gesturing toward the product, clean white background, live-stream style.
- Драматический диалог: A woman in a red evening dress stands on a rainy balcony at night, speaking emotionally, city lights bokeh behind her, cinematic lighting.
- Музыкант: A man with short gray hair plays a red electric guitar and sings on a small stage, spotlight, energetic body movement.
- Преподаватель: A middle-aged professor in glasses explains a concept beside a whiteboard, calm gestures, classroom lighting, full body visible.
- Виртуальная стримерша: An anime-style adult girl with silver hair talks cheerfully and waves, pastel bedroom background, streaming frame.
- Разговор на пляже (18+): A confident adult woman in a black bikini talks to the camera on a sunny beach, relaxed posture, gentle waves, golden hour light.
- Негативный промпт (только модель на 50 шагов): blurry face, distorted mouth, extra fingers, flickering, static body.
Сравнение с Wan 2.2 S2V, InfiniteTalk и другими открытыми аватарами
Открытых моделей говорящих аватаров стало много, и у каждой своя сильная сторона по сравнению с Kandinsky S2V 1.0 Pro. Для Wan2.2-S2V-14B от Alibaba уже есть GGUF-файлы от сообщества, что делает её удобнее для небольших GPU. InfiniteTalk и MultiTalk сосредоточены на очень длинных видео и разговорах нескольких людей. Для LongCat-Video-Avatar 1.5 тоже есть GGUF-сборки для ComfyUI. Kandinsky S2V 1.0 Pro выделяется свободной лицензией MIT, движением всего тела под управлением текста и дистиллированным релизом на 16 шагов; его слабые места сегодня — высокие требования к памяти и молодая экосистема сообщества. В статье бейзлайны не названы, поэтому считайте прямые сравнения непроверенными и тестируйте на собственных роликах.
| Модель | Сильная сторона | Проще всего на небольших GPU? |
|---|---|---|
| Kandinsky S2V (Lite / Pro) | Движение всего тела, сцены под управлением текста, distill на 16 шагов | Только Lite; Pro требует 48 ГБ |
| Wan2.2-S2V-14B | Зрелая экосистема, кинематографичное движение | Да, GGUF от сообщества |
| InfiniteTalk / MultiTalk | Очень длинные ролики, диалоги нескольких людей | Зависит от конфигурации |
| LongCat-Video-Avatar 1.5 | Видео с аватаром и поддержкой ComfyUI | Да, GGUF от сообщества |
Говорящие аватары без цензуры: что можно сделать уже сегодня
Официального или созданного сообществом файнтюна Kandinsky S2V 1.0 Pro без цензуры пока нет. Открытые веса работают локально без онлайн-слоя модерации, но обучающие данные — это записи одного говорящего человека, поэтому модель не создавалась для сцен для взрослых, а карточка модели просит анимировать только тех, кто дал согласие. Если вы хотите, чтобы фото говорило, флиртовало или позировало в купальнике или белье для вымышленных персонажей 18+ без какой-либо установки, в нашей студии «изображение в видео» можно загрузить портрет, описать движение и сгенерировать результат прямо в браузере.
Анимируйте портрет персонажа 18+ прямо в браузере, без GPU.
Начать «изображение в видео» →Самостоятельный запуск Kandinsky S2V 1.0 Pro или онлайн-генерация в Spicy AI
| Локальное развёртывание (официальные веса) | Spicy AI онлайн | |
|---|---|---|
| Фильтрация контента | Нет онлайн-фильтра при самостоятельном запуске | Контент для взрослых (18+) разрешён |
| Открытые веса | Да, лицензия MIT на Hugging Face | Неприменимо, работает онлайн |
| Фактически используемая модель | Kandinsky S2V Lite или Pro | Собственные видеомодели Spicy AI |
| Цена | Веса бесплатны, вы платите за GPU | Бесплатный старт, кредиты для большего |
- Локально: синхронизация губ по вашему собственному аудио, неограниченная длина, полный контроль.
- Spicy AI: начните с фото и анимируйте его в браузере, оборудование не нужно.
Часто задаваемые вопросы
Что такое Kandinsky S2V 1.0 Pro?
Kandinsky S2V 1.0 Pro — модель преобразования речи в видео на 21 миллиард параметров от Kandinsky Lab. Дайте ей референсное фото, запись голоса и текстовый промпт, и она сгенерирует говорящее видео в полный рост 25 кадров/с с синхронизацией губ. Веса открыты под лицензией MIT.
Чем отличаются Pro и Pro distill?
Обе имеют 21B параметров. Версия distill использует дистилляцию pi-Flow, чтобы завершать генерацию за 16 шагов вместо 50, и «запекает» guidance в веса, поэтому она примерно в пять раз быстрее и почти по всем метрикам близка к базовой модели.
Сколько видеопамяти нужно Kandinsky S2V 1.0 Pro?
Команда рекомендует одну видеокарту минимум на 48 ГБ (80 ГБ для HD). Пик Pro distill в стандартном разрешении — около 46 ГиБ; VAE tiling снижает его примерно до 28 ГБ со слабо заметными швами. Официальной квантованной сборки пока нет.
Какой длины могут быть видео Kandinsky S2V 1.0 Pro?
Такой же, как ваше аудио. Модель генерирует пятисекундные блоки и продолжает каждый следующий с конца предыдущего. На одной H100 одна секунда видео в стандартном разрешении занимает около 41,5 секунды с Pro distill.
Генерирует ли Kandinsky S2V 1.0 Pro ещё и голос?
Нет. Речь предоставляете вы — реальную запись или синтез речи, — и готовое видео содержит эту исходную звуковую дорожку.
Есть ли онлайн-демо или поддержка ComfyUI?
Да. Kandinsky Lab размещает демо-Space на Hugging Face, ветка dev/comfyui GitHub-репозитория добавляет ноды ComfyUI для Lite distill и Pro distill, а поддержка Diffusers доступна в ветке main.
Существует ли Kandinsky S2V 1.0 Pro без цензуры?
На ноябрь 2026 года — нет: ни официальный, ни созданный сообществом файнтюн без цензуры не выпускался. Вы можете запускать открытые веса самостоятельно или воспользоваться онлайн-генератором «изображение в видео», который допускает вымышленный контент 18+.
Источники
- Карточка модели Kandinsky-S2V-1.0-Pro-distill (Hugging Face)
- Карточка модели Kandinsky-S2V-1.0-Pro-distill-Diffusers (Hugging Face)
- Базовая модель Kandinsky-S2V-1.0-Pro (Hugging Face)
- Онлайн-демо Kandinsky S2V 1.0 (Hugging Face Space)
- Репозиторий kandinskylab/kandinsky-s2v (GitHub)
- Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation (arXiv)
- Страница проекта Kandinsky Avatar
- Wan2.2-S2V-14B GGUF (Hugging Face)
Другие руководства по видеомоделям без цензуры
- Kandinsky 6.0 без цензуры
- Kling без цензуры
- Kling 2.6 без цензуры
- Kling O1 без цензуры
- Sora без цензуры
- Veo без цензуры
- Hailuo AI без цензуры
- MiniMax H3 Max без цензуры
- Wan без цензуры
- Wan 3.0 без цензуры
- Seedance без цензуры
- Seedance 2.5 без цензуры
- Seedance 2.0 без цензуры
- Seedance 2.0 Mini без цензуры
- HunyuanVideo без цензуры
- LTX Video без цензуры
- Runway без цензуры
- Pika без цензуры
- Luma Dream Machine без цензуры
- Vidu без цензуры
- PixVerse без цензуры
- EdenLive без цензуры
- Grok Imagine без цензуры
- AI Avatars без цензуры
- HappyHorse 1.0 без цензуры
- MiniMax H3 FL2VA Ref2VA без цензуры
- Kling 4.0 без цензуры
- Kling 3.0 без цензуры
- MiniMax H3 RefMods без цензуры
- Looking Ahead без цензуры
- TaoMate-H3 без цензуры
- SANA-Video 2.0 без цензуры
- MiniMax H3 Remix без цензуры
- Sora 2 без цензуры
- Wan 2.6 без цензуры
- LTX-2.5 Slow Motion без цензуры
- VDN MiniMax H3 без цензуры
Spicy AI — независимый сайт, не связанный с Kandinsky Lab или Сбером. Весь контент должен касаться только взрослых (18+); не анимируйте реальных людей без их согласия.